
Adversarial Machine Learning ist die Untersuchung von Angriffen auf Algorithmen des maschinellen Lernens und von Abwehrmechanismen gegen solche Angriffe.
ExzellentAI safety
Kategorie
61 Artikel
Adversarial Machine Learning ist die Untersuchung von Angriffen auf Algorithmen des maschinellen Lernens und von Abwehrmechanismen gegen solche Angriffe.
Algorithmische Inferenz umfasst neue Entwicklungen statistischer Inferenzmethoden , die durch die leistungsstarken, für Datenanalysten weit verbreiteten Computer ermöglicht werden.

Algorithmische Verzerrung beschreibt die systematische und wiederholbare schädliche Tendenz in einem computergestützten soziotechnischen System, „ ungerechte “ Ergebnisse zu erzeugen, wie z. B.

Audio-Inpainting (auch Audio-Interpolation genannt ) ist ein Verfahren zur Audiorestaurierung , das sich mit der Rekonstruktion fehlender oder beschädigter Teile eines digitalen Audiosignals befasst .

Im maschinellen Lernen ist Aufmerksamkeit ein Verfahren, das die Wichtigkeit jeder Komponente einer Sequenz im Verhältnis zu den anderen Komponenten dieser Sequenz bestimmt.
In der künstlichen Intelligenz bezeichnet man als Lehrlingslernen (auch bekannt als Lernen durch Nachahmung oder Imitationslernen ) den Prozess des Lernens durch Beobachtung eines Experten.

Die Bayes'sche Optimierung ist eine sequentielle, modellbasierte Strategie zur globalen Optimierung von Black-Box -Zielfunktionen, deren Auswertung aufwändig ist.

In der künstlichen Intelligenz und im Cloud Computing bezeichnet „ Compute“ die Rechenleistung oder die benötigten Rechenressourcen, um Modelle des maschinellen Lernens und große Sprachmodelle zu trainieren .
XLA ( Accelerated Linear Algebra ) ist ein Open-Source -Compiler für maschinelles Lernen , der vom OpenXLA-Projekt entwickelt wurde.
Gelabelte Daten sind eine Gruppe von Datenpunkten , die mit einem oder mehreren Labels versehen wurden.

Die binäre Klassifizierung ist die Aufgabe, Dinge in eine von zwei Kategorien (jeweils eine Klasse genannt) einzuordnen .
BioSerenity ist ein 2014 gegründetes Medizintechnikunternehmen, das ambulante medizinische Geräte zur Diagnose und Überwachung von Patienten mit chronischen Erkrankungen wie Epilepsie entwickelt .

Data preprocessing can refer to manipulation, filtration or augmentation of data before it is analyzed, and is often an important step in the data mining process.
Die Dokumentenklassifizierung bzw. -kategorisierung ist ein Problem der Bibliothekswissenschaft , der Informationswissenschaft und der Informatik .
In der Neurowissenschaft und im maschinellen Lernen bezeichnet man als Drei-Faktoren-Lernen die Kombination von Hebbscher Plastizität mit einem dritten modulatorischen Faktor zur Stabilisierung und Verbesserung des
In der künstlichen Intelligenz bezeichnet „ Eager Learning“ eine Lernmethode, bei der das System während des Trainings versucht, eine allgemeine, eingabeunabhängige Zielfunktion zu konstruieren.

Im maschinellen Lernen ist Embedding eine Repräsentationslerntechnik , die komplexe, hochdimensionale Daten in einen niedrigdimensionalen Vektorraum numerischer Vektoren abbildet.

In der statistischen Lerntheorie definiert das Prinzip der empirischen Risikominimierung eine Familie von Lernalgorithmen, die auf der Bewertung ihrer Leistung anhand eines bekannten und festen Datensatzes basieren.

Entwicklungsrobotik ( DevRob ), auch epigenetische Robotik genannt , ist ein wissenschaftliches Feld, das die Entwicklungsmechanismen, Architekturen und Einschränkungen erforscht, die lebenslanges und ergebnisoffenes
Die Toronto-Erklärung zum Schutz des Rechts auf Gleichstellung und Nichtdiskriminierung in Systemen des maschinellen Lernens setzt sich für verantwortungsvolle Praktiken von Anwendern und Aufsichtsbehörden im Bereich des
Die Evaluierung eines binären Klassifikators ordnet ihm typischerweise einen oder mehrere numerische Werte zu, die seine Genauigkeit repräsentieren.
Feature Engineering ist ein Vorverarbeitungsschritt im überwachten maschinellen Lernen und in der statistischen Modellierung , der Rohdaten in einen effektiveren Eingabedatensatz umwandelt.

Im maschinellen Lernen (ML) bezeichnet Feature-Learning oder Repräsentationslernen eine Reihe von Techniken, die es einem System ermöglichen, die für die Merkmalserkennung oder Klassifizierung benötigten Repräsentationen
Im Deep Learning bezeichnet Fine - Tuning den Prozess der Anpassung eines für eine Aufgabe (die Upstream-Aufgabe ) trainierten Rechenmodells an eine andere, in der Regel spezifischere Aufgabe (die Downstream-Aufgabe ).

Flux ist eine Open-Source - Softwarebibliothek und ein Ökosystem für maschinelles Lernen, geschrieben in Julia . Die aktuelle stabile Version ist v0.16.5 .
Google Research (auch bekannt als Research at Google ) ist die Forschungsabteilung von Google , einer Tochtergesellschaft von Alphabet Inc.
In der Wahrscheinlichkeitstheorie und Statistik bezeichnet man als Basisrate (auch bekannt als A-priori-Wahrscheinlichkeiten ) die Klasse der Wahrscheinlichkeiten, die bedingungslos auf „Merkmalsbelegen“ ( Likelihoods )

Der Inception Score (IS) ist ein Algorithmus zur Bewertung der Qualität von Bildern, die von einem generativen Bildmodell wie einem Generative Adversarial Network (GAN) erzeugt werden.

In den Bereichen maschinelles Lernen , Berechnungstheorie und Zufallsmatrixtheorie wird eine Wahrscheinlichkeitsverteilung über Vektoren als isotrop bezeichnet , wenn ihre Kovarianzmatrix proportional zur Einheitsmatrix
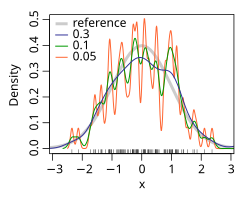
In der Statistik bezeichnet die Kerndichteschätzung ( KDE ) die Anwendung der Kernglättung zur Schätzung der Wahrscheinlichkeitsdichte .
Kognitive Robotik bzw. kognitive Technologie ist ein Teilgebiet der Robotik, das sich mit der Entwicklung intelligenter Roboter befasst.

Eine Konfusionsmatrix , auch Fehlermatrix genannt , ist eine spezielle Tabellendarstellung , die die Leistung einer Person oder eines Algorithmus bei einer bestimmten Aufgabe visualisiert.

Die Kreuzentropie- Methode ( CE- Methode ) ist eine Monte-Carlo -Methode für Importance Sampling und Optimierung .

Rankinglernen ( Learning to Ranking , LTR ) oder maschinelles Lernen ( Machine-Learned Ranking, MLR ) ist die Anwendung von maschinellem Lernen , häufig überwachtem , halbüberwachtem oder bestärkendem Lernen , zur

Im maschinellen Lernen (ML) ist eine Lernkurve (oder Trainingskurve ) eine grafische Darstellung , die zeigt, wie sich die Leistung eines Modells auf einem Trainingsdatensatz (und üblicherweise einem

In der maschinellen Lernforschung und Statistik ist die Lernrate ein Optimierungsparameter , der die Schrittweite in jeder Iteration bestimmt, während sich das Modell einem Minimum der Verlustfunktion annähert .

In der Statistik und im maschinellen Lernen ist eine lineare Prädiktorfunktion eine lineare Funktion ( Linearkombination ) aus Koeffizienten und erklärenden Variablen ( unabhängigen Variablen ), deren Wert zur Vorhersage

In der euklidischen Geometrie ist die lineare Trennbarkeit eine Eigenschaft zweier Punktmengen .
Lyra ist ein von Google entwickelter verlustbehafteter Audio-Codec , der für die Komprimierung von Sprache mit sehr niedrigen Bitraten konzipiert ist.

Maschinelles Lernen ( ML ) ist ein Forschungsgebiet der künstlichen Intelligenz, das sich mit der Entwicklung und Untersuchung statistischer Algorithmen befasst , die aus Daten lernen und auf unbekannte Daten

Die Anwendung von Methoden des maschinellen Lernens (ML), einschließlich Deep Learning , auf die Untersuchung von Quantensystemen ist ein aufstrebendes Forschungsgebiet der Physik.

MAUVE ist eine Metrik zur automatischen Bewertung der Qualität von Open-Ended- Text-Generierung und anderen generativen Modellen .

Mechanistische Interpretierbarkeit (manchmal abgekürzt als Mech-Interp , Mech-Interp oder MI ) ist ein Teilgebiet der erklärbaren künstlichen Intelligenz , das darauf abzielt, die Funktionsweise neuronaler Netze durch

MLOps oder ML Ops ist ein Paradigma, das darauf abzielt, Machine-Learning- Modelle zuverlässig und effizient in der Produktion einzusetzen und zu warten .

Mustererkennung ist die Aufgabe, Beobachtungen anhand von aus Daten extrahierten Mustern einer Klasse zuzuordnen .

Präferenzlernen ist ein Teilgebiet des maschinellen Lernens , das sich mit der Modellierung und Vorhersage von Präferenzen auf Basis beobachteter Präferenzinformationen befasst.
Proaftn ist eine Fuzzy-Klassifikationsmethode , die zur Klasse der überwachten Lernalgorithmen gehört .
Robotisches Lernen ist ein Forschungsfeld an der Schnittstelle von maschinellem Lernen und Robotik .

Schwache Überwachung (auch bekannt als semi-überwachtes Lernen ) ist ein Paradigma des maschinellen Lernens , dessen Relevanz und Bedeutung mit dem Aufkommen großer Sprachmodelle aufgrund des hohen Trainingsdatenbedarfs

Die semantische Faltungstheorie beschreibt ein Verfahren zur Kodierung der Semantik von natürlichsprachlichen Texten in einer semantisch fundierten binären Repräsentation .
Statistisches relationales Lernen ( SRL ) ist ein Teilgebiet der künstlichen Intelligenz und des maschinellen Lernens , das sich mit Domänenmodellen befasst , die sowohl Unsicherheit (die mithilfe statistischer Methoden

Strukturierte Sparsity-Regularisierung ist eine Klasse von Methoden und ein Forschungsgebiet der statistischen Lerntheorie , die Sparsity-Regularisierungslernmethoden erweitern und verallgemeinern.

Die symbolische Regression ( SR ) ist eine Art der Regressionsanalyse , die den Raum mathematischer Ausdrücke durchsucht , um das Modell zu finden, das am besten zu einem gegebenen Datensatz passt, sowohl im Hinblick auf

Im maschinellen Lernen bezeichnet der Begriff Tensor umgangssprachlich zwei unterschiedliche Konzepte: (i) eine Methode zur Datenorganisation und (ii) eine multilineare ( Tensor- )Transformation.

Transferlernen ( TL ) ist eine Technik des maschinellen Lernens (ML), bei der Wissen, das bei einer Aufgabe erlernt wurde, wiederverwendet wird, um die Leistung bei einer verwandten Aufgabe zu verbessern.
Die folgende Gliederung dient als Überblick und thematischer Leitfaden zum Thema Deep Learning :
In der Informatik bezeichnet man Daten als unsicher , wenn sie Rauschen enthalten und dadurch von den korrekten, beabsichtigten oder ursprünglichen Werten abweichen. Im Zeitalter von Big Data ist Unsicherheit bzw.
Die folgenden Tabellen stellen einen Vergleich von Software für maschinelles Lernen dar, wie z. B. Software-Frameworks , Bibliotheken und Computerprogramme, die für maschinelles Lernen verwendet werden .
Wissensintegration ist der Prozess der Synthese mehrerer Wissensmodelle (oder Repräsentationen) zu einem gemeinsamen Modell (einer gemeinsamen Repräsentation).

In der Mathematik ist eine Zeitreihe eine Folge von Datenpunkten, die in chronologischer Reihenfolge indexiert, aufgelistet oder grafisch dargestellt werden.
Das Journal of Machine Learning Research ist eine begutachtete, frei zugängliche wissenschaftliche Fachzeitschrift, die sich mit maschinellem Lernen befasst .