
[ 1 ] EinDatenbankmodellist ein Datenmodell,das die logische Struktur einerDatenbank. Es bestimmt grundlegend, wieDatengespeichert, organisiert und verarbeitet werden können. Das bekannteste Beispiel für ein Datenbankmodell ist dasrelationale Modell, das tabellenbasiert arbeitet.
Typen
Gängige logische Datenmodelle für Datenbanken sind:
- Dies ist die älteste Form des Datenbankmodells. Es wurde von IBM für IMS (Information Management System) entwickelt und stellt eine Menge organisierter Daten in Baumstruktur dar. Ein Datenbankeintrag ist ein Baum, der aus vielen Gruppen, sogenannten Segmenten, besteht. Er verwendet Eins-zu-viele-Beziehungen , und der Datenzugriff ist vorhersehbar.
- Netzwerkmodell
- Relationales Modell
- Entity-Relationship-Modell
- Objektmodell
- Dokumentenmodell
- Entitäts-Attribut-Wert-Modell
- Sternschema
Eine objektrelationale Datenbank kombiniert die beiden verwandten Strukturen.
Zu den physikalischen Datenmodellen gehören:
Weitere Modelle sind:
- Multidimensionales Modell
- Mehrwertmodell
- Semantisches Modell
- XML-Datenbank
- Benannter Graph
- Dreifachgeschäft
Beziehungen und Funktionen
Ein Datenbankmanagementsystem kann ein oder mehrere Datenmodelle bereitstellen. Die optimale Struktur hängt von der natürlichen Datenorganisation der Anwendung und ihren Anforderungen ab, darunter Transaktionsrate (Geschwindigkeit), Zuverlässigkeit, Wartbarkeit, Skalierbarkeit und Kosten. Die meisten Datenbankmanagementsysteme basieren auf einem bestimmten Datenmodell, obwohl einige Produkte auch mehrere Modelle unterstützen können.
Verschiedene physikalische Datenmodelle können jedes beliebige logische Modell implementieren. Die meisten Datenbankprogramme bieten dem Benutzer gewisse Kontrollmöglichkeiten bei der Optimierung der physikalischen Implementierung, da die getroffenen Entscheidungen einen erheblichen Einfluss auf die Leistung haben.
A model is not just a way of structuring data: it also defines a set of operations that can be performed on the data.[1] The relational model, for example, defines operations such as select, project and join. Although these operations may not be explicit in a particular query language, they provide the foundation on which a query language is built.
Flat model

The flat (or table) model consists of a single, two-dimensional array of data elements, where all members of a given column are assumed to be similar values, and all members of a row are assumed to be related to one another. For instance, columns for name and password that might be used as a part of a system security database. Each row would have the specific password associated with an individual user. Columns of the table often have a type associated with them, defining them as character data, date or time information, integers, or floating point numbers. This tabular format is a precursor to the relational model.
Early data models
These models were popular in the 1960s, 1970s, but nowadays can be found primarily in old legacy systems. They are characterized primarily by being navigational with strong connections between their logical and physical representations, and deficiencies in data independence.
Hierarchical model

In a hierarchical model, data is organized into a tree-like structure, implying a single parent for each record. A sort field keeps sibling records in a particular order. Hierarchical structures were widely used in the early mainframe database management systems, such as the Information Management System (IMS) by IBM, and now describe the structure of XML documents. This structure allows one-to-many relationship between two types of data. This structure is very efficient to describe many relationships in the real world; recipes, table of contents, ordering of paragraphs/verses, any nested and sorted information.
This hierarchy is used as the physical order of records in storage. Record access is done by navigating downward through the data structure using pointers combined with sequential accessing. Because of this, the hierarchical structure is inefficient for certain database operations when a full path (as opposed to upward link and sort field) is not also included for each record. Such limitations have been compensated for in later IMS versions by additional logical hierarchies imposed on the base physical hierarchy.
Network model

Das Netzwerkmodell erweitert die hierarchische Struktur und ermöglicht Viele-zu-Viele-Beziehungen in einer baumartigen Struktur mit mehreren übergeordneten Elementen. Es war vor seiner Ablösung durch das relationale Modell sehr verbreitet und ist in der CODASYL- Spezifikation definiert.
Das Netzwerkmodell organisiert Daten mithilfe zweier grundlegender Konzepte: Datensätze und Mengen . Datensätze enthalten Felder (die hierarchisch organisiert sein können, wie in der Programmiersprache COBOL ). Mengen (nicht zu verwechseln mit mathematischen Mengen) definieren Eins-zu-viele- Beziehungen zwischen Datensätzen: ein Eigentümer, mehrere Mitglieder. Ein Datensatz kann Eigentümer und Mitglied beliebig vieler Mengen sein.
Ein Set besteht aus zirkulären verketteten Listen, wobei ein Datensatztyp, der Set-Besitzer oder übergeordnete Datensatz, in jedem Kreis genau einmal vorkommt und ein zweiter Datensatztyp, der untergeordnete Datensatz oder untergeordnete Datensatz, mehrfach in jedem Kreis vorkommen kann. Auf diese Weise lässt sich eine Hierarchie zwischen je zwei Datensatztypen herstellen, z. B. ist Typ A der Besitzer von Typ B. Gleichzeitig kann ein weiteres Set definiert werden, in dem Typ B der Besitzer von Typ A ist. Somit bilden alle Sets einen allgemeinen gerichteten Graphen (Besitz definiert die Richtung) oder ein Netzwerk . Der Zugriff auf Datensätze erfolgt entweder sequenziell (üblicherweise innerhalb jedes Datensatztyps) oder durch Navigation in den zirkulären verketteten Listen.
Das Netzwerkmodell kann Datenredundanz effizienter darstellen als das hierarchische Modell, und es können mehrere Pfade von einem Vorfahrenknoten zu einem Nachfolgerknoten existieren. Die Operationen des Netzwerkmodells sind navigationsbasiert: Ein Programm speichert seine aktuelle Position und navigiert von einem Datensatz zum nächsten, indem es den Beziehungen folgt, an denen der Datensatz beteiligt ist. Datensätze können auch durch Angabe von Schlüsselwerten gefunden werden.
Obwohl es kein essentielles Merkmal des Modells ist, implementieren Netzwerkdatenbanken die Mengenbeziehungen im Allgemeinen mithilfe von Zeigern , die direkt auf den Speicherort eines Datensatzes auf der Festplatte verweisen. Dies ermöglicht eine hervorragende Abfrageleistung, geht jedoch auf Kosten von Operationen wie dem Laden und Reorganisieren der Datenbank.
Zu den populären DBMS-Produkten, die es nutzten, gehörten Total von Cincom Systems und IDMS von Cullinet . IDMS erlangte eine beträchtliche Kundenbasis; in den 1980er Jahren übernahm es neben seinen ursprünglichen Werkzeugen und Sprachen auch das relationale Modell und SQL.
Most object databases (invented in the 1990s) use the navigational concept to provide fast navigation across networks of objects, generally using object identifiers as "smart" pointers to related objects. Objectivity/DB, for instance, implements named one-to-one, one-to-many, many-to-one, and many-to-many named relationships that can cross databases. Many object databases also support SQL, combining the strengths of both models.
Inverted file model
In an inverted file or inverted index, the contents of the data are used as keys in a lookup table, and the values in the table are pointers to the location of each instance of a given content item. This is also the logical structure of contemporary database indexes, which might only use the contents from a particular columns in the lookup table. The inverted file data model can put indexes in a set of files next to existing flat database files, in order to efficiently directly access needed records in these files.
Notable for using this data model is the ADABAS DBMS of Software AG, introduced in 1970. ADABAS has gained considerable customer base and exists and supported until today. In the 1980s it has adopted the relational model and SQL in addition to its original tools and languages.
Document-oriented databaseClusterpoint uses inverted indexing model to provide fast full-text search for XML or JSON data objects for example.
Relational model

The relational model was introduced by E.F. Codd in 1970[2] as a way to make database management systems more independent of any particular application. It is a mathematical model defined in terms of predicate logic and set theory, and implementations of it have been used by mainframe, midrange and microcomputer systems.
The products that are generally referred to as relational databases in fact implement a model that is only an approximation to the mathematical model defined by Codd. Three key terms are used extensively in relational database models: relations, attributes, and domains. A relation is a table with columns and rows. The named columns of the relation are called attributes, and the domain is the set of values the attributes are allowed to take.
Die grundlegende Datenstruktur des relationalen Modells ist die Tabelle. Informationen über eine bestimmte Entität (z. B. einen Mitarbeiter) werden in Zeilen (auch Tupel genannt ) und Spalten dargestellt. Der Begriff „ Relation “ in „relationaler Datenbank“ bezieht sich daher auf die verschiedenen Tabellen der Datenbank; eine Relation ist eine Menge von Tupeln. Die Spalten listen die verschiedenen Attribute der Entität auf (z. B. Name, Adresse oder Telefonnummer des Mitarbeiters), und eine Zeile ist eine konkrete Instanz der Entität (ein bestimmter Mitarbeiter), die durch die Relation repräsentiert wird. Somit repräsentiert jedes Tupel der Mitarbeitertabelle verschiedene Attribute eines einzelnen Mitarbeiters.
Alle Relationen (und somit auch Tabellen) in einer relationalen Datenbank müssen bestimmte Grundregeln erfüllen, um als Relationen zu gelten. Erstens ist die Reihenfolge der Spalten in einer Tabelle irrelevant. Zweitens dürfen keine identischen Tupel oder Zeilen in einer Tabelle vorkommen. Und drittens enthält jedes Tupel für jedes seiner Attribute genau einen Wert.
Eine relationale Datenbank enthält mehrere Tabellen, die jeweils einer Tabelle im „flachen“ Datenbankmodell ähneln. Eine der Stärken des relationalen Modells besteht darin, dass prinzipiell jeder Wert, der in zwei verschiedenen Datensätzen vorkommt (unabhängig davon, ob sie zur selben oder zu verschiedenen Tabellen gehören), eine Beziehung zwischen diesen beiden Datensätzen impliziert. Um jedoch explizite Integritätsbedingungen zu gewährleisten , können Beziehungen zwischen Datensätzen in Tabellen auch explizit definiert werden, indem identifizierende oder nicht-identifizierende Eltern-Kind-Beziehungen durch die Zuweisung einer Kardinalität (1:1, (0)1:M, M:M) charakterisiert werden. Tabellen können außerdem ein einzelnes Attribut oder eine Menge von Attributen besitzen, die als „Schlüssel“ dienen und jedes Tupel in der Tabelle eindeutig identifizieren.
Ein Schlüssel, der eine Zeile in einer Tabelle eindeutig identifiziert, wird als Primärschlüssel bezeichnet. Schlüssel werden häufig verwendet, um Daten aus zwei oder mehr Tabellen zu verknüpfen oder zu kombinieren. Beispielsweise kann eine Mitarbeitertabelle eine Spalte namens „ Standort “ enthalten , deren Wert dem Schlüssel einer Standorttabelle entspricht . Schlüssel sind auch für die Erstellung von Indizes unerlässlich, die den schnellen Zugriff auf Daten aus großen Tabellen ermöglichen. Jede Spalte kann als Schlüssel dienen, oder mehrere Spalten können zu einem zusammengesetzten Schlüssel zusammengefasst werden. Es ist nicht notwendig, alle Schlüssel im Voraus zu definieren; eine Spalte kann auch dann als Schlüssel verwendet werden, wenn sie ursprünglich nicht als solcher vorgesehen war.
Ein Schlüssel mit einer externen, realen Bedeutung (wie beispielsweise ein Personenname, die ISBN eines Buches oder die Seriennummer eines Autos) wird auch als „natürlicher“ Schlüssel bezeichnet. Ist kein natürlicher Schlüssel geeignet (man denke an die vielen Personen mit dem Namen Brown ), kann ein beliebiger oder Ersatzschlüssel vergeben werden (z. B. durch die Vergabe von Mitarbeiter-IDs). In der Praxis verwenden die meisten Datenbanken sowohl generierte als auch natürliche Schlüssel. Generierte Schlüssel können intern verwendet werden, um unveränderliche Verknüpfungen zwischen Datensätzen herzustellen, während natürliche Schlüssel – wenn auch weniger zuverlässig – für Suchvorgänge und die Integration mit anderen Datenbanken genutzt werden können. (So könnten beispielsweise Datensätze in zwei unabhängig voneinander entwickelten Datenbanken anhand der Sozialversicherungsnummer abgeglichen werden , außer wenn die Sozialversicherungsnummern falsch, unvollständig oder geändert sind.)
Die am häufigsten verwendete Abfragesprache beim relationalen Modell ist die Structured Query Language ( SQL ).
Dimensionsmodell
Das dimensionale Modell ist eine spezielle Anpassung des relationalen Modells zur Darstellung von Daten in Data Warehouses . Es ermöglicht die einfache Zusammenfassung dieser Daten mithilfe von OLAP- Abfragen (Online Analytical Processing). Im dimensionalen Modell besteht das Datenbankschema aus einer einzigen großen Tabelle mit Fakten, die durch Dimensionen und Kennzahlen beschrieben werden. Eine Dimension liefert den Kontext eines Fakts (z. B. wer beteiligt war, wann und wo das Ereignis stattfand und um welche Art von Ereignis es sich handelt) und dient in Abfragen zur Gruppierung verwandter Fakten. Dimensionen sind in der Regel diskret und oft hierarchisch strukturiert; beispielsweise kann der Standort das Gebäude, das Bundesland und das Land umfassen. Eine Kennzahl ist eine Größe, die den Fakt beschreibt, wie beispielsweise der Umsatz. Es ist wichtig, dass Kennzahlen sinnvoll aggregiert werden können – beispielsweise können die Umsätze verschiedener Standorte addiert werden.
Bei einer OLAP-Abfrage werden Dimensionen ausgewählt und die Fakten gruppiert und aggregiert, um eine Zusammenfassung zu erstellen.
Das dimensionale Modell wird häufig mithilfe eines Sternschemas auf dem relationalen Modell implementiert . Dieses besteht aus einer hochgradig normalisierten Tabelle mit den Fakten und umgebenden denormalisierten Tabellen, die die einzelnen Dimensionen enthalten. Eine alternative physische Implementierung, das sogenannte Schneeflockenschema , normalisiert mehrstufige Hierarchien innerhalb einer Dimension in mehrere Tabellen.
Ein Data Warehouse kann mehrere dimensionale Schemata enthalten, die gemeinsame Dimensionstabellen verwenden, sodass sie zusammen genutzt werden können. Die Entwicklung eines Standardsatzes von Dimensionen ist ein wichtiger Bestandteil der dimensionalen Modellierung .
Seine hohe Leistungsfähigkeit hat das dimensionale Modell zur beliebtesten Datenbankstruktur für OLAP gemacht.
Postrelationale Datenbankmodelle
Products offering a more general data model than the relational model are sometimes classified as post-relational.[3] Alternate terms include "hybrid database", "Object-enhanced RDBMS" and others. The data model in such products incorporates relations but is not constrained by E.F. Codd's Information Principle, which requires that
all information in the database must be cast explicitly in terms of values in relations and in no other way
— [4]
Some of these extensions to the relational model integrate concepts from technologies that pre-date the relational model. For example, they allow representation of a directed graph with trees on the nodes. The German company sones implements this concept in its GraphDB.
Some post-relational products extend relational systems with non-relational features. Others arrived in much the same place by adding relational features to pre-relational systems. Paradoxically, this allows products that are historically pre-relational, such as PICK and MUMPS, to make a plausible claim to be post-relational.
The resource space model (RSM) is a non-relational data model based on multi-dimensional classification.[5]
Graph model
Graph databases allow even more general structure than a network database; any node may be connected to any other node.
Multivalue model
Multivalue databases are "lumpy" data, in that they can store exactly the same way as relational databases, but they also permit a level of depth which the relational model can only approximate using sub-tables. This is nearly identical to the way XML expresses data, where a given field/attribute can have multiple right answers at the same time. Multivalue can be thought of as a compressed form of XML.
An example is an invoice, which in either multivalue or relational data could be seen as (A) Invoice Header Table - one entry per invoice, and (B) Invoice Detail Table - one entry per line item. In the multivalue model, we have the option of storing the data as on table, with an embedded table to represent the detail: (A) Invoice Table - one entry per invoice, no other tables needed.
The advantage is that the atomicity of the Invoice (conceptual) and the Invoice (data representation) are one-to-one. This also results in fewer reads, less referential integrity issues, and a dramatic decrease in the hardware needed to support a given transaction volume.
Object-oriented database models
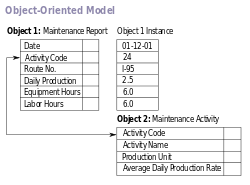
In den 1990er Jahren wurde das Paradigma der objektorientierten Programmierung auf die Datenbanktechnologie angewendet und führte zur Entwicklung eines neuen Datenbankmodells, den sogenannten Objektdatenbanken . Ziel ist es, die Diskrepanz zwischen Objekt- und relationaler Programmierung zu vermeiden – den Mehraufwand für die Konvertierung von Informationen zwischen ihrer Darstellung in der Datenbank (z. B. als Zeilen in Tabellen) und ihrer Darstellung im Anwendungsprogramm (typischerweise als Objekte). Darüber hinaus kann das in einer Anwendung verwendete Typsystem direkt in der Datenbank definiert werden, wodurch die Datenbank dieselben Datenintegritätsinvarianten gewährleisten kann. Objektdatenbanken führen außerdem die Kernkonzepte der objektorientierten Programmierung, wie Kapselung und Polymorphismus , in die Welt der Datenbanken ein.
Für die Speicherung von Objekten in einer Datenbank wurden verschiedene Ansätze erprobt. Einige Produkte gehen das Problem von der Anwendungsebene aus an, indem sie die vom Programm verarbeiteten Objekte persistent speichern . Dies erfordert typischerweise die Hinzufügung einer Abfragesprache, da herkömmliche Programmiersprachen Objekte nicht anhand ihres Informationsgehalts finden können. Andere Ansätze verfolgen einen datenbankseitigen Ansatz, indem sie ein objektorientiertes Datenmodell für die Datenbank definieren und eine Datenbankprogrammiersprache entwickeln, die sowohl umfassende Programmierfunktionen als auch traditionelle Abfragemöglichkeiten bietet.
Objektdatenbanken litten unter mangelnder Standardisierung: Obwohl die ODMG Standards definierte , wurden diese nie ausreichend implementiert, um die Interoperabilität zwischen Produkten zu gewährleisten. Dennoch wurden Objektdatenbanken in vielen Anwendungen erfolgreich eingesetzt, zumeist in spezialisierten Bereichen wie Ingenieurdatenbanken oder molekularbiologischen Datenbanken und weniger in der gängigen kommerziellen Datenverarbeitung. Die Ideen von Objektdatenbanken wurden jedoch von Anbietern relationaler Datenbanken aufgegriffen und beeinflussten Erweiterungen dieser Produkte sowie die SQL- Sprache selbst.
Eine Alternative zur Übersetzung zwischen Objekten und relationalen Datenbanken ist die Verwendung einer Objekt-Relationalen-Mapping -Bibliothek (ORM).
Siehe auch
Referenzen
- ^ a b Grundlagen von Datenbanksystemen .
- ^ E. F. Codd (1970). „Ein relationales Datenmodell für große, gemeinsam genutzte Datenbanken“. In: Communications of the ACM Archive . Band 13, Heft 6 (Juni 1970), S. 377–387.
- ^ Einführung in Datenbanken von Stephen Chu, in Conrick, M. (2006) Gesundheitsinformatik: Transformation des Gesundheitswesens durch Technologie , Thomson, ISBN 0-17-012731-1, S. 69.
- ^Date, C. J. (June 1, 1999). "When's an extension not an extension?". Intelligent Enterprise. 2 (8).
- ^Zhuge, H. (2008). The Web Resource Space Model. Web Information Systems Engineering and Internet Technologies Book Series. Vol. 4. Springer. ISBN 978-0-387-72771-4.