In UNIX -Systemen ist die Systemlast ein Maß für die Rechenleistung eines Computersystems. Die durchschnittliche Systemlast gibt die durchschnittliche Systemlast über einen bestimmten Zeitraum an. Sie wird üblicherweise in Form von drei Zahlen dargestellt, die die Systemlast der letzten ein, fünf und fünfzehn Minuten repräsentieren.
Laden
Die Unix- Lastzahl gibt die Anzahl der Prozesse an, die die CPU nutzen oder auf sie warten ; d. h. die Anzahl der Prozesse in der Warteschlange für bereite oder auszuführende Prozesse . Ein im Leerlauf befindlicher Computer hat eine Lastzahl von 0 (der Leerlaufprozess wird nicht gezählt). Jeder laufende Prozess erhöht die Lastzahl um 1. Jeder beendete Prozess verringert sie um 1. Die meisten Unix-Systeme zählen nur Prozesse im Zustand „ Läuft “ (auf der CPU) oder „Ausführbar“ (wartet auf die CPU) ( Zustand R).
Neben Prozessen im Zustand „R“ berücksichtigt Linux auch Prozesse im nicht unterbrechbaren Schlafzustand (üblicherweise warten sie auf Festplattenaktivität ; Zustand „D“). Dies kann zu deutlich abweichenden Ergebnissen führen, wenn viele Prozesse aufgrund eines ausgelasteten oder blockierten E/A-Systems blockiert bleiben. [ 1 ] Dies betrifft beispielsweise Prozesse, die aufgrund eines NFS- Serverausfalls oder zu langsamer Speichermedien (z. B. USB 1.x) blockiert werden. Solche Umstände können zu einer erhöhten Systemlast führen, die jedoch keine tatsächliche Steigerung der CPU-Auslastung widerspiegelt. Der Grundgedanke hinter dieser Einbeziehung ist, dass die Wartezeit auf die Festplatte zwar nicht mit der CPU-Wartezeit identisch ist, aber dennoch die Wartezeit des Benutzers widerspiegelt.
Auf modernen UNIX-Systemen variiert die Behandlung von Threads hinsichtlich der Systemlast. Einige Systeme behandeln Threads für die Berechnung der Systemlast wie Prozesse: Jeder Thread, der auf seine Ausführung wartet, erhöht die Last um 1. Andere Systeme, insbesondere solche mit sogenanntem M:N-Threading , verwenden jedoch unterschiedliche Strategien. Beispielsweise wird jeder Prozess für die Lastberechnung genau einmal gezählt (unabhängig von der Anzahl der Threads), oder es werden nur die Threads gezählt, die der Benutzer-Thread-Scheduler dem Kernel aktuell zur Verfügung stellt. Dies kann vom für den Prozess festgelegten Grad der Parallelität abhängen. Linux scheint jeden Thread separat zu zählen und die Last um 1 zu erhöhen. [ 2 ]
Es gibt keine Standardmethode, um die Länge der Ausführungswarteschlange auf verschiedenen Unix-ähnlichen Systemen zu ermitteln [ a ]. Eine gängige Methode besteht jedoch darin, die Ausgabe des Befehls `ps` zu analysieren und die Anzahl der Zeilen zu zählen, die mit „R“ beginnen (entsprechend Prozessen im Zustand „R“). Optional kann auch der nicht unterbrechbare Wartezustand „Disk“ hinzugefügt werden , der unter Linux und FreeBSD mit „D“ und unter macOS mit „U“ bezeichnet wird . Unter Linux und macOS kann die Option `--thread` verwendet werden, um Informationen pro Thread zu erhalten, nicht jedoch unter FreeBSD, wo stattdessen die Option `--thread` verwendet wird . [ 4 ] (Die angezeigte Last ist niemals 0, da der Prozess selbst mitgezählt wird. Um die tatsächliche Last zu erhalten, subtrahieren Sie eins von der Anzahl.) ps -ax -o stat-M-Hps
Unter Linux enthält die procfs- Datei /proc/statzwei Zeilen procs_running, die procs_blockedden Scheduling-Entitäten (Prozessen/Threads) im Zustand „R“ bzw. „D“ entsprechen. Diese Zeilen können verwendet werden, um die aktuelle Auslastung anstelle der aktuellen Auslastung zu ermitteln ps. Wie bereits erwähnt, beinhaltet die angegebene Auslastung auch das Programm, das die procfs-Datei gerade liest. Daher muss eins von der Summe subtrahiert werden, um die tatsächliche Auslastung zu erhalten. [ 5 ]
Im Vergleich zur CPU-Auslastung
Die von Ferrari et al. durchgeführte Vergleichsstudie verschiedener Lastindizes zeigte, dass die auf der CPU-Warteschlangenlänge basierende CPU-Lastinformation im Vergleich zur CPU-Auslastung eine deutlich bessere Lastverteilung ermöglicht. Der Grund dafür liegt wahrscheinlich darin, dass die CPU-Auslastung eines stark ausgelasteten Hosts nahe 100 % liegt und daher die tatsächliche Auslastung nicht präzise abbilden kann. Im Gegensatz dazu gibt die CPU-Warteschlangenlänge die tatsächliche CPU-Last direkt wieder. Beispielsweise weisen zwei Systeme – eines mit 3 und das andere mit 6 Prozessen in der Warteschlange – mit hoher Wahrscheinlichkeit eine Auslastung nahe 100 % auf, obwohl sie sich hinsichtlich der Wartezeiten der Prozesse unterscheiden. [ 6 ]
Auslastung
Alle Unix- und Unix-ähnlichen Systeme erzeugen im Kernel eine dimensionslose Metrik , die aus drei „Lastdurchschnittswerten“ besteht . Benutzer können das aktuelle Ergebnis einfach über die Unix-Shell mit folgendem Befehl abfragen: uptime
Betriebszeit : 14:34:03, Laufzeit : 10:43, 4 Benutzer, Systemlast: 0,06, 0,11, 0,09Die Befehle `load_aver` wund ` topload_aver` zeigen dieselben drei Load-Average-Werte an, ebenso wie verschiedene grafische Benutzeroberflächen . Die zugrundeliegende Schnittstelle ist `load_aver` getloadavg(), eine C-Funktion, die seit 4.3BSD-Reno von 1990 auf den meisten UNIX-Systemen vorhanden ist (aber nicht Teil von POSIX ist ). [ 7 ] Speziell unter Linux kann man /proc/loadavgdiese Informationen auch auslesen. Diese Datei liefert außerdem aktuelle Informationen über die Anzahl der Prozesse im Zustand „R“, die Gesamtzahl der Prozesse und die Prozess-ID des zuletzt erstellten Prozesses. [ 8 ]
Systeme berechnen die mittlere Last als exponentiell gedämpften/gewichteten gleitenden Mittelwert der Lastzahl . Die drei Werte der mittleren Last beziehen sich auf die letzten ein, fünf und fünfzehn Minuten des Systembetriebs. [ 9 ]
Mathematisch gesehen stellen alle drei Werte den Mittelwert der Systemlast seit Systemstart dar. Sie klingen alle exponentiell ab, jedoch unterschiedlich schnell : nach 1, 5 bzw. 15 Minuten jeweils exponentiell mit e <sup>-ε</sup>. Der 1-Minuten-Lastmittelwert setzt sich daher aus 63 % (genauer: 1 - 1/ e <sup>ε </sup>) der Last der letzten Minute und 37 % (1/ e <sup>ε</sup>) der durchschnittlichen Last seit Systemstart (ohne die letzte Minute) zusammen. Für die 5- und 15-Minuten-Lastmittelwerte wird dasselbe Verhältnis von 63 % zu 37 % über jeweils 5 bzw. 15 Minuten berechnet. Daher ist es technisch nicht ganz korrekt, dass der 1-Minuten-Lastmittelwert nur die letzten 60 Sekunden der Aktivität berücksichtigt, da er 37 % der Aktivität der Vergangenheit einschließt. Korrekt ist jedoch die Aussage, dass er hauptsächlich die letzte Minute umfasst.
Interpretation
Bei Systemen mit einem einzelnen Prozessor, die durch die CPU limitiert sind , kann die durchschnittliche Systemlast als Maß für die Systemauslastung im jeweiligen Zeitraum betrachtet werden. Bei Systemen mit mehreren Prozessoren muss die Last durch die Anzahl der Prozessoren geteilt werden, um ein vergleichbares Maß zu erhalten.
Beispielsweise kann eine durchschnittliche Systemlast von „1,73 0,60 7,98“ auf einem Ein-Kern-System wie folgt interpretiert werden:
- Während der letzten Minute war das System im Durchschnitt zu 73 % überlastet (1,73 ausführbare Prozesse, sodass im Durchschnitt 0,73 Prozesse auf einen Einsatz pro CPU warten mussten).
- In den letzten 5 Minuten war die CPU durchschnittlich 40 % der Zeit im Leerlauf.
- Während der letzten 15 Minuten war das System im Durchschnitt zu 698 % überlastet (7,98 ausführbare Prozesse, sodass im Durchschnitt 6,98 Prozesse auf einen Einsatz pro CPU warten mussten).
Dies bedeutet, dass dieses System die gesamte bis zur letzten Minute geplante Arbeit hätte bewältigen können, wenn es 1,73-mal so schnell gewesen wäre.
In einem System mit vier CPUs würde eine durchschnittliche Systemlast von 3,73 bedeuten, dass durchschnittlich 3,73 Prozesse zur Ausführung bereitstehen. Da dies weniger als 4 ist, wissen wir, dass jeder Prozess einer CPU zugewiesen werden könnte und keine Überlastung vorliegt.
Berechnung der CPU-Auslastung
Linux als Beispiel
Auf Linux-Systemen wird die Systemlast nicht bei jedem Taktzyklus berechnet, sondern durch einen variablen Wert gesteuert, der auf der HZFrequenzeinstellung basiert und bei jedem Taktzyklus überprüft wird. Diese Einstellung definiert die Taktfrequenz des Kernels in Hertz (Mal pro Sekunde) und ist standardmäßig auf 100 eingestellt.10- ms -Ticks. Kernel-Aktivitäten verwenden diese Anzahl an Ticks zur Zeitmessung. Genauer gesagt wird die calc_load()Funktion (in loadavg.h, ehemals sched.h), die die Systemlast berechnet, nominell alle LOAD_FREQ (5*HZ+1)10 ms ausgeführt, also etwas mehr als 10 ms.5 s .
extern unsigned long avenrun []; /* Load Averages */ extern void get_avenrun ( unsigned long * loads , unsigned long offset , int shift );#define FSHIFT 11 /* Anzahl der Bits Genauigkeit */ #define FIXED_1 (1<<FSHIFT) /* 1.0 als Festkomma */ #define LOAD_FREQ (5*HZ+1) /* 5-Sekunden-Intervalle */ #define EXP_1 1884 /* 1/exp(5sec/1min) als Festkomma */ #define EXP_5 2014 /* 1/exp(5sec/5min) */ #define EXP_15 2037 /* 1/exp(5sec/15min) *//* a1 = a0 * e + a * (1 - e) */ static inline unsigned long calc_load ( unsigned long load , unsigned long exp , unsigned long active ) { unsigned long newload ;newload = load * exp + active * ( FIXED_1 - exp ); if ( active >= load ) newload += FIXED_1 -1 ;return newload / FIXED_1 ; }extern unsigned long calc_load_n ( unsigned long load , unsigned long exp , unsigned long active , unsigned int n );#define LOAD_INT(x) ((x) >> FSHIFT) #define LOAD_FRAC(x) LOAD_INT(((x) & (FIXED_1-1)) * 100)Das Array `avenrun` enthält den 1-Minuten-, 5-Minuten- und 15-Minuten-Durchschnitt. Die calc_load()Funktion sorgt für die korrekte Aktualisierung der Systemlast bei der Standardaktualisierungsrate LOAD_FREQ (5*HZ+1). [ 10 ] In `loadavg.c` (ehemals `sched.c`) wird sie folgendermaßen verwendet: [ 11 ]
void calc_global_load ( void ) { unsigned long sample_window ; long active , delta ;sample_window = READ_ONCE ( calc_load_update ); if ( time_before ( jiffies , sample_window + 10 )) return ;/* * Falte das 'alte' NO_HZ-Delta, um alle NO_HZ-CPUs einzuschließen. */ delta = calc_load_nohz_read (); if ( delta ) atomic_long_add ( delta , & calc_load_tasks );active = atomic_long_read ( & calc_load_tasks ); active = active > 0 ? active * FIXED_1 : 0 ;avenrun [ 0 ] = calc_load ( avenrun [ 0 ], EXP_1 , active ); avenrun [ 1 ] = calc_load ( avenrun [ 1 ], EXP_5 , active ); avenrun [ 2 ] = calc_load ( avenrun [ 2 ], EXP_15 , active );WRITE_ONCE ( calc_load_update , sample_window + LOAD_FREQ );/* * Falls wir für mehrere LOAD_FREQ-Intervalle auf NO_HZ gewechselt haben , * werden die Berechnungen gesammelt durchgeführt. */ calc_global_nohz (); }Beachten Sie diese Vorgehensweise bei NO_HZ-CPUs. NO_HZ ist ein Modus, der die Anzahl der Taktunterbrechungen im Leerlauf reduziert, was die Energieeffizienz verbessert und Taktjitter verringert. Dies kann jedoch dazu führen, dass Prozessoren ihre Aktualisierungstakte verpassen. Daher erfolgt die Zählung der Aufgaben mithilfe atomarer Operationen. Die Funktion calc_global_nohzübernimmt die Berechnung, falls mehrere Takte nachgeholt werden müssen, und verwendet dazu folgende Funktion:
/* [1] Anwendung der geometrischen Reihe: * n 1 - x^(n+1) * S_n := \Sum x^i = ------------- * i=0 1 - x */ unsigned long calc_load_n ( unsigned long load , unsigned long exp , unsigned long active , unsigned int n ) { return calc_load ( load , fixed_power_int ( exp , FSHIFT , n ), active ); }Hier fixed_power_int(nicht im Artikel enthalten) wird exp in der Festkommaarithmetik zur n-ten Potenz potenziert.
Probenahme und Präzision
Die Berechnung der Systemlast „stichprobenartig“ ist ein gängiges Vorgehen; auch FreeBSD aktualisiert den Wert nur alle fünf Sekunden. Das Intervall ist üblicherweise nicht exakt, um Prozesse auszuschließen, die zu einem bestimmten Zeitpunkt ausgeführt werden sollen. Daher das „+1“ im obigen Linux-Code; FreeBSD verwendet stattdessen einen pseudozufälligen Offset, der dem Intervall hinzugefügt wird. [ 12 ]
loadavg.hAußerdem wird darauf hingewiesen, dass die Verwendung von 11 Nachkommastellen in der obigen Festkomma-Berechnung eine LOAD_FREQdeutliche Verkleinerung des Intervalls ( ) verhindert. Beispielsweise würde ein Intervall von zwei Sekunden zu EXP-Werten von 1981, 2034 und 2043 führen, wodurch die verfügbare Genauigkeit (0–2047) nahezu ausgeschöpft wäre. [ 10 ]
Ripke Klaus hat 2011 gezeigt, dass die Modifikation „+1“ allein nicht ausreicht, um Moiré-Artefakte bei regelmäßig ablaufenden Prozessen zu vermeiden. Seine Experimente legen nahe, dass 4,61 ein besserer Wert ist: 0,61 liegt nahe am Goldenen Schnitt , was dazu beiträgt , den Abtastpunkt über Bruchteile von Sekunden zu verteilen. Gleichzeitig liegt 4,61 nahe bei 60/13 , sodass die Eigenschaft von5 ist ein ganzzahliger Bruchteil von60 s wird beibehalten. [ 13 ] [ 14 ] Ripkes Änderung ist bei Android-Systemkerneln üblich , obwohl der verwendete Ausdruck ( 4*HZ+61) einen HZ-Wert von 100 voraussetzt. [ 15 ]60*HZ/13 wäre für variable HZ-Werte besser geeignet. Die neuen Werte wären: [ 14 ]
#define LOAD_FREQ (60*HZ/13) /* 60/13 ~ 4,61 Sekunden Intervalle */ #define EXP_1 1896 /* 1/exp(4,61sec/1min) = 1/exp(1/13) als Festkomma */ #define EXP_5 2017 /* 1/exp(4,61sec/5min) = 1/exp(1/13/5) */ #define EXP_15 2038 /* 1/exp(4,61sec/15min) = 1/exp(1/13/15) */Berechnung aus dem Benutzermodus
Wie bereits erwähnt, verwenden die meisten Kernel aus Effizienz- und Einfachheitsgründen Festkommaarithmetik zur Berechnung der durchschnittlichen Systemlast. Dies schränkt jedoch die erreichbare Aktualisierungsrate und Genauigkeit ein. Da wir nun wissen, wie die momentane Last aus dem Benutzermodus ermittelt werden kann, lässt sich auch die durchschnittliche Systemlast aus dem Benutzermodus berechnen. Der folgende Code implementiert dies in Python mit einer Aktualisierungsrate von φ ≈ 1,618 Sekunden für Zeiträume von 10 Sekunden bis zu einer Stunde:
#!/usr/bin/env python3Importzeitimport osfrom datetime import datetimefrom math import exp , logfrom dataclasses import dataclassLOGSYSPERIODS = [ log ( x ) for x in [ 60 , 300 , 900 ]]AKTUALISIERUNGSRATE = (( 5 ** 0,5 ) + 1 ) / 2 # Ripkes Goldener SchnittPERIODEN = [ 10 , 30 , 60 , 120 , 300 , 900 , 1800 , 3600 ]COUNT_DISKWAIT = True # Gibt an, ob die Wartezeit auf die Festplatte in die Ladeberechnung einbezogen werden soll@dataclassKlasse LoadEntry :Durchschnitt : Gleitkommazahlexp : floatdef initialize_loads ( now : int | float , lavgs : dict [ int , LoadEntry ]):"""Initialisierung der Lastmittelwerte basierend auf linearer Interpolation der Systemlastmittelwerte und der momentanen Lastzählung."""sys = getloadavg ()Steigungen = (( sys [ 0 ] - jetzt ) / 60 , ( sys [ 1 ] - sys [ 0 ]) / 240 , ( sys [ 2 ] - sys [ 1 ]) / 600 )für den Zeitraum in [ 10 , 30 , 60 , 120 , 300 , 900 , 1800 , 3600 ]:exp_factor = exp ( - REFRESH_RATE / period )falls Periode < 60 :est_avg = now + slopes [ 0 ] * ( period - 60 )elif period < 300 :est_avg = sys [ 0 ] + slopes [ 1 ] * ( period - 300 )anders :est_avg = sys [ 1 ] + slopes [ 2 ] * ( period - 900 )lavgs [ period ] = LoadEntry ( avg = max ( est_avg , 0 ), exp = exp_factor )def update_loads ( lavgs : dict [ int , LoadEntry ], current_load : int | float ) -> None :für _ , Eintrag in lavgs . items ():entry.avg = entry.avg * entry.exp + current_load * ( 1 - entry.exp )if os.name == " posix " :uname = os . uname ()[ 0 ] . untere ()getloadavg = os.getloadavgif uname == "linux" :def get_current_load () -> int :Last = 0with open ( "/proc/stat" , "r" ) as f :für Zeile in f :if line . startswith ( "procs_running " ):load += int ( line.split ( ) [ 1 ]) # Lies procs_runningLast -= 1 # Subtrahiere eins für uns selbstelif line . startswith ( "procs_blocked " ) and COUNT_DISKWAIT :load += int ( line.split ( ) [ 1 ]) # Lese procs_blockedRückladunganders :PS_THREAD_OPTION = "-H" if os.uname ()[ 0 ] .lower () . endswith ( " bsd" ) else " -M "PS_DISK_WAIT = "U" if os . uname ()[ 0 ] == "Darwin" else "D"PS_STATES = ( "R" + PS_DISK_WAIT ) if COUNT_DISKWAIT else "R"def get_current_load () -> int :with os . popen ( f "ps { PS_THREAD_OPTION } ax -o stat" , "r" ) as f :states = map ( f , lambda line : line.split ( ) [ - 1 ]) # Die letzte Spalte abrufen. Erforderlich unter macOS!return sum ( 1 if state [ 0 ] in PS_STATES else 0 for state in states ) - 1elif os . name == "nt" :# Es ist möglich, mithilfe der Windows-Leistungsindikatoren die Warteschlangenlänge zu ermitteln.Tatsächlich empfiehlt Microsoft dies als zusätzliche Messgröße für die Auslastung neben der CPU-Auslastung:# https://learn.microsoft.com/en-us/biztalk/technical-guides/using-the-performance-analysis-of-logs-pal-tool#processor-queue-length-analysis# Damit lässt sich auch eine ähnliche Last wie bei Unix-Systemen erzielen.from pyperfmon import pyperfmonpm = pyperfmon . pyperfmon ()ncores = os.cpu_count ( )get_counter = lambda x : pm . getCounter ( x )def get_current_load () -> float :zurückkehren (# Threads, die auf CPU warten, aber nicht laufenget_counter ( r "System\Processor Queue Length" )# Ungefähre Anzahl der Threads, die die CPU nutzen+ get_counter ( r "Processor\_Total\% Prozessorzeit" ) * ncores# Threads, die auf Festplatten-E/A warten+ get_counter ( r "PhysicalDisk\_Total\Current Disk Queue Length" )if COUNT_DISKWAITsonst 0)def getloadavg () -> tuple [ float , float , float ]:# Dummy-Implementierung für WindowsLast = get_current_load ()return ( load , load , load )def main ():lavgs : dict [ int , LoadEntry ] = {}aktuelle_Auslastung = get_current_load ()initialize_loads ( current_load , lavgs )heading = [ "SYSTIME" , " CURR" ] + [ str ( x ) for x in PERIODS ]print ( " \t " . join ( heading ))solange wahr :# Vor der Neuberechnung immer druckenentries = [ f " { datetime . now () . strftime ( '%H:%M:%S' ) } { current_load : .4f } " ]entries += [ f " { entry . avg : .4f } " for entry in lavgs . values ()]print ( " \t " . join ( entries ), flush = True )# Schlafen und warten. Dies setzt voraus, dass die Zeit, die zum Aktualisieren einer neuen Zeile benötigt wird,# winzig im Vergleich zur Schlafzeit. Falls dies nicht der Fall ist, ein# Es sollte eine Berechnung vom Typ sleepuntil() verwendet werden.time.sleep ( REFRESH_RATE )# Druckenaktuelle_Auslastung = get_current_load ()update_loads ( lavgs , current_load )if __name__ == "__main__" :hauptsächlich ()Weitere Systemleistungsbefehle
Weitere Befehle zur Beurteilung der Systemleistung umfassen:
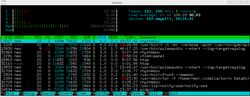
uptime– die Systemzuverlässigkeit und die durchschnittliche Auslastungtop– für einen Gesamtüberblick über das Systemhtop– interaktiver Prozessbetrachter
btop– ein weiteres Tool zur Gesamtübersicht des Systemsvmstat– vmstat meldet Informationen über ausführbare oder blockierte Prozesse, Speicher, Paging, Block-E/A, Traps und CPU.dool(früherdstat), [ 16 ]atop– hilft dabei, alle vorhandenen Ressourcendaten für Prozesse, Speicher, Paging, Block-E/A, Traps und CPU-Aktivität zu korrelieren.iftop– interaktiver Netzwerkverkehrs-Viewer pro Schnittstellenethogs– interaktiver Netzwerkverkehrs-Viewer pro Prozessiotop– interaktiver I/O-Viewer [ 17 ]iostat– für Speicher-E/A-Statistikennetstat– für Netzwerkstatistikenmpstat– für CPU-Statistikentload– Lastdurchschnittsdiagramm für Terminalxload– Lastdurchschnittsdiagramm für X
Siehe auch
Anmerkungen
Referenzen
- ^ „Linux Tech Support: Was genau ist eine Systemlastdurchschnittsmessung?“ . 23. Oktober 2008.
- ^ Siehe http://serverfault.com/a/524818/27813
- ^ – Shell- und Dienstprogrammreferenz, Die einheitliche UNIX-Spezifikation , Version 5 von The Open Group
- ^
- – Linux- Benutzerhandbuch – Benutzerbefehle
- – FreeBSD Allgemeines Befehlshandbuch
- – Darwin und macOS Allgemeine Befehle Handbuch
- ^ „Verschiedene Kernel-Statistiken in /proc/stat“ . Abgerufen am 4. Oktober 2023 .
- ^ Ferrari, Domenico; und Zhou, Songnian; „ Eine empirische Untersuchung von Lastindizes für Lastverteilungsanwendungen “, Proceedings of Performance '87, dem 12. Internationalen Symposium über Computerleistungsmodellierung, -messung und -bewertung, North Holland Publishers, Amsterdam, Niederlande, 1988, S. 515–528
- ^ – FreeBSD - Systemaufrufhandbuch
- ^ – Linux- Programmierhandbuch– Dateiformate
- ^ Walker, Ray (1. Dezember 2006). „Untersuchung der Systemlast“ . Linux Journal . Abgerufen am 13. März 2012 .
- ^ a b "Linux v6.17 :: include/linux/sched/loadavg.h" .
- ^ "Linux v6.17 :: kernel/sched/loadavg.c" .
- ^ "Wie wird die Systemlast unter FreeBSD berechnet?" . Unix & Linux Stack Exchange .
- ^ Ripke, Klaus (2011). „Linux-Kernel-Archiv: vermeidet Moiré“ . lkml.iu.edu .
LOAD_FREQ (4*HZ+61)loadavg - ^ a b Ripke, Klaus (2011). "Moiré patterns in linux load average" .(Diagramm zur Veranschaulichung des Musters; späterer Kommentar für 60*HZ/13)
- ^ „Kernel-Patch mit der 4,61-Sekunden-Ladefunktion · Problem Nr. 2109 · AOSC-Dev/aosc-os-abbs“ . GitHub .
- ^ Baker, Scott (28. September 2022). „dool – Python3-kompatibler Klon von dstat“ . GitHub . Abgerufen am 22. November 2022. …
Dag Wieers hat die Entwicklung von Dstat eingestellt…
- ^ "Iotop(8) - Linux-Handbuchseite" .
Externe Links
- Brendan Gregg (8. August 2017). „Linux Load Averages: Solving the Mystery“ . Abgerufen am 22. Januar 2018 .
- Neil J. Gunther . „UNIX Load Average – Teil 1: Wie es funktioniert“ (PDF) . TeamQuest . Abgerufen am 12. August 2009 .
- Andre Lewis (31. Juli 2009). „Linux-CPU-Auslastung verstehen – wann sollte man sich Sorgen machen?“ . Abgerufen am 21. Juli 2011 .Erläuterung anhand einer illustrierten Verkehrsanalogie.
- Ray Walker (1. Dezember 2006). „Untersuchung der Systemlast“ . Linux Journal . Abgerufen am 21. Juli 2011 .
- Karsten Becker. „Linux OSS Load Monitoring Toolset“ . LoadAvg.