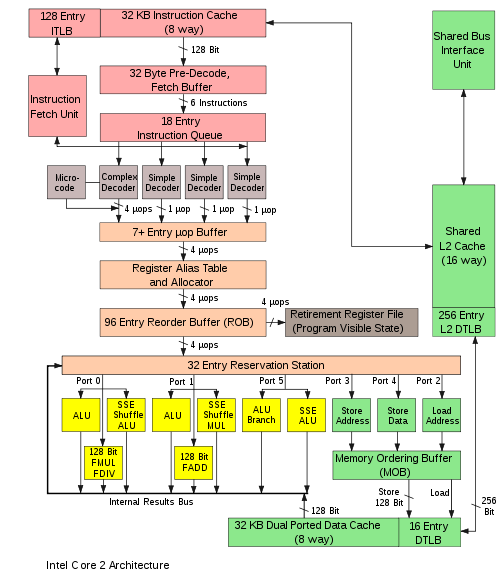
In der Elektronik , Informatik und Computertechnik bezeichnet die Mikroarchitektur , auch Rechnerorganisation genannt und manchmal als μarch oder uarch abgekürzt , die Art und Weise, wie eine bestimmte Befehlssatzarchitektur (ISA) in einem bestimmten Prozessor implementiert wird . [ 1 ] Eine gegebene ISA kann mit verschiedenen Mikroarchitekturen implementiert werden; [ 2 ] [ 3 ] Implementierungen können aufgrund unterschiedlicher Ziele eines bestimmten Designs oder aufgrund von Technologieentwicklungen variieren. [ 4 ]
Die Computerarchitektur ist die Kombination aus Mikroarchitektur und Befehlssatzarchitektur.
Bezug zur Befehlssatzarchitektur

Die Befehlssatzarchitektur (ISA) entspricht im Wesentlichen dem Programmiermodell eines Prozessors aus Sicht eines Assemblerprogrammierers oder Compilerentwicklers. Die ISA umfasst unter anderem die Befehle , das Ausführungsmodell , die Prozessorregister sowie Adress- und Datenformate. Die Mikroarchitektur beschreibt die einzelnen Komponenten des Prozessors und deren Verbindungen und Zusammenspiel zur Implementierung der ISA.
Die Mikroarchitektur einer Maschine wird üblicherweise in (mehr oder weniger detaillierten) Diagrammen dargestellt, die die Verbindungen der verschiedenen mikroarchitektonischen Elemente der Maschine beschreiben. Diese Elemente können von einzelnen Gattern und Registern bis hin zu kompletten arithmetisch-logischen Einheiten (ALUs) und noch größeren Bausteinen reichen. Im Allgemeinen trennen diese Diagramme den Datenpfad (wo die Daten abgelegt werden) vom Steuerpfad (der die Daten steuert). [ 5 ]
Der Systementwickler stellt die spezifische Mikroarchitektur üblicherweise als eine Art Datenflussdiagramm dar . Ähnlich einem Blockdiagramm zeigt das Mikroarchitekturdiagramm mikroarchitektonische Elemente wie die arithmetisch-logische Einheit und das Registerfile als einzelnes Schaltbildsymbol. Typischerweise verbindet das Diagramm diese Elemente mit Pfeilen, dicken und dünnen Linien, um zwischen Drei-Zustands-Bussen (die für jedes ansteuernde Gerät einen Drei-Zustands-Puffer benötigen), unidirektionalen Bussen (die immer von einer einzigen Quelle angesteuert werden, wie beispielsweise der Adressbus einfacherer Computer, der immer vom Speicheradressregister angesteuert wird ) und einzelnen Steuerleitungen zu unterscheiden. Sehr einfache Computer verfügen über eine einzige Datenbusorganisation – sie besitzen einen einzigen Drei-Zustands-Bus . Das Diagramm komplexerer Computer zeigt üblicherweise mehrere Drei-Zustands-Busse, die es der Maschine ermöglichen, mehrere Operationen gleichzeitig auszuführen.
Jedes mikroarchitektonische Element wird durch ein Schaltbild dargestellt , das die Verbindungen der zu seiner Implementierung verwendeten Logikgatter beschreibt . Jedes Logikgatter wiederum wird durch ein Schaltbild dargestellt , das die Verbindungen der Transistoren beschreibt, die zu seiner Implementierung in einer bestimmten Logikfamilie verwendet werden. Rechner mit unterschiedlichen Mikroarchitekturen können dieselbe Befehlssatzarchitektur (ISA) aufweisen und somit dieselben Programme ausführen. Neue Mikroarchitekturen und/oder Schaltungslösungen sowie Fortschritte in der Halbleiterfertigung ermöglichen es neueren Prozessorgenerationen, mit derselben ISA eine höhere Leistung zu erzielen.
Prinzipiell könnte eine einzelne Mikroarchitektur mehrere verschiedene ISAs mit nur geringfügigen Änderungen am Mikrocode ausführen .
Aspekte

Der Pipeline- Datenpfad ist heutzutage das am häufigsten verwendete Datenpfaddesign in der Mikroarchitektur. Diese Technik kommt in den meisten modernen Mikroprozessoren, Mikrocontrollern und digitalen Signalprozessoren (DSPs) zum Einsatz . Die Pipeline-Architektur ermöglicht die überlappende Ausführung mehrerer Befehle, ähnlich einem Fließband. Die Pipeline umfasst verschiedene Stufen, die für den Entwurf von Mikroarchitekturen grundlegend sind. [ 5 ] Zu diesen Stufen gehören das Abrufen, Dekodieren, Ausführen und Zurückschreiben von Befehlen. Manche Architekturen beinhalten weitere Stufen wie den Speicherzugriff. Der Entwurf von Pipelines zählt zu den zentralen Aufgaben der Mikroarchitektur.
Ausführungseinheiten sind ebenfalls essenziell für die Mikroarchitektur. Zu ihnen gehören arithmetisch-logische Einheiten (ALU), Gleitkommaeinheiten (FPU), Lade-/Speichereinheiten, Sprungvorhersage und SIMD . Diese Einheiten führen die Operationen bzw. Berechnungen des Prozessors aus. Die Wahl der Anzahl der Ausführungseinheiten sowie ihrer Latenz und ihres Durchsatzes ist eine zentrale Aufgabe beim mikroarchitektonischen Entwurf. Auch die Größe, Latenz, der Durchsatz und die Vernetzung der Speicher innerhalb des Systems sind mikroarchitektonische Entscheidungen.
Systembezogene Designentscheidungen, wie beispielsweise die Frage, ob Peripheriegeräte wie Speichercontroller integriert werden sollen oder nicht , können als Teil des mikroarchitektonischen Designprozesses betrachtet werden. Dies umfasst Entscheidungen über die Leistungsfähigkeit und die Konnektivität dieser Peripheriegeräte.
Anders als beim Architekturdesign, bei dem die Erreichung eines bestimmten Leistungsniveaus im Vordergrund steht, berücksichtigt das Mikroarchitekturdesign weitere Randbedingungen. Da sich Entscheidungen im Mikroarchitekturdesign direkt auf die Systemkomponenten auswirken, müssen Aspekte wie Chipfläche/Kosten, Stromverbrauch, Logikkomplexität, einfache Konnektivität, Herstellbarkeit, einfache Fehlersuche und Testbarkeit beachtet werden.
Mikroarchitektonische Konzepte
Anweisungszyklen
Zum Ausführen von Programmen benötigen alle Einzel- oder Mehrchip-CPUs:
- Lies eine Anweisung und entschlüssele sie.
- Suchen Sie alle zugehörigen Daten, die zur Verarbeitung der Anweisung benötigt werden.
- Führen Sie die Anweisung aus.
- Schreibe die Ergebnisse auf
Der Befehlszyklus wird so lange wiederholt, bis die Stromzufuhr unterbrochen wird.
Multizyklus-Mikroarchitektur
Historisch gesehen waren die ersten Computer Multicycle-Architekturen. Die kleinsten und kostengünstigsten Computer nutzen diese Technik oft noch heute. Multicycle-Architekturen benötigen häufig die geringste Anzahl an Logikelementen und einen angemessenen Stromverbrauch. Sie können so ausgelegt werden, dass sie deterministisches Timing und hohe Zuverlässigkeit aufweisen. Insbesondere gibt es bei ihnen keine Pipeline, die bei bedingten Verzweigungen oder Interrupts blockiert werden könnte. Andere Mikroarchitekturen führen jedoch oft mehr Befehle pro Zeiteinheit aus, wobei dieselbe Logikfamilie verwendet wird. Wenn von „verbesserter Leistung“ die Rede ist, wird eine Verbesserung häufig relativ zu einer Multicycle-Architektur betrachtet.
In einem Mehrzyklusrechner werden die vier Schritte nacheinander über mehrere Taktzyklen ausgeführt. Manche Systeme können die Sequenz in zwei Taktzyklen realisieren, indem aufeinanderfolgende Schritte an alternierenden Taktflanken abgeschlossen werden, wobei längere Operationen gegebenenfalls außerhalb des Hauptzyklus stattfinden. Beispielsweise Schritt eins an der steigenden Flanke des ersten Zyklus, Schritt zwei an der fallenden Flanke usw.
In der Steuerlogik bestimmt die Kombination aus Zykluszähler, Zykluszustand (hoch oder niedrig) und den Bits des Befehlsdekodierungsregisters exakt, was jeder Teil des Computers tun soll. Zur Entwicklung der Steuerlogik kann man eine Bittabelle erstellen, die die Steuersignale an jeden Teil des Computers in jedem Zyklus jedes Befehls beschreibt. Diese Logiktabelle kann dann in einer Softwaresimulation mit Testcode geprüft werden. Wird die Logiktabelle im Speicher abgelegt und zum Betrieb eines realen Computers verwendet, spricht man von einem Mikroprogramm . In manchen Computerdesigns wird die Logiktabelle mithilfe eines Optimierungsprogramms in Form von kombinatorischer Logik aus Logikgattern optimiert. Frühe Computer verwendeten ad-hoc-Logikdesigns für die Steuerung, bis Maurice Wilkes diesen tabellarischen Ansatz entwickelte und ihn Mikroprogrammierung nannte. [ 6 ]
Erhöhung der Ausführungsgeschwindigkeit
Erschwerend kommt hinzu, dass die Speicherhierarchie, bestehend aus Caching , Hauptspeicher und nichtflüchtigen Speichern wie Festplatten (auf denen die Programmbefehle und Daten gespeichert werden), stets langsamer war als der Prozessor selbst. Schritt (2) führt häufig zu einer (CPU-mäßig) langen Verzögerung, während die Daten über den Computerbus übertragen werden . Umfangreiche Forschungsarbeiten wurden in Designs investiert, die diese Verzögerungen weitestgehend vermeiden. Ein zentrales Ziel war es über die Jahre, mehr Befehle parallel auszuführen und so die effektive Ausführungsgeschwindigkeit eines Programms zu erhöhen. Diese Bemühungen führten zu komplexen Logik- und Schaltungsstrukturen. Anfänglich konnten diese Techniken aufgrund des erforderlichen Schaltungsaufwands nur auf teuren Großrechnern oder Supercomputern implementiert werden. Mit dem Fortschritt der Halbleiterfertigung ließen sich immer mehr dieser Techniken auf einem einzigen Halbleiterchip realisieren. Siehe Mooresches Gesetz .
Befehlssatzauswahl
Befehlssätze haben sich im Laufe der Jahre stark verändert, von ursprünglich sehr einfach zu teils sehr komplex (in vielerlei Hinsicht). In den letzten Jahren waren Load-Store-Architekturen , VLIW- und EPIC- Architekturen weit verbreitet. Architekturen, die Datenparallelität nutzen, umfassen SIMD und Vektoren . Manche Bezeichnungen für CPU-Architekturen sind wenig aussagekräftig, insbesondere die Bezeichnung CISC; viele frühe Designs, die rückwirkend als „ CISC “ bezeichnet wurden, sind in Wirklichkeit deutlich einfacher als moderne RISC-Prozessoren (in vielerlei Hinsicht).
Die Wahl der Befehlssatzarchitektur kann die Komplexität der Implementierung von Hochleistungsgeräten erheblich beeinflussen. Die gängige Strategie bei der Entwicklung der ersten RISC-Prozessoren bestand darin, die Befehle auf ein Minimum an semantischer Komplexität zu reduzieren und gleichzeitig eine hohe Kodierungsregelmäßigkeit und Einfachheit zu gewährleisten. Solche einheitlichen Befehle ließen sich leicht abrufen, dekodieren und pipelined ausführen. Eine einfache Strategie zur Reduzierung der Logikstufen ermöglichte hohe Betriebsfrequenzen. Befehlscache-Speicher kompensierten die höhere Betriebsfrequenz und die geringere Codedichte, während große Registersätze die (langsamen) Speicherzugriffe so weit wie möglich auslagerten.
Anweisungspipeline
Eine der ersten und wirkungsvollsten Techniken zur Leistungssteigerung ist die Verwendung von Befehlspipelining . Frühe Prozessorarchitekturen führten alle oben genannten Schritte für einen Befehl aus, bevor sie zum nächsten übergingen. Große Teile der Schaltung blieben dabei in jedem Schritt ungenutzt; beispielsweise war die Befehlsdekodierungsschaltung während der Ausführung inaktiv.
Pipelining verbessert die Leistung, indem es ermöglicht, dass mehrere Befehle gleichzeitig vom Prozessor verarbeitet werden. Im gleichen Beispiel würde der Prozessor mit der Dekodierung (Schritt 1) eines neuen Befehls beginnen, während der vorherige auf das Ergebnis wartet. Dadurch können bis zu vier Befehle gleichzeitig ausgeführt werden, wodurch der Prozessor scheinbar viermal so schnell ist. Obwohl die Ausführung eines einzelnen Befehls genauso lange dauert (es sind weiterhin vier Schritte), verarbeitet die CPU insgesamt Befehle deutlich schneller.
RISC ermöglicht kleinere und deutlich einfacher zu realisierende Pipelines, indem jede Stufe des Befehlsprozesses klar getrennt und in jeweils einem Taktzyklus ausgeführt wird. Der Prozessor arbeitet wie ein Fließband: Befehle werden auf der einen Seite empfangen, Ergebnisse auf der anderen ausgegeben. Dank der reduzierten Komplexität der klassischen RISC-Pipeline konnten der pipelined Kern und ein Befehlscache auf demselben Chip untergebracht werden, auf dem bei einem CISC-Design nur der Kern Platz gefunden hätte. Dies war der eigentliche Grund für die höhere Geschwindigkeit von RISC. Frühe Designs wie SPARC und MIPS waren bei gleicher Taktfrequenz und gleichem Preis oft mehr als zehnmal so schnell wie Intel- und Motorola -CISC-Lösungen.
Pipelines sind keineswegs auf RISC-Architekturen beschränkt. Bereits 1986 war die Spitzenversion der VAX-Architektur ( VAX 8800 ) stark pipelined und damit den ersten kommerziellen MIPS- und SPARC-Architekturen einen Schritt voraus. Die meisten modernen CPUs (auch Embedded-CPUs) arbeiten heute pipelined, und mikrocodierte CPUs ohne Pipelining finden sich nur noch in den platzsparendsten Embedded-Prozessoren. Große CISC-Maschinen, vom VAX 8800 bis hin zu den modernen Intel- und AMD-Prozessoren, nutzen sowohl Mikrocode als auch Pipelines. Verbesserungen bei Pipelining und Caching sind die beiden wichtigsten mikroarchitektonischen Fortschritte, die es ermöglicht haben, dass die Prozessorleistung mit der zugrundeliegenden Schaltungstechnologie Schritt halten konnte.
Cache
Es dauerte nicht lange, bis Verbesserungen in der Chipfertigung es ermöglichten, noch mehr Schaltkreise auf dem Chip unterzubringen , und Entwickler suchten nach Möglichkeiten, diese zu nutzen. Eine der gängigsten Methoden war die Integration eines stetig wachsenden Cache-Speichers auf dem Chip. Cache ist ein sehr schneller und kostengünstiger Speicher. Der Zugriff auf den Cache erfolgt in wenigen Zyklen, im Gegensatz zu den vielen Zyklen, die für die Kommunikation mit dem Hauptspeicher benötigt werden. Die CPU verfügt über einen Cache-Controller, der das Lesen und Schreiben aus dem Cache automatisiert. Befinden sich die Daten bereits im Cache, werden sie von dort abgerufen – was eine erhebliche Zeitersparnis bedeutet. Andernfalls wird der Prozessor angehalten, während der Cache-Controller die Daten einliest.
RISC-Architekturen begannen Mitte bis Ende der 1980er-Jahre mit der Integration eines Caches, der anfangs oft nur 4 KB umfasste. Diese Größe wuchs im Laufe der Zeit, und typische CPUs verfügen heute über mindestens 2 MB, während leistungsstärkere CPUs mit 4, 6, 12 MB oder sogar 32 MB und mehr ausgestattet sind. Die größte Cache-Größe von 768 MB findet sich in der neu erschienenen EPYC Milan-X-Reihe, die in einer mehrstufigen Speicherhierarchie organisiert ist . Generell gilt: Mehr Cache bedeutet höhere Leistung aufgrund reduzierter Wartezeiten.
Caches und Pipelines ergänzten sich ideal. Früher war es wenig sinnvoll, eine Pipeline zu entwickeln, die schneller als die Zugriffszeit des externen Speichers laufen konnte. Durch die Verwendung von On-Chip-Cache-Speicher konnte eine Pipeline mit der Zugriffszeit des Caches ausgeführt werden – also in deutlich kürzerer Zeit. Dadurch konnten die Taktfrequenzen von Prozessoren wesentlich schneller steigen als die des externen Speichers.
Zweigvorhersage
Eine Hürde für höhere Leistung durch Befehlsparallelität sind Pipeline-Verzögerungen und -Leerungen aufgrund von Verzweigungen. Normalerweise ist erst spät in der Pipeline bekannt, ob eine bedingte Verzweigung ausgeführt wird, da diese von Registerwerten abhängt. Vom Zeitpunkt, an dem der Befehlsdecoder des Prozessors eine bedingte Verzweigungsanweisung erkennt, bis zum Auslesen des entscheidenden Registerwerts muss die Pipeline für mehrere Zyklen angehalten werden. Wird die Verzweigung ausgeführt, muss die Pipeline geleert werden. Mit steigender Taktfrequenz erhöht sich die Tiefe der Pipeline; moderne Prozessoren verfügen teilweise über 20 oder mehr Stufen. Im Durchschnitt ist jede fünfte ausgeführte Anweisung eine Verzweigung. Ohne Gegenmaßnahmen führt dies zu einer hohen Anzahl von Verzögerungen.
Techniken wie Sprungvorhersage und spekulative Ausführung werden eingesetzt, um die Kosten von Sprüngen zu reduzieren. Bei der Sprungvorhersage trifft die Hardware fundierte Annahmen darüber, ob ein bestimmter Sprung ausgeführt wird. Tatsächlich wird eine Seite des Sprungs deutlich häufiger aufgerufen als die andere. Moderne Architekturen verfügen über komplexe statistische Vorhersagesysteme, die die Ergebnisse vergangener Sprünge analysieren, um zukünftige Sprünge genauer vorherzusagen. Die Vorhersage ermöglicht es der Hardware, Befehle vorzuladen, ohne auf das Lesen der Register warten zu müssen. Spekulative Ausführung ist eine weitere Verbesserung, bei der der Code entlang des vorhergesagten Pfades nicht nur vorgeladen, sondern auch ausgeführt wird, bevor feststeht, ob der Sprung ausgeführt werden soll oder nicht. Dies kann die Leistung verbessern, wenn die Vorhersage korrekt ist, birgt aber das Risiko erheblicher Kosten, wenn die Vorhersage falsch ist, da Befehle rückgängig gemacht werden müssen.
Superskalar
Trotz der zusätzlichen Komplexität und der benötigten Logikgatter zur Unterstützung der oben beschriebenen Konzepte ermöglichten Verbesserungen in der Halbleiterfertigung schon bald den Einsatz noch größerer Logikgatter.
Im obigen Schema verarbeitet der Prozessor jeweils Teile eines einzelnen Befehls. Computerprogramme könnten schneller ausgeführt werden, wenn mehrere Befehle gleichzeitig verarbeitet würden. Genau das erreichen superskalare Prozessoren durch die Replikation von Funktionseinheiten wie ALUs. Die Replikation von Funktionseinheiten wurde erst möglich, als die Chipfläche eines herkömmlichen Prozessors die Grenzen der zuverlässigen Fertigung nicht mehr überschritt. Ende der 1980er-Jahre kamen superskalare Designs auf den Markt.
In modernen Architekturen findet man häufig zwei Ladeeinheiten, eine Speichereinheit (viele Befehle liefern keine zu speichernden Ergebnisse), zwei oder mehr Einheiten für Ganzzahlberechnungen, zwei oder mehr Gleitkommaeinheiten und oft auch eine SIMD- Einheit. Die Befehlsausgabe wird komplexer, indem eine große Liste von Befehlen aus dem Speicher eingelesen und an die verschiedenen, gerade freien Ausführungseinheiten übergeben wird. Die Ergebnisse werden anschließend gesammelt und neu geordnet.
Ausführung außerhalb der Reihenfolge
Durch den Einsatz von Caches wird die Häufigkeit und Dauer von Wartezeiten aufgrund des Abrufens von Daten aus dem Speicher reduziert, jedoch nicht vollständig beseitigt. In frühen Designs zwang ein Cache-Fehler den Cache-Controller, den Prozessor anzuhalten und zu warten. Natürlich kann es vorkommen, dass Daten für andere Anweisungen im Cache verfügbar sind . Die Out-of-Order-Ausführung ermöglicht die Verarbeitung dieser bereitstehenden Anweisung, während eine ältere Anweisung auf den Cache wartet. Anschließend werden die Ergebnisse neu geordnet, sodass es den Anschein hat, als sei alles in der programmierten Reihenfolge ausgeführt worden. Diese Technik wird auch verwendet, um Wartezeiten aufgrund anderer Operandenabhängigkeiten zu vermeiden, beispielsweise wenn eine Anweisung auf das Ergebnis einer Gleitkommaoperation mit langer Latenz oder anderer Operationen mit mehreren Taktzyklen wartet.
Registerumbenennung
Die Registerumbenennung ist eine Technik, die die unnötige serielle Ausführung von Programmbefehlen aufgrund der Wiederverwendung derselben Register durch diese Befehle vermeidet. Angenommen, wir haben zwei Befehlsgruppen, die dasselbe Register verwenden . Eine Befehlsgruppe wird zuerst ausgeführt, um das Register für die andere Gruppe freizugeben. Wenn die andere Gruppe jedoch einem anderen, ähnlichen Register zugewiesen wird, können beide Befehlsgruppen parallel oder seriell ausgeführt werden.
Multiprocessing und Multithreading
Computerarchitekten stießen angesichts der zunehmenden Diskrepanz zwischen CPU-Betriebsfrequenzen und DRAM- Zugriffszeiten an ihre Grenzen. Keine der Techniken, die Befehlsparallelität (ILP) innerhalb eines Programms nutzten, konnte die langen Wartezeiten beim Abrufen von Daten aus dem Hauptspeicher kompensieren. Zudem erforderten die für die fortgeschritteneren ILP-Techniken notwendigen hohen Transistoranzahlen und Betriebsfrequenzen eine Verlustleistung, die nicht mehr kostengünstig gekühlt werden konnte. Aus diesen Gründen nutzen neuere Computergenerationen nun höhere Parallelitätsgrade außerhalb eines einzelnen Programms oder Programmthreads .
Dieser Trend wird mitunter als Durchsatzberechnung bezeichnet . Die Idee entstand im Mainframe-Markt, wo bei der Online-Transaktionsverarbeitung nicht nur die Ausführungsgeschwindigkeit einzelner Transaktionen, sondern auch die Fähigkeit zur Verarbeitung großer Transaktionsmengen im Vordergrund stand. Da transaktionsbasierte Anwendungen wie Netzwerk-Routing und Web-Serving im letzten Jahrzehnt stark zugenommen haben, rückt die Computerindustrie die Themen Kapazität und Durchsatz wieder stärker in den Fokus.
Eine Möglichkeit, diese Parallelität zu erreichen, bieten Multiprozessorsysteme , also Computersysteme mit mehreren CPUs. Waren sie einst High-End- Mainframes und Supercomputern vorbehalten , sind kleine Multiprozessorserver (2–8) mittlerweile Standard für kleine Unternehmen. Auch große Konzerne setzen häufig auf Multiprozessorsysteme (16–256). Selbst PCs mit mehreren CPUs sind seit den 1990er-Jahren erhältlich.
Dank der durch Fortschritte in der Halbleitertechnologie ermöglichten weiteren Miniaturisierungen von Transistoren sind Mehrkernprozessoren entstanden, bei denen mehrere CPUs auf demselben Siliziumchip implementiert sind. Anfänglich wurden sie in Chips für eingebettete Systeme eingesetzt, da einfachere und kleinere CPUs die Integration mehrerer Instanzen auf einem einzigen Siliziumchip ermöglichten. Ab 2005 erlaubte die Halbleitertechnologie die Serienfertigung von Dual-End-Desktop-CPUs auf CMP- Chipbasis. Einige Designs, wie beispielsweise der UltraSPARC T1 von Sun Microsystems , greifen wieder auf einfachere (skalare, In-Order-)Architekturen zurück, um mehr Prozessoren auf einem Siliziumchip unterzubringen.
Eine weitere Technik, die in letzter Zeit an Popularität gewonnen hat, ist Multithreading . Beim Multithreading wechselt der Prozessor, anstatt auf das Eintreffen der Daten zu warten, zu einem anderen Programm oder Thread, der zur Ausführung bereit ist, wenn er Daten aus dem langsamen Systemspeicher abrufen muss. Dies beschleunigt zwar nicht das jeweilige Programm oder den Thread, erhöht aber den Gesamtdurchsatz des Systems, indem die Leerlaufzeit der CPU reduziert wird.
Konzeptionell entspricht Multithreading einem Kontextwechsel auf Betriebssystemebene. Der Unterschied besteht darin, dass eine Multithread-fähige CPU einen Threadwechsel in einem einzigen CPU-Zyklus durchführen kann, anstatt der Hunderte oder Tausende von CPU-Zyklen, die ein Kontextwechsel normalerweise benötigt. Dies wird erreicht, indem die Zustandshardware (wie Registerdatei und Programmzähler ) für jeden aktiven Thread repliziert wird.
Eine weitere Verbesserung ist das simultane Multithreading . Diese Technik ermöglicht es superskalaren CPUs, Anweisungen aus verschiedenen Programmen/Threads gleichzeitig im selben Taktzyklus auszuführen.
Siehe auch
- Steuereinheit
- Hardwarearchitektur
- Hardwarebeschreibungssprache (HDL)
- Parallelität auf Anweisungsebene (ILP)
- Liste der AMD-CPU-Mikroarchitekturen
- Liste der Intel-CPU-Mikroarchitekturen
- Liste der ARM-CPU-Mikroarchitekturen
- Prozessordesign
- Streamverarbeitung
- VHDL
- Sehr große Integrationsstufen (VLSI)
- Verilog
- Vergleich von CPU-Mikroarchitekturen
Referenzen
- ^ Richtlinien für den Studienplan von Bachelorstudiengängen in Computertechnik (PDF) . Association for Computing Machinery. 2004. S. 60. Archiviert vom Original (PDF) am 03.07.2017.
Anmerkungen zur Rechnerarchitektur und -organisation: Rechnerarchitektur ist ein zentraler Bestandteil der Computertechnik, und praktizierende Computertechniker sollten über ein praktisches Verständnis dieses Themas verfügen…
- ^ Murdocca, Miles; Heuring, Vincent (2007). Computerarchitektur und -organisation: Ein integrierter Ansatz . Wiley. S. 151. ISBN 9780471733881Die
- ^ Clements, Alan. Principles of Computer Hardware (4. Aufl.). S. 1–2 .
- ^ Flynn, Michael J. (2007). „Einführung in die Architektur und die Funktionsweise von Rechnern“ . Rechnerarchitektur: Pipelined und paralleler Prozessorentwurf . Jones and Bartlett. S. 1–3 . ISBN 9780867202045Die
- ^ a b Hennessy, John L. ; Patterson, David A. (2006). Computer Architecture: A Quantitative Approach (4. Aufl.). Morgan Kaufmann. ISBN 0-12-370490-1Die
- ^ Wilkes, MV (1969). „Das wachsende Interesse an Mikroprogrammierung: Eine Literaturübersicht“ . ACM Computing Surveys . 1 (3): 139–145 . doi : 10.1145/356551.356553 . S2CID 10673679 .
Weiterführende Literatur
- Vorlesungen zur Rechnerarchitektur an der Carnegie Mellon University
- Patterson, D.; Hennessy, J. (2004). Rechnerorganisation und -design: Die Hardware/Software-Schnittstelle . Morgan Kaufmann. ISBN 1-55860-604-1Die
- Hamacher, V. C.; Vrasenic, Z. G.; Zaky, S. G. (2001). Rechnerorganisation . McGraw-Hill. ISBN 0-07-232086-9Die
- Stallings, William (2002). Rechnerorganisation und -architektur . Prentice Hall. ISBN 0-13-035119-9Die
- Hayes, J. P. (2002). Rechnerarchitektur und -organisation . McGraw-Hill. ISBN 0-07-286198-3Die
- Schneider, Gary Michael (1985). Die Prinzipien der Rechnerorganisation . Wiley. S. 6–7 . ISBN 0-471-88552-5Die
- Mano, M. Morris (1992). Rechnerarchitektur . Prentice Hall. S. 3. ISBN 0-13-175563-3Die
- Abd-El-Barr, Mostafa; El-Rewini, Hesham (2004). Grundlagen der Rechnerorganisation und -architektur . Wiley. S. 1. ISBN 0-471-46741-3Die
- Gardner, J (2001). "PC-Prozessor-Mikroarchitektur" . ExtremeTech.
- Gilreath, William F.; Laplante, Phillip A. (2012) [2003]. Computerarchitektur: Eine minimalistische Perspektive . Springer. ISBN 978-1-4615-0237-1Die
- Patterson, David A. (10. Oktober 2018). Ein neues goldenes Zeitalter für die Rechnerarchitektur . US Berkeley ACM AM Turing Laureate Colloquium. ctwj53r07yI.


