Die automatische Taxonomieerstellung (ATC) bezeichnet die Verwendung von Softwareprogrammen zur Generierung taxonomischer Klassifikationen aus einem Textkorpus .
GutNatural language processing
Kategorie
35 Artikel
Die automatische Taxonomieerstellung (ATC) bezeichnet die Verwendung von Softwareprogrammen zur Generierung taxonomischer Klassifikationen aus einem Textkorpus .
Automatische Zusammenfassung ist der Prozess, einen Datensatz rechnerisch zu kürzen, um eine Teilmenge (eine Zusammenfassung ) zu erstellen, die die wichtigsten oder relevantesten Informationen des Originalinhalts
Beispielbasierte maschinelle Übersetzung ( EBMT ) ist eine Methode der maschinellen Übersetzung, die sich häufig durch die Verwendung eines zweisprachigen Korpus mit Paralleltexten als zentrale Wissensbasis zur Laufzeit
Ein Bigramm oder Digramm ist eine Folge von zwei benachbarten Elementen einer Zeichenkette , die typischerweise aus Buchstaben , Silben oder Wörtern besteht. Ein Bigramm ist ein n -Gramm für n = 2.

ClearForest war ein israelisches Softwareunternehmen, das Lösungen für Textanalyse und Text Mining entwickelte und vermarktete .
Das CMU Pronouncing Dictionary (auch bekannt als CMUdict ) ist ein Open-Source -Aussprachewörterbuch , das ursprünglich von der Speech Group der Carnegie Mellon University (CMU) für die Verwendung in der

Documenting Hate ist ein Projekt von ProPublica in Zusammenarbeit mit verschiedenen journalistischen, akademischen und IT-Organisationen zur systematischen Erfassung von Hassverbrechen und diskriminierenden Vorfällen .
Die Dokumentenklassifizierung bzw. -kategorisierung ist ein Problem der Bibliothekswissenschaft , der Informationswissenschaft und der Informatik .

Im maschinellen Lernen ist Embedding eine Repräsentationslerntechnik , die komplexe, hochdimensionale Daten in einen niedrigdimensionalen Vektorraum numerischer Vektoren abbildet.

Die Geschichte der Verarbeitung natürlicher Sprache beschreibt die Fortschritte in diesem Bereich .

Ein großes Sprachmodell ( LLM ) ist ein neuronales Netzwerk , das mit einer riesigen Textmenge für Aufgaben der natürlichen Sprachverarbeitung , insbesondere der Sprachgenerierung, trainiert wurde .

Informationsextraktion ( IE ) bezeichnet die automatische Gewinnung strukturierter Informationen aus unstrukturierten und/oder semistrukturierten maschinenlesbaren Dokumenten und anderen elektronisch dargestellten

In der Theorie formaler Sprachen bezeichnet der Kleene-Stern (oder Kleene-Operator oder Kleene-Abschluss ) zwei verwandte unäre Operationen , die entweder auf ein Alphabet von Symbolen oder auf eine formale Sprache ,
LanguageWare ist eine von IBM entwickelte Technologie zur Verarbeitung natürlicher Sprache (Natural Language Processing, NLP) , die es Anwendungen ermöglicht, natürlichsprachliche Texte zu verarbeiten.
Logical Machine Corporation ( LOMAC ) war ein US-amerikanisches Computerunternehmen, das von Mitte der 1970er bis in die 1980er Jahre aktiv war und seinen Sitz in der San Francisco Bay Area hatte.

MAUVE ist eine Metrik zur automatischen Bewertung der Qualität von Open-Ended- Text-Generierung und anderen generativen Modellen .

METEOR ( Metric for Evaluation of Translation with Explicit ORdering ) ist eine Metrik zur Bewertung maschineller Übersetzungsergebnisse .
Ein morphologisches Muster ist eine Menge von Assoziationen und/oder Operationen, die die verschiedenen Formen eines Lexems bilden , beispielsweise durch Flexion , Agglutination , Komposition oder Derivation .

Das Verstehen natürlicher Sprache ( Natural Language Understanding, NLU ) bzw. die Interpretation natürlicher Sprache ( Natural Language Interpretation, NLI ) ist ein Teilgebiet der natürlichen Sprachverarbeitung in der
Ontologielernen ( Ontologieextraktion , Ontologieerweiterung , Ontologiegenerierung oder Ontologieerwerb ) bezeichnet die automatische oder halbautomatische Erstellung von Ontologien .
Der Begriff Phrasenstrukturgrammatik wurde ursprünglich von Noam Chomsky für die zuvor von Emil Post und Axel Thue untersuchten Grammatiken eingeführt ( Postsche kanonische Systeme ).
In der Informatik ist eine Produktionsregel eine Umschreibungsregel , die bestimmte Symbole durch andere ersetzt.
Natürliche Sprachprogrammierung ( NLP ) ist eine ontologiegestützte Programmiermethode, die auf Sätzen natürlicher Sprache , z. B. Englisch, basiert .

Die semantische Faltungstheorie beschreibt ein Verfahren zur Kodierung der Semantik von natürlichsprachlichen Texten in einer semantisch fundierten binären Repräsentation .

Sketch Engine ist eine Korpusverwaltungs- und Textanalyse- Software, die seit 2003 von Lexical Computing entwickelt wird.
In der linguistischen Morphologie und im Information Retrieval bezeichnet Stemming den Prozess, flektierte (oder manchmal abgeleitete) Wörter auf ihren Wortstamm , ihre Basis oder Wurzel – in der Regel eine geschriebene

StatMuse Inc. ist ein amerikanisches Unternehmen für künstliche Intelligenz, das 2014 gegründet wurde.

T9 ist eine Technologie zur Textvorhersage für Mobiltelefone (insbesondere solche mit einem 3×4-Tastenfeld ), die ursprünglich von Tegic Communications , heute Teil von Nuance Communications , entwickelt wurde .
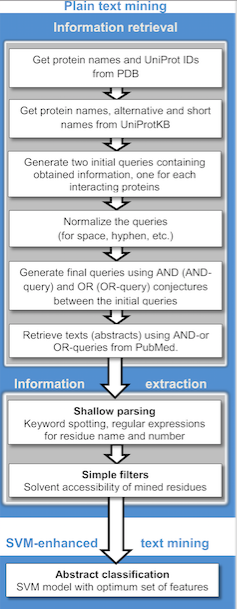
Text Mining , auch Text Data Mining ( TDM ) oder Textanalyse genannt, ist der Prozess der Gewinnung hochwertiger Informationen aus Texten .
Textnormalisierung ist der Prozess, Text in eine einheitliche, kanonische Form zu überführen , die er zuvor möglicherweise nicht besaß.
In der Verarbeitung natürlicher Sprache ( NLP) ist ein Themenmodell ein probabilistisches , neuronales oder algebraisches Modell zur Ermittlung abstrakter Themen in einer Dokumentensammlung.
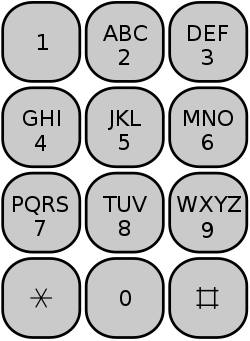
Die Texterkennung ist eine Eingabetechnologie, die dort zum Einsatz kommt, wo eine Taste mehrere Buchstaben repräsentiert, wie beispielsweise auf den numerischen Tastaturen von Mobiltelefonen oder in barrierefreien

In der Verarbeitung natürlicher Sprache bezeichnet ein w -Shingling eine Menge eindeutiger Shingles (und damit n-Gramme ), die jeweils aus zusammenhängenden Token - Sequenzen innerhalb eines Dokuments bestehen und zur

In der Verarbeitung natürlicher Sprache ( NLP) ist ein Wort-Embedding eine Repräsentation eines Wortes. Das Embedding wird in der Textanalyse verwendet .
Die Zusammenfassung mehrerer Dokumente ist ein automatisches Verfahren zur Extraktion von Informationen aus mehreren Texten zum selben Thema.