Text Mining , auch Text Data Mining ( TDM ) oder Textanalyse genannt, ist der Prozess der Gewinnung hochwertiger Informationen aus Texten . Es umfasst die computergestützte Entdeckung neuer, bisher unbekannter Informationen durch die automatische Extraktion von Informationen aus verschiedenen schriftlichen Quellen. [ 1 ] Zu diesen Quellen zählen beispielsweise Websites , Bücher , E-Mails , Rezensionen und Artikel. [ 2 ] Hochwertige Informationen werden typischerweise durch die Erkennung von Mustern und Trends mithilfe von Methoden wie dem statistischen Musterlernen gewonnen . Laut Hotho et al. (2005) gibt es drei Perspektiven des Text Mining: Informationsextraktion , Data Mining und Wissensentdeckung in Datenbanken (KDD). [ 3 ] Text Mining beinhaltet üblicherweise die Strukturierung des Eingabetextes (meist Parsing , Hinzufügen und Entfernen linguistischer Merkmale sowie die anschließende Speicherung in einer Datenbank ), die Ableitung von Mustern in den strukturierten Daten und schließlich die Auswertung und Interpretation der Ergebnisse. „Hohe Qualität“ im Text Mining bezieht sich üblicherweise auf eine Kombination aus Relevanz , Neuheit und Interesse. Typische Text Mining-Aufgaben umfassen Textkategorisierung , Textclustering , Konzept-/Entitätsextraktion, Erstellung granularer Taxonomien, Stimmungsanalyse , Dokumentenzusammenfassung und Entity-Relation-Modellierung ( d. h . das Erlernen von Beziehungen zwischen benannten Entitäten ).
Die Textanalyse umfasst Informationsabruf , lexikalische Analyse zur Untersuchung von Worthäufigkeitsverteilungen, Mustererkennung , Tagging / Annotation , Informationsextraktion , Data-Mining- Techniken einschließlich Link- und Assoziationsanalyse, Visualisierung und prädiktive Analysen . Das übergeordnete Ziel ist im Wesentlichen die Umwandlung von Text in analysierbare Daten durch Anwendung von Methoden der natürlichen Sprachverarbeitung (NLP), verschiedenen Algorithmen und Analyseverfahren. Ein wichtiger Schritt in diesem Prozess ist die Interpretation der gewonnenen Informationen.
Eine typische Anwendung besteht darin, eine Menge von Dokumenten in natürlicher Sprache zu scannen und diese entweder für prädiktive Klassifizierungszwecke zu modellieren oder eine Datenbank bzw. einen Suchindex mit den extrahierten Informationen zu füllen. Das Dokument ist das grundlegende Element beim Text Mining. Hier definieren wir ein Dokument als eine Einheit textueller Daten, die üblicherweise in vielen Arten von Sammlungen vorkommt. [ 4 ]
Textanalyse
Textanalyse beschreibt eine Reihe linguistischer , statistischer und maschineller Lernverfahren, die den Informationsgehalt von Textquellen für Business Intelligence , explorative Datenanalyse , Forschung oder Untersuchung modellieren und strukturieren. [ 5 ] Der Begriff ist weitgehend synonym mit Text Mining; Ronen Feldman modifizierte 2004 eine Beschreibung von „Text Mining“ [ 6 ] aus dem Jahr 2000, um „Textanalyse“ zu beschreiben. [ 7 ] Letzterer Begriff wird heute häufiger im Geschäftsumfeld verwendet, während „Text Mining“ in einigen der frühesten Anwendungsbereiche, die bis in die 1980er-Jahre zurückreichen, [ 8 ] insbesondere in der lebenswissenschaftlichen Forschung und im Bereich der staatlichen Nachrichtendienste Anwendung findet .
Der Begriff Textanalyse beschreibt auch die Anwendung von Textanalyse zur Lösung von Geschäftsproblemen, sei es eigenständig oder in Verbindung mit der Abfrage und Analyse von erhobenen numerischen Daten. Es ist eine Binsenweisheit, dass 80 % der geschäftsrelevanten Informationen in unstrukturierter Form, vorwiegend als Text, vorliegen. [ 9 ] Diese Techniken und Prozesse erschließen und präsentieren Wissen – Fakten, Geschäftsregeln und Zusammenhänge –, das ansonsten in Textform vorliegt und für die automatisierte Verarbeitung unzugänglich wäre.
Textanalyseprozesse
Teilaufgaben – Bestandteile eines umfassenderen Textanalyseprojekts – umfassen typischerweise:
- Dimensionsreduktion ist eine wichtige Technik zur Datenvorverarbeitung. Sie dient dazu, die Wortstämme von Wörtern zu identifizieren und die Größe der Textdaten zu reduzieren.
- Die Informationssuche oder die Identifizierung eines Korpus ist ein vorbereitender Schritt: das Sammeln oder Identifizieren einer Menge von Textmaterialien im Web oder in einem Dateisystem , einer Datenbank oder einem Content -Corpus-Manager zur Analyse.
- Obwohl einige Textanalysesysteme ausschließlich fortgeschrittene statistische Methoden anwenden, nutzen viele andere eine umfassendere Verarbeitung natürlicher Sprache , wie z. B. Wortartenbestimmung , syntaktische Analyse und andere Arten der linguistischen Analyse. [ 10 ]
- Named Entity Recognition bezeichnet die Verwendung von Ortsverzeichnissen oder statistischen Verfahren zur Identifizierung benannter Textmerkmale: Personen, Organisationen, Ortsnamen, Börsenkürzel, bestimmte Abkürzungen usw.
- Zur Klärung – also unter Berücksichtigung des Kontextes – kann beispielsweise erforderlich sein, um zu entscheiden, ob sich „Ford“ auf einen ehemaligen US-Präsidenten, einen Fahrzeughersteller, einen Filmstar, eine Flussüberquerung oder eine andere Entität bezieht. [ 11 ]
- Erkennung von musteridentifizierten Entitäten: Merkmale wie Telefonnummern, E-Mail-Adressen, Mengen (mit Einheiten) können mittels regulärer Ausdrücke oder anderer Musterübereinstimmungen erkannt werden .
- Dokumentenclustering : Identifizierung von Mengen ähnlicher Textdokumente. [ 12 ]
- Koreferenzauflösung : Identifizierung von Nominalphrasen und anderen Begriffen, die sich auf dasselbe Objekt beziehen.
- Extraktion von Beziehungen, Fakten und Ereignissen: Identifizierung von Zusammenhängen zwischen Entitäten und anderen Informationen in Texten.
- Sentimentanalyse : Die Analyse subjektiver Inhalte und die Gewinnung von Informationen über Einstellungen: Gefühle, Meinungen, Stimmungen und Emotionen. Dies geschieht auf der Ebene von Entitäten, Konzepten oder Themen und zielt darauf ab, Meinungsträger und -objekte zu unterscheiden. [ 13 ]
- Quantitative Textanalyse: eine Reihe von Techniken aus den Sozialwissenschaften, bei denen entweder ein menschlicher Gutachter oder ein Computer semantische oder grammatikalische Beziehungen zwischen Wörtern extrahiert, um die Bedeutung oder stilistische Muster eines in der Regel informellen persönlichen Textes zum Zweck der psychologischen Profilerstellung usw. zu ermitteln. [ 14 ]
- Die Vorverarbeitung umfasst üblicherweise Aufgaben wie Tokenisierung, Filterung und Stemming.
Anwendungen
Text-Mining-Technologien finden heute breite Anwendung in Regierung, Forschung und Wirtschaft. Diese Gruppen nutzen Text Mining beispielsweise für die Dokumentenverwaltung und die Suche nach relevanten Dokumenten. Juristen setzen Text Mining etwa für die elektronische Beweissicherung (E-Discovery) ein . Regierungen und Militärs nutzen Text Mining für die nationale Sicherheit und im Nachrichtendienst. Wissenschaftler integrieren Text-Mining-Ansätze, um große Textmengen zu strukturieren (d. h. das Problem unstrukturierter Daten zu lösen ), um in Texten vermittelte Ideen zu analysieren (z. B. Stimmungsanalyse in sozialen Medien [ 15 ] [ 16 ] [ 17 ] ) und um wissenschaftliche Erkenntnisse in Bereichen wie den Lebenswissenschaften und der Bioinformatik zu fördern. In der Wirtschaft werden Anwendungen unter anderem für Wettbewerbsanalysen und die automatisierte Anzeigenschaltung eingesetzt .
Sicherheitsanwendungen
Viele Text-Mining-Softwarepakete werden für Sicherheitsanwendungen vermarktet , insbesondere für die Überwachung und Analyse von Online-Klartextquellen wie Internetnachrichten , Blogs usw. für Zwecke der nationalen Sicherheit . [ 18 ] Sie befasst sich auch mit der Erforschung der Textverschlüsselung und -entschlüsselung .
Biomedizinische Anwendungen
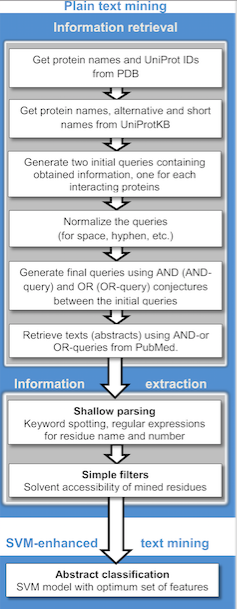
Eine Reihe von Text-Mining-Anwendungen in der biomedizinischen Literatur wurde bereits beschrieben [ 20 ] , darunter computergestützte Ansätze zur Unterstützung von Studien zum Protein-Docking [ 21 ] , zu Proteininteraktionen [ 22 , 23 ] und zu Protein-Krankheits-Assoziationen [ 24 ] . Darüber hinaus kann Text Mining mit großen Patientendatensätzen im klinischen Bereich, Datensätzen mit demografischen Informationen aus Bevölkerungsstudien und Berichten über unerwünschte Ereignisse klinische Studien und die Präzisionsmedizin fördern. Text-Mining-Algorithmen ermöglichen die Stratifizierung und Indexierung spezifischer klinischer Ereignisse in großen Patientendatensätzen zu Symptomen, Nebenwirkungen und Komorbiditäten aus elektronischen Patientenakten, Ereignisberichten und Berichten über spezifische diagnostische Tests [ 25 ] . Eine Online-Text-Mining-Anwendung in der biomedizinischen Literatur ist PubGene , eine öffentlich zugängliche Suchmaschine , die biomedizinisches Text Mining mit Netzwerkvisualisierung kombiniert [ 26 , 27 ] . GoPubMed ist eine wissensbasierte Suchmaschine für biomedizinische Texte. Text Mining-Techniken ermöglichen es uns auch, unbekanntes Wissen aus unstrukturierten Dokumenten im klinischen Bereich zu extrahieren [ 28 ].
Softwareanwendungen
Text-Mining-Methoden und -Software werden von großen Unternehmen wie IBM und Microsoft erforscht und entwickelt, um die Mining- und Analyseprozesse weiter zu automatisieren. Auch verschiedene Unternehmen im Bereich Suche und Indexierung arbeiten daran, ihre Ergebnisse zu verbessern. Im öffentlichen Sektor konzentrieren sich die Bemühungen auf die Entwicklung von Software zur Verfolgung und Überwachung terroristischer Aktivitäten . [ 29 ] Für Studienzwecke ist die Software Weka eine der beliebtesten Optionen in der Wissenschaft und eignet sich hervorragend als Einstieg für Anfänger. Python-Programmierern steht mit NLTK ein ausgezeichnetes Toolkit für allgemeinere Zwecke zur Verfügung. Fortgeschrittene Programmierer können die Gensim- Bibliothek nutzen, die sich auf wortvektorbasierte Textrepräsentationen spezialisiert hat.
Online-Medienanwendungen
Text Mining wird von großen Medienunternehmen wie der Tribune Company eingesetzt , um Informationen zu strukturieren und Lesern ein optimiertes Sucherlebnis zu bieten. Dies wiederum erhöht die Verweildauer auf der Website und steigert die Einnahmen. Darüber hinaus profitieren Redakteure im Backend davon, Nachrichten plattformübergreifend teilen, verknüpfen und bündeln zu können, wodurch sich die Monetarisierungsmöglichkeiten für Inhalte deutlich erweitern.
Geschäfts- und Marketinganwendungen
Textanalyse findet Anwendung in der Wirtschaft, insbesondere im Marketing, beispielsweise im Kundenbeziehungsmanagement (CRM ). [ 30 ] Coussement und Van den Poel (2008) [ 31 ] [ 32 ] nutzen sie zur Verbesserung von Modellen zur Vorhersage von Kundenabwanderung ( Customer Churn ). [ 31 ] Auch zur Prognose von Aktienrenditen wird Text Mining eingesetzt. [ 33 ]
Stimmungsanalyse
Die Stimmungsanalyse kann die Bewertung von Produkten wie Filmen, Büchern oder Hotelrezensionen umfassen, um die positive Bewertung des Produkts einzuschätzen. [ 34 ] Eine solche Analyse kann einen annotierten Datensatz oder die Kennzeichnung der Affektivität von Wörtern erfordern. Ressourcen zur Affektivität von Wörtern und Konzepten wurden für WordNet [ 35 ] bzw. ConceptNet [ 36 ] erstellt .
Im verwandten Bereich des affektiven Computings wird Text zur Erkennung von Emotionen eingesetzt. [ 37 ] Textbasierte Ansätze des affektiven Computings wurden auf verschiedene Korpora angewendet, darunter Schülerbewertungen, Kindergeschichten und Nachrichtenartikel.
Recherche wissenschaftlicher Literatur und akademische Anwendungen
Das Thema Text Mining ist für Verlage mit großen Datenbanken , deren Informationen indexiert werden müssen, von großer Bedeutung . Dies gilt insbesondere für wissenschaftliche Disziplinen, in denen Texte häufig hochspezifische Informationen enthalten. Daher wurden Initiativen wie der Vorschlag von Nature für eine offene Text Mining-Schnittstelle (OTMI) und die gemeinsame Dokumententypdefinition (DTD) der National Institutes of Health für Zeitschriftenveröffentlichungen ins Leben gerufen . Diese Initiativen liefern Maschinen semantische Hinweise, um spezifische Anfragen im Text zu beantworten, ohne die Zugangsbarrieren der Verlage für die Öffentlichkeit zu verringern.
Auch akademische Einrichtungen beteiligen sich an der Text-Mining-Initiative:
- Das Nationale Zentrum für Text Mining (NaCTeM) ist das weltweit erste öffentlich finanzierte Zentrum für Text Mining. NaCTeM wird von der Universität Manchester [ 38 ] in enger Zusammenarbeit mit dem Tsujii-Labor [ 39 ] der Universität Tokio [ 40 ] betrieben . NaCTeM bietet der akademischen Gemeinschaft maßgeschneiderte Werkzeuge und Forschungseinrichtungen sowie Beratung. Finanziert wird es vom Joint Information Systems Committee (JISC) und zwei britischen Forschungsräten ( EPSRC & BBSRC ). Ursprünglich auf Text Mining in den Biowissenschaften und der Biomedizin ausgerichtet , hat sich die Forschung inzwischen auf die Sozialwissenschaften ausgeweitet .
- In den Vereinigten Staaten entwickelt die School of Information der University of California, Berkeley, ein Programm namens BioText, um Biologieforscher bei der Textanalyse zu unterstützen.
- Das Text Analysis Portal for Research (TAPoR), das derzeit an der Universität von Alberta angesiedelt ist , ist ein wissenschaftliches Projekt zur Katalogisierung von Textanalyseanwendungen und zur Schaffung eines Zugangs für Forscher, die neu in dieser Praxis sind.
Methoden zur Gewinnung wissenschaftlicher Literatur
Zur Unterstützung der Informationsrecherche in wissenschaftlicher Literatur wurden computergestützte Methoden entwickelt. Zu den veröffentlichten Ansätzen gehören Methoden zur Suche [ 41 ] , zur Bestimmung der Neuheit [ 42 ] und zur Klärung von Homonymen [ 43 ] in technischen Berichten.
Digitale Geisteswissenschaften und Computersoziologie
Die automatische Analyse umfangreicher Textkorpora ermöglicht es Wissenschaftlern, Millionen von Dokumenten in verschiedenen Sprachen mit minimalem manuellem Aufwand zu analysieren. Zu den wichtigsten Basistechnologien zählen Parsing, maschinelle Übersetzung , Themenkategorisierung und maschinelles Lernen.

Die automatische Analyse von Textkorpora ermöglicht die Extraktion von Akteuren und ihren Beziehungsnetzwerken in großem Umfang und wandelt Textdaten in Netzwerkdaten um. Die resultierenden Netzwerke, die Tausende von Knoten enthalten können, werden anschließend mithilfe von Methoden der Netzwerktheorie analysiert, um die wichtigsten Akteure, die wichtigsten Gemeinschaften oder Parteien sowie allgemeine Eigenschaften wie Robustheit oder strukturelle Stabilität des Gesamtnetzwerks oder die Zentralität bestimmter Knoten zu identifizieren. [ 45 ] Dies automatisiert den Ansatz der quantitativen Narrationsanalyse, [ 46 ] bei dem Subjekt-Verb-Objekt- Triplets mit Akteurpaaren identifiziert werden, die durch eine Handlung verbunden sind, oder mit Akteur-Objekt-Paaren. [ 44 ]
Die Inhaltsanalyse ist seit Langem ein fester Bestandteil der Sozial- und Medienwissenschaften. Ihre Automatisierung hat eine „ Big-Data “-Revolution in diesem Bereich ermöglicht, die sich in Studien zu Social-Media- und Zeitungsinhalten mit Millionen von Nachrichtenartikeln widerspiegelt. Mithilfe von Text-Mining-Methoden wurden Geschlechterverzerrungen , Lesbarkeit , Inhaltsähnlichkeit, Leserpräferenzen und sogar Stimmungen anhand von Millionen von Dokumenten analysiert. [ 47 ] [ 48 ] [ 49 ] [ 50 ] [ 51 ] Die Analyse von Lesbarkeit, Geschlechterverzerrungen und Themenverzerrungen wurde von Flaounas et al. [ 52 ] demonstriert . Sie zeigten, wie unterschiedliche Themen unterschiedliche Geschlechterverzerrungen und Lesbarkeitsgrade aufweisen; zudem wurde die Möglichkeit aufgezeigt, Stimmungsmuster in einer großen Bevölkerungsgruppe durch die Analyse von Twitter-Inhalten zu erkennen. [ 53 ] [ 54 ]
Software
Text-Mining-Computerprogramme sind von vielen kommerziellen und Open-Source- Unternehmen und -Quellen erhältlich.
Recht des geistigen Eigentums
Situation in der Europäischen Union
Nach europäischem Urheber- und Datenbankrecht ist das Mining urheberrechtlich geschützter Werke (z. B. durch Web-Mining ) ohne Zustimmung des Urhebers gemäß Artikel 3 und 4 der Richtlinie 2019/2009 über das Urheberrecht im digitalen Binnenmarkt zulässig . Eine spezifische Ausnahme für wissenschaftliche Forschungszwecke ist in Artikel 3 beschrieben, während die allgemeinere Ausnahme in Artikel 4 nur dann gilt, wenn der Urheber nicht widersprochen hat. [ 55 ]
Die Europäische Kommission förderte 2013 unter dem Titel „Lizenzen für Europa“ einen Dialog zwischen Interessengruppen zum Thema Text- und Data-Mining . [ 56 ] Da der Fokus bei der Lösung dieses Rechtsproblems auf Lizenzen und nicht auf Einschränkungen und Ausnahmen des Urheberrechts lag, verließen Vertreter von Universitäten, Forschungseinrichtungen, Bibliotheken, zivilgesellschaftlichen Gruppen und Open-Access- Verlagen den Dialog im Mai 2013. [ 57 ]
Situation in den Vereinigten Staaten
Das US-amerikanische Urheberrecht , insbesondere seine Bestimmungen zur fairen Nutzung , führt dazu, dass Text Mining in den USA sowie in anderen Ländern mit ähnlicher Rechtsprechung wie Israel, Taiwan und Südkorea als legal gilt. Da Text Mining transformativ ist, also das Originalwerk nicht ersetzt, wird es im Rahmen der fairen Nutzung als rechtmäßig angesehen. Beispielsweise entschied der zuständige Richter im Vergleich zu Google Books , dass Googles Digitalisierungsprojekt urheberrechtlich geschützter Bücher rechtmäßig war, unter anderem aufgrund der transformativen Nutzungen, die das Projekt aufwies – darunter Text- und Data Mining. [ 58 ]
Situation in Australien
Das australische Urheberrecht sieht im Copyright Act 1968 keine Ausnahme für Text- oder Data-Mining vor . Die Australian Law Reform Commission hat festgestellt, dass die Ausnahme für „Forschung und Studium“ im Rahmen des Fair Use wahrscheinlich auch nicht auf ein solches Thema anwendbar ist, da es über die Anforderung eines „angemessenen Teils“ hinausginge. [ 59 ]
Situation im Vereinigten Königreich
Im Jahr 2014 änderte die britische Regierung auf Empfehlung des Hargreaves-Berichts das Urheberrecht [ 60 ] , um Text Mining als Einschränkung und Ausnahme zuzulassen. Großbritannien war nach Japan , das 2009 eine spezifische Ausnahme für Text Mining eingeführt hatte , das zweite Land weltweit, das diesen Schritt unternahm. Aufgrund der Bestimmungen der Richtlinie über die Informationsgesellschaft (2001) ist Text Mining im Vereinigten Königreich jedoch nur für nichtkommerzielle Zwecke zulässig. Das britische Urheberrecht lässt keine vertragliche Ausnahme von dieser Bestimmung zu.
Implikationen
Bis vor Kurzem nutzten Websites meist textbasierte Suchfunktionen, die lediglich Dokumente mit bestimmten, vom Nutzer definierten Wörtern oder Phrasen fanden. Dank des semantischen Webs kann Text Mining heute Inhalte anhand von Bedeutung und Kontext (und nicht nur anhand einzelner Wörter) finden. Darüber hinaus lassen sich mit Text-Mining-Software umfangreiche Informationsdossiers über bestimmte Personen und Ereignisse erstellen. So können beispielsweise große Datensätze auf Basis von Daten aus Nachrichtenberichten erstellt werden, um die Analyse sozialer Netzwerke oder die Spionageabwehr zu erleichtern . Die Text-Mining-Software kann somit ähnlich wie ein Geheimdienstanalyst oder Bibliothekar agieren, wenn auch mit einem begrenzteren Analyseumfang. Text Mining wird auch in einigen E-Mail -Spamfiltern eingesetzt , um die Merkmale von Nachrichten zu bestimmen, die wahrscheinlich Werbung oder andere unerwünschte Inhalte enthalten. Darüber hinaus spielt Text Mining eine wichtige Rolle bei der Bestimmung der Stimmung an den Finanzmärkten .
Siehe auch
- Konzeptgewinnung
- Dokumentenverarbeitung
- Volltextsuche
- Liste der Textmining-Software
- Marktstimmung
- Namensauflösung (Semantik und Textextraktion)
- Named Entity Recognition
- Ontologielernen
- Datensatzverknüpfung
- Sequenzielles Muster-Mining (String- und Sequenz-Mining)
- W-Schindel
- Web Mining , eine Aufgabe, die Text Mining beinhalten kann (z. B. zuerst geeignete Webseiten finden, indem gecrawlte Webseiten klassifiziert werden, und dann die gewünschten Informationen aus dem Textinhalt dieser als relevant erachteten Seiten extrahieren).
Referenzen
Zitate
- ^ "Marti Hearst: Was ist Text Mining?" .
- ^ Galiani, Sebastian; Gálvez, Ramiro H.; Nachman, Ian (2025). „Spezialisierungstrends in der wirtschaftswissenschaftlichen Forschung: Eine groß angelegte Studie unter Verwendung von Natural Language Processing und Zitationsanalyse“ . Economic Inquiry . 63 (1): 289–329 . doi : 10.1111/ecin.13261 .
- ^ Hotho, A., Nürnberger, A. und Paaß, G. (2005). „Ein kurzer Überblick über Text Mining“. In: Ldv Forum, Bd. 20(1), S. 19–62.
- ^ Feldman, R. und Sanger, J. (2007). Das Handbuch des Text Mining. Cambridge University Press. New York
- ^ [1] Archiviert am 29. November 2009 in der Wayback Machine
- ^ „KDD-2000 Workshop on Text Mining – Call for Papers“ . Cs.cmu.edu . Abgerufen am 23.02.2015 .
- ^ [2] Archiviert am 3. März 2012 in der Wayback Machine
- ^ Hobbs, Jerry R.; Walker, Donald E.; Amsler, Robert A. (1982). „Natural language access to structured text“. Proceedings of the 9th conference on Computational linguistics . Vol. 1. S. 127–32 . doi : 10.3115/991813.991833 . S2CID 6433117 .
- ^ „Unstrukturierte Daten und die 80-Prozent-Regel“ . Breakthrough Analysis . August 2008. Archiviert vom Original am 12.09.2014 . Abgerufen am 23.02.2015 .
- ^ Antunes, João (14.11.2018). Exploração de informações contextuais para enriquecimento semântico em repräsentativações de textos (Mestrado em Ciências de Computação e Matemática Computacional thesis) (auf Portugiesisch). São Carlos: Universität von São Paulo. doi : 10.11606/d.55.2019.tde-03012019-103253 .
- ^ Moro, Andrea; Raganato, Alessandro; Navigli, Roberto (Dezember 2014). „Entity Linking meets Word Sense Disambiguation: a Unified Approach“ . Transactions of the Association for Computational Linguistics . 2 : 231–244 . doi : 10.1162/tacl_a_00179 . ISSN 2307-387X .
- ^ Chang, Wui Lee; Tay, Kai Meng; Lim, Chee Peng (06.02.2017). „Ein neues, sich entwickelndes baumbasiertes Modell mit lokalem Re-Learning für Dokumentenclustering und -visualisierung“. Neural Processing Letters . 46 (2): 379–409 . doi : 10.1007/s11063-017-9597-3 . ISSN 1370-4621 . S2CID 9100902 .
- Benchimol , Jonathan; Kazinnik, Sophia; Saadon, Yossi (2022). „Text Mining Methoden mit R: Eine Anwendung auf Zentralbanktexte“ . Machine Learning with Applications . 8 100286. doi : 10.1016/j.mlwa.2022.100286 . hdl : 10419/323255 . S2CID 243798160 .
- Mehl , Matthias R. (2006). „Quantitative Textanalyse“. Handbuch der multimethodischen Messung in der Psychologie . S. 141. doi : 10.1037/11383-011 . ISBN 978-1-59147-318-3Die
- ^ Pang, Bo; Lee, Lillian (2008). „Meinungsanalyse und Stimmungsanalyse“. Foundations and Trends in Information Retrieval . 2 ( 1–2 ): 1–135 . CiteSeerX 10.1.1.147.2755 . doi : 10.1561/1500000011 . ISSN 1554-0669 . S2CID 207178694 .
- ^ Paltoglou, Georgios; Thelwall, Mike (01.09.2012). „Twitter, MySpace, Digg: Unüberwachte Stimmungsanalyse in sozialen Medien“. ACM Transactions on Intelligent Systems and Technology . 3 (4): 66. doi : 10.1145/2337542.2337551 . ISSN 2157-6904 . S2CID 16600444 .
- ^ „Sentimentanalyse auf Twitter < SemEval-2017 Aufgabe 4“ . alt.qcri.org . Abgerufen am 2018-10-02 .
- ^ Zanasi, Alessandro (2009). „Virtuelle Waffen für reale Kriege: Text Mining für die nationale Sicherheit“. Proceedings of the International Workshop on Computational Intelligence in Security for Information Systems CISIS’08 . Advances in Soft Computing. Band 53. S. 53. doi : 10.1007/978-3-540-88181-0_7 . ISBN 978-3-540-88180-3Die
- ^ Badal, Varsha D.; Kundrotas, Petras J.; Vakser, Ilya A. (09.12.2015). „Text Mining für Protein-Docking“ . PLOS Computational Biology . 11 (12) e1004630. Bibcode : 2015PLSCB..11E4630B . doi : 10.1371/journal.pcbi.1004630 . ISSN 1553-7358 . PMC 4674139. PMID 26650466 .
- ^ Cohen, K. Bretonnel; Hunter, Lawrence (2008). „Einführung in das Text Mining“ . PLOS Computational Biology . 4 (1) e20. Bibcode : 2008PLSCB...4...20C . doi : 10.1371/ journal.pcbi.0040020 . PMC 2217579. PMID 18225946 .
- ^ Badal, V. D.; Kundrotas, P. J.; Vakser, I. A. (2015). „Text Mining für Protein-Docking“ . PLOS Computational Biology . 11 (12) e1004630. Bibcode : 2015PLSCB..11E4630B . doi : 10.1371/journal.pcbi.1004630 . PMC 4674139. PMID 26650466 .
- ^ Papanikolaou, Nikolas; Pavlopoulos, Georgios A.; Theodosiou, Theodosios; Iliopoulos, Ioannis (2015). „Vorhersagen von Protein-Protein-Interaktionen mithilfe von Text-Mining-Methoden“. Methoden . 74 : 47–53 . doi : 10.1016/j.ymeth.2014.10.026 . ISSN 1046-2023 . PMID 25448298 .
- ^ Szklarczyk, Damian; Morris, John H; Cook, Helen; Kuhn, Michael; Wyder, Stefan; Simonovic, Milan; Santos, Alberto; Doncheva, Nadezhda T; Roth, Alexander (18.10.2016). „Die STRING-Datenbank im Jahr 2017: Qualitätskontrollierte Protein-Protein-Assoziationsnetzwerke, breit zugänglich gemacht“ . Nucleic Acids Research . 45 (D1): D362– D368 . doi : 10.1093/nar/gkw937 . ISSN 0305-1048 . PMC 5210637. PMID 27924014 .
- ^ Liem, David A.; Murali, Sanjana; Sigdel, Dibakar; Shi, Yu; Wang, Xuan; Shen, Jiaming; Choi, Howard; Caufield, John H.; Wang, Wei; Ping, Peipei; Han, Jiawei (1. Oktober 2018). „Phrase Mining von Textdaten zur Analyse von Mustern extrazellulärer Matrixproteine bei kardiovaskulären Erkrankungen“ . American Journal of Physiology. Heart and Circulatory Physiology . 315 (4): H910– H924. doi : 10.1152/ajpheart.00175.2018 . ISSN 1522-1539 . PMC 6230912. PMID 29775406 .
- ^ Van Le, D.; Montgomery, J.; Kirkby, K. C.; Scanlan, J. (10. August 2018). „Risikoprognose mittels natürlicher Sprachverarbeitung elektronischer Patientenakten im stationären forensisch-psychiatrischen Bereich“ . Journal of Biomedical Informatics . 86 : 49–58 . doi : 10.1016/j.jbi.2018.08.007 . PMID 30118855 .
- ^ Jenssen, Tor-Kristian; Lægreid, Astrid; Komorowski, Jan; Hovig, Eivind (2001). „Ein Literaturnetzwerk menschlicher Gene zur Hochdurchsatzanalyse der Genexpression“. Naturgenetik . 28 (1): 21– 8. doi : 10.1038/ng0501-21 . PMID 11326270 . S2CID 8889284 .
- ^ Masys, Daniel R. (2001). „Verknüpfung von Microarray-Daten mit der Literatur“. Nature Genetics . 28 (1): 9–10 . doi : 10.1038/ng0501-9 . PMID 11326264. S2CID 52848745 .
- ^ Renganathan, Vinaitheerthan (2017). „ Text Mining im biomedizinischen Bereich mit Schwerpunkt auf Dokumentenclustering“ . Healthcare Informatics Research . 23 (3): 141–146 . doi : 10.4258/hir.2017.23.3.141 . ISSN 2093-3681 . PMC 5572517. PMID 28875048 .
- ^ [3] Archiviert am 4. Oktober 2013 in der Wayback Machine
- ^ „Textanalyse“ . Medallia . Abgerufen am 23.02.2015 .
- ^ a b Coussement, Kristof; Van Den Poel, Dirk (2008). „Integration der Kundenstimme aus Callcenter-E-Mails in ein Entscheidungsunterstützungssystem zur Abwanderungsprognose“ . Information & Management . 45 (3): 164–74 . CiteSeerX 10.1.1.113.3238 . doi : 10.1016/j.im.2008.01.005 .
- ^ Coussement, Kristof; Van Den Poel, Dirk (2008). „Verbesserung des Beschwerdemanagements durch automatische E-Mail-Klassifizierung unter Verwendung linguistischer Stilmerkmale als Prädiktoren“ . Decision Support Systems . 44 (4): 870–882 . doi : 10.1016/j.dss.2007.10.010 .
- ^ Ramiro H. Gálvez; Agustín Gravano (2017). „Bewertung des Nutzens von Online-Forenanalysen für automatische Aktienprognosesysteme“. Journal of Computational Science . 19 : 1877–7503 . doi : 10.1016/j.jocs.2017.01.001 . hdl : 11336/60065 .
- ^ Pang, Bo; Lee, Lillian; Vaithyanathan, Shivakumar (2002). „Daumen hoch?“. Proceedings der ACL-02-Konferenz über empirische Methoden in der Verarbeitung natürlicher Sprache . Band 10. S. 79–86 . doi : 10.3115/1118693.1118704 . S2CID 7105713 .
- ^ Alessandro Valitutti; Carlo Strapparava; Oliviero Stock (2005). „Entwicklung affektiver lexikalischer Ressourcen“ (PDF) . PsychNology Journal . 2 (1): 61–83 . Archiviert vom Original (PDF) am 20.09.2018 . Abgerufen am 21.08.2007 .
- ^ Erik Cambria; Robert Speer; Catherine Havasi; Amir Hussain (2010). „SenticNet: eine öffentlich verfügbare semantische Ressource für Opinion Mining“ (PDF) . Verfahren der AAAI CSK . S. 14–18 .
- ^ Calvo, Rafael A.; d'Mello, Sidney (2010). „Affect Detection: An Interdisciplinary Review of Models, Methods, and Their Applications“. IEEE Transactions on Affective Computing . 1 (1): 18–37 . doi : 10.1109/T-AFFC.2010.1 . S2CID 753606 .
- ^ „Die Universität Manchester“ . Manchester.ac.uk . Abgerufen am 23.02.2015 .
- ^ „Tsujii Laboratory“ . Tsujii.is.su-tokyo.ac.jp. Archiviert vom Original am 7. März 2012. Abgerufen am 23. Februar 2015 .
- ^ „Universität Tokio“ . UTokyo . Abgerufen am 23.02.2015 .
- ^ Shen, Jiaming; Xiao, Jinfeng; Er, Xinwei; Shang, Jingbo; Sinha, Saurabh; Han, Jiawei (27.06.2018). Entitätssatzsuche in wissenschaftlicher Literatur: Ein unbeaufsichtigter Ranking-Ansatz . ACM. S. 565–574 . doi : 10.1145/3209978.3210055 . ISBN 978-1-4503-5657-2. S2CID 13748283 .
- ^ Walter, Lothar; Radauer, Alfred; Moehrle, Martin G. (06.02.2017). „Die Schönheit des Schwefelfalters: Neuheit von Patenten, identifiziert durch eine auf Text Mining basierende Analyse des nahen Umfelds“. Scientometrics . 111 (1): 103–115 . doi : 10.1007/s11192-017-2267-4 . ISSN 0138-9130 . S2CID 11174676 .
- ^ Roll, Uri; Correia, Ricardo A.; Berger-Tal, Oded (10.03.2018). „Einsatz von maschinellem Lernen zur Entwirrung von Homonymen in großen Textkorpora“. Conservation Biology . 32 (3): 716–724 . Bibcode : 2018ConBi..32..716R . doi : 10.1111/cobi.13044 . ISSN 0888-8892 . PMID 29086438. S2CID 3783779 .
- ^ a b Automatisierte Analyse der US-Präsidentschaftswahlen mithilfe von Big Data und Netzwerkanalyse; S Sudhahar, GA Veltri, N Cristianini; Big Data & Society 2 (1), 1-28, 2015
- ^ Netzwerkanalyse narrativer Inhalte in großen Korpora; S. Sudhahar, G. De Fazio, R. Franzosi, N. Cristianini; Natural Language Engineering, 1-32, 2013
- ^ Quantitative Narrative Analysis; Roberto Franzosi; Emory University © 2010
- ^ Lansdall-Welfare, Thomas; Sudhahar, Saatviga; Thompson, James; Lewis, Justin; Team, FindMyPast Newspaper; Cristianini, Nello (09.01.2017). „Inhaltsanalyse von 150 Jahren britischer Zeitschriften“ . Proceedings of the National Academy of Sciences . 114 (4): E457– E465 . Bibcode : 2017PNAS..114E.457L . doi : 10.1073/pnas.1606380114 . ISSN 0027-8424 . PMC 5278459. PMID 28069962 .
- ^ I. Flaounas, M. Turchi, O. Ali, N. Fyson, T. De Bie, N. Mosdell, J. Lewis, N. Cristianini, Die Struktur der EU-Mediasphäre, PLoS ONE, Vol. 5(12), S. e14243, 2010.
- ^ Nowcasting Events from the Social Web with Statistical Learning V Lampos, N Cristianini; ACM Transactions on Intelligent Systems and Technology (TIST) 3 (4), 72
- ^ NOAM: Nachrichtenagenturanalyse- und Überwachungssystem; I. Flaounas, O. Ali, M. Turchi, T. Snowsill, F. Nicart, T. De Bie, N. Cristianini; Proceedings der internationalen ACM SIGMOD-Konferenz 2011 zum Thema Datenmanagement
- ^ Automatische Erkennung von Mustern in Medieninhalten, N Cristianini, Kombinatorische Mustererkennung, 2-13, 2011
- ^ I. Flaounas, O. Ali, T. Lansdall-Welfare, T. De Bie, N. Mosdell, J. Lewis, N. Cristianini, Forschungsmethoden im Zeitalter des digitalen Journalismus, Digital Journalism, Routledge, 2012
- ^ Zirkadiane Stimmungsschwankungen in Twitter-Inhalten; Fabon Dzogang, Stafford Lightman, Nello Cristianini. Brain and Neuroscience Advances, 1, 2398212817744501.
- Auswirkungen der Rezession auf die öffentliche Stimmung in Großbritannien; T. Lansdall-Welfare, V. Lampos, N. Cristianini; Sitzung „Mining Social Network Dynamics (MSND)“ zu Social-Media-Anwendungen
- ^ „Kneschke vs. LAION – Wegweisendes Urteil zu TDM-Ausnahmen für KI-Trainingsdaten – Teil 2 | Kluwer Copyright Blog“ . legalblogs.wolterskluwer.com . Abgerufen am 16.09.2025 .
- ^ „Lizenzen für Europa – Strukturierter Stakeholder-Dialog 2013“ . Europäische Kommission . Abgerufen am 14. November 2014 .
- ^ „Text- und Data-Mining: Seine Bedeutung und der Änderungsbedarf in Europa“ . Association of European Research Libraries . 25.04.2013. Archiviert vom Original am 29.11.2014 . Abgerufen am 14. November 2014 .
- ^ „Richter gibt Google Books im summarischen Verfahren Recht – ein Sieg für die faire Nutzung“ . Lexology . Antonelli Law Ltd. 19. November 2013. Abgerufen am 14. November 2014 .
- ^ „Text- und Data-Mining“ . Australische Kommission für Rechtsreform . 4. Juni 2013. Abgerufen am 10. Februar 2023 .
- ^ Forscher erhalten durch neue britische Urheberrechtsgesetze das Recht zur Datenanalyse. Archiviert am 9. Juni 2014 in der Wayback Machine.
Quellen
- Ananiadou, S. und McNaught, J. (Hrsg.) (2006). Text Mining für Biologie und Biomedizin . Artech House Books. ISBN 978-1-58053-984-5
- Bilisoly, R. (2008). Praktisches Text Mining mit Perl . New York: John Wiley & Sons. ISBN 978-0-470-17643-6
- Feldman, R. und Sanger, J. (2006). The Text Mining Handbook . New York: Cambridge University Press. ISBN 978-0-521-83657-9
- Hotho, A., Nürnberger, A. und Paaß, G. (2005). „Ein kurzer Überblick über Text Mining“. In: Ldv Forum, Bd. 20(1), S. 19–62.
- Indurkhya, N. und Damerau, F. (2010). Handbuch der Verarbeitung natürlicher Sprache , 2. Auflage. Boca Raton, FL: CRC Press. ISBN 978-1-4200-8592-1
- Kao, A., und Poteet, S. (Hrsg.). Verarbeitung natürlicher Sprache und Text Mining . Springer. ISBN 1-84628-175-X
- Konchady, M. Text Mining Application Programming (Programming Series) . Charles River Media. ISBN 1-58450-460-9
- Manning, C. und Schütze, H. (1999). Grundlagen der statistischen Verarbeitung natürlicher Sprache . Cambridge, MA: MIT Press. ISBN 978-0-262-13360-9
- Miner, G., Elder, J., Hill, T., Nisbet, R., Delen, D. und Fast, A. (2012). Praktisches Text Mining und statistische Analyse für Anwendungen mit unstrukturierten Textdaten . Elsevier Academic Press. ISBN 978-0-12-386979-1
- McKnight, W. (2005). „Aufbau von Business Intelligence: Text Data Mining in der Business Intelligence“. DM Review , 21–22.
- Srivastava, A., und Sahami, M. (2009). Text Mining: Klassifizierung, Clustering und Anwendungen . Boca Raton, FL: CRC Press. ISBN 978-1-4200-5940-3
- Zanasi, A. (Hrsg.) (2007). Text Mining und seine Anwendungen in den Bereichen Intelligence, CRM und Wissensmanagement . WIT Press. ISBN 978-1-84564-131-3


