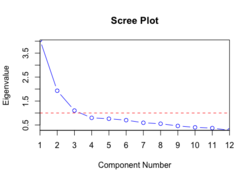
In der multivariaten Statistik ist die explorative Faktorenanalyse ( EFA ) eine statistische Methode , die dazu dient, die zugrundeliegende Struktur einer relativ großen Anzahl von Variablen aufzudecken . Die EFA ist eine Technik innerhalb der Faktorenanalyse , deren übergeordnetes Ziel es ist, die zugrundeliegenden Beziehungen zwischen gemessenen Variablen zu identifizieren. [ 1 ] Sie wird häufig von Forschern bei der Entwicklung einer Skala (einer Sammlung von Fragen zur Messung eines bestimmten Forschungsthemas) eingesetzt und dient dazu, latente Konstrukte zu identifizieren , die einer Reihe von gemessenen Variablen zugrunde liegen. [ 2 ] Sie sollte angewendet werden, wenn der Forscher keine a priori Hypothesen über Faktoren oder Muster der gemessenen Variablen hat. [ 3 ] Gemessene Variablen sind verschiedene Merkmale von Personen, die beobachtet und gemessen werden können. Beispiele für gemessene Variablen sind Körpergröße, Gewicht und Pulsfrequenz. Üblicherweise verfügen Forscher über eine große Anzahl gemessener Variablen, von denen angenommen wird, dass sie mit einer kleineren Anzahl „unbeobachteter“ Faktoren zusammenhängen. Forscher müssen die Anzahl der in die Analyse einzubeziehenden gemessenen Variablen sorgfältig abwägen. [ 2 ] EFA-Verfahren sind genauer, wenn jeder Faktor durch mehrere gemessene Variablen in der Analyse repräsentiert wird.
Die explorative Faktorenanalyse (EFA) basiert auf dem Common-Factor-Modell. [ 1 ] In diesem Modell werden manifeste Variablen als Funktion von gemeinsamen Faktoren, individuellen Faktoren und Messfehlern ausgedrückt. Jeder individuelle Faktor beeinflusst nur eine manifeste Variable und erklärt keine Korrelationen zwischen manifesten Variablen. Gemeinsame Faktoren beeinflussen mehrere manifeste Variablen, und die Faktorladungen messen den Einfluss eines gemeinsamen Faktors auf eine manifeste Variable. [ 1 ] Im Rahmen der EFA liegt unser Hauptaugenmerk auf der Identifizierung der gemeinsamen Faktoren und der zugehörigen manifesten Variablen.
Die explorative Faktorenanalyse (EFA) geht davon aus, dass jede Indikatorvariable mit jedem Faktor assoziiert sein kann. Bei der Skalenentwicklung sollten Forschende daher zunächst eine EFA durchführen, bevor sie zur konfirmatorischen Faktorenanalyse übergehen . [ 4 ] Die EFA ist unerlässlich, um die zugrunde liegenden Faktoren/Konstrukte einer Reihe gemessener Variablen zu bestimmen. Die konfirmatorische Faktorenanalyse ermöglicht es Forschenden, die Hypothese zu testen, dass ein Zusammenhang zwischen den beobachteten Variablen und ihren zugrunde liegenden latenten Faktoren/Konstrukten besteht. [ 5 ] Da es keine allgemeingültige Methode für die EFA gibt, müssen Forschende einige wichtige Entscheidungen hinsichtlich der Durchführung der Analyse treffen.
Anpassungsverfahren
Anpassungsverfahren dienen der Schätzung der Faktorladungen und der einzigartigen Varianzen des Modells ( Faktorladungen sind die Regressionskoeffizienten zwischen Items und Faktoren und messen den Einfluss eines gemeinsamen Faktors auf eine gemessene Variable). Es stehen verschiedene Anpassungsverfahren für die Faktorenanalyse zur Auswahl, jedoch gibt es nur wenige Informationen zu all ihren Stärken und Schwächen, und viele haben nicht einmal einen einheitlichen Namen. Hauptachsenfaktorisierung (PAF) und Maximum-Likelihood-Schätzung (ML) sind zwei allgemein empfohlene Extraktionsmethoden. Im Allgemeinen liefern ML oder PAF die besten Ergebnisse, je nachdem, ob die Daten normalverteilt sind oder die Annahme der Normalverteilung verletzt wurde. [ 2 ]
Maximum-Likelihood-Methode (ML)
Die Maximum-Likelihood-Methode bietet viele Vorteile, da sie die Berechnung einer Vielzahl von Güteindizes des Modells ermöglicht, die statistische Signifikanz von Faktorladungen prüft, Korrelationen zwischen Faktoren berechnet und Konfidenzintervalle für diese Parameter ermittelt. [ 6 ] Bei normalverteilten Daten ist die ML-Methode die beste Wahl, da sie „die Berechnung einer Vielzahl von Güteindizes des Modells ermöglicht und statistische Signifikanztests von Faktorladungen und Korrelationen zwischen Faktoren sowie die Berechnung von Konfidenzintervallen erlaubt“. [ 2 ]
Hauptachsenfaktorisierung (PAF)
Die Hauptachsenfaktorisierung (PAF) wird so genannt, weil der erste Faktor möglichst viel gemeinsame Varianz erklärt, der zweite Faktor die nächstgrößte usw. Da es sich um ein deskriptives Verfahren handelt, eignet es sich am besten, wenn der Fokus auf der eigenen Stichprobe liegt und die Ergebnisse nicht verallgemeinert werden sollen. Ein Nachteil der PAF ist, dass sie im Vergleich zur Maximum-Likelihood-Methode (ML) nur eine begrenzte Auswahl an Güteindizes bietet und keine Berechnung von Konfidenzintervallen und Signifikanztests ermöglicht.
Auswahl der geeigneten Anzahl von Faktoren
Bei der Auswahl der Anzahl der in ein Modell aufzunehmenden Faktoren müssen Forscher ein Gleichgewicht zwischen Sparsamkeit (ein Modell mit relativ wenigen Faktoren) und Plausibilität (dass genügend Faktoren vorhanden sind, um Korrelationen zwischen gemessenen Variablen angemessen zu berücksichtigen) finden. [ 7 ]
Überfaktorisierung tritt auf, wenn zu viele Faktoren in ein Modell einbezogen werden, und kann dazu führen, dass Forscher Konstrukte mit geringem theoretischem Wert vorschlagen.
Unterfaktorisierung tritt auf, wenn zu wenige Faktoren in ein Modell einbezogen werden. Sind nicht genügend Faktoren vorhanden, ist mit erheblichen Fehlern zu rechnen. Gemessene Variablen, die auf einen nicht im Modell enthaltenen Faktor laden, können fälschlicherweise auf enthaltenen Faktoren laden und so die tatsächlichen Faktorladungen verfälschen. Dies kann zu rotierten Lösungen führen, in denen zwei Faktoren zu einem einzigen Faktor zusammengefasst werden, wodurch die wahre Faktorstruktur verschleiert wird.
Es gibt verschiedene Verfahren zur Bestimmung der optimalen Anzahl an Faktoren, die in einer explorativen Faktorenanalyse (EFA) beibehalten werden sollen. Im Allgemeinen gehen die meisten bestehenden Verfahren bei der Bestimmung der geeigneten Faktorenanzahl entweder (1) durch die Untersuchung von Eigenwertmustern der Kovarianzmatrix oder (2) durch die Behandlung als Modellselektionsproblem vor. [ 8 ] Zu den bestehenden Ansätzen gehören: Kaisers (1960) Eigenwert-größer-eins-Regel (oder K1-Regel), [ 9 ] Cattells (1966) Scree-Plot , [ 10 ] Revelle und Rocklins (1979) Kriterium für sehr einfache Strukturen, [ 11 ] Modellvergleichstechniken, [ 12 ] Raiche, Roipel und Blais’ (2006) Beschleunigungsfaktor und optimale Koordinaten, [ 13 ] Velicers (1976) Minimum-Average-Partial-Ansatz, [ 14 ] Horns (1965) Parallelanalyse sowie Ruscio und Roches (2012) Vergleichsdaten. [ 15 ] Neuere Simulationsstudien zur Robustheit dieser Techniken legen nahe, dass die fünf letztgenannten Anwender besser bei der Modellierung von Daten unterstützen können. [ 15 ] Diese fünf modernen Techniken sind durch die integrierte Nutzung der IBM SPSS Statistics Software (SPSS) und R (R Development Core Team, 2011) leicht zugänglich. Hinweise zur Durchführung dieser Verfahren für stetige, ordinale und heterogene (stetige und ordinale) Daten finden sich bei Courtney (2013) [ 16 ] .
Mit Ausnahme des sehr einfachen Strukturkriteriums von Revelle und Rocklin (1979), Modellvergleichsverfahren und Velicers (1976) minimalem durchschnittlichen partiellen Eigenwerts basieren alle anderen Verfahren auf der Analyse von Eigenwerten. Der Eigenwert eines Faktors repräsentiert den Anteil der Varianz der Variablen, der durch diesen Faktor erklärt wird. Je kleiner der Eigenwert, desto geringer trägt der Faktor zur Erklärung der Varianz der Variablen bei. [ 1 ]
Nachfolgend finden Sie eine kurze Beschreibung jedes der neun oben genannten Verfahren.
Kaisers (1960) Eigenwert-größer-eins-Regel (K1- oder Kaiser-Kriterium)
Das nach dem amerikanischen Psychologen Henry Felix Kaiser benannte Kaiser-Kriterium bestimmt die Anzahl der Faktoren, indem es die Eigenwerte der Korrelationsmatrix berechnet und zählt, wie viele dieser Eigenwerte größer als 1 sind. [ 9 ] Diese Zahl gibt die Anzahl der in das Modell aufzunehmenden Faktoren an. Ein Nachteil dieses Verfahrens ist seine Willkür (z. B. wird ein Eigenwert von 1,01 berücksichtigt, ein Eigenwert von 0,99 jedoch nicht). Dieses Verfahren führt häufig zu einer Überfaktorisierung und manchmal auch zu einer Unterfaktorisierung und gilt im Vergleich zu moderneren Methoden als suboptimal. [ 2 ] Um die Probleme des Kriteriums zu verringern, wurde eine Variante des K1-Kriteriums entwickelt. Hierbei berechnet der Forscher Konfidenzintervalle für jeden Eigenwert und behält nur Faktoren bei, deren gesamtes Konfidenzintervall größer als 1,0 ist. [ 17 ] [ 18 ]
Cattells (1966) Geröllfeld

Berechnen Sie die Eigenwerte der Korrelationsmatrix und stellen Sie diese absteigend grafisch dar. Untersuchen Sie die Grafik, um den letzten signifikanten Abfall der Eigenwerte zu bestimmen. Die Anzahl der Punkte vor diesem letzten Abfall entspricht der Anzahl der in das Modell aufzunehmenden Faktoren. [ 10 ] Diese Methode wurde aufgrund ihrer subjektiven Natur kritisiert (d. h., es gibt keine eindeutige objektive Definition für einen signifikanten Abfall). [ 19 ] Da dieses Verfahren subjektiv ist, empfiehlt Courtney (2013) es nicht. [ 16 ]
Revelle und Rocklin (1979) sehr einfache Struktur
Das VSS-Kriterium von Revelle und Rocklin (1979) operationalisiert diese Tendenz, indem es bewertet, inwieweit die ursprüngliche Korrelationsmatrix durch eine vereinfachte Mustermatrix reproduziert wird. In dieser vereinfachten Matrix wird nur die höchste Ladung jedes Items beibehalten, alle anderen Ladungen werden auf null gesetzt. Das VSS-Kriterium zur Beurteilung des Replikationsgrades kann Werte zwischen 0 und 1 annehmen und ist ein Maß für die Güte der Anpassung der Faktorlösung. Es wird anhand von Faktorlösungen mit einem Faktor (k = 1) bis zu einer vom Benutzer festgelegten theoretischen Maximalanzahl von Faktoren ermittelt. Die Faktorlösung mit dem höchsten VSS-Wert bestimmt anschließend die optimale Anzahl interpretierbarer Faktoren in der Matrix. Um Datensätze zu berücksichtigen, bei denen Items mit mehr als einem Faktor kovariieren (d. h. faktoriell komplexere Daten), kann das Kriterium auch mit vereinfachten Mustermatrizen durchgeführt werden, in denen die beiden höchsten Ladungen beibehalten und die übrigen auf null gesetzt werden (maximale VSS-Komplexität 2). Courtney empfiehlt VSS auch deshalb nicht, weil es an aussagekräftigen Simulationsstudien zur Leistungsfähigkeit des VSS-Kriteriums mangelt. [ 16 ]
Modellvergleichstechniken
Wählen Sie aus einer Reihe von Modellen mit unterschiedlicher Komplexität das beste Modell aus. Forscher verwenden Gütemaße, um Modelle anzupassen. Sie beginnen mit einem Modell ohne Faktoren und erhöhen die Anzahl der Faktoren schrittweise. Ziel ist es, letztendlich ein Modell auszuwählen, das die Daten deutlich besser erklärt als einfachere Modelle (mit weniger Faktoren) und genauso gut wie komplexere Modelle (mit mehr Faktoren).
Zur Beurteilung der Modellgüte können verschiedene Methoden verwendet werden: [ 2 ]
- Likelihood-Ratio-Test: [ 20 ] Dieser Test dient der Überprüfung der Nullhypothese, dass ein Modell eine perfekte Anpassung aufweist. Er sollte auf Modelle mit einer steigenden Anzahl von Faktoren angewendet werden, bis das Ergebnis nicht signifikant ist. Dies deutet darauf hin, dass das Modell nicht als gut an die Grundgesamtheit angepasst verworfen werden kann. Dieser Test sollte bei großen Stichprobenumfängen und normalverteilten Daten angewendet werden. Der Likelihood-Ratio-Test hat jedoch einige Nachteile. Erstens führen bei großen Stichprobenumfängen selbst kleine Abweichungen zwischen Modell und Daten zur Ablehnung des Modells. [ 21 ] [ 22 ] [ 23 ] Bei kleinen Stichprobenumfängen sind selbst große Abweichungen zwischen Modell und Daten möglicherweise nicht signifikant, was zu einer Unterfaktorisierung führen kann. [ 21 ] Ein weiterer Nachteil des Likelihood-Ratio-Tests besteht darin, dass die Nullhypothese einer perfekten Anpassung ein unrealistischer Standard ist. [ 24 ] [ 25 ]
- Der Root Mean Square Error of Approximation (RMSEA) ist ein Güteindex, der die Abweichung zwischen Modell und Daten pro Freiheitsgrad des Modells schätzt. Gängigen Faustregeln zufolge gelten Werte unter 0,05 als gute Anpassung, Werte zwischen 0,05 und 0,08 als akzeptable Anpassung, Werte zwischen 0,08 und 0,10 als grenzwertige Anpassung und Werte über 0,10 als schlechte Anpassung. [ 25 ] [ 26 ] Ein Vorteil des RMSEA-Güteindex besteht darin, dass er Konfidenzintervalle liefert, die es Forschern ermöglichen, verschiedene Modelle mit unterschiedlicher Anzahl an Faktoren zu vergleichen.
- Informationskriterien: Informationskriterien wie das Akaike-Informationskriterium (AIC) oder das Bayes'sche Informationskriterium (BIC) [ 27 ] können verwendet werden, um die Modellanpassung gegen die Modellkomplexität abzuwägen und eine optimale Anzahl von Faktoren auszuwählen.
- Vorhersagefehler außerhalb der Stichprobe (PE): Mithilfe des Zusammenhangs zwischen modellimplizierten Kovarianzmatrizen und standardisierten Regressionsgewichten lässt sich die Anzahl der Faktoren anhand von Vorhersagefehlern außerhalb der Stichprobe bestimmen. [ 8 ] Anders ausgedrückt: Der PE-Ansatz prüft die Fähigkeit eines Faktormodells mit k Faktoren, die Werte von p Items bei zurückgehaltenen Probanden vorherzusagen . Dabei wird die modellimplizierte Kovarianzstruktur genutzt, um Regressionen auf Itemebene abzuleiten (z. B. wird Item i als Linearkombination aller anderen Items vorhergesagt, wobei die Koeffizienten durch die inverse Kovarianzmatrix gegeben sind). Der Wert von k wird ausgewählt , der die Itemwerte außerhalb der Stichprobe am besten vorhersagt. In einer umfangreichen Simulationsstudie aus dem Jahr 2022 stellten Haslbeck und van Bork [ 8 ] fest, dass die PE-Methode im Vergleich zu den leistungsstärksten bestehenden Methoden (z. B. Parallelanalyse, explorative Graphanalyse, AIC) gut abschneidet.
Optimaler Koordinaten- und Beschleunigungsfaktor
Um die subjektive Schwäche des Scree-Tests nach Cattell (1966) zu überwinden, wurden [ 10 , 28 ] zwei Familien nicht-grafischer Lösungen vorgestellt. Die erste Methode, die sogenannte optimale Koordinate (OC), versucht, die Lage des Scree-Punktes durch Messung der Gradienten der Eigenwerte und ihrer vorhergehenden Koordinaten zu bestimmen. Die zweite Methode, der Beschleunigungsfaktor (AF), ist eine numerische Lösung zur Bestimmung der Koordinate, an der sich die Steigung der Kurve am abruptesten ändert. Beide Methoden haben in Simulationen die K1-Methode übertroffen. [ 15 ] In der Studie von Ruscio und Roche (2012) [ 15 ] lag die OC-Methode in 74,03 % der Fälle korrekt und erreichte damit eine vergleichbare Genauigkeit wie die PA-Methode (76,42 %). Die AF-Methode lag in 45,91 % der Fälle korrekt und zeigte eine Tendenz zur Unterschätzung. Die OC- und AF-Methoden, die mithilfe von Pearson-Korrelationskoeffizienten generiert wurden, wurden in der Simulationsstudie von Ruscio und Roche (2012) untersucht. Die Ergebnisse zeigten, dass beide Verfahren bei ordinalen Antwortkategorien von zwei bis sieben (C = 2–7) und quasi-kontinuierlichen Daten (C = 10 oder 20) sehr gut abschnitten. Aufgrund der Genauigkeit dieser Verfahren in der Simulation werden sie zur Bestimmung der Anzahl der in der explorativen Faktorenanalyse (EFA) zu berücksichtigenden Faktoren dringend empfohlen. Sie gehören zu den fünf von Courtney empfohlenen modernen Verfahren. [ 16 ]
Velicers Minimum Average Partial Test (MAP)
Velicers (1976) MAP-Test [ 14 ] „beinhaltet eine vollständige Hauptkomponentenanalyse, gefolgt von der Untersuchung einer Reihe von Matrizen partieller Korrelationen“ (S. 397). Die quadrierte Korrelation für Schritt „0“ (siehe Abbildung 4) ist die durchschnittliche quadrierte Korrelation außerhalb der Diagonalen der unpartitionierten Korrelationsmatrix. In Schritt 1 werden die erste Hauptkomponente und ihre zugehörigen Elemente herauspartialisiert. Anschließend wird die durchschnittliche quadrierte Korrelation außerhalb der Diagonalen für die resultierende Korrelationsmatrix für Schritt 1 berechnet. In Schritt 2 werden die ersten beiden Hauptkomponenten herauspartialisiert und die resultierende durchschnittliche quadrierte Korrelation außerhalb der Diagonalen erneut berechnet. Die Berechnungen werden für k minus eins Schritte durchgeführt (k entspricht der Gesamtzahl der Variablen in der Matrix). Schließlich werden die durchschnittlichen quadrierten Korrelationen aller Schritte verglichen, und die Schrittnummer, die zur niedrigsten durchschnittlichen quadrierten partiellen Korrelation geführt hat, bestimmt die Anzahl der beizubehaltenden Komponenten oder Faktoren (Velicer, 1976). Bei dieser Methode bleiben die Komponenten so lange erhalten, wie die Varianz in der Korrelationsmatrix systematische Varianz und nicht etwa Rest- oder Fehlervarianz darstellt. Obwohl die MAP-Technik methodisch der Hauptkomponentenanalyse ähnelt, hat sie sich in mehreren Simulationsstudien als sehr geeignet erwiesen, die Anzahl der beizubehaltenden Faktoren zu bestimmen. [ 15 ] [ 29 ] In seltenen Fällen kann MAP die Anzahl der Faktoren in einem Datensatz jedoch aus unbekannten Gründen stark überschätzen. [ 30 ] Dieses Verfahren ist über die Benutzeroberfläche von SPSS verfügbar. Siehe Courtney (2013) [ 16 ] für weitere Informationen. Es handelt sich um eines seiner fünf empfohlenen modernen Verfahren.
Parallelanalyse
Zur Durchführung des PA-Tests berechnen die Nutzer die Eigenwerte der Korrelationsmatrix und tragen diese absteigend auf. Anschließend wird eine Reihe zufälliger Eigenwerte dargestellt. Die Anzahl der Eigenwerte vor den Schnittpunkten gibt an, wie viele Faktoren in das Modell aufgenommen werden sollten. [ 21 ] [ 31 ] [ 32 ] Dieses Verfahren kann bis zu einem gewissen Grad willkürlich sein (d. h. ein Faktor, der den Schwellenwert gerade erreicht, wird aufgenommen, ein anderer knapp darunter nicht). [ 2 ] Darüber hinaus reagiert die Methode sehr empfindlich auf die Stichprobengröße; PA schlägt bei größeren Stichproben tendenziell mehr Faktoren vor. [ 33 ] Trotz dieser Einschränkungen erzielt das Verfahren in Simulationsstudien sehr gute Ergebnisse und gehört zu den von Courtney empfohlenen Verfahren. [ 16 ] PA ist in vielen gängigen Statistikprogrammen wie R und SPSS implementiert .
Vergleichsdaten von Ruscio und Roche
Im Jahr 2012 führten Ruscio und Roche [ 15 ] das Verfahren der vergleichenden Daten (CD) ein, um die PA-Methode zu verbessern. Die Autoren geben an, dass „anstatt zufällige Datensätze zu generieren, die lediglich den Stichprobenfehler berücksichtigen , mehrere Datensätze mit bekannter Faktorstruktur analysiert werden, um denjenigen zu ermitteln, der das Eigenwertprofil der tatsächlichen Daten am besten reproduziert“ (S. 258). Die Stärke des Verfahrens liegt in seiner Fähigkeit, neben dem Stichprobenfehler auch die Faktorstruktur und die multivariate Verteilung der Items einzubeziehen. Die Simulationsstudie von Ruscio und Roche (2012) [ 15 ] ergab, dass das CD-Verfahren viele andere Methoden zur Bestimmung der korrekten Anzahl der beizubehaltenden Faktoren übertraf. In dieser Studie sagte die CD-Technik unter Verwendung von Pearson-Korrelationen die korrekte Anzahl der Faktoren in 87,14 % der Fälle korrekt voraus. Die simulierte Studie umfasste jedoch nie mehr als fünf Faktoren. Daher muss die Anwendbarkeit des CD-Verfahrens zur Schätzung von Faktorstrukturen mit mehr als fünf Faktoren noch untersucht werden. Courtney führt dieses Verfahren in seiner Empfehlungsliste auf und gibt Anleitungen, die zeigen, wie es einfach über die Benutzeroberfläche von SPSS durchgeführt werden kann. [ 16 ]
Im Jahr 2023 schlugen Goretzko und Ruscio den Vergleichsdatenwald als Erweiterung des CD-Ansatzes vor. [ 34 ]
Konvergenz mehrerer Tests
Eine Übersichtsarbeit von Henson und Roberts (2006) zu 60 Fachartikeln ergab, dass keine der Studien mehrere moderne Verfahren zur Konvergenzsuche nutzte, wie beispielsweise die partiellen Angleichungen (PA) und Velicers (1976) Minimum Average Partial (MAP)-Verfahren. Die Simulationsstudie von Ruscio und Roche (2012) belegte den empirischen Vorteil der Konvergenzsuche. Bei Übereinstimmung der CD- und PA-Verfahren lag die Genauigkeit der geschätzten Faktoranzahl in 92,2 % der Fälle korrekt. Ruscio und Roche (2012) zeigten, dass sich die Genauigkeit der Schätzung durch weitere übereinstimmende Tests noch weiter steigern ließ. [ 16 ]
Anpassung der von Courtney empfohlenen Verfahren an ordinale und kontinuierliche Daten
Aktuelle Simulationsstudien im Bereich der Psychometrie legen nahe, dass die Verfahren der Parallelanalyse, der minimalen partiellen Mittelwerte und des Datenvergleichs für verschiedene Datensituationen optimiert werden können. So lässt sich beispielsweise die Leistung des Tests mit minimalen partiellen Mittelwerten bei ordinalen Daten durch die Verwendung polychorischer Korrelationen anstelle von Pearson-Korrelationen verbessern. Courtney (2013) [ 16 ] beschreibt detailliert, wie jedes dieser drei Verfahren optimiert und gleichzeitig über die SPSS-Benutzeroberfläche durchgeführt werden kann.
Faktorrotation
Die Faktorrotation ist ein häufig angewandter Schritt in der explorativen Faktorenanalyse (EFA) und dient der besseren Interpretation von Faktormatrizen. [ 35 ] [ 36 ] [ 37 ] Für jede Lösung mit zwei oder mehr Faktoren gibt es unendlich viele Orientierungen der Faktoren, die die Daten gleichermaßen gut erklären. Da es keine eindeutige Lösung gibt, muss der Forscher aus den unendlich vielen Möglichkeiten eine einzige auswählen. Ziel der Faktorrotation ist es, die Faktoren im mehrdimensionalen Raum so zu rotieren , dass eine Lösung mit möglichst einfacher Struktur entsteht. Eine einfache Struktur ist dabei eine Faktormatrix mit m Spalten, in der gilt: [ 35 ]
- Jede Zeile (die die Ladungen eines einzelnen Items auf alle m Faktoren angibt) enthält mindestens eine Null.
- Jede Spalte (die die Ladungen aller Items auf einem einzelnen Faktor angibt) enthält mindestens m Nullen.
- Alle Spaltenpaare (d. h. Faktoren) haben mehrere Zeilen (d. h. Elemente), die in einer Spalte eine Ladung von Null aufweisen, in der anderen jedoch nicht (d. h. alle Faktorenpaare haben mehrere Elemente, die die Faktoren unterscheiden können).
- Wenn m ≥ 4, sollten alle Spaltenpaare mehrere Zeilen mit Nullen in beiden Spalten aufweisen.
- Alle Spaltenpaare sollten wenige Zeilen mit von Null verschiedenen Ladungen in beiden Spalten aufweisen (d. h. es sollten wenige Elemente mit Kreuzladungen vorhanden sein).
Es gibt zwei Hauptarten der Faktorrotation: die orthogonale und die schiefe Rotation.
Orthogonale Rotation
Orthogonale Rotationen setzen voraus, dass Faktoren senkrecht zueinander stehen und somit unkorreliert sind . Ein Vorteil der orthogonalen Rotation ist ihre Einfachheit und konzeptionelle Klarheit, allerdings gibt es auch einige Nachteile. In den Sozialwissenschaften besteht oft eine theoretische Grundlage für die Annahme, dass Konstrukte korreliert sind. Daher sind orthogonale Rotationen möglicherweise nicht sehr realistisch, da sie dies nicht zulassen. Da orthogonale Rotationen zudem die Unkorreliertheit der Faktoren voraussetzen, führen sie seltener zu Lösungen mit einfacher Struktur. [ 2 ]
Die Varimax-Rotation ist eine orthogonale Rotation der Faktorachsen, die die Varianz der quadrierten Ladungen eines Faktors (Spalte) auf alle Variablen (Zeilen) einer Faktormatrix maximiert. Dadurch werden die ursprünglichen Variablen anhand des extrahierten Faktors differenziert. Jeder Faktor weist tendenziell entweder hohe oder niedrige Ladungen einer bestimmten Variable auf. Eine Varimax-Lösung liefert Ergebnisse, die es möglichst einfach machen, jede Variable einem einzigen Faktor zuzuordnen. Dies ist die gebräuchlichste Methode der orthogonalen Rotation. [ 2 ]
Die Quartimax-Rotation ist eine orthogonale Rotation, die die quadrierten Ladungen für jede Variable anstatt für jeden Faktor maximiert. Dadurch wird die Anzahl der Faktoren minimiert, die zur Erklärung jeder Variable benötigt werden. Diese Art der Rotation erzeugt häufig einen allgemeinen Faktor, auf dem die meisten Variablen mit hoher oder mittlerer Ladung vorliegen. [ 38 ]
Die Equimax-Rotation ist ein Kompromiss zwischen Varimax- und Quartimax-Kriterien.
Schräge Drehung
Schiefe Rotationen ermöglichen Korrelationen zwischen Faktoren. Ein Vorteil schiefer Rotationen besteht darin, dass sie Lösungen mit besserer einfacher Struktur liefern, wenn Korrelationen zwischen den Faktoren zu erwarten sind, und dass sie Schätzungen dieser Korrelationen ermöglichen. [ 2 ] Sind die Faktoren nicht miteinander korreliert, können diese Rotationen Lösungen erzeugen, die denen orthogonaler Rotationen ähneln.
Es werden verschiedene Verfahren der schrägen Rotation häufig angewendet. Die direkte Oblimin-Rotation ist die Standardmethode. Die Promax-Rotation findet sich oft in älterer Literatur, da sie einfacher zu berechnen ist als die Oblimin-Rotation. Weitere Methoden der schrägen Rotation sind die direkte Quartimin-Rotation und die Harris-Kaiser-Orthoglique-Rotation. [ 2 ]
Unrotierte Lösung
Gängige Software zur Faktorenanalyse kann eine unrotierte Lösung erzeugen. Dies entspricht dem Ergebnis einer Hauptachsenfaktorisierung ohne weitere Rotation. Die sogenannte unrotierte Lösung ist in Wirklichkeit eine orthogonale Rotation, die die Varianz der ersten Faktoren maximiert. Sie liefert tendenziell einen allgemeinen Faktor mit Ladungen für die meisten Variablen. Dies kann hilfreich sein, wenn viele Variablen miteinander korreliert sind, wie ein oder wenige dominierende Eigenwerte im Scree-Plot zeigen .
Die Nützlichkeit einer unrotierten Lösung wurde durch eine Metaanalyse von Studien zu kulturellen Unterschieden unterstrichen. Diese zeigte, dass viele veröffentlichte Studien zu kulturellen Unterschieden zwar ähnliche Ergebnisse in der Faktorenanalyse lieferten, die Faktoren jedoch unterschiedlich rotierten. Die Rotation der Faktoren verschleierte die Ähnlichkeit zwischen den Ergebnissen verschiedener Studien und die Existenz eines starken allgemeinen Faktors, während die unrotierten Lösungen deutlich ähnlicher waren. [ 39 ] [ 40 ]
Faktoreninterpretation
Faktorladungen sind numerische Werte, die die Stärke und Richtung des Einflusses eines Faktors auf eine gemessene Variable angeben. Sie zeigen an, wie stark der Faktor die gemessene Variable beeinflusst. Um die Faktoren im Modell zu benennen, sollten Forschende das Faktormuster untersuchen, um festzustellen, welche Items auf welchen Faktoren hoch laden, und anschließend die Gemeinsamkeiten dieser Items ermitteln. [ 2 ] Die Gemeinsamkeiten der Items bestimmen die Bedeutung des jeweiligen Faktors. Die Interpretation gilt seit Langem als wichtiger, aber schwieriger Bestandteil des Analyseprozesses. [ 41 ]
Obwohl die explorative Faktorenanalyse ein leistungsstarkes Instrument zur Aufdeckung zugrundeliegender Strukturen zwischen Variablen darstellt, ist es entscheidend, sich nicht ohne adäquate theoretische Fundierung darauf zu verlassen. Armstrongs Kritik [ 42 ] hebt hervor, dass eine EFA ohne theoretischen Rahmen zu irreführenden Interpretationen führen kann. Beispielsweise konnte in einer hypothetischen Fallstudie zur Analyse verschiedener physikalischer Eigenschaften von Metallen die EFA die wahren zugrundeliegenden Faktoren nicht identifizieren, sondern erzeugte stattdessen ein überfaktorisiertes Modell, das die Einfachheit der Beziehungen zwischen den beobachteten Variablen verschleierte. Ebenso können schlecht konzipierte Umfrageitems zu Scheinfaktorenstrukturen führen. [ 43 ]
Siehe auch
- Konfirmatorische Faktorenanalyse
- Exploratorische Faktorenanalyse vs. Hauptkomponentenanalyse
- Exploratorische Faktorenanalyse (Wikiversity)
- Faktorenanalyse
Referenzen
- ^ a b c d Norris, Megan; Lecavalier, Luc (17. Juli 2009). „Evaluating the Use of Exploratory Factor Analysis in Developmental Disability Psychological Research“. Journal of Autism and Developmental Disorders . 40 (1): 8–20 . doi : 10.1007/s10803-009-0816-2 . PMID 19609833. S2CID 45751299 .
- Fabrigar , Leandre R.; Wegener, Duane T.; MacCallum, Robert C.; Strahan, Erin J. (1. Januar 1999). „ Evaluating the use of exploratory factor analysis in psychological research“ ( PDF) . Psychological Methods . 4 ( 3): 272–299 . doi : 10.1037/1082-989X.4.3.272 .
- ^ Finch, JF; West, SG (1997). „Die Untersuchung der Persönlichkeitsstruktur: Statistische Modelle“. Journal of Research in Personality . 31 (4): 439–485 . doi : 10.1006/jrpe.1997.2194 .
- ^ Worthington, Roger L.; Whittaker, Tiffany A. J. (1. Januar 2006). „Skalenentwicklungsforschung: Eine Inhaltsanalyse und Empfehlungen für bewährte Verfahren“. The Counseling Psychologist . 34 (6): 806–838 . doi : 10.1177/0011000006288127 . S2CID 146284440 .
- ^ Suhr, DD (2006). Exploratorische oder konfirmatorische Faktorenanalyse? (S. 1-17). Cary: SAS Institute.
- ^ Cudeck, R.; O'Dell, L. L. (1994). „Anwendungen von Standardfehlerschätzungen in der uneingeschränkten Faktorenanalyse: Signifikanztests für Faktorladungen und Korrelationen“. Psychological Bulletin . 115 (3): 475–487 . doi : 10.1037/0033-2909.115.3.475 . PMID 8016288 .
- ^ Fabrigar, Leandre R.; Wegener, Duane T. (12.01.2012). Explorative Faktorenanalyse . Oxford: Oxford University Press. ISBN 978-0-19-973417-7Die
- Haslbeck , Jonas MB ; van Bork, Riet (Februar 2024). „ Schätzung der Anzahl von Faktoren in der explorativen Faktorenanalyse mittels Out-of-Sample-Vorhersagefehlern“ . Psychological Methods . 29 ( 1 ): 48–64 . doi : 10.1037/met0000528 . ISSN 1939-1463 . PMID 36326634 .
- ^ a b Kaiser, HF (1960). „Die Anwendung elektronischer Computer zur Faktorenanalyse“. Educational and Psychological Measurement . 20 : 141–151 . doi : 10.1177/001316446002000116 . S2CID 146138712 .
- ^ a b c Cattell, RB (1966). Der Scree-Test zur Bestimmung der Anzahl der Faktoren. Multivariate Behavioral Research, I, 245-276.
- Revelle , W.; Rocklin, T. (1979). „Very simple structure-alternative procedure for estimating the optimal number of interpretable factors“. Multivariate Behavioral Research . 14 (4): 403–414 . doi : 10.1207/s15327906mbr1404_2 . PMID 26804437 .
- ^ Fabrigar, Leandre R.; Wegener, Duane T.; MacCallum, Robert C.; Strahan, Erin J. (1999). „Evaluating the use of exploratory factor analysis in psychological research“. Psychological Methods . 4 (3): 272–299 . doi : 10.1037/1082-989X.4.3.272 .
- ^ Raiche, G., Roipel, M. & Blais, J. G. | Nichtgrafische Lösungen für den Cattell-Scree-Test. Vortrag auf der Jahrestagung der Psychometric Society, Montreal | Datum: 2006 | Abgerufen am 10. Dezember 2012 von der „Archivkopie“ (PDF) . Archiviert (PDF) vom Original am 21. Oktober 2013. Abgerufen am 3. Mai 2013 .
{{cite web}}: CS1 Wartung: Archivierte Kopie als Titel ( Link ) - ^ a b Velicer, WF (1976). „Bestimmung der Anzahl der Komponenten aus der Matrix der partiellen Korrelationen“. Psychometrika . 41 (3): 321–327 . doi : 10.1007/bf02293557 . S2CID 122907389 .
- Ruscio , J .; Roche, B. (2012). „ Bestimmung der Anzahl der zu berücksichtigenden Faktoren in einer explorativen Faktorenanalyse anhand von Vergleichsdaten einer bekannten Faktorenstruktur“. Psychological Assessment . 24 ( 2 ): 282–292 . doi : 10.1037/a0025697 . PMID 21966933 .
- Courtney , MGR ( 2013 ). Bestimmung der Anzahl der in der explorativen Faktorenanalyse zu berücksichtigenden Faktoren: Verwendung des SPSS R-Menüs v2.0 für fundiertere Schätzungen. Practical Assessment , Research and Evaluation , 18(8). Online verfügbar : „Archivierte Kopie“ . Archiviert vom Original am 17.03.2015 . Abgerufen am 08.06.2014 .
{{cite web}}: CS1 Wartung: Archivierte Kopie als Titel ( Link ) - ^ Larsen, R.; Warne, RT (2010). „Schätzung von Konfidenzintervallen für Eigenwerte in der explorativen Faktorenanalyse“ . Behavior Research Methods . 42 (3): 871–876 . doi : 10.3758/BRM.42.3.871 . PMID 20805609 .
- ^ Warne, R. T.; Larsen, R. (2014). „Evaluierung einer vorgeschlagenen Modifikation der Guttman-Regel zur Bestimmung der Anzahl von Faktoren in einer explorativen Faktorenanalyse“. Psychological Test and Assessment Modeling . 56 : 104–123 .
- ^ Kaiser, HF (1970). „Ein Little Jiffy der zweiten Generation“. Psychometrika . 35 (4): 401–415 . doi : 10.1007/bf02291817 . S2CID 121850294 .
- ^ Lawley, DN (1940). Die Schätzung von Faktorladungen mit der Maximum-Likelihood-Methode. Proceedings of the Royal Society of Edinburgh, 60A, 64-82.
- ^ a b c Humphreys, LG; Montanelli, RG Jr (1975). „Eine Untersuchung des Parallelanalysekriteriums zur Bestimmung der Anzahl gemeinsamer Faktoren“. Multivariate Behavioral Research . 10 (2): 193–205 . doi : 10.1207/s15327906mbr1002_5 .
- ^ Hakstian, AR; Rogers, WT; Cattell, RB (1982). „Das Verhalten von Number-Off-Faktors-Regeln mit simulierten Daten“. Multivariate Behavioral Research . 17 (2): 193–219 . doi : 10.1207/s15327906mbr1702_3 . PMID 26810948 .
- ^ Harris, ML; Harris, CW (1. Oktober 1971). „Eine faktorenanalytische Interpretationsstrategie“. Educational and Psychological Measurement . 31 (3): 589–606 . doi : 10.1177/001316447103100301 . S2CID 143515527 .
- ^ Maccallum, RC (1990). „Die Notwendigkeit alternativer Anpassungsmaße in der Kovarianzstrukturmodellierung“. Multivariate Behavioral Research . 25 (2): 157–162 . doi : 10.1207/s15327906mbr2502_2 . PMID 26794477 .
- ^ a b Browne, MW; Cudeck, R. (1992). „Alternative Wege zur Beurteilung der Modellpassung“. Sociological Methods and Research . 21 (2): 230–258 . doi : 10.1177/0049124192021002005 . S2CID 120166447 .
- ^ Steiger, JH (1989). EzPATH: Ein Zusatzmodul für SYSTAT und sygraph. Evanston, IL: SYSTAT
- ^ Neath, AA, & Cavanaugh, JE (2012). Das Bayes'sche Informationskriterium: Hintergrund, Herleitung und Anwendungen. Wiley Interdisciplinary Reviews: Computational Statistics, 4(2), 199-203.
- ^ Raiche, Roipel und Blais (2006)
- ^ Garrido, L. E., Abad, F. J. & Ponsoda, V. (2012). Horns Parallelanalyse mit ordinalen Variablen neu betrachtet. Psychological Methods. Online-Vorabveröffentlichung. doi : 10.1037/a0030005
- ^ Warne, R. T.; Larsen, R. (2014). „Evaluierung einer vorgeschlagenen Modifikation der Guttman-Regel zur Bestimmung der Anzahl von Faktoren in einer explorativen Faktorenanalyse“. Psychological Test and Assessment Modeling . 56 : 104–123 .
- ^ Horn, John L. (1. Juni 1965). „Eine Begründung und ein Test für die Anzahl der Faktoren in der Faktorenanalyse“. Psychometrika . 30 (2): 179–185 . doi : 10.1007/BF02289447 . PMID 14306381. S2CID 19663974 .
- ^ Humphreys, LG; Ilgen, DR (1. Oktober 1969). „Note On a Criterion for the Number of Common Factors“. Educational and Psychological Measurement . 29 (3): 571–578 . doi : 10.1177/001316446902900303 . S2CID 145258601 .
- ^ Warne, RG; Larsen, R. (2014). „Evaluierung einer vorgeschlagenen Modifikation der Guttman-Regel zur Bestimmung der Anzahl von Faktoren in einer explorativen Faktorenanalyse“. Psychological Test and Assessment Modeling . 56 : 104–123 .
- ^ Goretzko, David; Ruscio, John (15.06.2023). „Der Vergleichsdatenwald: Ein neuer Vergleichsdatenansatz zur Bestimmung der Anzahl von Faktoren in der explorativen Faktorenanalyse“ . Behavior Research Methods . 56 (3): 1838–1851 . doi : 10.3758/s13428-023-02122-4 . ISSN 1554-3528 . PMC 10991039. PMID 37382813 .
- ^ a b Browne, Michael W. (Januar 2001). „Ein Überblick über die analytische Rotation in der explorativen Faktorenanalyse“. Multivariate Behavioral Research . 36 (1): 111–150 . doi : 10.1207/S15327906MBR3601_05 . S2CID 9598774 .
- ^ Sass, Daniel A.; Schmitt, Thomas A. (29. Januar 2010). „Eine vergleichende Untersuchung von Rotationskriterien in der explorativen Faktorenanalyse“. Multivariate Behavioral Research . 45 (1): 73–103 . doi : 10.1080/00273170903504810 . PMID 26789085. S2CID 6458980 .
- ^ Schmitt, Thomas A.; Sass, Daniel A. (Februar 2011). „Rotationskriterien und Hypothesentests für die explorative Faktorenanalyse: Implikationen für Faktorladungen und Interfaktorkorrelationen“. Educational and Psychological Measurement . 71 (1): 95–113 . doi : 10.1177/0013164410387348 . S2CID 120709021 .
- ^ Neuhaus, Jack O; Wrigley, C. (1954). „Die Quartimax-Methode“. British Journal of Statistical Psychology . 7 (2): 81–91 . doi : 10.1111/j.2044-8317.1954.tb00147.x .
- ^ Fog, A. (2020). „Ein Test der Reproduzierbarkeit der Clusterung kultureller Variablen“. Cross-Cultural Research . 55 : 29–57 . doi : 10.1177/1069397120956948 . S2CID 224909443 .
- ^ „Untersuchung der Faktoren im TIMSS-Fragebogen für australische Viertklässler aus dem Jahr 2015 hinsichtlich ihrer Einstellung zur Wissenschaft mittels explorativer Faktorenanalyse (EFA)“ . North American Academic Research . 3 .
- ^ Copeland, Herman A. (März 1935). „Eine Anmerkung zu „Die Vektoren des Geistes“." . Psychological Review . 42 (2): 216– 218. doi : 10.1037/h0057026 . ISSN 1939-1471 .
- ^ Armstrong, J. Scott (Dezember 1967). „Theorieableitung mittels Faktorenanalyse oder Tom Swift und seine elektrische Faktorenanalysemaschine“. The American Statistician . 21 (5): 17–21 . doi : 10.1080/00031305.1967.10479849 . hdl : 1721.1/47256 .
- ^ Maul, Andrew (3. April 2017). „Überdenken traditioneller Methoden der Umfragevalidierung“. Measurement: Interdisciplinary Research and Perspectives . 15 (2): 51–69 . doi : 10.1080/15366367.2017.1348108 .
Externe Links
- Bewährte Verfahren in der explorativen Faktorenanalyse: Vier Empfehlungen für optimale Ergebnisse. http://pareonline.net/pdf/v10n7.pdf
- Wikiversity: Explorative Faktorenanalyse. http://en.wikiversity.org/wiki/Exploratory_factor_analysis
- Tucker und MacCallum: Explorative Faktorenanalyse.pdf