Flynns Taxonomie ist eine Klassifizierung von Computerarchitekturen , die 1966 von Michael J. Flynn [ 1 ] vorgeschlagen und 1972 erweitert wurde [ 2 ]. Das Klassifizierungssystem hat sich etabliert und dient als Werkzeug für den Entwurf moderner Prozessoren und ihrer Funktionalitäten. Mit dem Aufkommen von Multiprocessing - CPUs hat sich der Multiprogrammierungskontext als Erweiterung des Klassifizierungssystems entwickelt. Die Vektorverarbeitung , die in Duncans Taxonomie [ 3 ] behandelt wird, fehlt in Flynns Werk, da der Cray -1 erst 1977 auf den Markt kam; Flynns zweite Veröffentlichung erschien 1972.
Klassifizierungen
Die vier von Flynn definierten ursprünglichen Klassifizierungen basieren auf der Anzahl der gleichzeitig verfügbaren Befehls- (oder Kontroll-) und Datenströme in der Architektur. [ 4 ] Flynn definierte 1972 drei weitere Unterkategorien von SIMD. [ 2 ]
| Flynns Taxonomie |
|---|
| Einzelner Datenstrom |
| Mehrere Datenströme |
| SIMD-Unterkategorien [ 5 ] |
| Siehe auch |
Einzelner Befehlsstrom, einzelner Datenstrom (SISD)
Ein sequenzieller Computer, der weder im Befehls- noch im Datenstrom Parallelität nutzt. Eine einzelne Steuereinheit (CU) lädt einen einzelnen Befehlsstrom (IS) aus dem Speicher. Anschließend generiert die CU die entsprechenden Steuersignale, um ein einzelnes Verarbeitungselement (PE) anzuweisen, einen einzelnen Datenstrom (DS) zu verarbeiten, d. h. jeweils eine Operation auszuführen.
Beispiele für SISD-Architekturen sind die traditionellen Uniprozessor- Maschinen wie ältere Personalcomputer (PCs) (um 2010 hatten viele PCs mehrere Kerne) und ältere Mainframe-Computer .
Single Instruction Stream, Multiple Data Streams (SIMD)
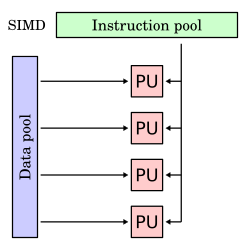
Ein einzelner Befehl wird gleichzeitig auf mehrere verschiedene Datenströme angewendet. Befehle können sequenziell, beispielsweise durch Pipelining, oder parallel von mehreren Funktionseinheiten ausgeführt werden. Flynns Arbeit von 1972 unterteilte SIMD in drei weitere Kategorien: [ 2 ]
- Array-Prozessoren, heute als SIMT bekannt , empfangen zwar denselben Befehl, aber jede Parallelverarbeitungseinheit (PU) verfügt über einen eigenen, separaten Speicher und Registersatz . Der Speicher jeder PU wird nicht mit anderen PUs geteilt. Frühe SIMT-Prozessoren besaßen skalare PUs (1 Bit im SOLOMON , 64 Bit im ILLIAC IV ), moderne SIMT-Prozessoren – GPUs – hingegen verwenden ausnahmslos SWAR- ALUs.
- Pipeline -Prozessoren empfangen einen (gleichen) Befehl, lesen dann Daten aus einer zentralen Ressource, verarbeiten jeweils Fragmente dieser Daten (typischerweise „Elemente“ genannt) und schreiben die Ergebnisse anschließend wieder in dieselbe zentrale Ressource zurück. In Abbildung 5 von Flynns Arbeit aus dem Jahr 1972 ist diese Ressource der Hauptspeicher; bei modernen CPUs ist diese Ressource typischerweise der Registersatz.
- Assoziativer Prozessor – Diese Prozessoren empfangen denselben Befehl, zusätzlich wird aber auch ein Registerwert der Steuereinheit an jede PU gesendet. Jede PU entscheidet dann anhand lokaler Daten unddes gesendeten Werts , ob der Befehl ausgeführt oder übersprungen wird.
Array-Prozessor

Die moderne Bezeichnung für einen Array-Prozessor lautet „ Single Instruction, Multiple Threads “ (SIMT). Dies ist eine eigenständige Klassifizierung in Flynns Taxonomie von 1972 als Unterkategorie von SIMD. Erkennbar ist er daran, dass die parallelen Subelemente über ein eigenes, unabhängiges Registerfile und einen eigenen Speicher (Cache und Datenspeicher) verfügen. Flynn nennt in seinen Originalveröffentlichungen zwei historische Beispiele für SIMT-Prozessoren: SOLOMON und ILLIAC IV .
Jedes Verarbeitungselement verfügt außerdem über ein unabhängiges Aktiv/Inaktiv-Bit, das das PE aktiviert/deaktiviert:
für jedes (PE j) // synchron-paralleles Array falls (aktives Maskenbit j) dann sende_Anweisung_an(PE j)
Nvidia verwendet den Begriff häufig in seinen Marketingmaterialien und technischen Dokumenten, um die Neuartigkeit seiner Architektur hervorzuheben. [ 6 ] SOLOMON existierte bereits über 60 Jahre vor Nvidia.
Pipelined-Prozessor

Flynns Arbeit von 1972 bezeichnet Pipeline-Prozessoren als eine Form der „zeitmultiplexierten“ Array-Verarbeitung. Dabei werden Elemente sequenziell aus dem Speicher gelesen, in (pipelinierten) Stufen verarbeitet und aus der letzten Stufe wieder sequenziell in den Speicher geschrieben. Aus dieser Beschreibung (Seite 954) geht hervor, dass Flynn wahrscheinlich auf Vektorverkettung und Speicher-zu-Speicher- Vektorprozessoren wie den TI ASC (entwickelt, hergestellt und verkauft zwischen 1966 und 1973) [ 7 ] und den CDC STAR-100, der zum Zeitpunkt der Veröffentlichung von Flynns Arbeit gerade angekündigt worden war, Bezug nahm.
Als Flynn 1972 seine Arbeit verfasste, nutzten viele Systeme den Hauptspeicher als Ressource für Lese- und Schreibvorgänge von Pipelines. Wenn die Ressource, auf die alle Pipelines zugreifen, nicht der Hauptspeicher, sondern das Skalarregister ist, entstehen moderne SIMD-Varianten. Beispiele hierfür sind Altivec , NEON und AVX .
Eine alternative Bezeichnung für diese Art von registerbasiertem SIMD ist „gepacktes SIMD“ [ 8 ] und eine weitere ist SIMD innerhalb eines Registers (SWAR) .
Assoziativer Prozessor

Der moderne Begriff für assoziativen Prozessor ist analog zu den Zellen eines inhaltsadressierbaren Speichers, von denen jede ihren eigenen Prozessor hat. Solche Prozessoren sind sehr selten.
broadcast_value = control_unit.register ( n ) broadcast_instruction = control_unit.array_instruction for each ( PE j ) // of associative array possible_match = PE [ j ] .match_register if broadcast_value == possible_match PE [ j ] .execute ( broadcast_instruction )Der Aspex Microelectronics Associative String Processor (ASP) [ 9 ] wurde in seinen Marketingmaterialien als „massiver, breiter SIMD-Prozessor“ bezeichnet, verfügte aber über Bit-Level -ALUs und Bit-Level-Prädikation (Flynns Taxonomie: Array-Verarbeitung). Jeder der 4096 Prozessoren besaß eigene Register und Speicher, einschließlich inhaltsadressierbarem Speicher (Flynns Taxonomie: assoziative Verarbeitung). Der 2010 erschienene Linedancer enthielt 4096 2-Bit-prädikierte SIMD-ALUs, jede mit eigenem CAM, und erreichte eine Verarbeitungsgeschwindigkeit von 800 Milliarden Befehlen pro Sekunde. [ 10 ] Der assoziative Array-SIMT-Prozessor ASP von Aspex erschien 20 Jahre vor NVIDIA. [ 11 ] [ 12 ] Die Klassifizierung dieses Prozessors nach Flynns Taxonomie gestaltet sich schwierig, da er sowohl assoziative als auch Array-Verarbeitung ermöglichte, die beide explizit vom Programmierer gesteuert werden konnten.
Mehrere Befehlsströme, ein einziger Datenstrom (MISD)
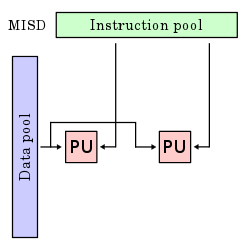
Mehrere Befehle verarbeiten einen Datenstrom. Diese Architektur ist unüblich und wird im Allgemeinen zur Fehlertoleranz eingesetzt. Heterogene Systeme arbeiten mit demselben Datenstrom und müssen sich auf ein Ergebnis einigen. Ein Beispiel hierfür ist der Flugsteuerungscomputer des Space Shuttles . [ 13 ]
Mehrere Befehlsströme, mehrere Datenströme (MIMD)
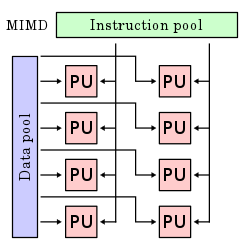
Mehrere autonome Prozessoren führen gleichzeitig unterschiedliche Anweisungen auf unterschiedlichen Daten aus. MIMD-Architekturen umfassen Mehrkern- Superskalarprozessoren und verteilte Systeme , die entweder einen gemeinsamen Speicherbereich oder einen verteilten Speicherbereich verwenden.
Diagramm zum Vergleich der Klassifizierungen
Diese vier Architekturen werden unten visuell dargestellt. Jede Verarbeitungseinheit (PU) wird für einen Einkern- oder Mehrkernrechner gezeigt:

Weitere Unterteilungen
Stand 2006 basieren alle der zehn leistungsstärksten und die meisten der 500 leistungsstärksten Supercomputer auf einer MIMD-Architektur.
Obwohl diese Einteilungen nicht zu Flynns Werk gehören, unterteilen einige die MIMD-Kategorie weiter in die beiden unten aufgeführten Kategorien [ 14 ] [ 15 ] [ 16 ] [ 17 ] [ 18 ] , und es werden mitunter sogar noch weitere Unterteilungen in Betracht gezogen. [ 19 ]
Einzelprogramm, mehrere Datenströme (SPMD)
Mehrere autonome Prozessoren führen gleichzeitig dasselbe Programm (jedoch unabhängig voneinander und nicht synchron wie bei SIMD) auf unterschiedlichen Daten aus. [ 20 ] Auch als Single Process Multiple Data ( SPMD) bezeichnet [ 18 ] – die Verwendung dieser Bezeichnung für SPMD ist technisch inkorrekt, da SPMD ein paralleles Ausführungsmodell ist und mehrere kooperierende Prozessoren zur Programmausführung voraussetzt. SPMD ist die gängigste Form der expliziten Parallelprogrammierung. [ 21 ] Das SPMD-Modell und der Begriff wurden von Frederica Darema vom RP3-Team vorgeschlagen. [ 22 ]
Mehrere Programme, mehrere Datenströme (MPMD)
Mehrere autonome Prozessoren führen gleichzeitig mindestens zwei unabhängige Programme aus. In HPC-Kontexten wird häufig ein Knoten als „Host“ (explizites Host/Knoten-Programmiermodell) oder „Manager“ (Manager/Worker-Strategie) ausgewählt. Dieser führt ein Programm aus, das Daten an alle anderen Knoten verteilt, die jeweils ein zweites Programm ausführen. Die anderen Knoten senden ihre Ergebnisse dann direkt an den Manager zurück. Ein Beispiel hierfür ist die Sony PlayStation 3-Spielkonsole mit ihrem SPU/PPU-Prozessor .
MPMD ist auch außerhalb von HPC-Umgebungen weit verbreitet. Beispielsweise kann das Build-System `make` mehrere Abhängigkeiten parallel erstellen, indem es neben der `make`-Datei selbst auch zielabhängige Programme verwendet. MPMD tritt häufig auch in Form von Pipelines auf. Ein einfacher Unix-Shell-Befehl wie `make` startet drei Prozesse, die separate Programme parallel ausführen, wobei die Ausgabe des einen Prozesses als Eingabe für den nächsten dient. ls | grep "A" | more
Diese beiden Ansätze unterscheiden sich von der expliziten Parallelprogrammierung im HPC dadurch, dass die einzelnen Programme generische Bausteine darstellen und nicht Teile eines spezifischen parallelen Algorithmus implementieren. Beim Pipelining-Ansatz steigt der Grad der verfügbaren Parallelität nicht mit der Größe des Datensatzes.
Siehe auch
- Fengs Klassifizierung
- Duncans Taxonomie
- Händlers Erlangen -Klassifizierungssystem (ECS)
Referenzen
- ^ Flynn, Michael J. (Dezember 1966). „Very high-speed computing systems“ (PDF) . Proceedings of the IEEE . 54 (12): 1901–1909 . doi : 10.1109/PROC.1966.5273 .
- Flynn , Michael J. ( September 1972). „ Some Computer Organizations and Their Effectiveness“ (PDF) . IEEE Transactions on Computers . C - 21 (9): 948–960 . doi : 10.1109 / TC.1972.5009071 . S2CID 18573685 .
- ^ Duncan, Ralph (Februar 1990). „A Survey of Parallel Computer Architectures“ (PDF) . Computer . 23 (2): 5–16 . doi : 10.1109/2.44900 . S2CID 15036692. Archiviert vom Original (PDF) am 18.07.2018 . Abgerufen am 18.07.2018 .
- ^ „Datenparallelität in Vektor-, SIMD- und GPU-Architekturen“ (PDF) . 12. November 2013.
- ^ Flynn, Michael J. (September 1972). „Some Computer Organizations and Their Effectiveness“ (PDF) . IEEE Transactions on Computers . C-21 (9): 948–960 . doi : 10.1109/TC.1972.5009071 .
- ^ „NVIDIAs CUDA-Rechenarchitektur der nächsten Generation: Fermi“ (PDF) . Nvidia .
- ^ Cragon, Harvey G. (21.05.1984). „Die Geschichte des fortgeschrittenen wissenschaftlichen Computers“ . www.bitsavers.org . Archiviert vom Original am 18.02.2025 . Abgerufen am 01.06.2026 .
- ^ Miyaoka, Y.; Choi, J.; Togawa, N.; Yanagisawa, M.; Ohtsuki, T. (2002). Ein Algorithmus zur Generierung von Hardwareeinheiten für die Prozessorkernsynthese mit gepackten SIMD-Befehlen . Asia-Pacific Conference on Circuits and Systems. S. 171–176 . doi : 10.1109/APCCAS.2002.1114930 . hdl : 2065/10689 . ISBN 0-7803-7690-0Die
- ^ Lea, RM (1988). „ASP: Ein kosteneffektiver paralleler Mikrocomputer“. IEEE Micro . 8 (5): 10–29 . doi : 10.1109/40.87518 . S2CID 25901856 .
- ^ „Linedancer HD – Übersicht“ . Aspex Semiconductor . Archiviert vom Original am 13. Oktober 2006.
- ^ Krikelis, A. (1988). Künstliche neuronale Netze auf einer massiv parallelen assoziativen Architektur . Internationale Konferenz für neuronale Netze. Dordrecht: Springer . doi : 10.1007/978-94-009-0643-3_39 . ISBN 978-94-009-0643-3Die
- ^ Ódor, Géza; Krikelis, Argy; Vesztergombi, György; Rohrbach, Francois. „Effektive Monte-Carlo-Simulation auf der massiv parallelen assoziativen String-Verarbeitungsarchitektur von System-V“ (PDF) .
- ^ Spector, A.; Gifford, D. (September 1984). „Das primäre Computersystem des Space Shuttles“ . Communications of the ACM . 27 (9): 872–900 . doi : 10.1145/358234.358246 . S2CID 39724471 .
- ^ „Single Program Multiple Data stream (SPMD)“ . Llnl.gov. Archiviert vom Original am 04.06.2004 . Abgerufen am 09.12.2013 .
- ^ „Programmiervoraussetzungen für das Kompilieren, Erstellen und Ausführen von Jobs“ . Lightning-Benutzerhandbuch . Archiviert vom Original am 1. September 2006.
- ^ „CTC Virtual Workshop“ . Web0.tc.cornell.edu . Abgerufen am 9. Dezember 2013 .
- ^ „NIST SP2 Primer: Distributed-memory programming“ . Math.nist.gov. Archiviert vom Original am 13.12.2013 . Abgerufen am 9.12.2013 .
- ^ a b „Verständnis der parallelen Jobverwaltung und Nachrichtenübermittlung auf IBM SP-Systemen“ . Archiviert vom Original am 3. Februar 2007.
- ^ „9.2 Strategien“ . Programmierung mit verteiltem Speicher . Archiviert vom Original am 10. September 2006.
- ^ Dieser Artikel basiert auf Material aus Flynns Taxonomie im Free On-line Dictionary of Computing vor dem 1. November 2008 und wurde unter den „Relicensing“-Bedingungen der GFDL , Version 1.3 oder später, übernommen.
- ^ „Single program multiple data“ . Nist.gov. 17.12.2004 . Abgerufen am 9.12.2013 .
- ^ Darema, Frederica ; George, David A.; Norton, V. Alan; Pfister, Gregory F. (1988). „Ein Single-Program-Multiple-Data-Rechenmodell für EPEX/FORTRAN“. Parallel Computing . 7 (1): 11–24 . doi : 10.1016/0167-8191(88)90094-4 .