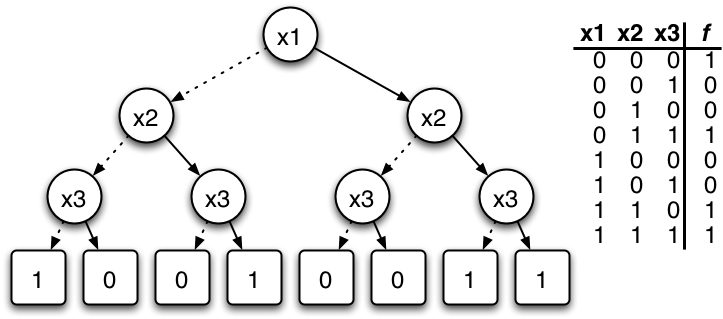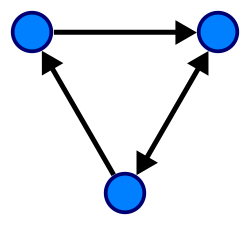
In der Informatik ist ein Graph ein abstrakter Datentyp , der dazu dient, die Konzepte des ungerichteten Graphen und des gerichteten Graphen aus dem Bereich der Graphentheorie innerhalb der Mathematik zu implementieren .
Eine Graphdatenstruktur besteht aus einer endlichen (und möglicherweise veränderlichen) Menge von Knoten (auch Eckpunkte genannt ) sowie einer Menge ungeordneter Paare dieser Knoten für einen ungerichteten Graphen oder einer Menge geordneter Paare für einen gerichteten Graphen. Diese Paare werden als Kanten (auch Verbindungen oder Linien genannt ) bezeichnet und für einen gerichteten Graphen zusätzlich als Pfeile oder Bögen . Die Knoten können Teil der Graphstruktur sein oder externe Entitäten darstellen, die durch ganzzahlige Indizes oder Referenzen repräsentiert werden .
Eine Graphdatenstruktur kann auch jeder Kante einen Kantenwert zuordnen , wie zum Beispiel eine symbolische Bezeichnung oder ein numerisches Attribut (Kosten, Kapazität, Länge usw.).
Betrieb

Zu den grundlegenden Operationen, die eine Graphdatenstruktur G bietet, gehören üblicherweise: [ 1 ]
- adjacent( G , x , y ) : prüft, ob eine Kante vom Knoten x zum Knoten y existiert ;
- neighbors( G , x ) : listet alle Knoten y auf , von denen eine Kante zum Knoten x führt ;
- add_vertex( G , x ) : Fügt den Knoten x hinzu , falls er noch nicht vorhanden ist;
- remove_vertex( G , x ) : entfernt den Knoten x , falls er vorhanden ist;
- add_edge( G , x , y , z ) : Fügt die Kante z vom Knoten x zum Knoten y hinzu , falls sie noch nicht existiert;
- remove_edge( G , x , y ) : Entfernt die Kante vom Knoten x zum Knoten y , falls vorhanden;
- get_vertex_value( G , x ) : gibt den Wert zurück, der dem Knoten x zugeordnet ist ;
- set_vertex_value( G , x , v ) : setzt den Wert, der dem Knoten x zugeordnet ist, auf v .
Strukturen, die den Kanten Werte zuordnen, bieten in der Regel auch: [ 1 ]
- get_edge_value( G , x , y ) : gibt den Wert zurück, der der Kante ( x , y ) zugeordnet ist;
- set_edge_value( G , x , y , v ) : setzt den Wert, der der Kante ( x , y ) zugeordnet ist, auf v .
Gängige Datenstrukturen zur Graphdarstellung
- Adjazenzliste [ 2 ]
- Knoten werden als Datensätze oder Objekte gespeichert, und jeder Knoten speichert eine Liste seiner benachbarten Knoten. Diese Datenstruktur ermöglicht die Speicherung zusätzlicher Daten zu den Knoten. Zusätzliche Daten können gespeichert werden, wenn auch Kanten als Objekte gespeichert werden; in diesem Fall speichert jeder Knoten seine zugehörigen Kanten und jede Kante ihre zugehörigen Knoten.
- Adjazenzmatrix [ 3 ]
- Eine zweidimensionale Matrix, deren Zeilen die Quellknoten und deren Spalten die Zielknoten darstellen. Daten zu Kanten und Knoten müssen extern gespeichert werden. Zwischen jedem Knotenpaar kann nur die Kostenfunktion einer Kante gespeichert werden.
- Inzidenzmatrix [ 4 ]
- Eine zweidimensionale Matrix, in der die Zeilen die Knoten und die Spalten die Kanten darstellen. Die Einträge geben die Inzidenzbeziehung zwischen dem Knoten in einer Zeile und der Kante in einer Spalte an.
Die folgende Tabelle gibt die Zeitkomplexität verschiedener Operationen auf Graphen für jede dieser Darstellungen an, wobei | V | die Anzahl der Knoten und | E | die Anzahl der Kanten ist. In den Matrixdarstellungen kodieren die Einträge die Kosten für das Folgen einer Kante. Die Kosten nicht vorhandener Kanten werden als ∞ angenommen.
| Adjazenzliste | Adjazenzmatrix | Inzidenzmatrix | |
|---|---|---|---|
| Graph speichern | |||
| Füge einen Eckpunkt hinzu | |||
| Kante hinzufügen | |||
| Vertex entfernen | |||
| Kante entfernen | |||
| Sind die Knoten x und y benachbart (vorausgesetzt, ihre Speicherpositionen sind bekannt)? | |||
| Anmerkungen | Das Entfernen von Knoten und Kanten ist langsam, da alle Knoten bzw. Kanten gefunden werden müssen. | Das Hinzufügen oder Entfernen von Eckpunkten ist langsam, da die Matrix in ihrer Größe angepasst/kopiert werden muss. | Das Hinzufügen oder Entfernen von Eckpunkten und Kanten ist langsam, da die Matrix in ihrer Größe angepasst/kopiert werden muss. |


Adjazenzlisten werden im Allgemeinen zur Darstellung dünnbesetzter Graphen bevorzugt , während eine Adjazenzmatrix vorzuziehen ist, wenn der Graph dicht ist; das heißt, wenn die Anzahl der Kanten nahe am Quadrat der Anzahl der Knoten liegt, oder wenn man schnell nachschlagen können muss, ob eine Kante zwei Knoten verbindet. [ 5 ] [ 6 ]


Effizientere Darstellung von Adjazenzmengen
Die Zeitkomplexität von Operationen in der Adjazenzlistendarstellung lässt sich verbessern, indem die Mengen benachbarter Knoten in effizienteren Datenstrukturen wie Hashtabellen oder balancierten binären Suchbäumen gespeichert werden (letztere Darstellung erfordert, dass Knoten durch Elemente einer linear geordneten Menge, wie z. B. ganze Zahlen oder Zeichenketten, identifiziert werden). Die Darstellung benachbarter Knoten mittels Hashtabellen führt zu einer amortisierten durchschnittlichen Zeitkomplexität von O ( n²) für die Prüfung der Adjazenz zweier gegebener Knoten und das Entfernen einer Kante sowie zu einer amortisierten durchschnittlichen Zeitkomplexität [ 7 ] von O(n²) für das Entfernen eines gegebenen Knotens x vom Grad n . Die Zeitkomplexität der übrigen Operationen und der asymptotische Speicherbedarf bleiben unverändert.


Parallele Darstellungen
Die Parallelisierung von Graphproblemen steht vor erheblichen Herausforderungen: datengetriebene Berechnungen, unstrukturierte Probleme, geringe Lokalität und ein hohes Verhältnis von Datenzugriff zu Rechenaufwand. [ 8 ] [ 9 ] Die für parallele Architekturen verwendete Graphdarstellung spielt eine entscheidende Rolle bei der Bewältigung dieser Herausforderungen. Ungeeignete Darstellungen können die Kommunikationskosten des Algorithmus unnötig erhöhen und somit seine Skalierbarkeit verringern . Im Folgenden werden Architekturen mit gemeinsamem und verteiltem Speicher betrachtet.
Gemeinsames Gedächtnis
Im Falle eines Shared-Memory- Modells sind die für die Parallelverarbeitung verwendeten Graphdarstellungen dieselben wie im sequenziellen Fall, [ 10 ] da der parallele Lesezugriff auf die Graphdarstellung (z. B. eine Adjazenzliste ) im Shared Memory effizient ist.
Verteilter Speicher
Im verteilten Speichermodell besteht der übliche Ansatz darin, die Knotenmenge des Graphen in Mengen zu partitionieren . Hierbei ist die Anzahl der verfügbaren Verarbeitungselemente (PE). Die Knotenmengenpartitionen werden dann den PEs mit übereinstimmendem Index sowie den entsprechenden Kanten zugeordnet. Jedes PE besitzt eine eigene Subgraph- Repräsentation, wobei Kanten mit einem Endpunkt in einer anderen Partition besondere Beachtung erfordern. Für Standard-Kommunikationsschnittstellen wie MPI muss die ID des PE, dem der andere Endpunkt gehört, identifizierbar sein. Bei Berechnungen in verteilten Graphalgorithmen impliziert die Weitergabe von Informationen entlang dieser Kanten Kommunikation. [ 10 ]


Die Partitionierung des Graphen muss sorgfältig erfolgen – es besteht ein Zielkonflikt zwischen geringer Kommunikation und gleichmäßiger Partitionierung [ 11 ]. Da die Partitionierung eines Graphen jedoch ein NP-schweres Problem darstellt, ist eine Berechnung nicht praktikabel. Stattdessen werden die folgenden Heuristiken verwendet.
1D-Partitionierung: Jeder Prozessor erhält Knoten und die zugehörigen ausgehenden Kanten. Dies kann als zeilen- oder spaltenweise Zerlegung der Adjazenzmatrix verstanden werden. Für Algorithmen, die mit dieser Darstellung arbeiten, ist ein All-to-All-Kommunikationsschritt sowie die Größe des Nachrichtenpuffers erforderlich, da jeder Prozessor potenziell ausgehende Kanten zu jedem anderen Prozessor hat. [ 12 ]


2D-Partitionierung: Jeder Prozessor erhält eine Untermatrix der Adjazenzmatrix. Angenommen, die Prozessoren sind in einem Rechteck angeordnet , wobei und die Anzahl der Verarbeitungselemente in jeder Zeile bzw. Spalte darstellen. Dann erhält jeder Prozessor eine Untermatrix der Adjazenzmatrix der Dimension . Dies lässt sich als Schachbrettmuster in einer Matrix visualisieren. [ 12 ] Daher kann jede Verarbeitungseinheit nur ausgehende Kanten zu Verarbeitungselementen in derselben Zeile und Spalte haben. Dies beschränkt die Anzahl der Kommunikationspartner für jedes Verarbeitungselement auf von möglichen.


Komprimierte Darstellungen
Graphen mit Billionen von Kanten treten im maschinellen Lernen , in der Analyse sozialer Netzwerke und anderen Bereichen auf. Um den I/O- und Speicherbedarf zu reduzieren, wurden komprimierte Graphdarstellungen entwickelt. Allgemeine Techniken wie die Huffman-Codierung sind anwendbar, aber die Adjazenzliste oder Adjazenzmatrix kann auf spezifische Weise verarbeitet werden, um die Effizienz zu steigern. [ 13 ]
Anwendungen von Graphen
Breitensuche und Tiefensuche
Breitensuche (BFS) und Tiefensuche (DFS) sind zwei eng verwandte Verfahren zur Untersuchung aller Knoten einer gegebenen Zusammenhangskomponente . Beide beginnen mit einem beliebigen Knoten, der „ Wurzel “. [ 14 ] Stark zusammenhängende Komponenten lassen sich auch mithilfe von Graphdurchläufen und Algorithmen wie dem Kosaraju-Algorithmus finden , einer modifizierten DFS.
Wegfindung
Der Dijkstra-Algorithmus ist ein Pfadfindungsalgorithmus , der auf positiv gewichteten (d. h. alle Kantengewichte müssen größer oder gleich 0 sein) und/oder gerichteten Graphen angewendet werden kann. Er dient dazu, den kürzesten Pfad zwischen zwei beliebig gewählten Knoten zu finden, was häufig bei Routing-Problemen Anwendung findet.
Siehe auch
- Graphtraversierung für weitere Informationen zu Graph-Walking-Strategien
- Graphdatenbank für die Persistenz von Graphen (Datenstrukturen)
- Graph-Rewriting für regelbasierte Transformationen von Graphen (Graphdatenstrukturen)
- Software zur Diagrammerstellung für Software, Systeme und Systemanbieter zur Diagrammerstellung
- Graph-Neuronales Netzwerk für maschinelles Lernen auf Graphen mit tiefen neuronalen Netzen.
Referenzen
- Siehe z . B. Goodrich & Tamassia (2015) , Abschnitt 13.1.2: Operationen auf Graphen, S. 360. Eine detailliertere Übersicht der Operationen findet sich in Mehlhorn, K .; Näher, S. (1999). „Kapitel 6: Graphen und ihre Datenstrukturen“. LEDA: Eine Plattform für kombinatorisches und geometrisches Rechnen (PDF) . Cambridge University Press, S. 240–282 .
- ^ Cormen et al. (2001) , S. 528–529; Goodrich & Tamassia (2015) , S. 361–362.
- ^ Cormen et al. (2001) , S. 529–530; Goodrich & Tamassia (2015) , S. 363.
- ^ Cormen et al. (2001) , Übung 22.1-7, S. 531.
- ^ Cormen, Thomas H .; Leiserson, Charles E.; Rivest , Ronald L .; Stein, Clifford (2001). „Abschnitt 22.1: Darstellungen von Graphen“. Einführung in Algorithmen (2. Aufl.). MIT Press und McGraw-Hill. S. 527–531 . ISBN 0-262-03293-7Die
- ^ Goodrich, Michael T .; Tamassia, Roberto (2015). „Abschnitt 13.1: Graphterminologie und -darstellungen“. Algorithm Design and Applications . Wiley. S. 355–364 . ISBN 978-1-118-33591-8Die
- ^Cormen, Thomas H.; Leiserson, Charles E.; Rivest, Ronald L.; Stein, Clifford (2009). Introduction to Algorithms (3rd ed.). Massachusetts Institute of Technology. pp. 253–280. ISBN 978-0-262-03384-8.
- ^Bader, David; Meyerhenke, Henning; Sanders, Peter; Wagner, Dorothea (January 2013). Graph Partitioning and Graph Clustering. Contemporary Mathematics. Vol. 588. American Mathematical Society. doi:10.1090/conm/588/11709. ISBN 978-0-8218-9038-7.
- ^Lumsdaine, Andrew; Gregor, Douglas; Hendrickson, Bruce; Berry, Jonathan (March 2007). "Challenges in Parallel Graph Processing". Parallel Processing Letters. 17 (1): 5–20. doi:10.1142/s0129626407002843. ISSN 0129-6264.
- ^ abSanders, Peter; Mehlhorn, Kurt; Dietzfelbinger, Martin; Dementiev, Roman (2019). Sequential and Parallel Algorithms and Data Structures: The Basic Toolbox. Springer International Publishing. ISBN 978-3-030-25208-3.
- ^"Parallel Processing of Graphs"(PDF). Archived from the original(PDF) on 2021-08-25. Retrieved 2020-03-09.
- ^ abBuluç, A.; Madduri, Kamesh (2011). "Applications". Parallel breadth-first search on distributed memory systems. 2011 International Conference for High Performance Computing, Networking, Storage and Analysis. CiteSeerX 10.1.1.767.5248. doi:10.1145/2063384.2063471. ISBN 978-1-4503-0771-0. S2CID 6540738.
- ^Besta, Maciej; Hoefler, Torsten (27 April 2019). "Survey and Taxonomy of Lossless Graph Compression and Space-Efficient Graph Representations". arXiv:1806.01799 [cs.DS].
- ^Purti (July–September 2018). "Graph Traversals and its Applications"(PDF). International Journal of Research and Analytical Reviews. 5 (3): 2.
External links
- Boost Graph Library: a powerful C++ graph library s.a. Boost (C++ libraries)
- Networkx: a Python graph library
- GraphMatcher a java program to align directed/undirected graphs.
- GraphBLAS Eine Spezifikation für eine Bibliothekschnittstelle zur Durchführung von Operationen auf Graphen, mit besonderem Fokus auf dünnbesetzte Graphen.