Beim Signifikanztest unter der Nullhypothese ist der p- Wert [ Anmerkung 1 ] die Wahrscheinlichkeit , ein Testergebnis zu erhalten, das mindestens so extrem ist wie das tatsächlich beobachtete Ergebnis , unter der Annahme, dass die Nullhypothese korrekt ist. [ 2 ] [ 3 ] Ein sehr kleiner p -Wert bedeutet, dass ein solch extremes Ergebnis unter der Nullhypothese sehr unwahrscheinlich wäre . Obwohl die Angabe von p -Werten statistischer Tests in wissenschaftlichen Publikationen vieler quantitativer Disziplinen üblich ist , sind Fehlinterpretationen und Missbrauch von p-Werten weit verbreitet und stellen ein wichtiges Thema in Mathematik und Metawissenschaft dar . [ 4 ] [ 5 ]
Die American Statistical Association (ASA) gab 2016 eine offizielle Erklärung ab, in der sie feststellte, dass „ p -Werte nicht die Wahrscheinlichkeit messen, dass die untersuchte Hypothese wahr ist, oder die Wahrscheinlichkeit, dass die Daten allein durch Zufall entstanden sind“ und dass „ein p -Wert bzw. eine statistische Signifikanz weder die Effektstärke noch die Bedeutung eines Ergebnisses misst“ und „ohne Kontext oder weitere Belege kein ausreichendes Maß für die Evidenz eines Modells oder einer Hypothese darstellt“ [ 6 ] . Eine 2019 von der ASA eingesetzte Arbeitsgruppe veröffentlichte jedoch eine Stellungnahme zur statistischen Signifikanz und Replizierbarkeit, die zu dem Schluss kam: „ p -Werte und Signifikanztests erhöhen, wenn sie korrekt angewendet und interpretiert werden, die Aussagekraft der aus den Daten gezogenen Schlussfolgerungen“ [ 7 ] .
Grundkonzepte
In der Statistik wird jede Vermutung über die unbekannte Wahrscheinlichkeitsverteilung einer Menge von Zufallsvariablen, die die beobachteten Daten einer Studie repräsentieren, als statistische Hypothese bezeichnet . Wenn wir nur eine Hypothese aufstellen und das Ziel des statistischen Tests darin besteht, zu prüfen, ob diese Hypothese haltbar ist, ohne andere spezifische Hypothesen zu untersuchen, dann wird ein solcher Test als Nullhypothesentest bezeichnet .

Da unsere statistische Hypothese definitionsgemäß eine Eigenschaft der Verteilung aussagt, ist die Nullhypothese die Standardhypothese, unter der diese Eigenschaft nicht existiert. Die Nullhypothese besagt typischerweise, dass ein bestimmter Parameter (wie eine Korrelation oder eine Differenz zwischen Mittelwerten) in den untersuchten Populationen null ist. Unsere Hypothese kann die Wahrscheinlichkeitsverteilung präzise festlegen oder lediglich angeben, dass sie zu einer bestimmten Verteilungsklasse gehört. Häufig reduzieren wir die Daten auf eine einzelne numerische Statistik, z. B. , deren Randverteilung eng mit einer zentralen Fragestellung der Studie verknüpft ist.

Der p -Wert wird im Kontext von Nullhypothesentests verwendet, um die statistische Signifikanz eines Ergebnisses zu quantifizieren. Das Ergebnis ist der beobachtete Wert der gewählten Statistik . [ Anmerkung 2 ] Je kleiner der p -Wert ist, desto geringer ist die Wahrscheinlichkeit, dieses Ergebnis zu erhalten, wenn die Nullhypothese wahr wäre. Ein Ergebnis gilt als statistisch signifikant, wenn es die Ablehnung der Nullhypothese erlaubt. Unter sonst gleichen Bedingungen werden kleinere p -Werte als stärkere Evidenz gegen die Nullhypothese gewertet.
Vereinfacht gesagt bedeutet die Ablehnung der Nullhypothese, dass es genügend Beweise dagegen gibt.
Nehmen wir als konkretes Beispiel die Nullhypothese, dass eine bestimmte Kennzahl der Standardnormalverteilung folgt . Die Ablehnung dieser Nullhypothese könnte bedeuten, dass (i) der Mittelwert ungleich null ist, (ii) die Varianz ungleich 1 ist oder (iii) die Kennzahl nicht normalverteilt ist. Unterschiedliche Tests derselben Nullhypothese reagieren unterschiedlich sensitiv auf verschiedene Alternativen. Selbst wenn es gelingt, die Nullhypothese für alle drei Alternativen abzulehnen und wir wissen, dass die Verteilung normal ist und die Varianz 1 beträgt, gibt der Nullhypothesentest keine Auskunft darüber, welche von null verschiedenen Mittelwertwerte nun am plausibelsten sind. Je mehr unabhängige Beobachtungen aus derselben Wahrscheinlichkeitsverteilung vorliegen, desto genauer ist der Test und desto präziser lässt sich der Mittelwert bestimmen und seine Abweichung von null nachweisen. Dies erhöht jedoch auch die Bedeutung der Bewertung der praktischen oder wissenschaftlichen Relevanz dieser Abweichung.

Definition und Auslegung
Definition
Der p -Wert ist die Wahrscheinlichkeit unter der Nullhypothese, eine reelle Teststatistik zu erhalten, die mindestens so extrem ist wie die beobachtete. Betrachtet man eine beobachtete Teststatistik aus einer unbekannten Verteilung , so entspricht der p -Wert der A-priori-Wahrscheinlichkeit, einen Teststatistikwert zu beobachten, der mindestens so „extrem“ ist, als wäre die Nullhypothese wahr. Das heißt:


- für eine einseitige rechtsseitige Teststatistikverteilung.
- für eine einseitige linksseitige Teststatistikverteilung.
- für eine zweiseitige Teststatistikverteilung. Wenn die Verteilung von symmetrisch um Null ist, dann


Interpretationen
Der Fehler, den ein praktizierender Statistiker als den wichtigsten zu vermeidenden einstuft (eine subjektive Einschätzung), wird als Fehler erster Art bezeichnet. Die erste Forderung der mathematischen Theorie besteht darin, Testkriterien abzuleiten, die sicherstellen, dass die Wahrscheinlichkeit, einen Fehler erster Art zu begehen, einem vorgegebenen Wert α entspricht (oder annähernd entspricht oder diesen nicht überschreitet), beispielsweise α = 0,05 oder 0,01 usw. Dieser Wert wird als Signifikanzniveau bezeichnet.
— Jerzy Neyman, „Die Entstehung der mathematischen Statistik“ [ 8 ]
Bei einem Signifikanztest wird die Nullhypothese verworfen, wenn der p -Wert kleiner als ein vordefinierter Schwellenwert ist , das sogenannte Alpha-Niveau oder Signifikanzniveau . Dieses wird nicht aus den Daten abgeleitet, sondern vom Forscher vor der Datenanalyse festgelegt. Üblicherweise wird es auf 0,05 gesetzt, obwohl auch niedrigere Alpha-Niveaus verwendet werden. Der Wert von 0,05 (entspricht einer Wahrscheinlichkeit von 1/20) wurde ursprünglich 1925 von Ronald Fisher in seinem bekannten Buch „ Statistical Methods for Research Workers “ vorgeschlagen . [ 9 ]

Unterschiedliche p -Werte, die auf unabhängigen Datensätzen basieren, können kombiniert werden, beispielsweise mithilfe des Fisher-Kombinationstests .
Verteilung
Der p -Wert ist eine Funktion der gewählten Teststatistik und somit eine Zufallsvariable . Legt die Nullhypothese die Wahrscheinlichkeitsverteilung von λ präzise fest (z. B. λ = 0 , wobei λ der einzige Parameter ist) und ist diese Verteilung stetig, so ist der p -Wert bei Gültigkeit der Nullhypothese gleichverteilt zwischen 0 und 1. Unabhängig von der Gültigkeit der Nullhypothese ist der p -Wert jedoch nicht festgelegt; wird derselbe Test mit neuen Daten unabhängig wiederholt, erhält man typischerweise in jeder Iteration einen anderen p -Wert.


Üblicherweise wird nur ein einzelner p -Wert zu einer Hypothese beobachtet. Dieser p -Wert wird dann im Rahmen eines Signifikanztests interpretiert, ohne dass die zugrunde liegende Verteilung ermittelt wird. Stehen mehrere p -Werte zur Verfügung (z. B. bei der Betrachtung mehrerer Studien zum selben Thema), wird die Verteilung der signifikanten p -Werte mitunter als p -Kurve bezeichnet . [ 10 ] Mithilfe einer p -Kurve lässt sich die Zuverlässigkeit wissenschaftlicher Literatur beurteilen, beispielsweise durch Aufdecken von Publikationsbias oder p -Hacking . [ 10 ] [ 11 ]
Verteilung für zusammengesetzte Hypothese
Bei parametrischen Hypothesentests bezeichnet eine einfache oder Punkthypothese eine Hypothese, bei der der Parameterwert als einzelne Zahl angenommen wird. Im Gegensatz dazu wird der Parameterwert bei einer zusammengesetzten Hypothese durch eine Zahlenmenge angegeben. Ist die Nullhypothese zusammengesetzt (oder die Verteilung der Teststatistik diskret), so ist die Wahrscheinlichkeit, einen p -Wert kleiner oder gleich einer Zahl zwischen 0 und 1 zu erhalten, auch dann kleiner oder gleich dieser Zahl, wenn die Nullhypothese wahr ist. Anders ausgedrückt: Sehr kleine Werte sind relativ unwahrscheinlich, wenn die Nullhypothese wahr ist, und ein Signifikanztest auf dem Niveau α wird durch Verwerfen der Nullhypothese erreicht, wenn der p - Wert kleiner oder gleich α ist . [ 12 ] [ 13 ]
Wenn man beispielsweise die Nullhypothese testet, dass eine Verteilung normalverteilt ist mit einem Mittelwert kleiner oder gleich null, gegen die Alternativhypothese, dass der Mittelwert größer als null ist (bei bekannter Varianz), legt die Nullhypothese nicht die genaue Wahrscheinlichkeitsverteilung der entsprechenden Teststatistik fest. In diesem Beispiel wäre das die Z -Statistik des einseitigen Einstichproben -Z- Tests. Für jeden möglichen Wert des theoretischen Mittelwerts hat die Z -Teststatistik eine andere Wahrscheinlichkeitsverteilung. Unter diesen Umständen wird der p -Wert durch den ungünstigsten Fall der Nullhypothese definiert, der typischerweise an der Grenze zwischen Null- und Alternativhypothese liegt. Diese Definition gewährleistet die Komplementarität von p-Werten und Alpha-Niveaus: Man verwirft die Nullhypothese nur, wenn der p -Wert kleiner oder gleich ist , und der Hypothesentest hat tatsächlich eine maximale Fehlerwahrscheinlichkeit 1. Art von 0,05 .


Verwendung
Der p -Wert findet breite Anwendung in statistischen Hypothesentests , insbesondere bei Signifikanztests der Nullhypothese. Bei dieser Methode wählt man vor Beginn der Studie ein Modell (die Nullhypothese ) und das Signifikanzniveau α (meist 0,05). Ist der p -Wert nach der Datenanalyse kleiner als α , bedeutet dies, dass die beobachteten Daten ausreichend im Widerspruch zur Nullhypothese stehen , um diese zu verwerfen. Dies beweist jedoch nicht, dass die Nullhypothese falsch ist. Der p -Wert selbst liefert keine Wahrscheinlichkeiten für Hypothesen. Er dient vielmehr als Hilfsmittel, um zu entscheiden, ob die Nullhypothese verworfen wird. [ 14 ]
Missbrauch
Laut ASA besteht weitgehend Einigkeit darüber, dass p -Werte häufig missbraucht und falsch interpretiert werden. [ 3 ] Besonders kritisiert wird die Praxis, die Alternativhypothese bei einem p -Wert von unter 0,05 ohne weitere Belege anzunehmen. Obwohl p -Werte hilfreich sind, um die Kompatibilität der Daten mit einem bestimmten statistischen Modell zu beurteilen, müssen auch Kontextfaktoren berücksichtigt werden, wie beispielsweise „das Studiendesign, die Qualität der Messungen, externe Belege für das untersuchte Phänomen und die Gültigkeit der Annahmen, die der Datenanalyse zugrunde liegen“. [ 3 ] Ein weiteres Problem ist, dass der p -Wert oft fälschlicherweise als Wahrscheinlichkeit für die Richtigkeit der Nullhypothese verstanden wird. [ 3 ] [ 15 ] p -Werte und Signifikanztests sagen zudem nichts darüber aus, ob sich Schlussfolgerungen von einer Stichprobe auf eine Population ziehen lassen.
Einige Statistiker haben vorgeschlagen, p-Werte aufzugeben und sich stattdessen stärker auf andere inferenzstatistische Verfahren zu konzentrieren [3], wie beispielsweise Konfidenzintervalle [ 16 , 17 ] , Likelihood -Ratios [18, 19 ] oder Bayes - Faktoren [ 20 , 21 , 22]. Die Umsetzbarkeit dieser Alternativen wird jedoch kontrovers diskutiert [23, 24 ] . Gleichzeitig wird die Verwendung von p - Werten als nützliches statistisches Werkzeug verteidigt , das nicht aufgegeben werden sollte [ 25 , 26, 27, 28]. Andere wiederum haben vorgeschlagen , feste Signifikanzschwellen abzuschaffen und p - Werte als kontinuierliche Indizes für die Stärke der Evidenz gegen die Nullhypothese zu interpretieren [ 29 , 30 ] . Diese Vorschläge wurden jedoch ihrerseits kritisiert . [ 31 ] Andere schlugen jedoch vor, neben den p -Werten auch die A-priori-Wahrscheinlichkeit eines tatsächlichen Effekts anzugeben , die erforderlich wäre, um ein falsch-positives Risiko (d. h. die Wahrscheinlichkeit, dass kein tatsächlicher Effekt vorliegt) unterhalb eines vorab festgelegten Schwellenwerts (z. B. 5 %) zu erhalten. [ 32 ]
Dennoch wurde 2019 von der ASA eine Arbeitsgruppe einberufen, um den Einsatz statistischer Methoden in wissenschaftlichen Studien, insbesondere Hypothesentests und p -Werte, sowie deren Zusammenhang mit der Replizierbarkeit zu untersuchen. [ 7 ] Darin heißt es: „Verschiedene Unsicherheitsmaße können sich ergänzen; kein einzelnes Maß ist für alle Zwecke geeignet.“ Der p -Wert wird als eines dieser Maße genannt. Weiterhin wird betont, dass p -Werte sowohl einzeln als auch im Vergleich zu einem Schwellenwert wertvolle Informationen liefern können. Generell wird hervorgehoben, dass „ p -Werte und Signifikanztests, wenn sie korrekt angewendet und interpretiert werden, die Aussagekraft der aus den Daten gezogenen Schlussfolgerungen erhöhen“. Diese Ansicht wurde durch einen Kommentar in Nature Human Behaviour bekräftigt , der als Reaktion auf Empfehlungen zur Neudefinition der statistischen Signifikanz auf p ≤ 0,005 vorschlug, dass „Forschende alle Entscheidungen, die sie bei der Studienplanung treffen, einschließlich des Alpha-Niveaus, transparent darlegen und begründen sollten“. [ 33 ]
Berechnung
Üblicherweise handelt es sich um eine Teststatistik . Eine Teststatistik ist das Ergebnis einer Skalarfunktion , die alle Beobachtungen berücksichtigt. Diese Statistik liefert einen einzelnen Wert, wie beispielsweise eine t- Statistik oder eine F- Statistik . Daher folgt die Teststatistik einer Verteilung, die durch die Funktion, mit der sie definiert wurde, und die Verteilung der Eingangsdaten bestimmt wird.
Für den wichtigen Fall, dass die Daten als Zufallsstichprobe aus einer Normalverteilung angenommen werden, wurden je nach Art der Teststatistik und den zu prüfenden Hypothesen über deren Verteilung verschiedene Nullhypothesentests entwickelt. Beispiele hierfür sind der z -Test für Hypothesen über den Mittelwert einer Normalverteilung mit bekannter Varianz, der t -Test basierend auf der t -Verteilung einer geeigneten Statistik für Hypothesen über den Mittelwert einer Normalverteilung mit unbekannter Varianz und der F -Test basierend auf der F -Verteilung einer weiteren Statistik für Hypothesen über die Varianz. Für Daten anderer Art, beispielsweise kategoriale (diskrete) Daten, können Teststatistiken konstruiert werden, deren Nullhypothesenverteilung auf Normalapproximationen geeigneter Statistiken basiert, die durch Anwendung des zentralen Grenzwertsatzes für große Stichproben gewonnen werden, wie im Fall des Pearson-Chi-Quadrat-Tests .
Die Berechnung eines p -Wertes erfordert somit eine Nullhypothese, eine Teststatistik (sowie die Entscheidung, ob ein einseitiger oder zweiseitiger Test durchgeführt wird ) und Daten. Obwohl die Berechnung der Teststatistik anhand gegebener Daten einfach sein kann, stellt die Berechnung der Stichprobenverteilung unter der Nullhypothese und anschließend ihrer kumulativen Verteilungsfunktion (CDF) oft eine schwierige Aufgabe dar. Heutzutage erfolgt diese Berechnung mithilfe von Statistiksoftware, häufig über numerische Methoden (anstatt exakter Formeln). Im frühen und mittleren 20. Jahrhundert wurde dies jedoch mithilfe von Wertetabellen durchgeführt, aus denen die p -Werte interpoliert oder extrapoliert wurden. Anstatt eine p -Wert-Tabelle zu verwenden, invertierte Fisher die CDF und veröffentlichte eine Liste von Werten der Teststatistik für gegebene feste p- Werte; dies entspricht der Berechnung der Quantilfunktion (inverse CDF).
Beispiel
Test der Fairness einer Münze
Als Beispiel für einen statistischen Test wird ein Experiment durchgeführt, um festzustellen, ob ein Münzwurf fair ist (gleiche Wahrscheinlichkeit für Kopf oder Zahl) oder unfair verzerrt (ein Ergebnis ist wahrscheinlicher als das andere).
Angenommen, die experimentellen Ergebnisse zeigen, dass die Münze bei 14 von 20 Würfen auf Kopf landet. Die vollständigen Daten wären eine Folge von zwanzig Malen des Symbols „K“ oder „Z“. Die relevante Statistik wäre die Gesamtzahl der Würfe mit „Kopf“. Die Nullhypothese besagt, dass die Münze fair ist und die Würfe unabhängig voneinander sind. Bei einem rechtsseitigen Test, der angewendet wird, wenn man die Möglichkeit einer möglichen Tendenz der Münze zu „Kopf“ untersucht, entspricht der p -Wert der Wahrscheinlichkeit, dass eine faire Münze bei mindestens 14 von 20 Würfen auf „Kopf“ landet. Diese Wahrscheinlichkeit lässt sich mithilfe der Binomialkoeffizienten berechnen .

Diese Wahrscheinlichkeit ist der p -Wert, wobei nur extreme Ergebnisse zugunsten von Kopf berücksichtigt werden. Dies wird als einseitiger Test bezeichnet . Man könnte jedoch an Abweichungen in beide Richtungen interessiert sein, die entweder Kopf oder Zahl begünstigen. In diesem Fall kann der zweiseitige p -Wert berechnet werden, der Abweichungen zugunsten von Kopf oder Zahl berücksichtigt. Da die Binomialverteilung für eine faire Münze symmetrisch ist, ist der zweiseitige p -Wert einfach das Doppelte des oben berechneten einseitigen p- Werts: Der zweiseitige p- Wert beträgt 0,115.
Im obigen Beispiel:
- Nullhypothese ( H 0 ): Die Münze ist fair, mit Pr(Kopf) = 0,5.
- Teststatistik: Anzahl der Würfe mit Kopf.
- Alpha-Niveau (festgelegte Signifikanzschwelle): 0,05.
- Beobachtung O : 14 Mal Kopf bei 20 Würfen.
- Zweiseitiger p -Wert der Beobachtung O gegeben H 0 = 2 × min(Pr(Anzahl Kopf ≥ 14 Kopf), Pr(Anzahl Kopf ≤ 14 Kopf)) = 2 × min(0,058, 0,978) = 2 × 0,058 = 0,115.
Die Wahrscheinlichkeit P(Anzahl Kopf ≤ 14 Kopf) = 1 − P(Anzahl Kopf ≥ 14 Kopf) + P(Anzahl Kopf = 14) = 1 − 0,058 + 0,036 = 0,978. Aufgrund der Symmetrie dieser Binomialverteilung ist die Berechnung der kleineren der beiden Wahrscheinlichkeiten jedoch überflüssig. Der berechnete p -Wert ist größer als 0,05, was bedeutet, dass die Daten im Bereich dessen liegen, was in 95 % der Fälle zu erwarten wäre, wenn die Münze fair wäre. Daher wird die Nullhypothese auf dem 5%-Niveau nicht verworfen.
Hätte man jedoch einen weiteren Kopf erzielt, wäre der resultierende p -Wert (zweiseitig) 0,0414 (4,14 %) gewesen, in welchem Fall die Nullhypothese auf dem 0,05-Niveau verworfen worden wäre.
Optionaler Stopp
Der Unterschied zwischen den beiden Bedeutungen von „extrem“ wird deutlich, wenn wir einen sequenziellen Hypothesentest oder einen optionalen Stopp zur Gewährleistung der Fairness betrachten. Im Allgemeinen verändert ein optionaler Stopp die Berechnung des p-Werts. [ 34 ] [ 35 ] Angenommen, wir gestalten das Experiment wie folgt:
- Wirf die Münze zweimal. Wenn beide Male Kopf oder Zahl erscheint, beende das Experiment.
- Ansonsten wirf die Münze noch 4 Mal.
Dieses Experiment hat 7 mögliche Ergebnisse: 2x Kopf, 2x Zahl, 5x Kopf, 1x Zahl, ..., 1x Kopf, 5x Zahl. Wir berechnen nun den p -Wert für das Ergebnis „3x Kopf, 3x Zahl“.
Wenn wir die Teststatistik # verwenden , dann ist unter der Nullhypothese (d. h. # ) der zweiseitige p -Wert genau gleich 1, und sowohl der einseitige linksseitige p-Wert als auch der einseitige rechtsseitige p -Wert sind genau gleich .


Wenn wir jedes Ergebnis, dessen Wahrscheinlichkeit gleich oder geringer als die von „3x Kopf, 3x Zahl“ ist, als „mindestens genauso extrem“ betrachten, dann ist der p -Wert genau

Angenommen, wir hätten jedoch geplant, die Münze einfach 6 Mal zu werfen, egal was passiert, dann würde die zweite Definition des p -Werts bedeuten, dass der p -Wert von „3 Kopf 3 Zahl“ genau 1 beträgt.
Die Definition des p -Werts als „mindestens ebenso extrem“ ist daher stark kontextabhängig und hängt davon ab, was der Experimentator geplant hatte , selbst in Situationen, die nicht eintraten.
Geschichte
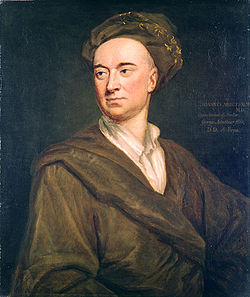


P-value computations date back to the 1700s, where they were computed for the human sex ratio at birth, and used to compute statistical significance compared to the null hypothesis of equal probability of male and female births.[36]John Arbuthnot studied this question in 1710,[37][38][39][40] and examined birth records in London for each of the 82 years from 1629 to 1710. In every year, the number of males born in London exceeded the number of females. Considering more male or more female births as equally likely, the probability of the observed outcome is 1/282, or about 1 in 4,836,000,000,000,000,000,000,000; in modern terms, the p-value. This is vanishingly small, leading Arbuthnot to conclude that this was not due to chance, but to divine providence: "From whence it follows, that it is Art, not Chance, that governs." In modern terms, he rejected the null hypothesis of equally likely male and female births at the p = 1/282 significance level. This and other work by Arbuthnot is credited as "… the first use of significance tests …"[41] the first example of reasoning about statistical significance,[42] and "… perhaps the first published report of a nonparametric test …",[38] specifically the sign test; see details at Sign test § History.
The same question was later addressed by Pierre-Simon Laplace, who instead used a parametric test, modeling the number of male births with a binomial distribution:[43]
In the 1770s Laplace considered the statistics of almost half a million births. The statistics showed an excess of boys compared to girls. He concluded by calculation of a p-value that the excess was a real, but unexplained, effect.
Der p -Wert wurde erstmals formal von Karl Pearson in seinem Pearson-Chi-Quadrat-Test [ 44 ] unter Verwendung der Chi-Quadrat-Verteilung eingeführt und mit einem großen P bezeichnet. [ 44 ] Die p -Werte für die Chi-Quadrat-Verteilung (für verschiedene Werte von χ² und Freiheitsgraden), die nun mit P bezeichnet werden, wurden in ( Elderton 1902 ) berechnet und in ( Pearson 1914 , S. xxxi–xxxiii, 26–28, Tabelle XII ) gesammelt.
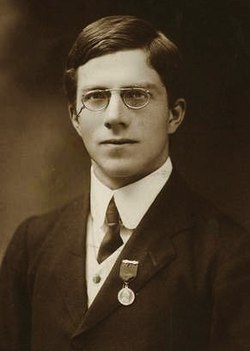
Ronald Fisher formalisierte und popularisierte die Verwendung des p -Werts in der Statistik [ 45 , 46 ], wobei dieser eine zentrale Rolle in seinem Ansatz zu diesem Thema spielte [ 47 ] . In seinem einflussreichen Buch „Statistical Methods for Research Workers “ (1925) schlug Fisher das Signifikanzniveau p = 0,05 vor, was einer Wahrscheinlichkeit von 1 zu 20 entspricht, diesen Wert zufällig zu überschreiten . Er wandte dies auf eine Normalverteilung (als zweiseitigen Test) an und leitete daraus die Zwei-Standardabweichungen-Regel (bei einer Normalverteilung) für statistische Signifikanz ab (siehe 68-95-99,7-Regel ) [ 48 , Anmerkung 3 , 49 ] .
Anschließend erstellte er eine Wertetabelle, ähnlich der von Elderton, wobei er jedoch die Rollen von χ² und p umkehrte . Anstatt p für verschiedene Werte von χ² (und Freiheitsgrade n) zu berechnen , ermittelte er χ² - Werte , die bestimmte p -Werte ergaben, nämlich 0,99, 0,98, 0,95, 0,90, 0,80, 0,70, 0,50, 0,30, 0,20, 0,10, 0,05, 0,02 und 0,01. [ 50 ] Dadurch konnten die berechneten χ²-Werte mit Schwellenwerten verglichen werden, und es wurde die Verwendung von p -Werten (insbesondere 0,05, 0,02 und 0,01) als Schwellenwerte anstelle der Berechnung und Angabe der p -Werte selbst gefördert. Die gleichen Tabellen wurden dann in ( Fisher & Yates 1938 ) zusammengestellt, was den Ansatz festigte. [ 49 ]
Als Beispiel für die Anwendung von p -Werten bei der Planung und Interpretation von Experimenten präsentierte Fisher in seinem nachfolgenden Buch „The Design of Experiments “ (1935) das Experiment mit der Teeverkostung durch eine Frau [ 51 ] , das als archetypisches Beispiel für den p -Wert gilt.
Um die Behauptung einer Frau ( Muriel Bristol ) zu überprüfen, sie könne anhand des Geschmacks unterscheiden, wie Tee zubereitet wird (erst die Milch, dann der Tee, oder umgekehrt), wurden ihr nacheinander acht Tassen präsentiert: vier auf die eine, vier auf die andere Art zubereitet. Sie sollte die Zubereitung jeder Tasse bestimmen (wobei sie wusste, dass es jeweils vier Tassen gab). Die Nullhypothese lautete, dass sie keine besondere Fähigkeit besitze. Der Test war der Fisher-Exakt-Test , und der p -Wert war so hoch, dass Fisher die Nullhypothese verwerfen würde (er hielt es für höchst unwahrscheinlich, dass das Ergebnis zufällig entstanden sei), wenn alle Tassen korrekt klassifiziert würden. (Im tatsächlichen Experiment klassifizierte Bristol alle acht Tassen korrekt.)

Fisher bekräftigte den Schwellenwert p = 0,05 und erläuterte dessen Begründung wie folgt: [ 52 ]
Es ist üblich und zweckmäßig, dass Experimentatoren 5 Prozent als Standard-Signifikanzniveau annehmen, in dem Sinne, dass sie bereit sind, alle Ergebnisse zu ignorieren, die diesen Standard nicht erreichen, und dadurch den größten Teil der Schwankungen, die durch Zufallsursachen in ihre experimentellen Ergebnisse eingebracht wurden, aus der weiteren Diskussion auszuschließen.
Er wendet diesen Schwellenwert auch auf die Versuchsplanung an und merkt an, dass bei nur sechs präsentierten Bechern (je drei von jeder Sorte) eine perfekte Klassifizierung lediglich einen p -Wert ergeben hätte, der dieses Signifikanzniveau nicht erreicht hätte. [ 52 ] Fisher betonte zudem die Interpretation des p-Werts als den langfristigen Anteil der Werte, die mindestens so extrem sind wie die Daten, unter der Annahme, dass die Nullhypothese zutrifft.

In späteren Ausgaben stellte Fisher die Verwendung des p -Werts für statistische Schlussfolgerungen in den Naturwissenschaften explizit dem Neyman-Pearson-Verfahren gegenüber, das er als „Akzeptanzverfahren“ bezeichnet. [ 53 ] Fisher betont, dass feste Signifikanzniveaus wie 5 %, 2 % und 1 % zwar praktisch sind, aber auch der exakte p -Wert verwendet werden kann und die Beweiskraft durch weitere Experimente angepasst werden kann und wird. Im Gegensatz dazu erfordern Entscheidungsverfahren eine eindeutige Entscheidung, die zu einer irreversiblen Handlung führt, und basieren auf Fehlerkosten, die seiner Ansicht nach in der wissenschaftlichen Forschung nicht anwendbar sind.
Verwandte Indizes
Der E-Wert kann zwei Bedeutungen haben, die beide mit dem p-Wert verwandt sind und bei multiplen Tests eine Rolle spielen . Erstens stellt er eine generische, robustere Alternative zum p-Wert dar , die die optionale Fortsetzung von Experimenten berücksichtigt . Zweitens wird er auch als Abkürzung für „Erwartungswert“ verwendet. Dieser gibt an, wie oft man erwartet , eine Teststatistik zu erhalten, die mindestens so extrem ist wie die tatsächlich beobachtete, wenn man die Nullhypothese als wahr annimmt. [ 54 ] Der Erwartungswert ist das Produkt aus der Anzahl der Tests und dem p -Wert.
Der q -Wert ist das Analogon zum p -Wert in Bezug auf die Falsch-Positiv-Rate . [ 55 ] Er wird bei multiplen Hypothesentests verwendet , um die statistische Power aufrechtzuerhalten und gleichzeitig die Falsch-Positiv-Rate zu minimieren . [ 56 ]
Die Wahrscheinlichkeit der Richtung ( pd ) ist das Bayes'sche numerische Äquivalent des p -Werts. [ 57 ] Sie entspricht dem Anteil der A- posteriori-Verteilung , der das Vorzeichen des Medians aufweist, typischerweise zwischen 50 % und 100 %, und repräsentiert die Sicherheit, mit der ein Effekt positiv oder negativ ist.
p-Werte der zweiten Generation erweitern das Konzept der p-Werte, indem sie extrem kleine, praktisch irrelevante Effektstärken nicht als signifikant betrachten. [ 58 ]
Der S-Wert, auch Überraschungswert genannt, ist als logarithmische Transformation des p-Werts definiert: S-Wert = -log₂ ( p-Wert). Die Transformation in S-Werte soll die Interpretation von p-Werten erleichtern, indem eine intuitivere logarithmische Skala verwendet wird, die angibt, wie „überrascht“ man von einem Ergebnis ist. [ 59 ] [ 60 ] [ 61 ]
Siehe auch
- Student-t-Test
- Bonferroni-Korrektur
- Counternull
- Fishers Methode zur Kombination von p -Werten
- Verallgemeinerter p -Wert
- Harmonischer Mittelwert p -Wert
- Holm-Bonferroni-Methode
- Problem der Mehrfachvergleiche
- p -rep
- p- Wert-Trugschluss
Anmerkungen
- ^ Die Schreibweise (Kursivschrift, Großschreibung, Bindestriche) des Begriffs variiert. Beispielsweise verwendet der AMA-Stil „ P- Wert“, der APA-Stil „ p- Wert“ und die American Statistical Association „ p -Wert“. In allen Fällen steht das „p“ für Wahrscheinlichkeit . [ 1 ]
- Die statistische Signifikanz eines Ergebnisses bedeutet nicht zwangsläufig, dass dieses Ergebnis auch in der Praxis relevant ist. Beispielsweise kann ein Medikament zwar eine statistisch signifikante Wirkung haben, diese ist jedoch zu gering, um von Interesse zu sein .
- ^ Genauer gesagt entspricht p = 0,05 etwa 1,96 Standardabweichungen bei einer Normalverteilung (zweiseitiger Test), und 2 Standardabweichungen entsprechen einer Wahrscheinlichkeit von etwa 1 zu 22, dass dieser Wert zufällig überschritten wird, oder p ≈ 0,045; Fisher weist auf diese Näherungen hin.
Referenzen
- ^ „ASA House Style“ (PDF) . Amstat News . Amerikanische Statistische Vereinigung.
- ^ Aschwanden C (24.11.2015). „Nicht einmal Wissenschaftler können p-Werte einfach erklären“ . FiveThirtyEight . Archiviert vom Original am 25. September 2019. Abgerufen am 11. Oktober 2019 .
- ^ a b c d e Wasserstein RL, Lazar NA (7. März 2016). „Die Stellungnahme der ASA zu p-Werten: Kontext, Prozess und Zweck“ . The American Statistician . 70 (2): 129–133 . doi : 10.1080/00031305.2016.1154108 .
- ^ Hubbard R, Lindsay RM (2008). „Warum p- Werte kein nützliches Maß für die Aussagekraft statistischer Signifikanztests sind“. Theory & Psychology . 18 (1): 69–88 . doi : 10.1177/0959354307086923 . S2CID 143487211 .
- ^ Munafò MR , Nosek BA, Bishop DV, Button KS, Chambers CD, du Sert NP et al. (Januar 2017). „ Ein Manifest für reproduzierbare Wissenschaft“ . Nature Human Behaviour . 1 (1) 0021. doi : 10.1038/s41562-016-0021 . PMC 7610724. PMID 33954258. S2CID 6326747 .
- ^ Wasserstein, Ronald L.; Lazar, Nicole A. (2016-04-02). „Die ASA-Stellungnahme zu p-Werten: Kontext, Prozess und Zweck“ . The American Statistician . 70 (2): 129–133 . doi : 10.1080/00031305.2016.1154108 . ISSN 0003-1305 . S2CID 124084622 .
- ^ a b Benjamini, Yoav; De Veaux, Richard D.; Efron, Bradley; Evans, Scott; Glickman, Mark; Graubard, Barry I.; He, Xuming; Meng, Xiao-Li; Reid, Nancy M.; Stigler, Stephen M.; Vardeman, Stephen B.; Wikle, Christopher K.; Wright, Tommy; Young, Linda J.; Kafadar, Karen (2021-10-02). „Statement der ASA President's Task Force on Statistical Significance and Replicability“ . Chance . 34 (4). Informa UK Limited: 10–11 . doi : 10.1080/09332480.2021.2003631 . ISSN 0933-2480 .
- ^ Neyman, Jerzy (1976). „Die Entstehung der mathematischen Statistik: Ein historischer Abriss mit besonderem Bezug auf die Vereinigten Staaten“. In: Owen, D. B. (Hrsg.). Zur Geschichte der Statistik und Wahrscheinlichkeitstheorie . Lehrbücher und Monographien. New York: Marcel Dekker Inc., S. 161.
- ^ Fisher, R. A. (1992), „Statistical Methods for Research Workers“, in: Kotz, Samuel; Johnson, Norman L. (Hrsg.), Breakthroughs in Statistics: Methodology and Distribution , Springer Series in Statistics, New York, NY: Springer, S. 66–70 , doi : 10.1007/978-1-4612-4380-9_6 , ISBN 978-1-4612-4380-9
- ^ a b Head ML, Holman L, Lanfear R, Kahn AT, Jennions MD (März 2015). „Ausmaß und Folgen des P-Hackings in der Wissenschaft“ . PLOS Biology . 13 (3) e1002106. doi : 10.1371/journal.pbio.1002106 . PMC 4359000. PMID 25768323 .
- ^ Simonsohn U, Nelson LD, Simmons JP (November 2014). „ p -Kurve und Effektstärke: Korrektur des Publikationsbias unter Verwendung ausschließlich signifikanter Ergebnisse“. Perspectives on Psychological Science . 9 (6): 666–681 . doi : 10.1177/1745691614553988 . PMID 26186117. S2CID 39975518 .
- ^ Bhattacharya B, Habtzghi D (2002). „Median des p-Werts unter der Alternativhypothese“. The American Statistician . 56 (3): 202–6 . doi : 10.1198/000313002146 . S2CID 33812107 .
- ^ Hung HM, O'Neill RT, Bauer P, Köhne K (März 1997). „Das Verhalten des p-Werts, wenn die Alternativhypothese wahr ist“ . Biometrics ( Eingereichtes Manuskript). 53 (1): 11–22 . doi : 10.2307/2533093 . JSTOR 2533093. PMID 9147587 .
- ^ Nuzzo R (Februar 2014). „Wissenschaftliche Methode: Statistische Fehler“ . Nature . 506 (7487): 150–152 . Bibcode : 2014Natur.506..150N . doi : 10.1038/506150a . hdl : 11573/685222 . PMID 24522584 .
- ^ Colquhoun D (November 2014). „Eine Untersuchung der Falsch-Entdeckungsrate und der Fehlinterpretation von p-Werten“ . Royal Society Open Science . 1 (3) 140216. arXiv : 1407.5296 . Bibcode : 2014RSOS....140216C . doi : 10.1098 / rsos.140216 . PMC 4448847. PMID 26064558 .
- ^ Lee DK (Dezember 2016). „ Alternativen zum p-Wert: Konfidenzintervall und Effektstärke“ . Korean Journal of Anesthesiology . 69 (6): 555–562 . doi : 10.4097/kjae.2016.69.6.555 . PMC 5133225. PMID 27924194 .
- ^ Ranstam J (August 2012). „Warum die p-Wert-Kultur schlecht ist und Konfidenzintervalle eine bessere Alternative darstellen“ . Osteoarthritis and Cartilage . 20 (8): 805–808 . doi : 10.1016/j.joca.2012.04.001 . PMID 22503814 .
- ^ Perneger TV (Mai 2001). „Die Evidenz prüfen. Likelihood-Ratios als Alternative zu p-Werten“ . BMJ . 322 ( 7295): 1184–1185 . doi : 10.1136/bmj.322.7295.1184 . PMC 1120301. PMID 11379590 .
- ^ Royall R (2004). „Das Likelihood-Paradigma für statistische Evidenz“. In: The Nature of Scientific Evidence . S. 119–152 . doi : 10.7208/chicago/9780226789583.003.0005 . ISBN 978-0-226-78957-6Die
- ^ Schimmack U (30. April 2015). „Ersetzen von p-Werten durch Bayes-Faktoren: Ein Wundermittel gegen die Replizierbarkeitskrise in der Psychologie“ . Replicability-Index . Abgerufen am 7. März 2017 .
- ^ Marden JI (Dezember 2000). „Hypothesentests: Von p-Werten zu Bayes-Faktoren“. Journal of the American Statistical Association . 95 (452): 1316–1320 . doi : 10.2307/2669779 . JSTOR 2669779 .
- ^ Stern HS (16. Februar 2016). „Ein Test, wie er auch genannt werden mag: P-Werte, Bayes-Faktoren und statistische Inferenz“ . Multivariate Behavioral Research . 51 (1): 23–29 . doi : 10.1080/00273171.2015.1099032 . PMC 4809350. PMID 26881954 .
- ^ Murtaugh PA (März 2014). „Zur Verteidigung von P-Werten“ . Ecology . 95 (3): 611–617 . Bibcode : 2014Ecol...95..611M . doi : 10.1890/13-0590.1 . PMID 24804441 .
- ^ Aschwanden C (7. März 2016). „Statistiker sind sich in einem Punkt einig: Es ist an der Zeit, den Missbrauch von p-Werten zu beenden“ . FiveThirtyEight . Archiviert vom Original am 8. März 2016.
- ^ Abelson, Robert P. (Januar 1997). „Über die überraschende Langlebigkeit gepeitschter Pferde: Warum ein Signifikanztest sinnvoll ist“. Psychological Science . 8 (1): 12–15 . doi : 10.1111/j.1467-9280.1997.tb00536.x .
- ^ Chow, Siu L. (April 1998). „Zusammenfassung der statistischen Signifikanz: Begründung, Gültigkeit und Nutzen“. Behavioral and Brain Sciences . 21 (2): 169–194 . doi : 10.1017/S0140525X98001162 .
- ^ Lakens, Daniël (Mai 2021). „Die praktische Alternative zum p-Wert ist der korrekt verwendete p-Wert“. Perspectives on Psychological Science . 16 (3): 639–648 . doi : 10.1177/1745691620958012 .
- ^ Nickerson, Raymond S. (2000). „Nullhypothesen-Signifikanztests: Ein Überblick über eine alte und anhaltende Kontroverse“. Psychological Methods . 5 (2): 241–301 . doi : 10.1037//1082-989X.5.2.241 .
- ^ Amrhein V , Korner-Nievergelt F, Roth T (2017). „Die Erde ist flach ( p > 0,05): Signifikanzschwellen und die Krise nicht replizierbarer Forschung“ . PeerJ . 5 e3544 . doi : 10.7717/peerj.3544 . PMC 5502092. PMID 28698825 .
- ^ Amrhein V , Greenland S (Januar 2018). „Statistische Signifikanz entfernen, statt sie neu zu definieren“. Nature Human Behaviour . 2 (1): 4. doi : 10.1038/s41562-017-0224-0 . PMID 30980046. S2CID 46814177 .
- ^ Lakens, Daniël (April 2022). „Warum p-Werte keine Evidenzmaße sind“. Trends in Ecology & Evolution . 37 (4): 289–290 . doi : 10.1016/j.tree.2021.12.006 .
- ^ Colquhoun D (Dezember 2017). „Die Reproduzierbarkeit von Forschungsergebnissen und die Fehlinterpretation von p -Werten“ . Royal Society Open Science . 4 (12) 171085. Bibcode : 2017RSOS....471085C . doi : 10.1098 / rsos.171085 . PMC 5750014. PMID 29308247 .
- ^ Lakens, D., Adolfi, FG, Albers, CJ et al. Justify your alpha. Nat Hum Behav 2, 168–171 (2018). https://doi.org/10.1038/s41562-018-0311-x
- ^ Goodman, Steven (1. Juli 2008). „Ein Dutzend Irrtümer: Zwölf Fehlvorstellungen zum p-Wert“ . Seminars in Hematology . Interpretation of Quantitative Research. 45 (3): 135–140 . doi : 10.1053/j.seminhematol.2008.04.003 . ISSN 0037-1963 . PMID 18582619 .
- ^ Wagenmakers, Eric-Jan (Oktober 2007). „Eine praktische Lösung für die weit verbreiteten Probleme der p-Werte“ . Psychonomic Bulletin & Review . 14 (5): 779–804 . doi : 10.3758/BF03194105 . ISSN 1069-9384 . PMID 18087943 .
- ^ Brian E , Jaisson M (2007). „Physiko-Theologie und Mathematik (1710–1794)“. Der Rückgang des menschlichen Geschlechterverhältnisses bei der Geburt . Springer Science & Business Media. S. 1–25 . ISBN 978-1-4020-6036-6Die
- ^ Arbuthnot J (1710). „Ein Argument für die göttliche Vorsehung, abgeleitet aus der beobachteten Regelmäßigkeit bei den Geburten beider Geschlechter“ (PDF) . Philosophical Transactions of the Royal Society of London . 27 ( 325–336 ): 186–190 . doi : 10.1098/rstl.1710.0011 . S2CID 186209819 .
- ^ a b Conover WJ (1999). „Kapitel 3.4: Der Vorzeichentest“. Praktische nichtparametrische Statistik (3. Aufl.). Wiley. S. 157–176 . ISBN 978-0-471-16068-7Die
- ^ Sprent P (1989). Angewandte nichtparametrische statistische Methoden (2. Aufl.). Chapman & Hall. ISBN 978-0-412-44980-2Die
- ^ Stigler SM (1986). Die Geschichte der Statistik: Die Messung von Unsicherheit vor 1900. Harvard University Press. S. 225–226 . ISBN 978-0-67440341-3Die
- ^ Bellhouse P (2001). „John Arbuthnot“. In: Heyde CC , Seneta E (Hrsg.). Statistiker der Jahrhunderte . Springer. S. 39–42 . ISBN 978-0-387-95329-8Die
- ^ Hald A (1998). „Kapitel 4. Zufall oder Planung: Signifikanztests“. Geschichte der mathematischen Statistik von 1750 bis 1930. Wiley. S. 65.
- ^ Stigler SM (1986). Die Geschichte der Statistik: Die Messung von Unsicherheit vor 1900. Harvard University Press. S. 134. ISBN 978-0-67440341-3Die
- ^ a b Pearson K (1900). „Über das Kriterium, dass ein gegebenes System von Abweichungen vom Wahrscheinlichen im Falle eines korrelierten Systems von Variablen so ist, dass es vernünftigerweise angenommen werden kann, dass es durch Zufallsstichproben entstanden ist“ (PDF) . Philosophical Magazine . Serie 5. 50 (302): 157–175 . doi : 10.1080/14786440009463897 .
- ^ Biau, David Jean; Jolles, Brigitte M.; Porcher, Raphaël (2010). „P-Wert und die Theorie des Hypothesentests: Eine Erklärung für Nachwuchsforscher“ . Clinical Orthopaedics and Related Research . 468 (3): 885–892 . doi : 10.1007/s11999-009-1164-4 . ISSN 0009-921X . PMC 2816758. PMID 19921345 .
- ^ Brereton, Richard G. (2021). „P-Werte und multivariate Verteilungen: Nicht-orthogonale Terme in Regressionsmodellen“ . Chemometrics and Intelligent Laboratory Systems . 210 104264. doi : 10.1016/j.chemolab.2021.104264 .
- ^ Hubbard R, Bayarri MJ (2003), „Verwirrung über Evidenzmaße ( p ′s) versus Fehler (α′s) in klassischen statistischen Tests“, The American Statistician , 57 (3): 171–178 [S. 171], doi : 10.1198/0003130031856 , S2CID 55671953
- ^ Fisher 1925 , S. 47, Kapitel III. Verteilungen .
- ^ a b Dallal 2012 , Anmerkung 31: Warum P=0,05? .
- ^ Fisher 1925 , S. 78–79, 98, Kapitel IV. Tests auf Anpassungsgüte, Unabhängigkeit und Homogenität; mit Tabelle von χ 2 , Tabelle III. Tabelle von χ 2 .
- ^ Fisher 1971 , II. Die Prinzipien des Experimentierens, veranschaulicht durch ein psychophysikalisches Experiment.
- ^ a b Fisher 1971 , Abschnitt 7. Der Signifikanztest.
- ^ Fisher 1971 , Abschnitt 12.1 Wissenschaftliche Schlussfolgerungen und Akzeptanzverfahren.
- ^ „Definition des E-Werts“ . National Institutes of Health .
- ^Storey JD (2003). "The positive false discovery rate: a Bayesian interpretation and the q-value". The Annals of Statistics. 31 (6): 2013–2035. doi:10.1214/aos/1074290335.
- ^Storey JD, Tibshirani R (August 2003). "Statistical significance for genomewide studies". Proceedings of the National Academy of Sciences of the United States of America. 100 (16): 9440–9445. Bibcode:2003PNAS..100.9440S. doi:10.1073/pnas.1530509100. PMC 170937. PMID 12883005.
- ^Makowski D, Ben-Shachar MS, Chen SH, Lüdecke D (10 December 2019). "Indices of Effect Existence and Significance in the Bayesian Framework". Frontiers in Psychology. 10 2767. doi:10.3389/fpsyg.2019.02767. PMC 6914840. PMID 31920819.
- ^An Introduction to Second-Generation p-Values Jeffrey D. Blume, Robert A. Greevy, Valerie F. Welty, Jeffrey R. Smith &William D. Dupont https://www.tandfonline.com/doi/full/10.1080/00031305.2018.1537893
- ^Die Testentscheidung – Bio Data Science
- ^Rafi, Zad; Greenland, Sander (2020-09-30). "Semantic and cognitive tools to aid statistical science: replace confidence and significance by compatibility and surprise". BMC Medical Research Methodology. 20 (1): 244. arXiv:1909.08579. doi:10.1186/s12874-020-01105-9. ISSN 1471-2288.
- ^Rovetta, Alessandro (2024-01-12). "S-values and Surprisal intervals to Replace P-values and Confidence Intervals: Accepted - January 2024". REVSTAT-Statistical Journal. ISSN 2183-0371. Archived from the original on 2024-12-04.
Further reading
- Denworth L (Oktober 2019). „Ein bedeutendes Problem: Standardmethoden der Wissenschaft stehen unter Beschuss. Wird sich etwas ändern?“ Scientific American . 321 (4): 62–67 (63).
Die Verwendung von p- Werten zur Bestimmung der statistischen Signifikanz experimenteller Ergebnisse hat seit fast einem Jahrhundert [seit 1925] zu einer Illusion von Gewissheit und zu Reproduzierbarkeitskrisen in vielen wissenschaftlichen Bereichen beigetragen . Es gibt zunehmend den Willen, die statistische Analyse zu reformieren… Einige [Forscher] schlagen eine Änderung der statistischen Methoden vor, während andere die Abschaffung eines Schwellenwerts für die Definition „signifikanter“ Ergebnisse befürworten.
- Elderton WP (1902). „Tabellen zum Testen der Güte der Anpassung von Theorie und Beobachtung“ . Biometrika . 1 (2): 155–163 . doi : 10.1093/biomet/1.2.155 .
- Pearson, Karl (1914). „Über die Wahrscheinlichkeit, dass zwei unabhängige Häufigkeitsverteilungen tatsächlich Stichproben derselben Population sind, unter besonderer Berücksichtigung neuerer Arbeiten zur Identität von Trypanosomenstämmen“. Biometrika . 10 : 85–154 . doi : 10.1093/biomet/10.1.85 .
- Fisher RA (1925). Statistische Methoden für Forscher . Edinburgh, Schottland: Oliver & Boyd. ISBN 978-0-05-002170-5Die
{{cite book}}:ISBN-/Datumsinkompatibilität ( Hilfe ) - Fisher RA (1971) [1935]. Versuchsplanung (9. Aufl.). Macmillan. ISBN 978-0-02-844690-5Die
- Fisher RA, Yates F (1938). Statistische Tabellen für die biologische, landwirtschaftliche und medizinische Forschung . London, England.
{{cite book}}CS1 Wartung: Standort des fehlenden Herausgebers ( Link ) - Stigler SM (1986). Die Geschichte der Statistik: Die Messung von Unsicherheit vor 1900. Cambridge, Mass.: Belknap Press of Harvard University Press. ISBN 978-0-674-40340-6Die
- Hubbard R, Armstrong JS (2006). „Warum wir nicht wirklich wissen, was statistische Signifikanz bedeutet: Implikationen für Pädagogen“ (PDF) . Journal of Marketing Education . 28 (2): 114–120 . doi : 10.1177/0273475306288399 . hdl : 2092/413 . S2CID 34729227. Archiviert vom Original (PDF) am 18. Mai 2006.
- Hubbard R, Lindsay RM (2008). „Warum p- Werte kein nützliches Maß für die Aussagekraft statistischer Signifikanztests sind“ (PDF) . Theory & Psychology . 18 (1): 69–88 . doi : 10.1177/0959354307086923 . S2CID 143487211. Archiviert vom Original (PDF) am 21.10.2016 . Abgerufen am 28.08.2015 .
- Stigler S (Dezember 2008). „Fisher und das 5%-Niveau“ . Chance . 21 (4): 12. doi : 10.1007/s00144-008-0033-3 .
- Dallal GE (2012). Das kleine Handbuch der statistischen Praxis .
- Biau DJ, Jolles BM, Porcher R (März 2010). „P-Wert und die Theorie des Hypothesentests: Eine Erklärung für Nachwuchswissenschaftler“ . Clinical Orthopaedics and Related Research . 468 (3): 885–892 . doi : 10.1007/s11999-009-1164-4 . PMC 2816758. PMID 19921345 .
- Reinhart A (2015). Statistics Done Wrong: The Woefully Complete Guide . No Starch Press . S. 176. ISBN 978-1-59327-620-1Die
- Benjamini, Yoav ; De Veaux, Richard D.; Efron, Bradley ; Evans, Scott; Glickman, Mark; Graubard, Barry I.; He, Xuming; Meng, Xiao-Li ; Reid, Nancy ; Stigler, Stephen M .; Vardeman, Stephen B.; Wikle, Christopher K.; Wright, Tommy; Young, Linda J.; Kafadar, Karen (2021). „Stellungnahme der ASA-Präsidenten-Taskforce zu statistischer Signifikanz und Replizierbarkeit“ . Annals of Applied Statistics . 15 (3): 1084–1085 . doi : 10.1214/21-AOAS1501 .
- Benjamin, Daniel J.; Berger, James O.; Johannesson, Magnus; Nosek, Brian A.; Wagenmakers, E.-J.; Berk, Richard; Bollen, Kenneth A.; Brembs, Björn; Brown, Lawrence; Camerer, Colin; Cesarini, David; Chambers, Christopher D.; Clyde, Merlise; Cook, Thomas D.; De Boeck, Paul; Dienes, Zoltan; Dreber, Anna; Easwaran, Kenny; Efferson, Charles; Fehr, Ernst; Fidler, Fiona; Field, Andy P.; Forster, Malcolm; George, Edward I.; Gonzalez, Richard; Goodman, Steven; Green, Edwin; Green, Donald P.; Greenwald, Anthony G.; Hadfield, Jarrod D.; Hedges, Larry V.; Held, Leonhard; Hua Ho, Teck; Hoijtink, Herbert; Hruschka, Daniel J.; Imai, Kosuke; Imbens, Guido; Ioannidis, John PA; Jeon, Minjeong; Jones, James Holland; Kirchler, Michael; Laibson, David; Liste, John; Wenig, Roderick; Lupia, Arthur; Machery, Edouard; Maxwell, Scott E.; McCarthy, Michael; Moore, Don A.; Morgan, Stephen L.; Munafó, Marcus; Nakagawa, Shinichi; Nyhan, Brendan; Parker, Timothy H.; Pericchi, Luis; Perugini, Marco; Rouder, Jeff; Rousseau, Judith; Savalei, Victoria; Schönbrodt, Felix D.; Sellke, Thomas; Sinclair, Betsy; Tingley, Dustin; Van Zandt, Trisha; Vazire, Simine; Watts, Duncan J.; Winship, Christopher; Wolpert, Robert L.; Xie, Yu; Jung, Cristobal; Zinman, Jonathan; Johnson, Valen E. (1. September 2017). „Statistische Signifikanz neu definieren“. Nature Human Behaviour . 2 (1): 6–10 . doi : 10.1038/s41562-017-0189-z . eISSN 2397-3374 . hdl : 10281/184094 . PMID 30980045. S2CID 256726352 .
Externe Links
- Kostenlose Online -Rechner für p -Werte für verschiedene spezifische Tests (Chi-Quadrat-Test, Fisher-F-Test usw.).
- Verständnis von p -Werten , einschließlich eines Java-Applets, das veranschaulicht, wie die numerischen Werte von p -Werten einen irreführenden Eindruck von der Wahrheit oder Falschheit der zu testenden Hypothese vermitteln können.
- StatQuest: P-Werte, klar erklärt auf YouTube
- StatQuest: Fallstricke beim p-Wert und Berechnungen der Teststärke auf YouTube
- Science Isn't Broken – Artikel darüber, wie p -Werte manipuliert werden können, und ein interaktives Tool zur Visualisierung.