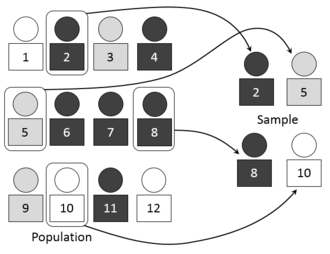
In der Statistik , der Qualitätssicherung und der Umfragemethodik bezeichnet Stichprobenziehung die Auswahl einer Teilmenge von Individuen aus einer statistischen Grundgesamtheit , um Merkmale der Gesamtpopulation zu schätzen. Diese Teilmenge, die als statistische Stichprobe (oder kurz Stichprobe ) bezeichnet wird, soll die Gesamtpopulation repräsentieren, und Statistiker bemühen sich, repräsentative Stichproben zu erheben.
Die Stichprobenziehung ist kostengünstiger und ermöglicht eine schnellere Datenerhebung als eine Volkszählung , bei der Daten der gesamten Bevölkerung erfasst werden (in vielen Fällen ist die Erfassung der gesamten Bevölkerung unmöglich, beispielsweise die Bestimmung der Größen aller Sterne im Universum). Daher kann sie in Fällen, in denen die Messung einer gesamten Bevölkerung nicht durchführbar ist, wertvolle Erkenntnisse liefern.
Jede Beobachtung misst eine oder mehrere Eigenschaften (wie Gewicht, Lage, Farbe oder Masse) unabhängiger Objekte oder Individuen. Bei Stichprobenverfahren können die Daten gewichtet werden, um dem Stichprobendesign, insbesondere bei geschichteten Stichproben, Rechnung zu tragen . [ 1 ] Ergebnisse der Wahrscheinlichkeitstheorie und der Statistik dienen als Grundlage für die Durchführung. In der Wirtschafts- und medizinischen Forschung werden Stichproben häufig zur Informationsgewinnung über eine Population eingesetzt. [ 2 ] Die Annahmestichprobe dient der Feststellung, ob eine Produktionscharge die vorgegebenen Spezifikationen erfüllt .
Geschichte
Die Zufallsstichprobe mittels Losverfahren ist eine alte Idee, die mehrfach in der Bibel erwähnt wird. 1786 schätzte Pierre Simon Laplace die Bevölkerung Frankreichs mithilfe einer Stichprobe und eines Verhältnisschätzers . Er berechnete auch Wahrscheinlichkeitsschätzungen des Fehlers. Diese wurden nicht als moderne Konfidenzintervalle , sondern als die Stichprobengröße ausgedrückt, die erforderlich wäre, um eine bestimmte obere Schranke für den Stichprobenfehler mit einer Wahrscheinlichkeit von 1000/1001 zu erreichen. Seine Schätzungen basierten auf dem Bayes-Theorem mit einer uniformen A-priori-Wahrscheinlichkeit und der Annahme, dass seine Stichprobe zufällig war. Alexander Iwanowitsch Tschuprow führte in den 1870er Jahren Stichprobenerhebungen im zaristischen Russland ein. [ 3 ]
In den USA erwies sich die Prognose des „Literary Digest“ von 1936, die einen republikanischen Sieg bei der Präsidentschaftswahl voraussagte , aufgrund einer gravierenden Voreingenommenheit als völlig falsch [1] . Über zwei Millionen Menschen nahmen an der Studie teil; ihre Namen stammten aus Zeitschriftenabonnentenlisten und Telefonbüchern. Man erkannte nicht, dass diese Listen stark republikanisch geprägt waren, und die resultierende Stichprobe war, obwohl sehr groß, stark fehlerhaft. [ 4 ] [ 5 ]
In Singapur wird seit den Wahlen 2015 die Praxis der Stichprobenauszählung angewendet . Laut der Wahlbehörde (Elections Department, ELD), der nationalen Wahlkommission, tragen Stichprobenauszählungen dazu bei, Spekulationen und Fehlinformationen zu reduzieren und den Wahlbeamten die Überprüfung des Wahlergebnisses im jeweiligen Wahlkreis zu ermöglichen. Die gemeldeten Stichprobenauszählungen liefern ein recht genaues, indikatives Ergebnis mit einer Fehlermarge von 4 % bei einem Konfidenzintervall von 95 % . Die ELD weist jedoch darauf hin, dass Stichprobenauszählungen von den offiziellen Ergebnissen getrennt sind und erst der Wahlleiter das offizielle Ergebnis nach Abschluss der Stimmauszählung bekannt geben wird. [ 6 ] [ 7 ]
Bevölkerungsdefinition
Erfolgreiche statistische Praxis basiert auf einer präzisen Problemdefinition. Bei der Stichprobenziehung umfasst dies die Definition der Grundgesamtheit , aus der die Stichprobe gezogen wird. Eine Grundgesamtheit kann als die Gesamtheit aller Personen oder Objekte mit den zu untersuchenden Merkmalen definiert werden. Da es äußerst selten möglich ist, Informationen von allen oder allen Mitgliedern einer Grundgesamtheit zu erheben, besteht das Ziel darin, eine repräsentative Stichprobe (oder Teilmenge) dieser Grundgesamtheit zu finden.
Manchmal ist die Definition einer Population offensichtlich. Beispielsweise muss ein Hersteller entscheiden, ob eine Produktionscharge die erforderliche Qualität für die Auslieferung an den Kunden aufweist oder aufgrund mangelnder Qualität verschrottet oder nachbearbeitet werden muss. In diesem Fall ist die Charge die Population.
Obwohl die untersuchte Population häufig aus physischen Objekten besteht, ist es manchmal notwendig, Stichproben über Zeit, Raum oder eine Kombination dieser Dimensionen zu erheben. Beispielsweise könnte eine Untersuchung des Supermarktpersonals die Länge der Kassenschlangen zu verschiedenen Tageszeiten analysieren, oder eine Studie über gefährdete Pinguine könnte deren Nutzung verschiedener Jagdgebiete im Laufe der Zeit untersuchen. Bezüglich der Zeitdimension kann der Fokus auf Zeiträumen oder einzelnen Ereignissen liegen.
In anderen Fällen kann die untersuchte „Population“ noch weniger greifbar sein. Joseph Jagger beispielsweise untersuchte das Verhalten von Roulette -Kesseln in einem Casino in Monte Carlo und nutzte dies, um einen manipulierten Kessel zu identifizieren. In diesem Fall war die „Population“, die Jagger untersuchen wollte, das Gesamtverhalten des Kessels (d. h. die Wahrscheinlichkeitsverteilung seiner Ergebnisse über unendlich viele Versuche), während seine „Stichprobe“ aus den beobachteten Ergebnissen dieses Kessels gebildet wurde. Ähnliche Überlegungen stellen sich bei wiederholten Messungen von Materialeigenschaften wie der elektrischen Leitfähigkeit von Kupfer .
Diese Situation tritt häufig auf, wenn man Erkenntnisse über das Ursachensystem gewinnen möchte , dessen Ergebnis die beobachtete Population ist. In solchen Fällen kann die Stichprobentheorie die beobachtete Population als Stichprobe einer größeren „Superpopulation“ betrachten. Beispielsweise könnte ein Forscher die Erfolgsquote eines neuen Programms zur Raucherentwöhnung an einer Testgruppe von 100 Patienten untersuchen, um die Auswirkungen des Programms vorherzusagen, falls es landesweit verfügbar wäre. Die Superpopulation wäre hier „alle Einwohner des Landes, die Zugang zu dieser Behandlung hätten“ – eine Gruppe, die noch nicht existiert, da das Programm noch nicht für alle verfügbar ist.
Die Grundgesamtheit, aus der die Stichprobe stammt, ist möglicherweise nicht identisch mit der Grundgesamtheit, aus der die Informationen gewonnen werden sollen. Häufig gibt es aufgrund von Definitionsfragen etc. eine große, aber nicht vollständige Überschneidung zwischen diesen beiden Gruppen (siehe unten). Manchmal sind sie auch völlig getrennt – beispielsweise könnte man Ratten untersuchen, um die menschliche Gesundheit besser zu verstehen, oder Daten von Personen, die 2008 geboren wurden, analysieren, um Vorhersagen über Personen zu treffen, die 2009 geboren wurden.
Der Zeitaufwand für die präzise Bestimmung der Stichprobenpopulation und der relevanten Population ist oft gut investiert, da dadurch viele Probleme, Unklarheiten und Fragen aufgeworfen werden, die in dieser Phase sonst übersehen worden wären.
Stichprobenrahmen
Im einfachsten Fall, etwa bei der Stichprobenentnahme aus einer Produktionscharge (Chargenprüfung), wäre es ideal, jedes einzelne Element der Grundgesamtheit zu identifizieren und zu messen und jedes beliebige davon in die Stichprobe aufzunehmen. Im Allgemeinen ist dies jedoch weder möglich noch praktikabel. Es ist unmöglich, alle Ratten in der Gesamtheit aller Ratten zu identifizieren. Wo keine Wahlpflicht besteht, lässt sich nicht vorhersagen, welche Personen an einer bevorstehenden Wahl teilnehmen werden. Solche ungenau definierten Grundgesamtheiten eignen sich nicht für die unten beschriebenen Stichprobenverfahren, auf die wir statistische Theorien anwenden könnten.
As a remedy, we seek a sampling frame which has the property that we can identify every single element and include any in our sample.[8][9][10][11] The most straightforward type of frame is a list of elements of the population (preferably the entire population) with appropriate contact information. For example, in an opinion poll, possible sampling frames include an electoral register and a telephone directory.
A probability sample is a sample in which every unit in the population has a chance (greater than zero) of being selected in the sample, and this probability can be accurately determined. The combination of these traits makes it possible to produce unbiased estimates of population totals, by weighting sampled units according to their probability of selection.
Example: We want to estimate the total income of adults living in a given street. We visit each household in that street, identify all adults living there, and randomly select one adult from each household. (For example, we can allocate each person a random number, generated from a uniform distribution between 0 and 1, and select the person with the highest number in each household). We then interview the selected person and find their income.
People living on their own are certain to be selected, so we simply add their income to our estimate of the total. But a person living in a household of two adults has only a one-in-two chance of selection. To reflect this, when we come to such a household, we would count the selected person's income twice towards the total. (The person who is selected from that household can be loosely viewed as also representing the person who isn't selected.)
In the above example, not everybody has the same probability of selection; what makes it a probability sample is the fact that each person's probability is known. When every element in the population does have the same probability of selection, this is known as an 'equal probability of selection' (EPS) design. Such designs are also referred to as 'self-weighting' because all sampled units are given the same weight.
Probability sampling includes: simple random sampling, systematic sampling, stratified sampling, probability-proportional-to-size sampling, and cluster or multistage sampling. These various ways of probability sampling have two things in common:
- Every element has a known nonzero probability of being sampled and
- involves random selection at some point.
Nonprobability sampling
Nonprobability sampling is any sampling method where some elements of the population have no chance of selection (these are sometimes referred to as 'out of coverage'/'undercovered'), or where the probability of selection cannot be accurately determined. It involves the selection of elements based on assumptions regarding the population of interest, which forms the criteria for selection. Hence, because the selection of elements is nonrandom, nonprobability sampling does not allow the estimation of sampling errors. These conditions give rise to exclusion bias, placing limits on how much information a sample can provide about the population. Information about the relationship between sample and population is limited, making it difficult to extrapolate from the sample to the population.
Example: We visit every household in a given street, and interview the first person to answer the door. In any household with more than one occupant, this is a nonprobability sample, because some people are more likely to answer the door (e.g., an unemployed person who spends most of their time at home is more likely to answer than an employed housemate who might be at work when the interviewer calls) and it's not practical to calculate these probabilities.
Nonprobability sampling methods include convenience sampling, quota sampling, snowball sampling, and purposive sampling. In addition, nonresponse effects may turn any probability design into a nonprobability design if the characteristics of nonresponse are not well understood, since nonresponse effectively modifies each element's probability of being sampled.
Sampling methods
Within any of the types of frames identified above, a variety of sampling methods can be employed individually or in combination. Factors commonly influencing the choice between these designs include:
- Nature and quality of the frame
- Availability of auxiliary information about units on the frame
- Accuracy requirements, and the need to measure accuracy
- Whether detailed analysis of the sample is expected
- Cost/operational concerns
Simple random sampling
Bei einer einfachen Zufallsstichprobe (SRS) einer bestimmten Größe hat jede Teilmenge des Stichprobenrahmens die gleiche Wahrscheinlichkeit, ausgewählt zu werden. Jedes Element des Rahmens hat somit die gleiche Auswahlwahrscheinlichkeit: Der Rahmen wird nicht unterteilt oder partitioniert. Darüber hinaus hat jedes beliebige Paar von Elementen die gleiche Auswahlwahrscheinlichkeit wie jedes andere Paar (und analog für Tripel usw.). Dies minimiert Verzerrungen und vereinfacht die Ergebnisanalyse. Insbesondere die Varianz zwischen den einzelnen Ergebnissen innerhalb der Stichprobe ist ein guter Indikator für die Varianz in der Gesamtpopulation, wodurch sich die Genauigkeit der Ergebnisse relativ leicht abschätzen lässt.
Einfache Zufallsstichproben sind anfällig für Stichprobenfehler, da die zufällige Auswahl zu einer Stichprobe führen kann, die nicht die Zusammensetzung der Grundgesamtheit widerspiegelt. Beispielsweise ergibt eine einfache Zufallsstichprobe von zehn Personen aus einem bestimmten Land im Durchschnitt fünf Männer und fünf Frauen. In einer konkreten Stichprobe ist jedoch mit hoher Wahrscheinlichkeit ein Geschlecht überrepräsentiert und das andere unterrepräsentiert. Systematische und geschichtete Verfahren versuchen, dieses Problem zu beheben, indem sie „Informationen über die Grundgesamtheit“ nutzen, um eine repräsentativere Stichprobe auszuwählen.
Auch die einfache Zufallsstichprobe kann bei großen Zielpopulationen umständlich und langwierig sein. Manchmal interessieren sich Forschende für Forschungsfragen, die sich speziell auf Untergruppen der Bevölkerung beziehen. Beispielsweise könnten sie untersuchen, ob die kognitive Leistungsfähigkeit als Prädiktor für Arbeitsleistung für alle ethnischen Gruppen gleichermaßen gilt. Die einfache Zufallsstichprobe genügt in diesem Fall nicht den Bedürfnissen der Forschenden, da sie keine Teilstichproben der Population liefert. Stattdessen können andere Stichprobenverfahren, wie beispielsweise die geschichtete Stichprobe, eingesetzt werden.
Systematische Probenahme

Systematische Stichprobenziehung (auch Intervallstichprobe genannt) basiert darauf, die Grundgesamtheit nach einem bestimmten Schema zu ordnen und anschließend in regelmäßigen Abständen Elemente aus dieser Liste auszuwählen. Die systematische Stichprobenziehung beginnt mit einem zufälligen Startpunkt und fährt dann mit der Auswahl jedes k -ten Elements fort. Dabei gilt: k = (Grundgesamtheitsgröße / Stichprobengröße). Wichtig ist, dass der Startpunkt nicht automatisch das erste Element der Liste ist, sondern zufällig aus den ersten bis k -ten Elementen der Liste gewählt wird. Ein einfaches Beispiel wäre die Auswahl jedes zehnten Namens aus dem Telefonbuch (eine „Zehnterstichprobe“, auch „Stichprobe mit Zehnerschritt“ genannt).
As long as the starting point is randomized, systematic sampling is a type of probability sampling. It is easy to implement and the stratification induced can make it efficient, if the variable by which the list is ordered is correlated with the variable of interest. 'Every 10th' sampling is especially useful for efficient sampling from databases.
For example, suppose we wish to sample people from a long street that starts in a poor area (house No. 1) and ends in an expensive district (house No. 1000). A simple random selection of addresses from this street could easily end up with too many from the high end and too few from the low end (or vice versa), leading to an unrepresentative sample. Selecting (e.g.) every 10th street number along the street ensures that the sample is spread evenly along the length of the street, representing all of these districts. (If we always start at house #1 and end at #991, the sample is slightly biased towards the low end; by randomly selecting the start between #1 and #10, this bias is eliminated.)
However, systematic sampling is especially vulnerable to periodicities in the list. If periodicity is present and the period is a multiple or factor of the interval used, the sample is especially likely to be unrepresentative of the overall population, making the scheme less accurate than simple random sampling.
For example, consider a street where the odd-numbered houses are all on the north (expensive) side of the road, and the even-numbered houses are all on the south (cheap) side. Under the sampling scheme given above, it is impossible to get a representative sample; either the houses sampled will all be from the odd-numbered, expensive side, or they will all be from the even-numbered, cheap side, unless the researcher has previous knowledge of this bias and avoids it by a using a skip which ensures jumping between the two sides (any odd-numbered skip).
Another drawback of systematic sampling is that even in scenarios where it is more accurate than SRS, its theoretical properties make it difficult to quantify that accuracy. (In the two examples of systematic sampling that are given above, much of the potential sampling error is due to variation between neighbouring houses – but because this method never selects two neighbouring houses, the sample will not give us any information on that variation.)
As described above, systematic sampling is an EPS method, because all elements have the same probability of selection (in the example given, one in ten). It is not 'simple random sampling' because different subsets of the same size have different selection probabilities – e.g., the set {4,14,24,...,994} has a one-in-ten probability of selection, but the set {4,13,24,34,...} has zero probability of selection.
Systematic sampling can also be adapted to a non-EPS approach; for an example, see discussion of PPS samples below.
Stratified sampling

When the population embraces a number of distinct categories, the frame can be organized by these categories into separate "strata." Each stratum is then sampled as an independent sub-population, out of which individual elements can be randomly selected.[8] The ratio of the size of this random selection (or sample) to the size of the population is called a sampling fraction.[12] There are several potential benefits to stratified sampling.[12]
First, dividing the population into distinct, independent strata can enable researchers to draw inferences about specific subgroups that may be lost in a more generalized random sample.
Second, utilizing a stratified sampling method can lead to more efficient statistical estimates (provided that strata are selected based upon relevance to the criterion in question, instead of availability of the samples). Even if a stratified sampling approach does not lead to increased statistical efficiency, such a tactic will not result in less efficiency than would simple random sampling, provided that each stratum is proportional to the group's size in the population.
Third, it is sometimes the case that data are more readily available for individual, pre-existing strata within a population than for the overall population; in such cases, using a stratified sampling approach may be more convenient than aggregating data across groups (though this may potentially be at odds with the previously noted importance of utilizing criterion-relevant strata).
Finally, since each stratum is treated as an independent population, different sampling approaches can be applied to different strata, potentially enabling researchers to use the approach best suited (or most cost-effective) for each identified subgroup within the population.
There are, however, some potential drawbacks to using stratified sampling. First, identifying strata and implementing such an approach can increase the cost and complexity of sample selection, as well as leading to increased complexity of population estimates. Second, when examining multiple criteria, stratifying variables may be related to some, but not to others, further complicating the design, and potentially reducing the utility of the strata. Finally, in some cases (such as designs with a large number of strata, or those with a specified minimum sample size per group), stratified sampling can potentially require a larger sample than would other methods (although in most cases, the required sample size would be no larger than would be required for simple random sampling).
- A stratified sampling approach is most effective when three conditions are met
- Variability within strata are minimized
- Variability between strata are maximized
- The variables upon which the population is stratified are strongly correlated with the desired dependent variable.
- Advantages over other sampling methods
- Focuses on important subpopulations and ignores irrelevant ones.
- Allows use of different sampling techniques for different subpopulations.
- Improves the accuracy/efficiency of estimation.
- Permits greater balancing of statistical power of tests of differences between strata by sampling equal numbers from strata varying widely in size.
- Disadvantages
- Requires selection of relevant stratification variables which can be difficult.
- Is not useful when there are no homogeneous subgroups.
- Can be expensive to implement.
- Poststratification
Stratification is sometimes introduced after the sampling phase in a process called "poststratification".[8] This approach is typically implemented due to a lack of prior knowledge of an appropriate stratifying variable or when the experimenter lacks the necessary information to create a stratifying variable during the sampling phase. Although the method is susceptible to the pitfalls of post hoc approaches, it can provide several benefits in the right situation. Implementation usually follows a simple random sample. In addition to allowing for stratification on an ancillary variable, poststratification can be used to implement weighting, which can improve the precision of a sample's estimates.[8]
- Oversampling
Choice-based sampling or oversampling is one of the stratified sampling strategies. In choice-based sampling,[13] the data are stratified on the target and a sample is taken from each stratum so that rarer target classes will be more represented in the sample. The model is then built on this biased sample. The effects of the input variables on the target are often estimated with more precision with the choice-based sample even when a smaller overall sample size is taken, compared to a random sample. The results usually must be adjusted to correct for the oversampling.
Probability-proportional-to-size sampling
In some cases the sample designer has access to an "auxiliary variable" or "size measure", believed to be correlated to the variable of interest, for each element in the population. These data can be used to improve accuracy in sample design. One option is to use the auxiliary variable as a basis for stratification, as discussed above.
Another option is probability proportional to size ('PPS') sampling, in which the selection probability for each element is set to be proportional to its size measure, up to a maximum of 1. In a simple PPS design, these selection probabilities can then be used as the basis for Poisson sampling. However, this has the drawback of variable sample size, and different portions of the population may still be over- or under-represented due to chance variation in selections.
Systematic sampling theory can be used to create a probability proportionate to size sample. This is done by treating each count within the size variable as a single sampling unit. Samples are then identified by selecting at even intervals among these counts within the size variable. This method is sometimes called PPS-sequential or monetary unit sampling in the case of audits or forensic sampling.
Example: Suppose we have six schools with populations of 150, 180, 200, 220, 260, and 490 students respectively (total 1500 students), and we want to use student population as the basis for a PPS sample of size three. To do this, we could allocate the first school numbers 1 to 150, the second school 151 to 330 (= 150 + 180), the third school 331 to 530, and so on to the last school (1011 to 1500). We then generate a random start between 1 and 500 (equal to 1500/3) and count through the school populations by multiples of 500. If our random start was 137, we would select the schools which have been allocated numbers 137, 637, and 1137, i.e. the first, fourth, and sixth schools.
The PPS approach can improve accuracy for a given sample size by concentrating sample on large elements that have the greatest impact on population estimates. PPS sampling is commonly used for surveys of businesses, where element size varies greatly and auxiliary information is often available – for instance, a survey attempting to measure the number of guest-nights spent in hotels might use each hotel's number of rooms as an auxiliary variable. In some cases, an older measurement of the variable of interest can be used as an auxiliary variable when attempting to produce more current estimates.[14]
Cluster sampling

Sometimes it is more cost-effective to select respondents in groups ('clusters'). Sampling is often clustered by geography or by time periods (nearly all samples are in some sense 'clustered' in time – although this is rarely taken into account in the analysis). For instance, if surveying households within a city, we might choose to select 100 city blocks and then interview every household within the selected blocks.
Clustering can reduce travel and administrative costs. In the example above, an interviewer can make a single trip to visit several households in one block, rather than having to drive to a different block for each household.
It also means that one does not need a sampling frame listing all elements in the target population. Instead, clusters can be chosen from a cluster-level frame, with an element-level frame created only for the selected clusters. In the example above, the sample only requires a block-level city map for initial selections, and then a household-level map of the 100 selected blocks, rather than a household-level map of the whole city.
Cluster sampling (also known as clustered sampling) generally increases the variability of sample estimates above that of simple random sampling, depending on how the clusters differ between one another as compared to the within-cluster variation. For this reason, cluster sampling requires a larger sample than SRS to achieve the same level of accuracy – but cost savings from clustering might still make this a cheaper option.
Die Clusterstichprobe wird üblicherweise als mehrstufige Stichprobenziehung durchgeführt . Dabei handelt es sich um eine komplexe Form der Clusterstichprobe, bei der zwei oder mehr Ebenen von Einheiten ineinander verschachtelt sind. Im ersten Schritt werden die Cluster gebildet, aus denen die Stichproben gezogen werden. Im zweiten Schritt wird aus jedem Cluster eine Stichprobe von Primäreinheiten zufällig ausgewählt (anstatt alle Einheiten aller ausgewählten Cluster zu verwenden). In den folgenden Schritten werden in jedem dieser ausgewählten Cluster weitere Stichproben von Einheiten gezogen usw. Alle im letzten Schritt dieses Verfahrens ausgewählten Endeinheiten (z. B. Einzelpersonen) werden dann befragt. Dieses Verfahren ist somit im Wesentlichen die Entnahme von zufälligen Teilstichproben aus vorhergehenden Zufallsstichproben.
Mehrstufige Stichprobenverfahren können die Kosten erheblich senken, da hierfür eine vollständige Populationsliste erstellt werden müsste (bevor andere Stichprobenverfahren angewendet werden können). Durch den Wegfall der Beschreibung nicht ausgewählter Cluster können die hohen Kosten herkömmlicher Clusterstichproben reduziert werden. [ 14 ] Allerdings ist jede Stichprobe möglicherweise nicht vollständig repräsentativ für die Gesamtpopulation.
Quotenstichprobe
Bei der Quotenstichprobe wird die Grundgesamtheit, ähnlich wie bei der geschichteten Stichprobe , zunächst in sich gegenseitig ausschließende Untergruppen unterteilt . Anschließend werden die Probanden oder Einheiten aus jeder Untergruppe anhand eines festgelegten Anteils ausgewählt. Beispielsweise könnte ein Interviewer angewiesen werden, 200 Frauen und 300 Männer im Alter zwischen 45 und 60 Jahren zu befragen.
Erst dieser zweite Schritt macht das Verfahren zu einer nicht-probabilistischen Stichprobenziehung. Bei Quotenstichproben erfolgt die Auswahl der Stichprobe nicht zufällig . Interviewer könnten beispielsweise in Versuchung geraten, diejenigen zu befragen, die am hilfreichsten erscheinen. Das Problem besteht darin, dass diese Stichproben verzerrt sein können, da nicht jeder die Chance erhält, ausgewählt zu werden. Dieses Zufallselement ist die größte Schwäche des Verfahrens, und die Frage, ob Quotenstichproben oder Wahrscheinlichkeitsstichproben besser geeignet sind, wird seit Jahren kontrovers diskutiert.
Minimax-Abtastung
Bei unausgewogenen Datensätzen, in denen das Stichprobenverhältnis nicht der Populationsstatistik entspricht, kann man den Datensatz konservativ neu beproben, was als Minimax-Sampling bezeichnet wird . Das Minimax-Sampling hat seinen Ursprung im Anderson -Minimax-Verhältnis, dessen Wert nachweislich 0,5 beträgt: Bei einer binären Klassifizierung sollten die Klassenstichprobengrößen gleich groß sein. Dieses Verhältnis kann nur unter der Annahme eines LDA- Klassifikators mit Gaußverteilungen als Minimax-Verhältnis bewiesen werden. Das Konzept des Minimax-Samplings wurde kürzlich für eine allgemeine Klasse von Klassifikationsregeln, sogenannte klassenweise intelligente Klassifikatoren, entwickelt. In diesem Fall wird das Stichprobenverhältnis der Klassen so gewählt, dass der schlechteste Klassifikatorfehler über alle möglichen Populationsstatistiken für die Klassen-Prior-Wahrscheinlichkeiten hinweg minimal ist. [ 12 ]
Zufällige Probenahme
Gelegenheitsstichproben (auch bekannt als Zufallsstichproben ) sind eine Form der nicht-probabilistischen Stichprobenziehung . Dabei wird die Stichprobe aus einem Teil der Grundgesamtheit gezogen , der leicht erreichbar ist. Die Auswahl erfolgt also , weil die Grundgesamtheit einfach zugänglich und bequem ist. Dies kann durch persönliche Begegnungen, durch die Einbeziehung einer Person in die Stichprobe im Rahmen einer zufälligen Begegnung oder durch die Suche nach ihr mithilfe von Technologien wie dem Internet oder per Telefon geschehen. Forschende, die eine solche Stichprobe verwenden, können daraus keine wissenschaftlichen Verallgemeinerungen über die Gesamtbevölkerung ableiten, da die Stichprobe nicht repräsentativ genug wäre. Führt ein Interviewer beispielsweise eine solche Umfrage früh morgens in einem Einkaufszentrum durch, beschränkt sich die Anzahl der zu befragenden Personen auf diejenigen, die sich zu diesem Zeitpunkt dort aufhalten. Würde die Umfrage zu verschiedenen Tageszeiten und mehrmals pro Woche durchgeführt, wären die Ansichten anderer Mitglieder der Gesellschaft in diesem Gebiet nicht repräsentativ. Diese Art der Stichprobenziehung eignet sich am besten für Pilotstudien. Forschende, die Gelegenheitsstichproben verwenden, sollten folgende wichtige Punkte beachten:
- Gibt es im Forschungsdesign oder im Experiment Kontrollmechanismen, die dazu dienen können, den Einfluss einer nicht-zufälligen Gelegenheitsstichprobe zu verringern und dadurch sicherzustellen, dass die Ergebnisse repräsentativer für die Grundgesamtheit sind?
- Gibt es einen triftigen Grund zu der Annahme, dass eine bestimmte Gelegenheitsstichprobe anders reagieren oder sich anders verhalten würde oder sollte als eine Zufallsstichprobe aus derselben Grundgesamtheit?
- Ist die Forschungsfrage eine, die mit einer Gelegenheitsstichprobe hinreichend beantwortet werden kann?
In der sozialwissenschaftlichen Forschung ist das Schneeballverfahren eine ähnliche Technik, bei der bereits vorhandene Studienteilnehmer genutzt werden, um weitere Teilnehmer für die Stichprobe zu rekrutieren. Einige Varianten des Schneeballverfahrens, wie beispielsweise das respondentengesteuerte Sampling, ermöglichen die Berechnung von Auswahlwahrscheinlichkeiten und gelten unter bestimmten Bedingungen als Wahrscheinlichkeitsstichprobenverfahren.
Freiwillige Probenahme
Die freiwillige Stichprobenmethode ist eine Form der nicht-probabilistischen Stichprobenziehung. Freiwillige entscheiden selbst, ob sie an einer Umfrage teilnehmen möchten.
Freiwillige können über Anzeigen in sozialen Medien gewonnen werden. [ 15 ] Die Zielgruppe für diese Anzeigen kann anhand von Merkmalen wie Wohnort, Alter, Geschlecht, Einkommen, Beruf, Bildung oder Interessen mithilfe der von den sozialen Medien bereitgestellten Tools ausgewählt werden. Die Anzeige kann eine Information über die Studie und einen Link zu einer Umfrage enthalten. Nach dem Aufrufen des Links und dem Ausfüllen der Umfrage übermittelt der Freiwillige seine Daten, um in die Stichprobe aufgenommen zu werden. Mit dieser Methode kann eine globale Bevölkerungsgruppe erreicht werden, allerdings ist sie durch das Kampagnenbudget begrenzt. Auch Freiwillige außerhalb der eingeladenen Zielgruppe können in die Stichprobe aufgenommen werden.
Aus dieser Stichprobe lassen sich nur schwer allgemeine Aussagen treffen, da sie möglicherweise nicht die Gesamtbevölkerung repräsentiert. Oftmals haben Freiwillige ein starkes Interesse am Hauptthema der Umfrage.
Linienabschnittsabtastung
Bei der Linienabschnittsstichprobe handelt es sich um eine Methode zur Stichprobenentnahme von Elementen in einem Gebiet, bei der ein Element dann in die Stichprobe aufgenommen wird, wenn eine gewählte Liniensegment, die als „Transekt“ bezeichnet wird, das Element schneidet.
Panel-Stichprobe
Panel-Sampling ist eine Methode, bei der zunächst eine Gruppe von Teilnehmenden per Zufallsstichprobe ausgewählt und anschließend über einen bestimmten Zeitraum hinweg mehrmals (möglicherweise dieselben) Informationen erhoben werden. Jede/r Teilnehmende wird somit zu zwei oder mehr Zeitpunkten befragt; jede Datenerhebungsperiode wird als „Welle“ bezeichnet. Die Methode wurde 1938 von dem Soziologen Paul Lazarsfeld zur Untersuchung politischer Kampagnen entwickelt . [ 16 ] Dieses Längsschnitt -Sampling-Verfahren ermöglicht Schätzungen von Veränderungen in der Bevölkerung, beispielsweise in Bezug auf chronische Erkrankungen, beruflichen Stress oder wöchentliche Lebensmittelausgaben. Panel-Sampling kann auch genutzt werden, um Forschende über altersbedingte Veränderungen des Gesundheitszustands einzelner Personen zu informieren oder um Veränderungen kontinuierlicher abhängiger Variablen wie der Interaktion zwischen Ehepartnern zu erklären. [ 17 ] Es wurden verschiedene Methoden zur Analyse von Paneldaten vorgeschlagen , darunter MANOVA , Wachstumskurven und Strukturgleichungsmodelle mit verzögerten Effekten.
Schneeballverfahren
Beim Schneeballverfahren wird zunächst eine kleine Gruppe von Befragten ausgewählt, die dann genutzt wird, um weitere Befragte zu rekrutieren. Es ist besonders nützlich, wenn die Grundgesamtheit schwer zu erfassen oder zu dezimieren ist.
Theoretische Stichproben
Theoretisches Sampling [ 18 ] bezeichnet die Auswahl von Stichproben auf Basis bisher erhobener Daten, um ein tieferes Verständnis des Untersuchungsgebiets zu erlangen oder Theorien zu entwickeln. Zunächst wird eine allgemeine Stichprobe erhoben, um allgemeine Trends zu untersuchen. Anschließend können extreme oder sehr spezifische Fälle ausgewählt werden, um die Wahrscheinlichkeit zu maximieren, dass ein Phänomen tatsächlich beobachtbar ist.
Aktive Probenahme
Beim aktiven Sampling werden die Stichproben, die zum Trainieren eines maschinellen Lernalgorithmus verwendet werden, aktiv ausgewählt; vergleiche auch aktives Lernen (maschinelles Lernen) .
Urteilsbasierte Auswahl
Bei der Beurteilungsstichprobe, auch Expertenstichprobe oder zielgerichtete Stichprobe genannt, handelt es sich um eine Art nicht-zufälliger Stichprobenziehung, bei der die Stichproben auf der Grundlage der Meinung eines Experten ausgewählt werden, der die Teilnehmer danach auswählt, wie wertvoll die von ihnen gelieferten Informationen sind.
Zufällige Stichproben
Die Zufallsstichprobe basiert auf dem Prinzip, durch menschliches Urteilsvermögen Zufälligkeit zu simulieren. Obwohl die Stichproben manuell ausgewählt werden, ist das Ziel, bewusste Voreingenommenheit bei der Stichprobenauswahl auszuschließen. Dies scheitert jedoch häufig an Selektionsverzerrungen . [ 19 ] Die Zufallsstichprobe wird in der Regel aufgrund ihrer Praktikabilität gewählt, wenn die Mittel oder Kapazitäten für andere Stichprobenverfahren nicht vorhanden sind.
Die größte Schwäche solcher Stichproben besteht darin, dass sie oft nicht die Merkmale der gesamten Population repräsentieren, sondern nur einen Teil davon. Aufgrund dieser unausgewogenen Repräsentation sind die Ergebnisse von Zufallsstichproben häufig verzerrt. [ 20 ]
Austausch ausgewählter Einheiten
Sampling schemes may be without replacement ('WOR' – no element can be selected more than once in the same sample) or with replacement ('WR' – an element may appear multiple times in the one sample). For example, if we catch fish, measure them, and immediately return them to the water before continuing with the sample, this is a WR design, because we might end up catching and measuring the same fish more than once. However, if we do not return the fish to the water or tag and release each fish after catching it, this becomes a WOR design.
Sample size determination
Formulas, tables, and power function charts are well known approaches to determine sample size.
Steps for using sample size tables:
- Postulate the effect size of interest, α, and β.
- Check sample size table[21]
- Select the table corresponding to the selected α
- Locate the row corresponding to the desired power
- Locate the column corresponding to the estimated effect size.
- The intersection of the column and row is the minimum sample size required.
Sampling and data collection
Good data collection involves:
- Following the defined sampling process
- Keeping the data in time order
- Noting comments and other contextual events
- Recording non-responses
Applications of sampling
Sampling enables the selection of right data points from within the larger data set to estimate the characteristics of the whole population. For example, there are about 600 million tweets produced every day. It is not necessary to look at all of them to determine the topics that are discussed during the day, nor is it necessary to look at all the tweets to determine the sentiment on each of the topics. A theoretical formulation for sampling Twitter data has been developed.[22]
In manufacturing different types of sensory data such as acoustics, vibration, pressure, current, voltage, and controller data are available at short time intervals. To predict down-time it may not be necessary to look at all the data but a sample may be sufficient.
Errors in sample surveys
Survey results are typically subject to some error. Total errors can be classified into sampling errors and non-sampling errors. The term "error" here includes systematic biases as well as random errors.
Sampling errors and biases
Sampling errors and biases are induced by the sample design. They include:
- Selection bias: When the true selection probabilities differ from those assumed in calculating the results.
- Random sampling error: Random variation in the results due to the elements in the sample being selected at random.
Non-sampling error
Non-sampling errors are other errors which can impact final survey estimates, caused by problems in data collection, processing, or sample design. Such errors may include:
- Übermäßige Datenabdeckung: Einbeziehung von Daten von außerhalb der Bevölkerung
- Untererfassung: Der Stichprobenrahmen umfasst nicht alle Elemente der Grundgesamtheit.
- Messfehler: z. B. wenn Befragte eine Frage missverstehen oder Schwierigkeiten bei der Beantwortung haben.
- Verarbeitungsfehler: Fehler in der Datenkodierung
- Verzerrung durch fehlende Antworten oder Teilnahme : Unvollständige Datenerhebung von allen ausgewählten Personen
Nach der Probenahme wird der tatsächlich durchgeführte Probenahmeprozess überprüft, nicht der beabsichtigte, um mögliche Auswirkungen von Abweichungen auf die nachfolgende Analyse zu untersuchen.
Ein besonderes Problem ist die Nichtbeantwortung . Es gibt zwei Hauptarten der Nichtbeantwortung: [ 23 ] [ 24 ]
- Fehlende Antworten (fehlende Bearbeitung eines Teils der Umfrage)
- Fehlende Antwort (Einreichung oder Teilnahme an der Umfrage, jedoch Nichtbeantwortung einer oder mehrerer Komponenten/Fragen der Umfrage)
Bei Umfragestichproben kann es vorkommen, dass viele der als Teil der Stichprobe identifizierten Personen nicht teilnehmen wollen, keine Zeit dafür haben ( Opportunitätskosten ) [ 25 ] oder von den Umfrageleitern nicht erreicht werden konnten. In diesem Fall besteht das Risiko von Unterschieden zwischen Teilnehmenden und Nicht-Teilnehmenden, was zu verzerrten Schätzungen von Populationsparametern führen kann. Dem wird häufig durch eine verbesserte Umfragegestaltung, das Anbieten von Anreizen und die Durchführung von Folgestudien begegnet, in denen wiederholt versucht wird, die Nicht-Teilnehmenden zu kontaktieren und ihre Gemeinsamkeiten und Unterschiede zum Rest der Stichprobe zu charakterisieren [ 26 ] . Die Auswirkungen lassen sich auch durch Gewichtung der Daten (sofern Populationsbenchmarks verfügbar sind) oder durch Imputation von Daten auf Basis der Antworten auf andere Fragen abmildern. Nichtteilnahme ist insbesondere bei Online-Stichproben ein Problem. Gründe für dieses Problem könnten unter anderem schlecht konzipierte Umfragen [ 24 ] , zu viele Umfragen (oder Umfragemüdigkeit) [ 17 ] [ 27 ] und die Tatsache sein, dass potenzielle Teilnehmer mehrere E-Mail-Adressen haben, die sie nicht mehr benutzen oder nicht regelmäßig überprüfen.
Gewichtung der Umfrage
In vielen Fällen kann der Stichprobenanteil je nach Schicht variieren, und die Daten müssen gewichtet werden, um die Grundgesamtheit korrekt abzubilden. So würde beispielsweise eine einfache Zufallsstichprobe von Personen im Vereinigten Königreich möglicherweise einige Bewohner abgelegener schottischer Inseln ausschließen, deren Stichprobenziehung unverhältnismäßig kostspielig wäre. Eine kostengünstigere Methode wäre die Verwendung einer geschichteten Stichprobe mit städtischen und ländlichen Schichten. Die ländliche Stichprobe könnte zwar in der Gesamtstichprobe unterrepräsentiert sein, aber in der Analyse entsprechend höher gewichtet werden, um dies auszugleichen.
Generell sollten Daten gewichtet werden, wenn die Stichprobengestaltung nicht jedem Einzelnen die gleiche Auswahlchance einräumt. Beispielsweise verringert sich die Wahrscheinlichkeit für Personen aus großen Haushalten, wenn alle Haushalte die gleiche Auswahlwahrscheinlichkeit haben, aber nur eine Person pro Haushalt befragt wird. Dies kann durch Gewichtungsfaktoren berücksichtigt werden. Ebenso haben Haushalte mit mehreren Telefonanschlüssen eine höhere Auswahlchance bei einer Zufallsstichprobe; auch dies kann durch Gewichtungsfaktoren ausgeglichen werden.
Gewichte können auch anderen Zwecken dienen, beispielsweise um fehlende Reaktionen auszugleichen.
Methoden zur Erzeugung von Zufallsstichproben
- Zufallszahlentabelle
- Mathematische Algorithmen für Pseudozufallszahlengeneratoren
- Physikalische Zufallsgeneratoren wie Münzen, Spielkarten oder hochentwickelte Geräte wie ERNIE
Siehe auch
- Datenerfassung
- Designeffekt
- Schätztheorie
- Gys Stichprobentheorie
- Deutsches Panzerproblem
- Horvitz-Thompson-Schätzer
- Latin-Hypercube-Sampling
- Offizielle Statistiken
- Verhältnis-Schätzer
- Replikation (Statistik)
- Zufallsstichprobenmechanismus
- Resampling (Statistik)
- Pseudozufallszahlenstichprobe
- Bestimmung der Stichprobengröße
- Stichproben (Fallstudien)
- Stichprobenverzerrung
- Stichprobenverteilung
- Stichprobenfehler
- Losverfahren
- Stichprobenverfahren
Anmerkungen
Das Lehrbuch von Groves et al. bietet einen Überblick über die Methodik von Umfragen und berücksichtigt dabei auch neuere Literatur zur Fragebogenentwicklung (unter Einbeziehung der Kognitionspsychologie ):
- Robert Groves et al. Umfragemethodik (2010, 2. Aufl. [2004]), ISBN 0-471-48348-6Die
Die anderen Bücher konzentrieren sich auf die statistische Theorie der Stichprobenziehung und setzen Grundkenntnisse der Statistik voraus, wie sie in den folgenden Lehrbüchern erläutert werden:
- David S. Moore und George P. McCabe (Februar 2005). „ Einführung in die Praxis der Statistik “ (5. Auflage). WH Freeman & Company. ISBN 0-7167-6282-XDie
- Freedman, David ; Pisani, Robert; Purves, Roger (2007). Statistik (4. Aufl.). New York: Norton . ISBN 978-0-393-92972-0Die
Das Grundschulbuch von Scheaffer et al. verwendet quadratische Gleichungen aus der Algebra der Oberstufe:
- Scheaffer, Richard L., William Mendenhal und R. Lyman Ott. Elementare Stichprobenverfahren , Fünfte Auflage. Belmont: Duxbury Press, 1996.
Für Lohr, für Särndal et al. und für Cochran sind weitere mathematische Statistiken erforderlich: [ 28 ].
- Cochran, William G. (1977). Stichprobenverfahren (3. Aufl.). Wiley. ISBN 978-0-471-16240-7Die
- Lohr, Sharon L. (1999). Stichprobenverfahren: Planung und Analyse . Duxbury. ISBN 978-0-534-35361-2Die
- Särndal, Carl-Erik ; Swensson, Bengt; Wretman, Jan (1992). Modellgestützte Stichprobenerhebung . Springer-Verlag. ISBN 978-0-387-40620-6Die
Die historisch bedeutsamen Bücher von Deming und Kish sind nach wie vor wertvoll für die Erkenntnisse von Sozialwissenschaftlern (insbesondere über die US-Volkszählung und das Institut für Sozialforschung an der Universität von Michigan ):
- Deming, W. Edwards (1966). Einige Theorien der Stichprobenziehung . Dover Publications . ISBN 978-0-486-64684-8OCLC 166526 .
- Kish, Leslie (1995) Survey Sampling , Wiley, ISBN 0-471-10949-5
Referenzen
- ^ Lance, P.; Hattori, A. (2016). Sampling and Evaluation . Web: MEASURE Evaluation. pp. 6– 8, 62– 64.
- ^ Salant, Priscilla, I. Dillman und A. Don. Wie man eine eigene Umfrage durchführt . Nr. 300.723 S3. 1994.
- ^ Seneta, E. (1985). „Eine Skizze zur Geschichte der Stichprobenziehung in Russland“ . Journal of the Royal Statistical Society. Series A (General) . 148 (2): 118–125 . doi : 10.2307/2981944 . JSTOR 2981944 .
- ^ David S. Moore und George P. McCabe . " Einführung in die Praxis der Statistik ".
- ^ Freedman, David ; Pisani, Robert; Purves, Roger. Statistik .
- ^ „Stichprobenauszählung – Wahlbehörde Singapur“ (PDF) . Abgerufen am 3. September 2023 .
- ^ Ho, Timothy (1. September 2023). „Präsidentschaftswahl 2023: Wie genau wird die Stichprobenauszählung heute Abend sein?“ . DollarsAndSense.sg . Abgerufen am 3. September 2023 .
- ^ a b c d Robert M. Groves; et al. (2009).ErhebungsmethodikJohn Wiley & Sons. ISBN 978-0470465462Die
- ^ Lohr, Sharon L. Stichproben: Planung und Analyse .
- ^ Särndal, Carl-Erik; Swensson, Bengt; Wretman, Jan. Modellunterstützte Stichprobenerhebung .
- ^ Scheaffer, Richard L.; William Mendenhal; R. Lyman Ott. (2006). Elementare Stichprobenverfahren .
- ^ a b c Shahrokh Esfahani, Mohammad; Dougherty, Edward (2014). „Einfluss der separaten Stichprobenentnahme auf die Klassifikationsgenauigkeit“ . Bioinformatics . 30 (2): 242–250 . doi : 10.1093/bioinformatics/btt662 . PMID 24257187 .
- ^ Scott, AJ; Wild, CJ (1986). „Anpassung logistischer Modelle bei Fall-Kontroll- oder Wahlstichprobenverfahren“. Journal of the Royal Statistical Society, Series B. 48 ( 2): 170–182 . doi : 10.1111/j.2517-6161.1986.tb01400.x . JSTOR 2345712 .
- ^ a b
- Lohr, Sharon L. Stichprobenverfahren: Planung und Analyse .
- Särndal, Carl-Erik; Swensson, Bengt; Wretman, Jan. Modellunterstützte Stichprobenerhebung .
- ^ Ariyaratne, Buddhika (30. Juli 2017). „Freiwillige Stichprobenmethode kombiniert mit Social-Media-Werbung“ . heal-info.blogspot.com . Gesundheitsinformatik . Abgerufen am 18. Dezember 2018 .
- ^ Lazarsfeld, P., & Fiske, M. (1938). Das „Panel“ als neues Instrument zur Meinungsforschung. The Public Opinion Quarterly, 2(4), 596–612.
- ^ a b Groves et al. Umfragemethodik
- ^ „Beispiele für Stichprobenverfahren“ (PDF) .
- ^ „Definition der Zufallsstichprobe“ . AccountingTools . 7. Januar 2024.
- ^ IRS Statistical Sampling Handbook . USA: Department of the Treasury, Internal Revenue Service. 1988. S. 8.
- ^ Cohen, 1988
- ^ Deepan Palguna; Vikas Joshi; Venkatesan Chakaravarthy; Ravi Kothari; LV Subramaniam (2015). Analyse von Sampling-Algorithmen für Twitter . Internationale Gemeinsame Konferenz über Künstliche Intelligenz .
- ^ Berinsky, AJ (2008). „Nichtteilnahme an Umfragen“. In: W. Donsbach & MW Traugott (Hrsg.), The Sage handbook of public opinion research (S. 309–321). Thousand Oaks, CA: Sage Publications.
- ^ a b Dillman, DA, Eltinge, JL, Groves, RM, & Little, RJA (2002). „Nichtteilnahme an Umfragen: Planung, Datenerhebung und Analyse“. In: RM Groves, DA Dillman, JL Eltinge & RJA Little (Hrsg.), Nichtteilnahme an Umfragen (S. 3–26). New York: John Wiley & Sons.
- ^ Dillman, D. A., Smyth, J. D. & Christian, L. M. (2009). Internet-, Post- und Mixed-Mode-Umfragen: Die Methode des maßgeschneiderten Designs. San Francisco: Jossey-Bass.
- ^ Vehovar, V., Batagelj, Z., Manfreda, KL und Zaletel, M. (2002). „Nichtbeantwortung bei Webumfragen“. In: RM Groves, DA Dillman, JL Eltinge und RJA Little (Hrsg.), Umfrage-Nonresponse (S. 229–242). New York: John Wiley & Sons.
- ^ Porter, Whitcomb, Weitzer (2004). „Mehrere Befragungen von Studierenden und Befragungsmüdigkeit“. In: Porter, Stephen R. (Hrsg.). Überwindung von Problemen in der Umfrageforschung . Neue Wege für die institutionelle Forschung. San Francisco: Jossey-Bass. S. 63–74 . ISBN 9780787974770Abgerufen am 15. Juli 2019 .
- ^ Cochran, William G. (1977-01-01). Sampling Techniques, 3rd Edition (3. Aufl.). New York, NY: John Wiley & Sons. ISBN 978-0-471-16240-7Die
Weiterführende Literatur
- Singh, GN, Jaiswal, AK und Pandey, AK (2021), Verbesserte Imputationsmethoden für fehlende Daten bei sukzessiver Stichprobenziehung zu zwei Zeitpunkten, Communications in Statistics: Theory and Methods. DOI:10.1080/03610926.2021.1944211
- Chambers, RL und Skinner, CJ (Hrsg.) (2003), Analyse von Umfragedaten , Wiley, ISBN 0-471-89987-9
- Deming, W. Edwards (1975) Über Wahrscheinlichkeit als Grundlage für Handeln, The American Statistician , 29(4), S. 146–152.
- Gy, P (2012) Sampling of Heterogeneous and Dynamic Material Systems: Theories of Heterogeneity, Sampling and Homogenizing , Elsevier Science, ISBN 978-0444556066
- Korn, EL, und Graubard, BI (1999) Analyse von Gesundheitsbefragungen , Wiley, ISBN 0-471-13773-1
- Lucas, Samuel R. (2012). doi : 10.1007/s11135-012-9775-3 "Jenseits des Existenzbeweises: Ontologische Bedingungen, epistemologische Implikationen und Tiefeninterviewforschung."], Quality & Quantity , doi : 10.1007/s11135-012-9775-3 .
- Stuart, Alan (1962) Grundideen der wissenschaftlichen Probenahme , Hafner Publishing Company, New York
- Smith, TMF (1984). „Gegenwärtige Lage und mögliche Entwicklungen: Einige persönliche Ansichten: Stichprobenerhebungen“. Journal of the Royal Statistical Society, Series A. 147 ( 150. Jahrestag der Royal Statistical Society, Nummer 2): 208–221 . doi : 10.2307/2981677 . JSTOR 2981677 .
- Smith, TMF (1993). „Populationen und Selektion: Grenzen der Statistik (Präsidentenansprache)“. Journal of the Royal Statistical Society, Series A. 156 ( 2): 144–166 . doi : 10.2307/2982726 . JSTOR 2982726 .(Porträt von TMF Smith auf Seite 144)
- Smith, TMF (2001). „Centenary: Sample surveys“. Biometrika . 88 (1): 167– 243. doi : 10.1093/biomet/88.1.167 .
- Smith, TMF (2001). „Biometrika-Hundertjahrfeier: Stichprobenuntersuchungen“. In DM Titterington und DR Cox (Hrsg.).Biometrika : Hundert Jahre . Oxford University Press. S. 165–194 . ISBN 978-0-19-850993-6Die
- Whittle, P. (Mai 1954). „Optimale präventive Stichprobenziehung“. Journal of the Operations Research Society of America . 2 (2): 197–203 . doi : 10.1287/opre.2.2.197 . JSTOR 166605 .
Standards
ISO
- ISO 2859-Reihe
- ISO 3951-Reihe
ASTM
- ASTM E105 Standardverfahren für die Wahrscheinlichkeitsstichprobenentnahme von Materialien
- ASTM E122 Standardverfahren zur Berechnung des Stichprobenumfangs zur Schätzung des Mittelwerts einer Chargen- oder Prozesscharakteristik mit einem festgelegten zulässigen Fehler.
- ASTM E141 Standardverfahren für die Annahme von Nachweisen auf der Grundlage der Ergebnisse von Wahrscheinlichkeitsstichproben
- ASTM E1402 Standardterminologie für die Probenahme
- ASTM E1994 Standardverfahren für die Anwendung prozessorientierter AOQL- und LTPD-Probenahmepläne
- ASTM E2234 Standardverfahren zur Probenahme eines Produktstroms anhand von durch AQL indizierten Attributen
ANSI, ASQ
- ANSI/ASQ Z1.4
US-Bundes- und Militärstandards
- MIL-STD-105
- MIL-STD-1916
Externe Links
 Medien zum Thema Stichproben (Statistik) auf Wikimedia Commons