
Analogische Modellierung ( AM ) ist eine formale Theorie des exemplarbasierten analogischen Schließens, die von Royal Skousen , Professor für Linguistik und Anglistik an der Brigham Young University in Provo, Utah ,
ExzellentAnalogy
Kategorie
33 Artikel
Analogische Modellierung ( AM ) ist eine formale Theorie des exemplarbasierten analogischen Schließens, die von Royal Skousen , Professor für Linguistik und Anglistik an der Brigham Young University in Provo, Utah ,
Die artikulatorische Phonologie ist eine linguistische Theorie, die 1986 von Catherine Browman von den Haskins Laboratories und Louis Goldstein von der University of Southern California und Haskins entwickelt wurde.
Automatische Zusammenfassung ist der Prozess, einen Datensatz rechnerisch zu kürzen, um eine Teilmenge (eine Zusammenfassung ) zu erstellen, die die wichtigsten oder relevantesten Informationen des Originalinhalts

In der Linguistik ist eine Treebank ein analysierter Textkorpus , der die syntaktische oder semantische Satzstruktur annotiert .
Die Message Understanding Conferences ( MUC ) für Informatik und Computerwissenschaften wurden von der DARPA (Defense Advanced Research Projects Agency) initiiert und finanziert, um die Entwicklung neuer und besserer
Die chinesische Computerlinguistik ist ein Teilgebiet der Computerlinguistik ; sie befasst sich mit der wissenschaftlichen Erforschung und Informationsverarbeitung der chinesischen Sprache mithilfe von Computern.

ClearForest war ein israelisches Softwareunternehmen, das Lösungen für Textanalyse und Text Mining entwickelte und vermarktete .

Die „Ground Truth“ bezeichnet Informationen, deren Wahrheitsgehalt bekannt ist und die durch direkte Beobachtung und Messung (d. h.

In der Informatik und im Operations Research sind genetische Fuzzy-Systeme Fuzzy-Systeme, die mithilfe genetischer Algorithmen oder genetischer Programmierung konstruiert werden, welche den Prozess der natürlichen
Das Georgetown-IBM-Experiment war eine einflussreiche Demonstration der maschinellen Übersetzung und wurde am 7. Januar 1954 durchgeführt.
Google Neural Machine Translation ( GNMT ) war ein eingestelltes System für neuronale maschinelle Übersetzung (NMT), das von Google entwickelt und im November 2016 eingeführt wurde.

In der Informationstheorie bezeichnet die Hamming-Distanz zwischen zwei Zeichenketten oder Vektoren gleicher Länge die Anzahl der Positionen, an denen sich die entsprechenden Symbole unterscheiden.

Handschrifterkennung ( HWR ), auch bekannt als Handschrifttexterkennung ( HTR ), bezeichnet die Fähigkeit eines Computers, verständliche handschriftliche Eingaben von Quellen wie Papierdokumenten , Fotos , Touchscreens

GloVe , abgeleitet von Global Vectors , ist ein Modell zur verteilten Wortrepräsentation. Es handelt sich um einen unüberwachten Lernalgorithmus zur Erzeugung von Vektorrepräsentationen von Wörtern.

Indexierte Sprachen sind eine Klasse formaler Sprachen, die von Alfred Aho entdeckt wurden ; sie werden durch indizierte Grammatiken beschrieben und können durch verschachtelte Stapelautomaten erkannt werden .
Die International Speech Communication Association ( ISCA ) ist eine gemeinnützige Organisation und neben der IEEE Signal Processing Society einer der beiden wichtigsten Berufsverbände für

Die Kulturomik ist eine Form der computergestützten Lexikologie , die menschliches Verhalten und kulturelle Trends durch die quantitative Analyse digitalisierter Texte untersucht .
Der von Xiaofei Lu an der Pennsylvania State University entwickelte L2 Syntactical Complexity Analyzer (L2SCA) ist ein Computerprogramm zur Berechnung von Indizes der syntaktischen Komplexität englischsprachiger Texte.
In der digitalen Lexikographie , der Verarbeitung natürlicher Sprache und den digitalen Geisteswissenschaften ist eine lexikalische Ressource eine Sprachressource, die aus Daten über die Lexeme des Lexikons einer oder
Ein maschinenlesbares Wörterbuch ( MRD ) ist ein Wörterbuch, das als maschinenlesbare Daten gespeichert und nicht auf Papier gedruckt wird.
Ein morphologisches Muster ist eine Menge von Assoziationen und/oder Operationen, die die verschiedenen Formen eines Lexems bilden , beispielsweise durch Flexion , Agglutination , Komposition oder Derivation .
Named-Entity Recognition ( NER ) (auch bekannt als (benannte) Entitätsidentifizierung , Entitätssegmentierung und Entitätsextraktion ) ist eine Teilaufgabe der Informationsextraktion , die darauf abzielt, benannte

Die semantische Faltungstheorie beschreibt ein Verfahren zur Kodierung der Semantik von natürlichsprachlichen Texten in einer semantisch fundierten binären Repräsentation .

Sketch Engine ist eine Korpusverwaltungs- und Textanalyse- Software, die seit 2003 von Lexical Computing entwickelt wird.

Language Grid (言語グリッド, Gengo Guriddo ) ist eine mehrsprachige Online-Serviceplattform, die Sprachressourcen wie Wörterbücher, zweisprachige Korpora und maschinelle Übersetzungssysteme über Webservice-Technologien
In der linguistischen Morphologie und im Information Retrieval bezeichnet Stemming den Prozess, flektierte (oder manchmal abgeleitete) Wörter auf ihren Wortstamm , ihre Basis oder Wurzel – in der Regel eine geschriebene
In der Linguistik wendet die statistische Semantik die Methoden der Statistik auf das Problem der Bedeutungsbestimmung von Wörtern oder Phrasen an, idealerweise durch unüberwachtes Lernen , mit einer Genauigkeit, die
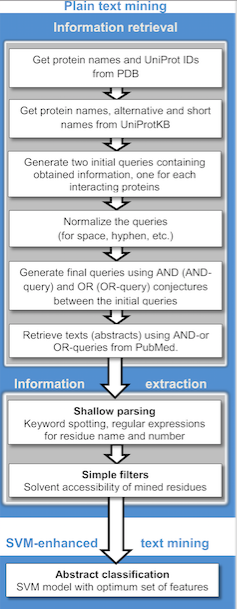
Text Mining , auch Text Data Mining ( TDM ) oder Textanalyse genannt, ist der Prozess der Gewinnung hochwertiger Informationen aus Texten .
TIMIT ist ein Korpus phonemisch und lexikalisch transkribierter Sprachaufnahmen amerikanischer Englischsprecher unterschiedlichen Geschlechts und verschiedener Dialekte.
VoxForge ist ein kostenloses Repository für Sprachkorpora und Akustikmodelle für Open-Source -Spracherkennungssysteme .

In der Verarbeitung natürlicher Sprache ( NLP) ist ein Wort-Embedding eine Repräsentation eines Wortes. Das Embedding wird in der Textanalyse verwendet .

In der Wahrscheinlichkeitstheorie und Statistik ist das Zipf-Mandelbrot-Gesetz eine diskrete Wahrscheinlichkeitsverteilung .

Das Zipfsche Gesetz ( / z ɪ f / ) ist ein empirisches Gesetz, das besagt, dass, wenn eine Menge von Messwerten in absteigender Reihenfolge sortiert wird, der Wert des n -ten Eintrags oft annähernd umgekehrt proportional