A* (ausgesprochen „A-Stern“) ist ein Graphdurchlauf- und Pfadfindungsalgorithmus , der aufgrund seiner Vollständigkeit, Optimalität und optimalen Effizienz in vielen Bereichen der Informatik Anwendung findet . [ 1 ] Gegeben ein gewichteter Graph , ein Startknoten und ein Zielknoten, findet der Algorithmus den kürzesten Pfad (bezüglich der gegebenen Gewichte) vom Startknoten zum Zielknoten.
Ein wesentlicher praktischer Nachteil ist die hohe Speicherkomplexität , wobei d die Tiefe der flachsten Lösung (die Länge des kürzesten Pfades vom Startknoten zu einem beliebigen Zielknoten) und b der Verzweigungsfaktor (die maximale Anzahl an Nachfolgern für einen beliebigen Zustand) ist. In praktischen Reiseplanungssystemen wird A* im Allgemeinen von Algorithmen übertroffen, die den Graphen vorverarbeiten können, um eine bessere Performance zu erzielen [ 2 ] , sowie von speicherbeschränkten Ansätzen; dennoch ist A* in vielen Fällen immer noch die beste Lösung [ 3 ] .

Peter Hart , Nils Nilsson und Bertram Raphael vom Stanford Research Institute (heute SRI International ) veröffentlichten den Algorithmus erstmals 1968. [ 4 ] Er kann als Erweiterung des Dijkstra-Algorithmus betrachtet werden . A* erzielt eine bessere Leistung durch den Einsatz von Heuristiken zur Steuerung der Suche.
Der A*-Algorithmus terminiert, sobald er den kürzesten Pfad zu einem vorgegebenen Ziel gefunden hat, anstatt den gesamten kürzesten Pfadbaum von einer vorgegebenen Quelle zu allen möglichen Zielen zu generieren.
Geschichte

A* entstand im Rahmen des Shakey-Projekts , dessen Ziel der Bau eines mobilen Roboters mit eigener Aktionsplanung war. Nils Nilsson schlug ursprünglich den Graph-Traverser-Algorithmus [ 5 ] für die Pfadplanung von Shakey vor. [ 6 ] Der Graph-Traverser-Algorithmus basiert auf der Heuristikfunktion h ( n ) , der geschätzten Distanz vom Knoten n zum Zielknoten. Die Distanz g ( n ) vom Startknoten zu n wird dabei vollständig ignoriert . Bertram Raphael schlug die Verwendung der Summe g ( n ) + h ( n ) vor . [ 7 ] Peter Hart prägte die Konzepte der Zulässigkeit und Konsistenz von Heuristikfunktionen. A* wurde ursprünglich für die Suche nach kostengünstigsten Pfaden entwickelt, wenn die Kosten eines Pfades der Summe seiner Einzelkosten entsprechen. Es hat sich jedoch gezeigt, dass A* zur Bestimmung optimaler Pfade für jedes Problem verwendet werden kann, das die Bedingungen einer Kostenalgebra erfüllt. [ 8 ]
Die ursprüngliche A*-Veröffentlichung von 1968 [ 4 ] enthielt einen Satz, der besagte, dass kein A*-ähnlicher Algorithmus [ a ] weniger Knoten expandieren könne als A*, wenn die Heuristikfunktion konsistent und die Tie-Breaking-Regel von A* geeignet gewählt sei. Einige Jahre später wurde eine „Korrektur“ [ 9 ] veröffentlicht , die behauptete, Konsistenz sei nicht erforderlich. Dies erwies sich jedoch 1985 in Dechter und Pearls wegweisender Studie zur Optimalität von A* (heute als optimale Effizienz bezeichnet) als falsch. Diese Studie lieferte ein Beispiel für A* mit einer zwar zulässigen, aber nicht konsistenten Heuristik, das beliebig mehr Knoten expandierte als ein alternativer A*-ähnlicher Algorithmus. [ 10 ]
Beschreibung

A* ist ein informierter Suchalgorithmus , auch Best-First-Suche genannt. Das bedeutet, dass er auf gewichteten Graphen basiert : Ausgehend von einem bestimmten Startknoten eines Graphen sucht er den kostengünstigsten Pfad zum Zielknoten (kürzeste zurückgelegte Strecke, kürzeste Laufzeit usw.). Dazu verwaltet er einen Pfadbaum , der vom Startknoten ausgeht, und erweitert diesen Pfad Kante für Kante, bis der Zielknoten erreicht ist.
In jedem Durchlauf seiner Hauptschleife muss A* entscheiden, welcher Pfad verlängert werden soll. Dies geschieht anhand der Kosten des Pfades und einer Schätzung der Kosten, die für die vollständige Verlängerung des Pfades bis zum Ziel erforderlich wären. Konkret wählt A* den Pfad, der die Kosten minimiert.

Dabei ist n der nächste Knoten auf dem Pfad, g ( n ) die Kosten des Pfades vom Startknoten zu n und h ( n ) eine Heuristikfunktion , die die Kosten des günstigsten Pfades von n zum Ziel schätzt. Die Heuristikfunktion ist problemspezifisch.
Typische Implementierungen des A*-Algorithmus verwenden eine Prioritätswarteschlange , um wiederholt Knoten mit minimalen (geschätzten) Kosten für die Expansion auszuwählen. Diese Prioritätswarteschlange wird als offene Menge , Rand oder Frontier bezeichnet . In jedem Schritt des Algorithmus wird der Knoten mit dem niedrigsten f ( x ) -Wert aus der Warteschlange entfernt, die f- und g -Werte seiner Nachbarn werden entsprechend aktualisiert und diese Nachbarn werden der Warteschlange hinzugefügt. Der Algorithmus wird fortgesetzt, bis ein entfernter Knoten (also der Knoten mit dem niedrigsten f- Wert aller Randknoten) ein Zielknoten ist. [ b ] Der f- Wert dieses Zielknotens entspricht dann den Kosten des kürzesten Pfades, da h am Zielknoten in einer zulässigen Heuristik null ist.
Der bisher beschriebene Algorithmus liefert lediglich die Länge des kürzesten Pfades. Um die tatsächliche Abfolge der Schritte zu ermitteln, kann der Algorithmus leicht so angepasst werden, dass jeder Knoten auf dem Pfad seinen Vorgänger speichert. Nach Ausführung des Algorithmus verweist der Endknoten auf seinen Vorgänger usw., bis der Vorgänger eines Knotens der Startknoten ist.
Beispielsweise könnte bei der Suche nach der kürzesten Route auf einer Karte h ( x ) die Luftlinie zum Ziel darstellen , da dies die physikalisch kleinstmögliche Entfernung zwischen zwei beliebigen Punkten ist. Bei einer Rasterkarte aus einem Videospiel ist die Verwendung der Taxi-Distanz oder der Tschebyscheff-Distanz je nach den verfügbaren Bewegungsmöglichkeiten (4-Wege- oder 8-Wege-Route) besser geeignet.
Wenn die Heuristik h die zusätzliche Bedingung h ( x ) ≤ d ( x , y ) + h ( y ) für jede Kante ( x , y ) des Graphen erfüllt (wobei d die Länge dieser Kante bezeichnet), dann wird h als monoton oder konsistent bezeichnet . Mit einer konsistenten Heuristik findet A* garantiert einen optimalen Pfad, ohne einen Knoten mehr als einmal zu verarbeiten, und A* ist äquivalent zur Ausführung des Dijkstra-Algorithmus mit den reduzierten Kosten d' ( x , y ) = d ( x , y ) + h ( y ) − h ( x ) . [ 11 ]
Pseudocode
Der folgende Pseudocode beschreibt den Algorithmus:
function reconstruct_path ( came_from , current ) total_path := {current} while current in came_from . keys : current := came_from [ current ] total_path . prepend ( current ) return total_path// A* findet einen Pfad vom Start zum Ziel. // h ist die Heuristikfunktion. h(n) schätzt die Kosten, um vom Knoten n zum Ziel zu gelangen. Funktion a_star ( Start , Ziel , h ) // Die Menge der gefundenen Knoten, die möglicherweise (erneut) erweitert werden müssen. // Anfangs ist nur der Startknoten bekannt. // Dies wird üblicherweise als Min-Heap oder Prioritätswarteschlange anstelle eines Hash-Sets implementiert. open_set := { Start}// Für Knoten n ist came_from[n] der Knoten, der ihm auf dem günstigsten bekannten Pfad vom Startknoten zu n unmittelbar vorausgeht . came_from := eine leere Map// Für Knoten n ist g_score[n] die aktuell bekannten Kosten des günstigsten Pfades von Start zu n. g_score := map mit dem Standardwert Infinity g_score [ start ] : = 0// Für Knoten n gilt: f_score[n] := g_score[n] + h(n). f_score[n] repräsentiert unsere aktuell beste Schätzung, // wie günstig ein Pfad vom Start zum Ziel sein könnte , wenn er durch n führt. f_score := map mit dem Standardwert Infinity f_score [ start ] : = h ( start )solange open_set nicht leer ist // Diese Operation kann in O(Log(N)) Zeit ausgeführt werden, wenn open_set ein Min-Heap oder eine Prioritätswarteschlange ist. current := der Knoten in open_set mit dem niedrigsten f_score [] Wert. Wenn current = Ziel , gib reconstruct_path ( came_from , current ) zurück.open_set.remove ( current ) for each neighbor of current // d(current,neighbor) is the weight of the edge from current to neighbor // tentative_g_score is the distance from start to the neighbor via current tentative_g_score := g_score [ current ] + d ( current , neighbor ) if tentative_g_score < g_score [ neighbor ] // This path to neighbor is better than any previous one. Record it! came_from [ neighbor ] : = current g_score [ neighbor ] := tentative_g_score f_score [ neighbor ] : = tentative_g_score + h ( neighbor ) if neighbor not in open_set open_set.add ( neighbor )// Die offene Menge ist leer, aber das Ziel wurde nie erreicht. Rückgabe: Fehler.Anmerkung: In diesem Pseudocode wird ein Knoten, der von einem Pfad erreicht, aus dem Suchraum entfernt open_setund anschließend von einem günstigeren Pfad erreicht wird, wieder hinzugefügt open_set. Dies ist unerlässlich, um sicherzustellen, dass der zurückgegebene Pfad optimal ist, falls die Heuristikfunktion zulässig , aber nicht konsistent ist . Ist die Heuristik konsistent, ist der Pfad nach dem Entfernen eines Knotens open_setgarantiert optimal, sodass der Test „ tentative_g_score < g_score[neighbor]“ immer fehlschlägt, wenn der Knoten erneut erreicht wird. Der hier implementierte Pseudocode wird mitunter als Graph-Suchversion von A* bezeichnet. [ 12 ] Dies steht im Gegensatz zur Version ohne den „ tentative_g_score < g_score[neighbor]“-Test zum Wiedereinfügen von Knoten open_set, die mitunter als Baum- Suchversion von A* bezeichnet wird und eine konsistente Heuristik zur Gewährleistung der Optimalität erfordert.
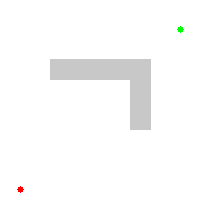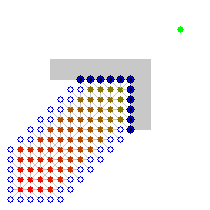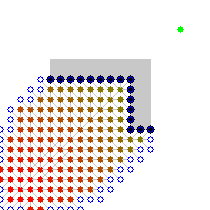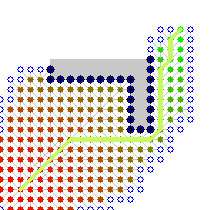
Beispiel
Ein Beispiel für die Anwendung des A*-Algorithmus, wobei die Knoten Städte darstellen, die durch Straßen verbunden sind, und h(x) die geradlinige Entfernung zum Zielpunkt ist:
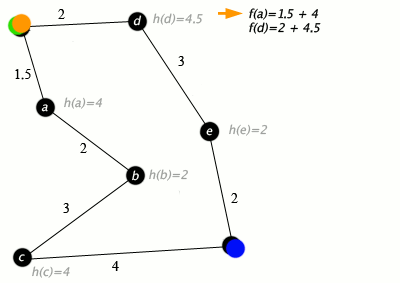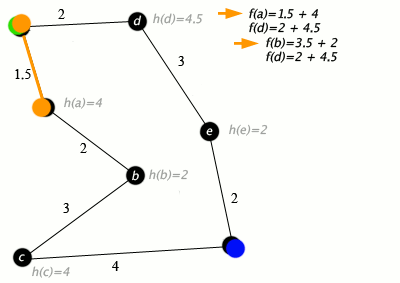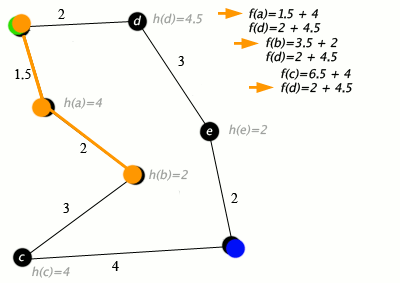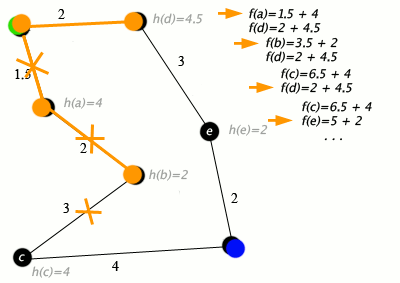
Legende: Grün: Start; Blau: Tor; Orange: besucht
Der A*-Algorithmus findet in der Praxis Anwendung. In diesem Beispiel stellen die Kanten Eisenbahnstrecken dar und h(x) ist die Großkreisdistanz (die kürzeste mögliche Entfernung auf einer Kugel) zum Ziel. Der Algorithmus sucht nach einem Pfad zwischen Washington, D.C., und Los Angeles.

Details zur Implementierung
Es gibt einige einfache Optimierungen und Implementierungsdetails, die die Leistung einer A*-Implementierung erheblich beeinflussen können. Zunächst ist zu beachten, dass die Art und Weise, wie die Prioritätswarteschlange mit Gleichständen umgeht, in bestimmten Situationen einen signifikanten Einfluss auf die Leistung haben kann. Werden Gleichstände so aufgelöst, dass sich die Warteschlange nach dem LIFO- Prinzip verhält, ähnelt A* einer Tiefensuche unter Pfaden mit gleichen Kosten (wodurch die Untersuchung mehrerer gleichwertiger optimaler Lösungen vermieden wird).
Wenn am Ende der Suche ein Pfad benötigt wird, speichert man üblicherweise für jeden Knoten eine Referenz auf dessen Elternknoten. Mithilfe dieser Referenzen lässt sich am Ende der Suche der optimale Pfad ermitteln. Werden diese Referenzen gespeichert, ist es wichtig, dass derselbe Knoten nicht mehrfach in der Prioritätswarteschlange erscheint (jeder Eintrag entspricht einem anderen Pfad zum Knoten und hat unterschiedliche Kosten). Ein gängiger Ansatz besteht darin, zu prüfen, ob ein hinzuzufügender Knoten bereits in der Prioritätswarteschlange vorhanden ist. Ist dies der Fall, werden Priorität und Elternzeiger entsprechend dem Pfad mit den geringeren Kosten angepasst. Eine standardmäßige binäre Heap- basierte Prioritätswarteschlange unterstützt die Suche nach einem ihrer Elemente nicht direkt. Sie kann jedoch durch eine Hashtabelle erweitert werden , die Elemente ihrer Position im Heap zuordnet. Dadurch lässt sich diese Prioritätsreduktion in logarithmischer Zeit durchführen. Alternativ kann ein Fibonacci-Heap dieselben Prioritätsreduktionsoperationen in konstanter amortisierter Zeit ausführen .
Sonderfälle
Der Dijkstra-Algorithmus , ein weiteres Beispiel für einen Suchalgorithmus mit einheitlichen Kosten, kann als Spezialfall des A*-Algorithmus betrachtet werden, wobei für alle x gilt . [ 13 ] [ 14 ] Die allgemeine Tiefensuche lässt sich mithilfe des A*-Algorithmus implementieren, indem man einen globalen Zähler C mit einem sehr großen Wert initialisiert. Bei jedem Knoten wird C allen neu entdeckten Nachbarn zugewiesen. Nach jeder Zuweisung wird der Zähler C um eins verringert. Je früher ein Knoten entdeckt wird, desto höher ist also sein Wert . Sowohl der Dijkstra-Algorithmus als auch die Tiefensuche lassen sich effizienter implementieren, indem man auf die Zuweisung eines Wertes an jedem Knoten verzichtet.


Eigenschaften
Beendigung und Vollständigkeit
Auf endlichen Graphen mit nichtnegativen Kantengewichten terminiert A* garantiert und ist vollständig , d. h., es findet immer eine Lösung (einen Pfad vom Start zum Ziel), falls eine existiert. Auf unendlichen Graphen mit endlichem Verzweigungsfaktor und von Null beschränkten Kantenkosten ( für ein festes ε ) terminiert A* nur dann garantiert, wenn eine Lösung existiert. [ 1 ]


Zulässigkeit
Ein Suchalgorithmus heißt zulässig , wenn er garantiert eine optimale Lösung liefert. Wenn die von A* verwendete Heuristikfunktion zulässig ist , dann ist auch A* zulässig. Ein intuitiver „Beweis“ dafür ist folgender:
Ein Knoten wird als geschlossen bezeichnet , wenn er besucht wurde und sich nicht in der Menge der offenen Knoten befindet. Wir schließen einen Knoten, indem wir ihn aus der Menge der offenen Knoten entfernen. Eine grundlegende Eigenschaft des A*-Algorithmus, deren Beweis wir weiter unten skizzieren werden, ist, dass die Entfernung eines geschlossenen Knotens eine optimistische Schätzung (untere Schranke) der tatsächlichen Entfernung vom Startknoten zum Ziel darstellt. Wenn also der Zielknoten geschlossen ist, entspricht die Entfernung höchstens der tatsächlichen Entfernung. Andererseits ist sie auch nicht geringer als die tatsächliche Entfernung, da sie die Länge eines Pfades zum Ziel plus einen heuristischen Term darstellt.


Wir werden nun sehen, dass die Schätzung immer dann optimistisch ist , wenn ein Knoten geschlossen ist . Es genügt zu erkennen, dass die offene Menge, sofern sie nicht leer ist, mindestens einen Knoten auf einem optimalen Pfad zum Ziel enthält, für den die tatsächliche Entfernung vom Startpunkt ist. Denn in diesem Fall unterschätzt + die Entfernung zum Ziel, und somit auch der kleinere Wert, der für den geschlossenen Knoten gewählt wird. Sei ein optimaler Pfad vom Startpunkt zum Zielpunkt. Sei der letzte geschlossene Knoten auf , für den die tatsächliche Entfernung vom Startpunkt zu ist (der Startpunkt ist ein solcher Knoten). Der nächste Knoten in hat den korrekten Wert, da er aktualisiert wurde, als geschlossen war, und er ist offen, da er nicht geschlossen ist.


Optimalität und Konsistenz
Algorithmus A ist optimal effizient bezüglich einer Menge alternativer Algorithmen Alts auf einer Menge von Problemen P , wenn für jedes Problem P in P und jeden Algorithmus A′ in Alts die Menge der von A bei der Lösung von P expandierten Knoten eine (möglicherweise gleiche) Teilmenge der von A′ bei der Lösung von P expandierten Knoten ist. Die maßgebliche Untersuchung zur optimalen Effizienz von A* stammt von Rina Dechter und Judea Pearl [ 10 ] . Sie betrachteten verschiedene Definitionen von Alts und P in Kombination mit der Annahme, dass die Heuristik von A* entweder nur zulässig oder sowohl konsistent als auch zulässig ist. Das interessanteste positive Ergebnis ihrer Untersuchung ist, dass A* mit einer konsistenten Heuristik optimal effizient bezüglich aller zulässigen A*-ähnlichen Suchalgorithmen auf allen „nicht-pathologischen“ Suchproblemen ist. Vereinfacht ausgedrückt entspricht ihr Begriff des nicht-pathologischen Problems dem, was wir heute unter „bis auf Gleichstand“ verstehen. Dieses Ergebnis gilt nicht, wenn die Heuristik von A* zwar zulässig, aber nicht konsistent ist. In diesem Fall zeigten Dechter und Pearl, dass es zulässige A*-ähnliche Algorithmen gibt, die bei einigen nicht-pathologischen Problemen beliebig weniger Knoten als A* expandieren können.
Optimale Effizienz bezieht sich auf die Menge der expandierten Knoten, nicht auf die Anzahl der Knotenexpansionen (die Anzahl der Iterationen der Hauptschleife von A*). Wenn die verwendete Heuristik zwar zulässig, aber nicht konsistent ist, kann ein Knoten von A* exponentiell oft expandiert werden. [ 15 ] Unter solchen Umständen könnte der Dijkstra-Algorithmus A* deutlich übertreffen. Neuere Forschungen haben jedoch gezeigt, dass dieser pathologische Fall nur in bestimmten, künstlich erzeugten Situationen auftritt, in denen das Kantengewicht des Suchgraphen exponentiell mit der Größe des Graphen wächst, und dass bestimmte inkonsistente (aber zulässige) Heuristiken die Anzahl der Knotenexpansionen bei A*-Suchen reduzieren können. [ 16 ] [ 17 ]
Begrenzte Entspannung

Das Zulässigkeitskriterium garantiert zwar einen optimalen Lösungspfad, bedeutet aber auch, dass A* alle gleichwertigen Pfade untersuchen muss, um den optimalen Pfad zu finden. Um approximative kürzeste Pfade zu berechnen, kann die Suche beschleunigt werden, indem das Zulässigkeitskriterium gelockert wird – allerdings auf Kosten der Optimalität. Oftmals ist es wünschenswert, diese Lockerung zu beschränken, sodass der Lösungspfad nicht schlechter als (1 + ε )-mal der optimale Lösungspfad ist. Diese neue Garantie wird als ε -zulässig bezeichnet.
Es gibt eine Reihe von ε -zulässigen Algorithmen:
- Gewichtete A*-Suche/Statische Gewichtung. [ 18 ] Ist h <sub> a</sub> ( n ) eine zulässige Heuristikfunktion, so verwendet man in der gewichteten Version der A*-Suche h <sub>w</sub> ( n ) = ε h<sub> a </sub> ( n ) , ε > 1 , als Heuristikfunktion und führt die A*-Suche wie gewohnt durch (was letztendlich schneller geht als mit h <sub> a</sub> , da weniger Knoten expandiert werden). Der so gefundene Pfad kann Kosten haben, die höchstens ε- mal so hoch sind wie die des kostengünstigsten Pfades im Graphen. [ 19 ]
- Konvexe Aufwärts-/Abwärtsparabel (XUP/XDP). [ 20 ] Modifikation der Kostenfunktion im gewichteten A*-Algorithmus, um die Optimalität in Richtung Start oder Ziel zu verschieben. XDP liefert nahezu optimale Pfade nahe dem Start, während XUP-Pfade nahezu optimale Pfade nahe dem Ziel liefern. Beide führen insgesamt zu Δ-optimalen Pfaden.
- Die
- Die
- Stückweise steigende/fallende Kurve (pwXU/pwXD). [ 21 ] Ähnlich wie XUP/XDP, jedoch mit stückweise definierten Funktionen anstelle einer Parabel. Die Lösungswege sind ebenfalls -optimal.
- Bei der dynamischen Gewichtung [ 22 ] wird die Kostenfunktion , verwendet, wobei , und wobei die Suchtiefe und N die erwartete Länge des Lösungspfades ist.
- Sampled Dynamic Weighting [ 23 ] verwendet eine Stichprobe von Knoten, um den heuristischen Fehler besser zu schätzen und zu entzerren.
- . [ 24 ] verwendet zwei heuristische Funktionen. Die erste ist die FOCAL-Liste, die zur Auswahl von Kandidatenknoten verwendet wird, und die zweite h F wird verwendet, um den vielversprechendsten Knoten aus der FOCAL-Liste auszuwählen.
- A ε [ 25 ] wählt Knoten mit der Funktion aus , wobei A und B Konstanten sind. Falls keine Knoten ausgewählt werden können, führt der Algorithmus einen Backtracking-Vorgang mit der Funktion durch , wobei C und D Konstanten sind.
- AlphA* [ 26 ] versucht, die Tiefensuche durch Bevorzugung kürzlich expandierter Knoten zu fördern. AlphA* verwendet die Kostenfunktion , wobei λ und Λ Konstanten mit sind , π ( n ) der Elternknoten von n ist und ñ der zuletzt expandierte Knoten ist.


Komplexität
Als heuristischer Suchalgorithmus wird die Leistung von A* stark von der Qualität der Heuristikfunktion beeinflusst . Wenn die Heuristik die tatsächlichen Kosten bis zum Ziel gut approximiert, kann A* die Anzahl der Knotenerweiterungen deutlich reduzieren. Eine ungeeignete Heuristik hingegen kann zu vielen unnötigen Erweiterungen führen.

Schlimmster Fall
Im schlimmsten Fall expandiert A* alle Knoten, für die gilt , wobei die Kosten des optimalen Zielknotens sind.


Warum es nicht schlimmer sein kann
Angenommen, es gibt einen Knoten in der offenen Liste mit , und dieser ist der nächste zu expandierende Knoten. Da der Zielknoten , und , hat der Zielknoten einen niedrigeren f-Wert und wird vor expandiert . Daher expandiert A* niemals Knoten mit .


Warum es nicht besser sein kann
Angenommen, es existiert ein optimaler Algorithmus, der mit derselben Heuristik weniger Knoten expandiert als im ungünstigsten Fall. Das bedeutet, es muss einen Knoten geben , für den gilt, den der Algorithmus jedoch nicht expandiert.

Betrachten wir nun einen modifizierten Graphen, in dem eine neue Kante mit Kosten (mit ) von zum Ziel hinzugefügt wird. Wenn , dann verläuft der neue optimale Pfad durch . Da der Algorithmus jedoch weiterhin die Erweiterung von vermeidet , verpasst er den neuen optimalen Pfad und verletzt somit seine Optimalitätsbedingung.


Daher kann kein optimaler Algorithmus, einschließlich A*, weniger Knoten expandieren als im schlechtesten Fall.
Mathematische Notation
Die Worst-Case-Komplexität des A*-Algorithmus wird oft als beschrieben , wobei der Verzweigungsfaktor und die Tiefe des flachsten Ziels ist. Dies vermittelt zwar eine grobe Intuition, erfasst aber nicht präzise das tatsächliche Verhalten des A*-Algorithmus.


Eine genauere Schranke berücksichtigt die Anzahl der Knoten mit . Wenn die kleinstmögliche Differenz der -Kosten zwischen verschiedenen Knoten ist, dann kann A* bis zu folgendem Umfang expandieren:


Dies stellt sowohl die Zeit- als auch die Speicherkomplexität im ungünstigsten Fall dar.
Raumkomplexität
Die Speicherkomplexität von A* ist in etwa dieselbe wie die aller anderen Graphsuchalgorithmen, da alle generierten Knoten im Speicher gehalten werden. [ 1 ] In der Praxis erweist sich dies als der größte Nachteil der A*-Suche, was zur Entwicklung speicherbeschränkter heuristischer Suchverfahren wie Iterative Deepening A* , Memory-Bounded A* und SMA* geführt hat .
Anwendungen
A* wird häufig für das gängige Pfadfindungsproblem in Anwendungen wie Videospielen verwendet , wurde aber ursprünglich als allgemeiner Graphdurchlaufalgorithmus entwickelt. [ 4 ] Er findet Anwendung in verschiedenen Bereichen, darunter beim Parsen stochastischer Grammatiken in der natürlichen Sprachverarbeitung . [ 27 ] Weitere Anwendungsgebiete sind die Informationssuche mit Online-Lernen. [ 28 ]
Beziehungen zu anderen Algorithmen
Was A* von einem gierigen Best-First-Suchalgorithmus unterscheidet , ist, dass er die Kosten/die bereits zurückgelegte Strecke, g ( n ) , berücksichtigt.
Einige gängige Varianten des Dijkstra-Algorithmus können als Spezialfall des A*-Algorithmus betrachtet werden, wobei die Heuristik für alle Knoten gilt; [ 13 ] [ 14 ] wiederum sind sowohl Dijkstra als auch A* Spezialfälle der dynamischen Programmierung . [ 29 ] A* selbst ist ein Spezialfall einer Verallgemeinerung des Branch-and-Bound- Verfahrens . [ 30 ]

A* ist ähnlich wie die Strahlsuche, mit der Ausnahme, dass die Strahlsuche die Anzahl der zu untersuchenden Pfade begrenzt. [ 31 ]
Varianten
- Jederzeit A* [ 32 ]
- Block A*
- D*
- Feld D*
- Randbereich
- Fringe Saving A* (FSA*)
- Generalisiertes adaptives A* (GAA*)
- inkrementelle heuristische Suche
- Reduziertes A* [ 33 ]
- Iterative Vertiefung A* (IDA*)
- Sprungpunktsuche
- Lebenslange Planung A* (LPA*)
- Neuer bidirektionaler A* (NBA*) [ 34 ]
- Vereinfachtes speicherbegrenztes A* (SMA*)
- Theta*
A* kann auch an einen bidirektionalen Suchalgorithmus angepasst werden , jedoch muss dem Abbruchkriterium besondere Aufmerksamkeit gewidmet werden. [ 35 ]
Siehe auch
- Pfadplanung für beliebige Winkel – Suche nach Pfaden, die nicht auf die Bewegung entlang von Kanten im Graphen beschränkt sind, sondern jeden beliebigen Winkel annehmen können.
- Breitensuche – Algorithmus zur Suche in den Knoten eines Graphen
- Tiefensuche – Algorithmus zur Suche in den Knoten eines Graphen
- Dijkstras Algorithmus – Algorithmus zur Bestimmung kürzester Wege
Anmerkungen
- „ A*-ähnlich“ bedeutet, dass der Algorithmus, genau wie A*, Pfade, die vom Startknoten ausgehen, Kante für Kante erweitert. Dies schließt beispielsweise Algorithmen aus, die vom Zielknoten rückwärts oder gleichzeitig in beide Richtungen suchen. Darüber hinaus müssen die von diesem Theorem erfassten Algorithmen zulässig und nicht „informierter“ als A* sein.
- ^ Zielknoten können mehrfach übersprungen werden, wenn noch andere Knoten mit niedrigeren f- Werten vorhanden sind, da diese zu einem kürzeren Weg zum Ziel führen können.
Referenzen
- Russell , Stuart J .; Norvig, Peter (2018). Künstliche Intelligenz : Ein moderner Ansatz (4. Aufl.). Boston: Pearson. ISBN 978-0134610993OCLC 1021874142 .
- Delling , D.; Sanders, P .; Schultes, D.; Wagner, D. (2009). „Engineering Route Planning Algorithms“. Algorithmics of Large and Complex Networks: Design, Analysis, and Simulation . Lecture Notes in Computer Science. Band 5515. Springer. S. 117–139 . doi : 10.1007/978-3-642-02094-0_7 . ISBN 978-3-642-02093-3Die
- ^ Zeng, W.; Church, RL (2009). „Finding shortest paths on real road networks: the case for A*“ . International Journal of Geographical Information Science . 23 (4): 531–543 . Bibcode : 2009IJGIS..23..531Z . doi : 10.1080/13658810801949850 . S2CID 14833639 .
- Hart , P. E .; Nilsson , N. J .; Raphael, B. (1968). „Eine formale Grundlage für die heuristische Bestimmung von Pfaden mit minimalen Kosten“. IEEE Transactions on Systems Science and Cybernetics . 4 ( 2): 100–107 . Bibcode : 1968IJSSC...4..100H . doi : 10.1109 /TSSC.1968.300136 .
- ^ Doran, J. E.; Michie, D. (20.09.1966). „Experiments with the Graph Traverser program“. Proc. R. Soc. Lond. A. 294 ( 1437): 235–259 . Bibcode : 1966RSPSA.294..235D . doi : 10.1098/rspa.1966.0205 . S2CID 21698093 .
- ^ Nilsson, Nils J. (30.10.2009). Die Suche nach künstlicher Intelligenz (PDF) . Cambridge: Cambridge University Press. ISBN 9780521122931Eines der ersten Probleme, mit denen wir uns befassten ,
war die Planung einer Abfolge von „Wegpunkten“, die Shakey zur Navigation von Ort zu Ort nutzen könnte. […] Shakeys Navigationsproblem ist ein Suchproblem, ähnlich den bereits erwähnten.
- ^ Nilsson, Nils J. (30.10.2009). Die Suche nach künstlicher Intelligenz (PDF) . Cambridge: Cambridge University Press. ISBN 9780521122931Bertram
Raphael, der zu dieser Zeit die Arbeiten an Shakey leitete, bemerkte, dass ein besserer Wert für die Punktzahl die Summe der bisher zurückgelegten Strecke von der Ausgangsposition zuzüglich meiner heuristischen Schätzung der noch zu fahrenden Strecke wäre.
- ^ Edelkamp, Stefan; Jabbar, Shahid; Lluch-Lafuente, Alberto (2005). „Cost-Algebraic Heuristic Search“. Proceedings of the Twentieth National Conference on Artificial Intelligence (AAAI) (PDF) . S. 1362–1367 . ISBN 978-1-57735-236-5Die
- ^ Hart, Peter E.; Nilsson, Nils J. ; Raphael, Bertram (1972-12-01). „Korrektur zu ‚Eine formale Grundlage für die heuristische Bestimmung von Pfaden mit minimalen Kosten‘“" (PDF) . ACM SIGART Bulletin (37): 28– 29. doi : 10.1145/1056777.1056779 . S2CID 6386648 .
- ^ a b Dechter, Rina; Judea Pearl (1985). „Generalized best-first search strategies and the optimality of A*“ . Journal of the ACM . 32 (3): 505–536 . doi : 10.1145/3828.3830 . S2CID 2092415 .
- ^ Nannicini, Giacomo; Delling, Daniel; Schultes, Dominik; Liberti, Leo (2012). „Bidirektionale A*-Suche auf zeitabhängigen Straßennetzen“ (PDF) . Networks . 59 (2): 240–251 . doi : 10.1002/NET.20438 .
- Russell , Stuart J.; Norvig , Peter (2009). Künstliche Intelligenz: Ein moderner Ansatz (3. Aufl.). Boston: Pearson. S. 95. ISBN 978-0136042594Die
- ^ a b De Smith, Michael John; Goodchild, Michael F.; Longley, Paul (2007), Geospatial Analysis: A Comprehensive Guide to Principles, Techniques and Software Tools , Troubadour Publishing Ltd, S. 344, ISBN 9781905886609Die
- ^ a b Hetland, Magnus Lie (2010), Python Algorithms: Mastering Basic Algorithms in the Python Language , Apress, S. 214, ISBN 9781430232377archiviert vom Original am 15. Februar 2022Die
- ^ Martelli, Alberto (1977). „Zur Komplexität zulässiger Suchalgorithmen“. Artificial Intelligence . 8 (1): 1–13 . doi : 10.1016/0004-3702(77)90002-9 .
- ^ Felner, Ariel; Uzi Zahavi (2011). „Inkonsistente Heuristiken in Theorie und Praxis“ . Künstliche Intelligenz . 175 ( 9–10 ): 1570–1603 . doi : 10.1016/j.artint.2011.02.001 .
- ^ Zhang, Zhifu; NR Sturtevant (2009). Verwendung inkonsistenter Heuristiken bei der A*-Suche . 21. Internationale Gemeinsame Konferenz über Künstliche Intelligenz. S. 634–639 .
- ^ Pohl, Ira (1970). „Erste Ergebnisse zum Einfluss von Fehlern bei der heuristischen Suche“. Machine Intelligence 5. Edinburgh University Press: 219–236 . ISBN 978-0-85224-176-9OCLC 1067280266 .
- ^ Pearl, Judea (1984). Heuristiken: Intelligente Suchstrategien zur computergestützten Problemlösung . Addison-Wesley. ISBN 978-0-201-05594-8Die
- ^ Chen, Jingwei; Sturtevant, Nathan R. (2019). „Bedingungen zur Vermeidung von Knotenerweiterungen in beschränkter suboptimaler Suche“ . Proceedings der 28. Internationalen Gemeinsamen Konferenz über Künstliche Intelligenz . International Joint Conferences on Artificial Intelligence Organization: 1220–1226 .
- ^ Chen, Jingwei; Sturtevant, Nathan R. (18.05.2021). „Notwendige und hinreichende Bedingungen zur Vermeidung von Wiederöffnungen in der Best-First-Suboptimalsuche mit allgemeinen Begrenzungsfunktionen“ . Proceedings of the AAAI Conference on Artificial Intelligence . 35 (5): 3688–3696 . doi : 10.1609/aaai.v35i5.16485 . ISSN 2374-3468 .
- ^ Pohl, Ira (August 1973). „Die Vermeidung (relativer) Katastrophen, heuristische Kompetenz, echte dynamische Gewichtung und Rechenprobleme bei der heuristischen Problemlösung“ (PDF) . Proceedings of the Third International Joint Conference on Artificial Intelligence (IJCAI-73) . Band 3. Kalifornien, USA. S. 11–17 .
- Köll , Andreas; Hermann Kaindl (August 1992). „Ein neuer Ansatz zur dynamischen Gewichtung“ . Proceedings der Zehnten Europäischen Konferenz für Künstliche Intelligenz (ECAI-92) . Wien, Österreich: Wiley. S. 16–17 . ISBN 978-0-471-93608-4Die
- ^ Pearl, Judea; Jin H. Kim (1982). „Studien zu semi-zulässigen Heuristiken“. IEEE Transactions on Pattern Analysis and Machine Intelligence . 4 (4): 392–399 . Bibcode : 1982ITPAM...4..392P . doi : 10.1109 / TPAMI.1982.4767270 . PMID 21869053. S2CID 3176931 .
- ^ Ghallab, Malik; Dennis Allard (August 1983). „ A ε – ein effizienter heuristischer Suchalgorithmus für nahezu zulässige Lösungen“ (PDF) . Proceedings of the Eighth International Joint Conference on Artificial Intelligence (IJCAI-83) . Band 2. Karlsruhe, Deutschland. S. 789–791 . Archiviert vom Original (PDF) am 6. August 2014.
- ^ Reese, Bjørn (1999). Alpha*: Ein ε -zulässiger heuristischer Suchalgorithmus (Bericht). Institut für Produktionstechnologie, Universität Süddänemark. Archiviert vom Original am 31.01.2016 . Abgerufen am 05.11.2014 .
- Klein , Dan; Manning, Christopher D. (2003). „A*-Parsing: Schnelle exakte Viterbi-Parse-Auswahl“ (PDF) . Proceedings der Human Language Technology Conference 2003 der North American Chapter der Association for Computational Linguistics . S. 119–126 . doi : 10.3115/1073445.1073461 .
- ^ Kagan E.; Ben-Gal I. (2014). „Ein Gruppentestalgorithmus mit Online-Informationslernen“ (PDF) . IIE Transactions . 46 (2): 164–184 . doi : 10.1080/0740817X.2013.803639 . S2CID 18588494. Archiviert vom Original (PDF) am 05.11.2016 . Abgerufen am 12.02.2016 .
- ^ Ferguson, Dave; Likhachev, Maxim; Stentz, Anthony (2005). „A Guide to Heuristic-based Path Planning“ (PDF) . Proceedings of the international workshop on planning under uncertainty for autonomous systems, international conference on automated planning and scheduling (ICAPS) . S. 9–18 . Archiviert (PDF) vom Original am 29.06.2016.
- Nau , Dana S.; Kumar, Vipin; Kanal, Laveen (1984). „General branch and bound, and its relation to A* and AO*“ (PDF) . Artificial Intelligence . 23 (1): 29–58 . doi : 10.1016/0004-3702(84)90004-3 . Archiviert (PDF) vom Original am 04.10.2012.
- ^ „Varianten von A*“ . theory.stanford.edu . Abgerufen am 9. Juni 2023 .
- ^ Hansen, Eric A.; Zhou, Rong (2007). „Anytime Heuristic Search“ . Journal of Artificial Intelligence Research . 28 : 267–297 . arXiv : 1110.2737 . doi : 10.1613/jair.2096 . S2CID 9832874 .
- ^ Fareh, Raouf; Baziyad, Mohammed; Rahman, Mohammad H.; Rabie, Tamer; Bettayeb, Maamar (14.05.2019). „Untersuchung einer reduzierten Pfadplanungsstrategie für einen mobilen Roboter mit Differenzialrädern“ . Robotica . 38 (2): 235–255 . doi : 10.1017/S0263574719000572 . ISSN 0263-5747 . S2CID 181849209 .
- ^ Pijls, Wim; Post, Henk. Ein weiterer bidirektionaler Algorithmus für kürzeste Wege (PDF) (Technischer Bericht). Ökonometrisches Institut, Erasmus-Universität Rotterdam. EI 2009-10. Archiviert (PDF) vom Original am 11.06.2014.
- ^ Goldberg, Andrew V.; Harrelson, Chris; Kaplan, Haim; Werneck, Renato F. „Effiziente Algorithmen für kürzeste Wege zwischen Punkten“ (PDF) . Princeton University . Archiviert (PDF) vom Original am 18. Mai 2022.
Weiterführende Literatur
- Nilsson, NJ (1980). Grundlagen der künstlichen Intelligenz . Palo Alto, Kalifornien: Tioga Publishing Company. ISBN 978-0-935382-01-3Die
- Walsh, Toby. Die kürzeste Geschichte der KI .
Externe Links
- Eine Variante von A*, die hierarchische Pfadfindung A* (HPA*) genannt wird
- Brian Grinstead. „A*-Suchalgorithmus in JavaScript (Aktualisiert)“ . Archiviert vom Original am 15. Februar 2020. Abgerufen am 8. Februar 2021 .