
Kopienzahlvariationen ( CNV ) sind ein Phänomen, bei dem sich Abschnitte des Genoms wiederholen und die Anzahl dieser Wiederholungen zwischen Individuen variiert. [ 1 ] Kopienzahlvariationen sind eine Form der Strukturvariation : genauer gesagt handelt es sich um Duplikations- oder Deletionsereignisse , die eine beträchtliche Anzahl von Basenpaaren betreffen. [ 2 ] Ungefähr zwei Drittel des gesamten menschlichen Genoms bestehen aus Wiederholungen [ 3 ] , und 4,8–9,5 % des menschlichen Genoms lassen sich als Kopienzahlvariationen klassifizieren. [ 4 ] Bei Säugetieren spielen Kopienzahlvariationen eine wichtige Rolle bei der Entstehung der notwendigen genetischen Vielfalt in der Population sowie des Krankheitsphänotyps . [ 1 ]
Kopienzahlvariationen lassen sich generell in zwei Hauptgruppen einteilen: kurze und lange Wiederholungen. Allerdings gibt es keine klare Abgrenzung zwischen den beiden Gruppen, und die Klassifizierung hängt von der Art der untersuchten Loci ab. Kurze Wiederholungen umfassen hauptsächlich Dinukleotid- Wiederholungen (zwei sich wiederholende Nukleotide, z. B. ACACAC...) und Trinukleotid-Wiederholungen . Lange Wiederholungen umfassen Wiederholungen ganzer Gene. Diese Klassifizierung anhand der Länge der Wiederholung ist die naheliegendste, da die Länge ein wichtiger Faktor bei der Untersuchung der Mechanismen ist, die höchstwahrscheinlich zu den Wiederholungen geführt haben [ 5 ] , und somit auch deren wahrscheinliche Auswirkungen auf den Phänotyp.
Typen und Chromosomenumlagerungen
Eines der bekanntesten Beispiele für eine kurze Kopienzahlvariation ist die Trinukleotid-Repeat-Sequenz der CAG-Basenpaare im Huntingtin-Gen, das für die neurologische Erkrankung Chorea Huntington verantwortlich ist . [ 6 ] In diesem Fall führt eine Trinukleotid- Repeat-Expansion mit hoher Wahrscheinlichkeit zum Ausbruch der Chorea Huntington und zur Vererbung an die Nachkommen. [ 6 ] Die Anzahl der CAG-Repeats korreliert invers mit dem Erkrankungsalter . [ 7 ] Man geht davon aus, dass diese kurzen Repeats häufig auf Fehler in der Polymeraseaktivität während der Replikation zurückzuführen sind, darunter Polymerase-Slippage, Template-Switching und Fork-Switching, die später ausführlich erläutert werden. Die geringe Größe dieser Kopienzahlvariationen begünstigt Fehler in der Polymerase, da diese repetitiven Bereiche leicht von der Polymerase falsch erkannt werden und replizierte Bereiche erneut repliziert werden können, was zu zusätzlichen Kopien des Repeats führt. [ 8 ] Liegen diese Trinukleotid-Wiederholungen im selben Leseraster im kodierenden Bereich eines Gens, kann dies zu einer langen Kette derselben Aminosäure führen und möglicherweise Proteinaggregate in der Zelle bilden. [ 7 ] Liegen diese kurzen Wiederholungen hingegen im nicht-kodierenden Bereich des Gens, kann dies die Genexpression und -regulation beeinflussen. Eine variable Anzahl von Wiederholungen ganzer Gene ist im Genom hingegen seltener. Ein Beispiel für eine solche Wiederholung ist das Alpha-Amylase -1-Gen ( AMY1 ), das für Alpha-Amylase kodiert und eine signifikante Kopienzahlvariation zwischen verschiedenen Populationen mit unterschiedlicher Ernährung aufweist. [ 9 ] Obwohl der genaue Mechanismus, der die Erhöhung oder Verringerung der Kopienzahl des AMY1- Gens ermöglicht, noch diskutiert wird, legen einige Hypothesen nahe, dass nicht-homologe Endverknüpfung oder mikrohomologievermittelte Endverknüpfung für diese Wiederholungen ganzer Gene verantwortlich sein könnten. [ 9 ] Wiederholungen ganzer Gene haben unmittelbare Auswirkungen auf die Expression des jeweiligen Gens, und die Tatsache, dass die Kopienzahlvariation des AMY1Die Verbindung von Genen mit der Ernährung ist ein bemerkenswertes Beispiel für eine rezente evolutionäre Anpassung des Menschen. [ 9 ] Obwohl Kopienzahlvariationen im Allgemeinen in diese Gruppen eingeteilt werden, hängt die genaue Anzahl der betroffenen Basenpaare von den jeweiligen Genorten ab. Aktuell liegt die mittlere Größe einer Kopienzahlvariation, basierend auf Daten aller berichteten Kopienzahlvariationen, bei etwa 118 kb, der Median bei etwa 18 kb. [ 10 ]
Hinsichtlich der Struktur von Kopienzahlvariationen wurden in der Forschung Hotspot-Regionen im Genom identifiziert und definiert, in denen Kopienzahlvariationen viermal häufiger auftreten. [ 2 ] Diese Hotspot-Regionen enthalten lange, zu 90–100 % ähnliche Sequenzwiederholungen, sogenannte segmentale Duplikationen, die entweder tandemartig oder interspersiert vorliegen. Besonders wichtig ist, dass in diesen Hotspot-Regionen eine erhöhte Rate an chromosomalen Umlagerungen auftritt . [ 2 ] Man ging davon aus, dass diese großflächigen chromosomalen Umlagerungen sowohl normale genetische Variationen als auch genetische Erkrankungen , einschließlich Kopienzahlvariationen, verursachen. [ 1 ] Darüber hinaus sind diese Hotspots für Kopienzahlvariationen in vielen Populationen verschiedener Kontinente konsistent. Dies deutet darauf hin, dass diese Hotspots entweder unabhängig voneinander von allen Populationen erworben und über Generationen weitergegeben wurden oder dass sie in der frühen menschlichen Evolution vor der Aufspaltung der Populationen entstanden sind – letzteres erscheint wahrscheinlicher. [ 1 ] Schließlich scheinen im Genom keine räumlichen Verzerrungen hinsichtlich der Dichte der Kopienzahlvariationen aufzutreten. [ 1 ] Obwohl ursprünglich mittels Fluoreszenz-in-situ-Hybridisierung und Mikrosatellitenanalyse nachgewiesen wurde , dass Kopienzahlvariationen in hochrepetitiven Regionen wie Telomeren , Zentromeren und Heterochromatin lokalisiert sind , [ 11 ] kamen neuere genomweite Studien zu einem anderen Ergebnis. [ 2 ] Die subtelomeren und perizentromeren Regionen sind die Orte, an denen die meisten Hotspots für chromosomale Umlagerungen zu finden sind, und es gibt dort keine signifikante Zunahme von Kopienzahlvariationen. [ 2 ] Darüber hinaus weisen diese Hotspots für chromosomale Umlagerungen keine verringerte Genanzahl auf, was wiederum darauf hindeutet, dass die räumliche Verteilung von Kopienzahlvariationen im Genom nur geringfügig beeinflusst wird. [ 2 ]
Erkennung und Identifizierung
Ursprünglich ging man aufgrund zytogenetischer Beobachtungen davon aus, dass Kopienzahlvariationen einen extrem kleinen und vernachlässigbaren Anteil des Genoms ausmachen . [ 12 ] Kopienzahlvariationen wurden im Allgemeinen nur mit kleinen Tandemwiederholungen oder spezifischen genetischen Erkrankungen in Verbindung gebracht. [ 13 ] Daher wurden Kopienzahlvariationen zunächst nur in Bezug auf spezifische Loci untersucht. Technologische Entwicklungen führten jedoch zu einer zunehmenden Anzahl hochpräziser Methoden zur Identifizierung und Untersuchung von Kopienzahlvariationen. Kopienzahlvariationen wurden ursprünglich mithilfe zytogenetischer Techniken untersucht, die es ermöglichen, die physikalische Struktur des Chromosoms zu beobachten. [ 12 ] Eine dieser Techniken ist die Fluoreszenz-in-situ-Hybridisierung (FISH), bei der fluoreszierende Sonden in das Genom eingeführt werden, die für die Bindung eine hohe Komplementarität benötigen . [ 10 ] Auch die vergleichende genomische Hybridisierung wurde häufig zur Detektion von Kopienzahlvariationen eingesetzt, indem Fluorophore visualisiert und anschließend die Länge der Chromosomen verglichen wurde. [ 10 ]
Jüngste Fortschritte in der Genomik haben zahlreiche wichtige Methoden mit extrem hoher genomischer Auflösung hervorgebracht, wodurch eine zunehmende Anzahl von Kopienzahlvariationen im Genom beschrieben wurde. [ 10 ] Anfänglich basierten diese Fortschritte auf der Verwendung von BAC-Arrays ( Bacterial Artificial Chromosome ) mit Intervallen von etwa einer Megabase über das gesamte Gen hinweg. [ 14 ] BACs können auch Kopienzahlvariationen in Rearrangement-Hotspots detektieren und ermöglichten so die Entdeckung von 119 neuen Kopienzahlvariationen. [ 2 ] Die Hochdurchsatz-Genomsequenzierung hat die Humangenomik revolutioniert, und es wurden In-silico- Studien zur Detektion von Kopienzahlvariationen im Genom durchgeführt. [ 2 ] Referenzsequenzen wurden mithilfe von Fosmiden mit anderen relevanten Sequenzen verglichen, wobei die Fosmid-Klone streng auf 40 kb begrenzt wurden. [ 15 ] Sequenzierungsend-Reads liefern ausreichende Informationen, um die Referenzsequenz mit der Zielsequenz abzugleichen. Fehlausrichtungen sind leicht erkennbar und werden daher als Kopienzahlvariationen innerhalb dieses Klonbereichs interpretiert. [ 15 ] Diese Detektionsmethode bietet eine hohe genomische Auflösung und präzise Lokalisierung der Repeats im Genom und kann auch andere Arten von Strukturvariationen wie Inversionen nachweisen. [ 10 ]
Eine weitere Möglichkeit zur Detektion von Kopienzahlvariationen besteht in der Verwendung von Einzelnukleotid-Polymorphismen (SNPs) [ 10 ] . Aufgrund der Fülle an humanen SNP-Daten hat sich der Fokus der Detektion von Kopienzahlvariationen hin zur Nutzung dieser SNPs verlagert [ 16 ] . Da menschliche Rekombination relativ selten ist und viele Rekombinationsereignisse in spezifischen Genomregionen, sogenannten Rekombinations-Hotspots, auftreten, kann die Kopplungsungleichgewichtsanalyse zur Identifizierung von Kopienzahlvariationen genutzt werden [ 16 ] . Es wurden Anstrengungen unternommen, Kopienzahlvariationen mit spezifischen Haplotyp -SNPs durch Analyse des Kopplungsungleichgewichts zu assoziieren. Mithilfe dieser Assoziationen lassen sich Kopienzahlvariationen im Genom anhand von SNPs als Marker erkennen. Next-Generation-Sequenzierungstechniken , einschließlich Kurz- und Langsequenzierung, werden heutzutage zunehmend eingesetzt und haben begonnen, Array-basierte Techniken zur Detektion von Kopienzahlvariationen zu ersetzen [ 17 ] [ 18 ] .
Molekularer Mechanismus
Es gibt zwei Haupttypen molekularer Mechanismen für die Entstehung von Kopienzahlvariationen: homologe und nicht-homologe. [ 5 ] Obwohl zahlreiche Vorschläge unterbreitet wurden, beruhen die meisten dieser Theorien auf Spekulationen und Vermutungen. Es gibt keinen eindeutigen Beweis, der eine spezifische Kopienzahlvariation mit einem bestimmten Mechanismus in Verbindung bringt.

Eine der anerkanntesten Theorien zur Entstehung von Kopienzahlvariationen sowie Deletionen und Inversionen ist die nicht-allelische homologe Rekombination . [ 19 ] Während der meiotischen Rekombination paaren sich homologe Chromosomen und bilden an beiden Enden Doppelstrangbrüche, die zu Holliday-Strukturen führen . Bei einem aberranten Mechanismus sind die Doppelstrangbrüche während der Bildung der Holliday-Strukturen jedoch falsch ausgerichtet, und das Crossing- over erfolgt an nicht-allelischen Positionen auf demselben Chromosom. Nach Auflösung der Holliday-Struktur ermöglicht das ungleiche Crossing-over den Transfer von genetischem Material zwischen den beiden homologen Chromosomen, wodurch ein Teil der DNA auf beiden Chromosomen dupliziert wird. [ 19 ] Da die duplizierten Bereiche nicht mehr unabhängig voneinander segregieren , wird der duplizierte Chromosomenbereich vererbt. Ein weiterer Mechanismus der homologen Rekombination, der zu Kopienzahlvariationen führen kann, ist die bruchinduzierte Replikation. [ 20 ] Tritt unerwartet ein Doppelstrangbruch im Genom auf, aktiviert die Zelle Reparaturwege. [ 20 ] Fehler bei der Reparatur können, ähnlich wie bei der nicht-allelischen homologen Rekombination, zu einer Erhöhung der Kopienzahl eines bestimmten Genomabschnitts führen. Während der Reparatur eines Doppelstrangbruchs kann das Bruchende in das homologe Chromosom eindringen, anstatt sich wieder mit dem ursprünglichen Strang zu verbinden. [ 20 ] Wie bei der nicht-allelischen homologen Rekombination wird eine zusätzliche Kopie eines bestimmten Abschnitts auf ein anderes Chromosom übertragen, was zu einer Duplikation führt. Kohäsinproteine unterstützen das Reparatursystem von Doppelstrangbrüchen, indem sie die beiden Enden in enger Nachbarschaft fixieren und so ein Eindringen der Enden in andere Chromosomen verhindern. [ 21 ] Wenn aus irgendeinem Grund, wie beispielsweise der Aktivierung ribosomaler RNA , die Kohäsinaktivität beeinträchtigt ist, kann es lokal zu einer Zunahme von Reparaturfehlern bei Doppelstrangbrüchen kommen. [ 21 ]
Die andere Klasse möglicher Mechanismen, die zu Kopienzahlvariationen führen können, basiert auf nicht-homologen Reparaturmechanismen. Um diese von homologen Mechanismen zu unterscheiden, muss man das Konzept der Homologie verstehen. Bei der homologen Paarung von Chromosomen werden DNA-Stränge verwendet, die einander sehr ähnlich sind (~97 %). Diese Stränge müssen eine bestimmte Länge überschreiten, um kurze, aber sehr ähnliche Paarungen zu vermeiden. [ 5 ] Nicht-homologe Paarungen hingegen basieren auf nur wenigen übereinstimmenden Basenpaaren zwischen zwei Strängen. Daher ist es möglich, dass genetisches Material bei nicht-homologen Reparaturmechanismen für Doppelstränge ausgetauscht oder dupliziert wird. [ 5 ]
Ein nicht-homologer Reparaturmechanismus ist die nicht-homologe Endverknüpfung (NHEJ) oder Mikrohomologie-Endverknüpfung (MHEJ ). [ 22 ] Diese Mechanismen sind auch an der Reparatur von Doppelstrangbrüchen beteiligt, benötigen aber keine oder nur geringe Mikrohomologie. [ 5 ] Bei der Reparatur dieser Stränge entstehen häufig kleine Deletionen oder Insertionen im reparierten Strang. Es ist möglich, dass Retrotransposons über dieses Reparatursystem in das Genom eingefügt werden. [ 22 ] Werden Retrotransposons an einer nicht-allelischen Position auf dem Chromosom eingefügt, kann die meiotische Rekombination dazu führen, dass die Insertion in denselben Strang wie eine bereits vorhandene Kopie derselben Region rekombiniert wird. Ein weiterer Mechanismus ist der Bruch-Fusions-Brücken-Zyklus, an dem Schwesterchromatiden beteiligt sind , die aufgrund von Doppelstrangbrüchen ihre telomere Region verloren haben. [ 23 ] Es wird angenommen, dass diese Schwesterchromatiden zu einem dizentrischen Chromosom fusionieren und sich anschließend in zwei verschiedene Zellkerne verteilen. [ 23 ] Da das Auseinanderziehen des dizentrischen Chromosoms einen Doppelstrangbruch verursacht, können die Endregionen mit anderen Doppelstrangbrüchen fusionieren und den Zyklus wiederholen. [ 23 ] Die Fusion zweier Schwesterchromatiden kann zu einer invertierten Duplikation führen. Wiederholen sich diese Ereignisse im Verlauf des Zyklus, wird die invertierte Region dupliziert, was zu einer Erhöhung der Kopienzahl führt. [ 23 ] Der letzte Mechanismus, der zu Variationen der Kopienzahl führen kann, ist das Polymerase-Slippage, auch bekannt als Template-Switching. [ 24 ] Während der normalen DNA-Replikation muss die Polymerase am Folgestrang die Replikationsregion kontinuierlich lösen und wieder anbinden. [ 24 ] Sind bereits kleine Wiederholungen in der DNA-Sequenz vorhanden, kann die Polymerase beim erneuten Anbinden zur Fortsetzung der Replikation „verwirrt“ werden. Anstatt an den korrekten Basenpaaren zu binden, verschiebt sie möglicherweise einige Basenpaare und repliziert einen Teil der wiederholten Region erneut. [ 24 ]Es ist anzumerken, dass dieser Mechanismus zwar experimentell beobachtet wurde und allgemein anerkannt ist, die zugrundeliegenden molekularen Wechselwirkungen jedoch weiterhin unbekannt sind. Da dieser Mechanismus zudem voraussetzt, dass die Polymerase innerhalb des DNA-Strangs springt und es unwahrscheinlich ist, dass sie sich an einer anderen Stelle, einige Kilobasen entfernt, erneut anlagern kann, ist er eher auf kurze Wiederholungen wie Dinukleotid- oder Trinukleotid-Wiederholungen anwendbar. [ 25 ]
Alpha-Amylase-Gen

Amylase ist ein Enzym im Speichel, das Stärke in Monosaccharide spaltet . Eine Amylaseart wird durch das Alpha-Amylase-Gen ( AMY1 ) kodiert. [ 9 ] Der AMY1- Locus und das zugehörige Amylase-Enzym gehören zu den am besten untersuchten und sequenzierten Genen des menschlichen Genoms. Homologe dieser Gene finden sich auch bei anderen Primaten. Daher ist es wahrscheinlich, dass das primaten AMY1 -Gen ein Vorfahre des menschlichen AMY1 -Gens ist und sich früh in der Primatenevolution angepasst hat. [ 9 ] AMY1 ist eines der am besten untersuchten Gene mit einer stark variierenden Kopienzahl in verschiedenen menschlichen Populationen. [ 9 ] Das AMY1 -Gen ist zudem eines der wenigen Gene, bei denen überzeugende Belege für einen Zusammenhang zwischen seiner Proteinfunktion und seiner Kopienzahl vorliegen. [ 9 ] Es ist bekannt, dass die Kopienzahl sowohl die Transkription als auch die Translation eines bestimmten Gens beeinflusst. Untersuchungen haben jedoch gezeigt, dass der Zusammenhang zwischen Proteinspiegel und Kopienzahl variabel ist. [ 26 ] Bei den AMY1- Genen von Europäischstämmigen Amerikanern wurde festgestellt, dass die Konzentration der Speichelamylase eng mit der Kopienzahl des AMY1 -Gens korreliert. [ 9 ] Daher wurde die Hypothese aufgestellt, dass die Kopienzahl des AMY1- Gens eng mit seiner Proteinfunktion, der Stärkeverdauung, zusammenhängt. [ 9 ]
Es wurde festgestellt, dass die Kopienzahl des AMY1 -Gens mit dem Stärkegehalt in der Ernährung verschiedener Bevölkerungsgruppen korreliert. [ 9 ] Acht Bevölkerungsgruppen verschiedener Kontinente wurden in Gruppen mit stärkereicher und stärkearmer Ernährung eingeteilt, und ihre AMY1- Genkopienzahl wurde mittels hochauflösender FISH und qPCR visualisiert . [ 9 ] Dabei zeigte sich, dass die Bevölkerungsgruppen mit stärkereicher Ernährung – darunter Japaner, Hadza und Europäisch-Amerikaner – eine signifikant höhere (doppelt so hohe) durchschnittliche AMY1 -Kopienzahl aufwiesen als die Bevölkerungsgruppen mit stärkearmer Ernährung, darunter Biaka, Mbuti, Datog und Jakuten. [ 9 ] Es wurde die Hypothese aufgestellt, dass der Stärkegehalt in der täglichen Ernährung, dem Substrat für AMY1, die Kopienzahl des AMY1 -Gens direkt beeinflussen kann. [ 9 ] Da festgestellt wurde, dass die Kopienzahl von AMY1 direkt mit der Speichelamylase korreliert, [ 9 ] ist es evolutionär günstiger, mehrere Kopien des AMY1 -Gens zu besitzen, je mehr Stärke in der täglichen Ernährung einer Bevölkerung vorhanden ist. Das AMY1 -Gen war das erste Gen, das starke Belege für die Evolution auf molekulargenetischer Ebene lieferte . [ 26 ] Mithilfe der vergleichenden genomischen Hybridisierung wurden zudem die Kopienzahlvariationen des gesamten Genoms der japanischen Bevölkerung mit denen der jakutischen Bevölkerung verglichen. [ 9 ] Dabei zeigte sich, dass sich die Kopienzahlvariation des AMY1 -Gens signifikant von der Kopienzahlvariation anderer Gene oder Genombereiche unterschied. Dies deutet darauf hin, dass das AMY1 -Gen einem starken Selektionsdruck unterlag, der die anderen Kopienzahlvariationen kaum oder gar nicht beeinflusste. [ 9 ] Abschließend wurde die Längenvariabilität von 783 Mikrosatelliten zwischen den beiden Populationen mit der Kopienzahlvariabilität des AMY1- Gens verglichen. Es wurde festgestellt, dass die Kopienzahl des AMY1 -Gens größer war als die von über 97 % der untersuchten Mikrosatelliten. [ 9 ] Dies deutet darauf hin, dass die natürliche Selektion eine bedeutende Rolle bei der Ausprägung der durchschnittlichen Anzahl von AMY1 -Genen in diesen beiden Populationen spielte . [ 9 ]Da jedoch nur sechs Populationen untersucht wurden, ist es wichtig, die Möglichkeit in Betracht zu ziehen, dass es neben Stärke auch andere Faktoren in ihrer Ernährung oder Kultur geben könnte, die die AMY1- Kopienzahl beeinflusst haben.
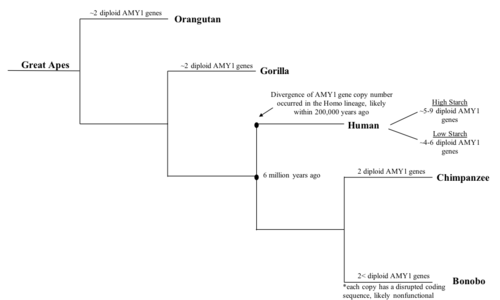
Obwohl der Zeitpunkt des Anstiegs der AMY1 -Genkopienzahl unklar ist, ist bekannt und bestätigt, dass das AMY1 -Gen bereits bei frühen Primaten existierte. Schimpansen , die nächsten evolutionären Verwandten des Menschen, besitzen zwei diploide Kopien des AMY1 -Gens, die in ihrer Länge mit dem menschlichen AMY1-Gen identisch sind [ 9 ] , jedoch deutlich weniger als beim Menschen. Bonobos hingegen , ebenfalls enge Verwandte des modernen Menschen, weisen mehr als zwei diploide Kopien des AMY1 -Gens auf [ 9 ] . Die Sequenzierung und Analyse der Bonobo -AMY1- Gene ergab, dass die kodierenden Sequenzen der AMY1 -Gene unterbrochen sind, was zur Produktion einer dysfunktionalen Speichelamylase führen kann [ 9 ] . Aus den Ergebnissen lässt sich schließen, dass der Anstieg der AMY1- Kopienzahl bei Bonobos wahrscheinlich nicht mit dem Stärkegehalt ihrer Nahrung korreliert. Es wurde weiterhin die Hypothese aufgestellt, dass der Anstieg der Kopienzahl erst vor Kurzem in der frühen Homininen -Evolution begann, da keiner der Menschenaffen mehr als zwei Kopien des AMY1 -Gens besaß, das für das funktionsfähige Protein kodiert. [ 9 ] Zudem wurde spekuliert, dass der Anstieg der AMY1 -Kopienzahl vor etwa 20.000 Jahren begann, als der Mensch vom Jäger- und Sammlerdasein zu Ackerbaugesellschaften überging und sich in dieser Zeit verstärkt stärkehaltiges Wurzelgemüse aß. [ 9 ] Diese Hypothese ist zwar logisch, jedoch fehlen experimentelle Belege, da es schwierig ist, Informationen über die Veränderungen der menschlichen Ernährung zu sammeln, insbesondere über stärkehaltiges Wurzelgemüse, da dieses nicht direkt beobachtet oder untersucht werden kann. Jüngste Fortschritte in der DNA-Sequenzierung haben es Forschern ermöglicht, ältere DNA, wie beispielsweise die von Neandertalern, mit einer gewissen Genauigkeit zu sequenzieren. Die Sequenzierung der Neandertaler-DNA könnte einen zeitlichen Marker für den Anstieg der AMY1 -Genkopienzahl liefern und Einblicke in die menschliche Ernährung und die Genentwicklung ermöglichen.
Derzeit ist der Mechanismus der ursprünglichen Duplikation des Amylase-Gens unbekannt. Es wird vermutet, dass die Insertion der retroviralen Sequenzen durch nicht-homologe Endverknüpfung erfolgte, was zur Duplikation des AMY1 -Gens führte. [ 27 ] Allerdings gibt es aktuell keine Belege für diese Theorie, weshalb diese Hypothese spekulativ bleibt. Die erst kürzlich erfolgte Entstehung des mehrfach vorhandenen AMY1 -Gens deutet darauf hin, dass die Kopienzahl des AMY1 -Gens je nach Umweltbedingungen im Vergleich zu Genen, die nicht so direkt mit der Umwelt interagieren, sehr schnell ansteigen und abfallen kann. [ 26 ] Das AMY1 -Gen ist ein hervorragendes Beispiel dafür, wie die Gen-Dosierung das Überleben eines Organismus in einer bestimmten Umwelt beeinflusst. Die zahlreichen Kopien des AMY1 -Gens verschaffen Organismen, die sich hauptsächlich von stärkereichen Lebensmitteln ernähren, einen evolutionären Vorteil, weshalb die hohe Genkopienzahl in der Population erhalten bleibt. [ 26 ]
Gehirnzellen
Unter den Neuronen des menschlichen Gehirns sind somatisch bedingte Kopienzahlvariationen häufig. [ 28 ] Diese Kopienzahlvariationen weisen eine große Variabilität auf (9 bis 100 % der Gehirnneuronen in verschiedenen Studien). Die meisten Veränderungen sind zwischen 2 und 10 Mb groß, wobei Deletionen Amplifikationen weit übertreffen. [ 28 ]
Genomische Duplikation und Triplikation des Gens scheinen eine seltene Ursache der Parkinson-Krankheit zu sein , obwohl sie häufiger vorkommen als Punktmutationen . [ 29 ]
Kopienzahlvarianten im RCL1 -Gen sind mit einer Reihe neuropsychiatrischer Phänotypen bei Kindern assoziiert. [ 30 ]
Genfamilien und natürliche Selektion

Kürzlich wurde die Verbindung zwischen Kopienzahlvariationen und Genfamilien diskutiert . Genfamilien sind definiert als Gruppen verwandter Gene mit ähnlichen Funktionen, die sich jedoch zeitlich oder räumlich geringfügig unterscheiden und wahrscheinlich von einem gemeinsamen Vorläufergen abstammen . [ 26 ] Der Hauptgrund für die Verbindung von Kopienzahlvariationen mit Genfamilien liegt in der Möglichkeit, dass Gene einer Familie von einem gemeinsamen Vorläufergen abstammen, das in verschiedene Kopien dupliziert wurde. [ 26 ] Mutationen akkumulieren sich im Laufe der Zeit in den Genen. Durch die natürliche Selektion führen manche Mutationen zu Umweltvorteilen, wodurch diese Gene vererbt werden und sich schließlich eindeutige Genfamilien herausbilden. Ein Beispiel für eine Genfamilie, die möglicherweise durch Kopienzahlvariationen entstanden ist, ist die Globin -Genfamilie. Diese bildet ein komplexes Netzwerk von Genen, bestehend aus Alpha- und Beta- Globin-Genen, einschließlich Genen, die sowohl in Embryonen als auch in Erwachsenen exprimiert werden, sowie Pseudogenen . [ 31 ] Diese Globingene der Globinfamilie sind alle hochkonserviert und unterscheiden sich nur in einem kleinen Abschnitt des Gens, was darauf hindeutet, dass sie von einem gemeinsamen Vorläufergen abstammen, möglicherweise durch Duplikation des ursprünglichen Globingens. [ 31 ]
Untersuchungen haben gezeigt, dass Kopienzahlvariationen deutlich häufiger in Genen auftreten, die Proteine kodieren, welche direkt mit der Umwelt interagieren, als in Genen, die Proteine kodieren, welche an grundlegenden Zellfunktionen beteiligt sind. [ 32 ] Es wurde vermutet, dass der mit Kopienzahlvariationen einhergehende Gen-Dosierungseffekt zu schädlichen Auswirkungen führen kann, wenn essentielle Zellfunktionen gestört werden. Daher unterliegen Proteine, die an zellulären Signalwegen beteiligt sind, einer starken reinigenden Selektion . [ 32 ] Da Proteine zudem zusammenwirken und mit Proteinen anderer Signalwege interagieren, ist es wichtig, die Auswirkungen der natürlichen Selektion auf biomolekulare Signalwege und nicht auf einzelne Proteine zu betrachten. In diesem Zusammenhang wurde festgestellt, dass Proteine am Rand eines Signalwegs vermehrt Kopienzahlvariationen aufweisen, während Proteine im Zentrum des Signalwegs verarmt sind. [ 33 ] Dies wurde damit erklärt, dass Proteine am Rand des Signalwegs mit weniger Proteinen interagieren und daher eine durch eine Änderung der Kopienzahl bedingte Änderung der Protein-Dosierung einen geringeren Einfluss auf das Gesamtergebnis des zellulären Signalwegs haben kann. [ 33 ]
Siehe auch
- CaSNP , eine Datenbank
- Vergleichende Genomik
- Kopienzahlanalyse
- Menschliches Genom
- Inparanoid
- Molekulare Evolution
- Pseudogene
- Segmentale Duplikation
- Tandem-Exon-Duplikation
- Virtueller Karyotyp
Referenzen
- ^ a b c d e McCarroll SA, Altshuler DM (Juli 2007). „Copy-number variation and association studies of human disease“. Nature Genetics . 39 (7 Suppl): S37-42. doi : 10.1038/ng2080 . PMID 17597780. S2CID 8521333 .
- Sharp AJ , Locke DP, McGrath SD, Cheng Z, Bailey JA, Vallente RU et al. (Juli 2005). „ Segmentale Duplikationen und Kopienzahlvariationen im menschlichen Genom“ . American Journal of Human Genetics . 77 ( 1): 78–88 . doi : 10.1086 / 431652 . PMC 1226196. PMID 15918152 .
- ^ de Koning AP, Gu W, Castoe TA, Batzer MA, Pollock DD (Dezember 2011). „Repetitive Elemente könnten über zwei Drittel des menschlichen Genoms ausmachen“ . PLOS Genetics . 7 (12) e1002384. doi : 10.1371/journal.pgen.1002384 . PMC 3228813. PMID 22144907 .
- ^ Zarrei M, MacDonald JR, Merico D, Scherer SW (März 2015). „Eine Karte der Kopienzahlvariationen des menschlichen Genoms“. Nature Reviews Genetics . 16 (3): 172–83 . doi : 10.1038/nrg3871 . hdl : 2027.42/146425 . PMID 25645873. S2CID 19697843 .
- Hastings PJ, Lupski JR, Rosenberg SM, Ira G (August 2009). „ Mechanismen der Veränderung der Genkopienzahl“ . Nature Reviews Genetics . 10 (8): 551–64 . doi : 10.1038/ nrg2593 . PMC 2864001. PMID 19597530 .
- ^ a b „Ein neuartiges Gen mit einer Trinukleotid-Wiederholung, die auf Huntington-Chromosomen expandiert und instabil ist. Die Huntington's Disease Collaborative Research Group“ (PDF) . Cell . 72 (6): 971–83 . März 1993. doi : 10.1016/0092-8674(93)90585-e . hdl : 2027.42/30901 . PMID 8458085. S2CID 802885 .
- ^ a b Myers RH (April 2004). „Genetik der Huntington-Krankheit“ . NeuroRx . 1 (2): 255–62 . doi : 10.1602 / neurorx.1.2.255 . PMC 534940. PMID 15717026 .
- ^ Albertini AM, Hofer M, Calos MP, Miller JH (Juni 1982). „Zur Entstehung spontaner Deletionen: Die Bedeutung kurzer Sequenzhomologien für die Entstehung großer Deletionen“. Cell . 29 ( 2): 319–28 . doi : 10.1016/0092-8674(82)90148-9 . PMID 6288254. S2CID 36657944 .
- Perry GH, Dominy NJ, Claw KG, Lee AS, Fiegler H, Redon R, et al. ( Oktober 2007 ) . „ Diet and the evolution of human amylase gene copy number variation “ . Nature Genetics . 39 ( 10 ) : 1256–60 . doi : 10.1038 / ng2123 . PMC 2377015. PMID 17828263 .
- Freeman JL, Perry GH, Feuk L, Redon R , McCarroll SA , Altshuler DM, et al. (August 2006). „ Copy number variation: new insights in genome diversity“ . Genome Research . 16 (8): 949–61 . doi : 10.1101 /gr.3677206 . PMID 16809666 .
- ^ Bailey JA, Gu Z, Clark RA, Reinert K, Samonte RV, Schwartz S, et al. (August 2002). „Recent segmental duplications in the human genome“. Science . 297 (5583): 1003–7 . Bibcode : 2002Sci...297.1003B . doi : 10.1126 / science.1072047 . PMID 12169732. S2CID 16501865 .
- ^ a b Jacobs PA, Browne C, Gregson N, Joyce C, White H (Februar 1992). „Schätzungen der Häufigkeit von Chromosomenaberrationen , die bei nicht selektierten Neugeborenen mittels moderater Bandenmuster nachweisbar sind“ . Journal of Medical Genetics . 29 (2): 103–8 . doi : 10.1136/jmg.29.2.103 . PMC 1015848. PMID 1613759 .
- ^ Inoue K, Lupski JR (2002). „Molekulare Mechanismen genomischer Erkrankungen“ . Annual Review of Genomics and Human Genetics . 3 : 199–242 . doi : 10.1146/annurev.genom.3.032802.120023 . PMID 12142364 .
- ^ Iafrate AJ, Feuk L, Rivera MN, Listewnik ML, Donahoe PK, Qi Y, et al. (September 2004). „Detection of large-scale variation in the human genome“ . Nature Genetics . 36 (9): 949–51 . doi : 10.1038/ng1416 . PMID 15286789 .
- ^ a b Tuzun E, Sharp AJ, Bailey JA, Kaul R, Morrison VA, Pertz LM, et al. (Juli 2005). „Feinstrukturelle Variation des menschlichen Genoms“. Nature Genetics . 37 (7): 727–32 . doi : 10.1038 / ng1562 . PMID 15895083. S2CID 14162962 .
- ^ a b Conrad B, Antonarakis SE (2007). „Genduplikation: ein Antrieb für phänotypische Diversität und Ursache menschlicher Krankheiten“. Annual Review of Genomics and Human Genetics . 8 : 17–35 . doi : 10.1146/annurev.genom.8.021307.110233 . PMID 17386002 .
- ^ Alkan C , Coe BP, Eichler EE (Mai 2011). „Entdeckung und Genotypisierung struktureller Genomvarianten“ . Nature Reviews Genetics . 12 (5): 363–76 . doi : 10.1038/nrg2958 . PMC 4108431. PMID 21358748 .
- ^ Sudmant PH, Rausch T, Gardner EJ, Handsaker RE, Abyzov A, Huddleston J, et al. (Oktober 2015). „Eine integrierte Karte der Strukturvariation in 2.504 menschlichen Genomen“ . Nature . 526 (7571): 75–81 . Bibcode : 2015Natur.526...75 . doi : 10.1038/nature15394 . PMC 4617611. PMID 26432246 .
- ^ a b Pâques F, Haber JE (Juni 1999). „Multiple pathways of recombination induced by double-strand breaks in Saccharomyces cerevisiae“ . Microbiology and Molecular Biology Reviews . 63 (2): 349–404 . doi : 10.1128/MMBR.63.2.349-404.1999 . PMC 98970. PMID 10357855 .
- ^ a b c Bauters M, Van Esch H, Friez MJ, Boespflug-Tanguy O, Zenker M, Vianna-Morgante AM, et al. (Juni 2008). „Nicht-rezidivierende MECP2-Duplikationen, vermittelt durch genomarchitekturbedingte DNA-Brüche und bruchinduzierte Replikationsreparatur“ . Genome Research . 18 (6): 847–58 . doi : 10.1101/gr.075903.107 . PMC 2413152. PMID 18385275 .
- ^ a b Kobayashi T, Ganley AR (September 2005). „Rekombinationsregulation durch transkriptionsinduzierte Kohäsin-Dissoziation in rDNA-Repeats“. Science . 309 ( 5740): 1581–4 . Bibcode : 2005Sci...309.1581K . doi : 10.1126/science.1116102 . PMID 16141077. S2CID 21547462 .
- ^ a b Lieber MR (Januar 2008). „Der Mechanismus der nicht-homologen DNA-Endverknüpfung beim Menschen“ . The Journal of Biological Chemistry . 283 (1): 1–5 . doi : 10.1074/jbc.R700039200 . PMID 17999957 .
- ^ a b c d McCLINTOCK B (1951). „Chromosome organization and gen expression“. Cold Spring Harbor Symposia on Quantitative Biology . 16 : 13–47 . doi : 10.1101/sqb.1951.016.01.004 . PMID 14942727 .
- ^ a b c Smith CE, Llorente B, Symington LS (Mai 2007). „Template switching during break-induced replication“. Nature . 447 ( 7140): 102–5 . Bibcode : 2007Natur.447..102S . doi : 10.1038/nature05723 . PMID 17410126. S2CID 7427921 .
- ^ Bi X, Liu LF (Januar 1994). „recA-unabhängige und recA-abhängige intramolekulare Plasmidrekombination. Unterschiedliche Homologieanforderungen und Distanzeffekt“ . Journal of Molecular Biology . 235 (2): 414–23 . doi : 10.1006/jmbi.1994.1002 . PMID 8289271 .
- Korbel JO, Kim PM, Chen X, Urban AE, Weissman S, Snyder M, Gerstein MB (Juni 2008). „ Die aktuelle Begeisterung für Kopienzahlvariationen: Ihr Zusammenhang mit Genduplikationen und Proteinfamilien“ . Current Opinion in Structural Biology . 18 (3): 366–74 . doi : 10.1016 / j.sbi.2008.02.005 . PMC 2577873. PMID 18511261 .
- ^ Samuelson LC, Wiebauer K, Snow CM, Meisler MH (Juni 1990). „Retrovirale und Pseudogen-Insertionsstellen enthüllen die Abstammung der menschlichen Speichel- und Pankreasamylasegene von einem einzigen Gen während der Primatenevolution“ . Molecular and Cellular Biology . 10 (6): 2513–2520 . doi : 10.1128/mcb.10.6.2513 . PMC 360608. PMID 1692956 .
- Rohrback S, Siddoway B, Liu CS, Chun J (November 2018). „Genomisches Mosaik im sich entwickelnden und adulten Gehirn“ . Developmental Neurobiology . 78 ( 11 ): 1026–1048 . doi : 10.1002 / dneu.22626 . PMC 6214721. PMID 30027562 .
- ^ Singleton AB, Farrer M, Johnson J, Singleton A, Hague S, Kachergus J, et al. (Oktober 2003). „Triplikation des Alpha-Synuclein-Locus verursacht die Parkinson-Krankheit“ . Science . 302 (5646): 841. doi : 10.1126/science.1090278 . PMID 14593171. S2CID 85938327 .
- ^ Brownstein, CA; Smith, RS; Rodan, LH; Gorman, Abgeordneter; Hojlo, MA; Garvey, EA; Li, J; Cabral, K; Bowen, JJ; Rao, AS; Genetti, Kalifornien; Carroll, D; Deaso, EA; Agrawal, PB; Rosenfeld, JA; Bi, W; Howe, J; Stavropoulos, DJ; Hansen, AW; Hamoda, HM; Pinard, F; Caracansi, A; Walsh, Kalifornien; D'Angelo, EJ; Beggs, AH; Zarrei, M; Gibbs, RA; Scherer, SW; Glahn, DC; Gonzalez-Heydrich, J (17. Februar 2021). „Varianten der RCL1-Kopienzahl sind mit einer Reihe neuropsychiatrischer Phänotypen verbunden . “ Molekulare Psychiatrie . 26 (5): 1706–1718 . doi : 10.1038/s41380-021-01035- y . PMC 8159744. PMID 33597717 .
- ^ a b Goodman M, Koop BF, Czelusniak J, Weiss ML (Dezember 1984). „Das β-Globin-Gen. Seine lange Evolutionsgeschichte in der β-Globin-Genfamilie der Säugetiere“. Journal of Molecular Biology . 180 (4): 803–23 . doi : 10.1016/0022-2836(84)90258-4 . PMID 6527390 .
- Redon R, Ishikawa S, Fitch KR, Feuk L, Perry GH, Andrews TD, et al. (November 2006). „ Globale Variation der Kopienzahl im menschlichen Genom“ . Nature . 444 (7118): 444–54 . Bibcode : 2006Natur.444..444R . doi : 10.1038/nature05329 . PMC 2669898. PMID 17122850 .
- ^ a b Kim PM, Korbel JO, Gerstein MB (Dezember 2007). „Positive Selektion an der Peripherie des Proteinnetzwerks: Bewertung im Hinblick auf strukturelle Beschränkungen und zellulären Kontext“ . Proceedings of the National Academy of Sciences of the United States of America . 104 (51): 20274–9 . Bibcode : 2007PNAS..10420274K . doi : 10.1073/pnas.0710183104 . PMC 2154421. PMID 18077332 .
Weiterführende Literatur
- Pollack JR, Perou CM, Alizadeh AA, Eisen MB, Pergamenschikov A, Williams CF, Jeffrey SS, Botstein D, Brown PO (September 1999). „Genomweite Analyse von DNA-Kopienzahlveränderungen mittels cDNA-Microarrays“. Nature Genetics . 23 (1): 41–46 . doi : 10.1038/12640 . PMID 10471496. S2CID 997032 .
- „Enorme genetische Variation bei gesunden Menschen“ . New Scientist. 7. August 2004.
- Carter NP (September 2004). „So normal wie normal nur sein kann?“ . Nature Genetics . 36 (9): 931–2 . doi : 10.1038/ng0904-931 . PMID 15340426 .
- Check E (Oktober 2005). „Das menschliche Genom: Ein Flickenteppich der Bevölkerung“ . Nature . 437 ( 7062): 1084–6 . Bibcode : 2005Natur.437.1084C . doi : 10.1038/4371084a . PMID 16237414. S2CID 8211641 .
- „Genduplikationen könnten definieren, wer Sie sind .“ New Scientist. 22. November 2006.
- „Genetische Karten zeigen: DNA variiert stärker von Mensch zu Mensch .“ National Geographic. 22. November 2006. Archiviert vom Original am 25. November 2006.
- „Die richtigen Linsen finden“ (PDF) . Nature Genetics. 1. Juli 2007.
- Lam HY, Mu XJ, Stütz AM, Tanzer A, Cayting PD, Snyder M et al. (Januar 2010). „Nukleotidauflösungsanalyse von Strukturvarianten mittels BreakSeq und einer Breakpoint-Bibliothek“ . Nature Biotechnology . 28 (1): 47–55 . doi : 10.1038/nbt.1600 . PMC 2951730. PMID 20037582 .
- „Neue Forschungsergebnisse werfen Licht auf die genetischen Ursachen von Autismus“ . Singularity Hub. 15. Juni 2010. Archiviert vom Original am 18. Juni 2010. Abgerufen am 15. Juni 2010 .
Externe Links
- Projekt zur Variation der Kopienzahl , Sanger-Institut
- Die Behauptung: Eineiige Zwillinge haben identische DNA
- Integrative Annotationsplattform für Kopienzahlvariationen beim Menschen
- Eine Bibliographie zur Exemplarnummernvariation
- Datenbank genomischer Varianten , eine Datenbank struktureller Varianten im menschlichen Genom
- Nachweis von Kopienzahlvariationen mittels hochauflösender SNP-Genotypisierung
- Oxford Gentechnologie
- BioDiscovery Nexus Kopiennummer
- Hochauflösende Kartierung von Kopienzahlvariationen bei 2.026 gesunden Personen
- IGSR: Die internationale Genomprobenressource
- cn.FARMS: ein latentes Variablenmodell zur Erkennung von Kopienzahlvariationen in Microarray-Daten mit niedriger Falsch-Positiv-Rate, ein R-Paket – Software
- cn.MOPS: Mischung aus Poisson-Verteilungen zur Entdeckung von Kopienzahlvariationen in Sequenzierungsdaten der nächsten Generation – Software