| Teil einer Serie über |
| Soziologie |
|---|
 |
|

Die Likert-Skala ( / ˈ l ɪ k ər t / LIK -ərt , [ 1 ] [ Anmerkung 1 ] ) ist eine psychometrische Skala, benannt nach ihrem Erfinder, dem amerikanischen Sozialpsychologen Rensis Likert [ 2 ] , die häufig in Forschungsfragebögen verwendet wird . Sie ist die am weitesten verbreitete Methode zur Skalierung von Antworten in der Umfrageforschung, sodass der Begriff (oder genauer die Likert-Skala ) oft synonym mit Bewertungsskala verwendet wird , obwohl es auch andere Arten von Bewertungsskalen gibt.
Likert unterschied zwischen einer eigentlichen Skala, die sich aus den Antworten auf eine Reihe von Items (üblicherweise acht oder mehr) ergibt, und dem Format, in dem die Antworten entlang einer Spanne bewertet werden. Genau genommen bezieht sich eine Likert-Skala nur auf Ersteres. [ 3 ] [ 4 ] Der Unterschied zwischen diesen beiden Konzepten liegt in Likerts Unterscheidung zwischen dem untersuchten Phänomen und den Mitteln zur Erfassung von Variationen, die auf dieses Phänomen hinweisen. [ 5 ]
Bei der Beantwortung einer Likert-Skala geben die Befragten ihren Grad der Zustimmung oder Ablehnung auf einer symmetrischen Zustimmungs-/Ablehnungsskala für eine Reihe von Aussagen an. Die Bandbreite erfasst somit die Intensität ihrer Gefühle zu einem bestimmten Item. [ 6 ]
Eine Skala kann als einfache Summe oder Durchschnittswert der Antworten auf die einzelnen Fragen eines Fragebogens erstellt werden. Die Likert-Skalierung setzt dabei voraus, dass die Abstände zwischen den einzelnen Antwortmöglichkeiten gleich sind. Viele Forscher verwenden eine Reihe solcher Items, die hoch korreliert sind (hohe interne Konsistenz aufweisen ) und gemeinsam den gesamten Untersuchungsbereich abdecken (was nicht perfekte Korrelationen erfordert). Andere vertreten den Standard, dass „alle Items als Replikationen voneinander oder, anders ausgedrückt, als parallele Instrumente betrachtet werden“ [ 7 : 197] . Im Gegensatz dazu berücksichtigt die moderne Testtheorie die Schwierigkeit jedes Items (die ICCs ) als Information, die in die Skalierung der Items einfließt. [ 8 ]
Zusammensetzung
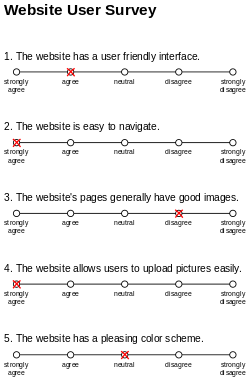
Eine Likert-Skala ist die Summe der Antworten auf mehrere Likert-Items . Da viele Likert-Skalen jedes einzelne Likert-Item mit einer eigenen visuellen Analogskala kombinieren (z. B. einer horizontalen Linie, auf der die Testperson eine Antwort durch Einkreisen oder Ankreuzen von Markierungen angibt), wird ein einzelnes Item selbst manchmal fälschlicherweise als Skala bezeichnet, was zu weit verbreiteter Verwirrung in der Literatur und im Fachjargon führt.
Ein Likert-Item ist eine Aussage, die die Befragten anhand subjektiver oder objektiver Kriterien quantitativ bewerten sollen, wobei Zustimmung/Ablehnung am häufigsten berücksichtigt wird. Gut gestaltete Likert-Items zeichnen sich durch Symmetrie und Ausgewogenheit aus. Symmetrie bedeutet, dass sie gleich viele positive und negative Werte enthalten, deren Abstände zum neutralen Wert (Null) symmetrisch sind (unabhängig davon, ob dieser Wert als Option angegeben wird). Ausgewogenheit bedeutet, dass die Abstände zwischen den einzelnen Werten gleich sind, sodass quantitative Vergleiche, wie z. B. die Mittelwertbildung, auch bei Items mit mehr als zwei Werten möglich sind. [ 9 ]
Die Likert-Skala besteht typischerweise aus fünf oder sieben Stufen. Die fünfstufige Skala ist:
- Ich stimme überhaupt nicht zu
- Verschiedener Meinung sein
- Unsicher
- Zustimmen
- Stimme voll und ganz zu
Eine siebenstufige Likert-Skala ergänzt die Kategorien „stimme eher zu“ und „stimme eher nicht zu“.
Die Likert-Skala ist eine bipolare Skalierungsmethode , die positive oder negative Reaktionen auf eine Aussage misst. Manchmal wird eine Skala mit geraden Antwortmöglichkeiten verwendet, bei der die mittlere Option „weder zustimmen noch ablehnen“ fehlt. Diese Methode wird mitunter als „ erzwungene Wahl “ bezeichnet, da die neutrale Option ausgeschlossen ist. [ 10 ] Die neutrale Option kann als einfache Wahlmöglichkeit bei Unsicherheit angesehen werden, weshalb ihre tatsächliche Neutralität fraglich ist. Eine Studie aus dem Jahr 1987 fand vernachlässigbare Unterschiede zwischen der Verwendung von „unentschlossen“ und „neutral“ als mittlere Option in einer fünfstufigen Likert-Skala. [ 11 ]
Likert-Skalen können aus verschiedenen Gründen verzerrt sein. Befragte können:
- Vermeiden Sie extreme Antwortkategorien ( Tendenz zur Mitte ), insbesondere aus dem Wunsch heraus, nicht als extremistisch wahrgenommen zu werden (ein Beispiel für soziale Erwünschtheit ). Dieser Effekt kann bereits früh im Test auftreten, da erwartet wird, dass Fragen folgen, zu denen die Testperson eine stärkere Meinung hat. Daher lässt man sich bei früheren Fragen „Spielraum“ für spätere, aussagekräftigere Antworten. Diese Erwartungshaltung erzeugt eine Verzerrung, die besonders schädlich ist, da ihre Auswirkungen nicht einheitlich im gesamten Test auftreten und nicht durch eine einfache, pauschale Normalisierung korrigiert werden können.
- Sie stimmen Aussagen so zu, wie sie präsentiert werden ( Akquieszenz-Tendenz ), beispielsweise indem sie sowohl Aussage A als auch deren Gegenteil zustimmen. Dieser Effekt ist besonders stark bei Kindern, Menschen mit Entwicklungsstörungen, älteren Menschen und Personen, die einer Institutionalisierungskultur ausgesetzt sind, die den Eifer, es allen recht zu machen, fördert und belohnt;
- Aus defensiver Absicht, falsche Aussagen zu vermeiden und/oder negative Konsequenzen zu vermeiden, die die Befragten befürchten, wenn ihre Antworten gegen sie verwendet werden, insbesondere wenn sie falsch interpretiert und/oder aus dem Kontext gerissen werden;
- Antworten geben, von denen sie glauben, dass sie als Zeichen von Stärke oder Fehlen von Schwäche/Funktionsstörungen („Gutsein vortäuschen“) bewertet werden;
- Geben Sie Antworten, von denen sie glauben, dass sie als Hinweis auf Schwäche oder das Vorliegen einer Beeinträchtigung/Pathologie bewertet werden („Vortäuschen von Schwäche“);
- Versuchen Sie, sich selbst oder Ihre Organisation in einem Licht darzustellen, von dem Sie glauben, dass der Prüfer oder die Gesellschaft es als günstiger empfinden als ihre wahren Überzeugungen ( Verzerrung durch soziale Erwünschtheit , die intersubjektive Version des oben besprochenen objektiven „Gutsein vortäuschen“);
- Versuchen Sie, sich selbst oder Ihre Organisation in einem Licht darzustellen, von dem sie glauben, dass der Prüfer oder die Gesellschaft es als weniger günstig/ungünstiger empfinden als ihre wahren Überzeugungen ( Normenverweigerung , die intersubjektive Version des oben besprochenen objektiven "Schlechtes vortäuschen".
Durch die Gestaltung einer Skala mit ausgewogener Kennzeichnung (eine gleiche Anzahl positiver und negativer Aussagen und insbesondere eine gleiche Anzahl positiver und negativer Aussagen zu jeder Position oder jedem Thema) lässt sich das Problem der Zustimmungstendenz umgehen, da die Zustimmung bei positiv gekennzeichneten Items die Zustimmung bei negativ gekennzeichneten Items ausgleicht. Defensive Verzerrungen, Verzerrungen aufgrund der Tendenz zur Mitte und Verzerrungen aufgrund sozialer Erwünschtheit sind hingegen etwas problematischer.
Bewertung und Analyse
Nach dem Ausfüllen des Fragebogens kann jeder Punkt einzeln analysiert oder, in manchen Fällen, die Antworten auf einzelne Punkte summiert werden, um einen Gesamtwert für eine Gruppe von Punkten zu ermitteln. Daher werden Likert-Skalen oft auch als summative Skalen bezeichnet.
Ob einzelne Likert-Items als Intervallskalendaten oder als ordinale Daten zu behandeln sind, ist in der Literatur Gegenstand erheblicher Uneinigkeit [ 12 , 13 ] , wobei starke Überzeugungen hinsichtlich der jeweils geeignetsten Methoden bestehen. Diese Uneinigkeit lässt sich in vielerlei Hinsicht darauf zurückführen, inwieweit Likert-Items als Ordinaldaten interpretiert werden .
Zwei Hauptaspekte leiten die Diskussion. Erstens sind Likert-Skalen willkürlich. Der Wert eines Likert-Items hat keine objektive numerische Grundlage, weder im Sinne der Messtheorie noch der Skala (aus der sich ein Distanzmaß ableiten ließe). Der Wert jedes Likert-Items wird schlichtweg vom Forschenden bei der Konzeption der Umfrage festgelegt, basierend auf dem gewünschten Detaillierungsgrad. Üblicherweise werden Likert-Items jedoch progressive positive ganzzahlige Werte zugewiesen. Likert-Skalen reichen typischerweise von 2 bis 10 – wobei 3, 5 oder 7 am häufigsten vorkommen. [ 14 ] Darüber hinaus ist die progressive Struktur der Skala so beschaffen, dass jedes nachfolgende Likert-Item als „bessere“ Antwort als der vorhergehende Wert interpretiert wird. Dies kann sich ändern, wenn eine umgekehrte Reihenfolge der Likert-Skala erforderlich ist.
Der zweite, möglicherweise wichtigere Punkt betrifft die Frage, ob der Abstand zwischen den einzelnen Kategorien gleich groß ist. Dies wird üblicherweise impliziert oder angenommen. Beispielsweise wird bei der oben genannten fünfstufigen Likert-Skala angenommen, dass der Abstand zwischen Kategorie 1 und 2 dem zwischen Kategorie 3 und 4 entspricht. Aus wissenschaftlicher Sicht ist eine äquidistante Darstellung der Kategorien durch die Forschenden wichtig; andernfalls kann es zu Verzerrungen in der Analyse kommen. So ist es beispielsweise unwahrscheinlich, dass bei einer vierstufigen Likert-Skala mit den Kategorien „Schlecht“, „Durchschnittlich“, „Gut“ und „Sehr gut“ alle Kategorien äquidistant sind, da nur eine Kategorie eine unterdurchschnittliche Bewertung erhalten kann. Dies würde die Ergebnisse möglicherweise zugunsten eines positiven Ergebnisses verfälschen. Andererseits kann es durchaus vorkommen, dass Befragte die Kategorien anders interpretieren, selbst wenn Forschende diese als äquidistant darstellen.
Eine gute Likert-Skala, wie oben beschrieben, zeichnet sich durch eine Symmetrie der Kategorien um einen Mittelpunkt und klar definierte sprachliche Merkmale aus. Bei einer solchen symmetrischen Skalierung lassen sich äquidistante Merkmale typischerweise besser beobachten oder zumindest erschließen. Ist eine Likert-Skala symmetrisch und äquidistant, verhält sie sich eher wie eine Intervallskala. Obwohl eine Likert-Skala also ordinal ist , kann sie bei guter Darstellung dennoch eine Intervallskala annähern. Dies kann von Vorteil sein, da bei einer rein ordinalen Betrachtung wertvolle Informationen verloren gehen könnten, wenn der Abstand zwischen den Likert-Items nicht berücksichtigt wird. Entscheidend ist hierbei, dass die geeignete Analysemethode von der Darstellung der Likert-Skala abhängt.
Die Validität solcher Messungen hängt von der zugrunde liegenden Intervallskala ab. Bei einem Vergleich zweier Gruppen ist der t -Test für abhängige Stichproben nicht ungeeignet, wenn Intervallskala angenommen wird. [ 4 ] Sollen nichtparametrische Tests durchgeführt werden, empfiehlt sich die Pratt-Modifikation (1959) [ 15 ] des Wilcoxon-Vorzeichenrangtests gegenüber dem Standard- Wilcoxon-Vorzeichenrangtest . [ 4 ]
Die Antworten auf mehrere Likert-Fragen können summiert werden, sofern alle Fragen dieselbe Likert-Skala verwenden und diese eine plausible Annäherung an eine Intervallskala darstellt. In diesem Fall erlaubt der zentrale Grenzwertsatz die Behandlung der Daten als Intervallskalendaten , die eine latente Variable messen. Erfüllen die summierten Antworten diese Voraussetzungen, können parametrische statistische Tests wie die Varianzanalyse angewendet werden. Üblicherweise gelten mindestens vier, vorzugsweise acht Items in der Summe als akzeptabel für diese Annäherung. [ 5 ] [ 13 ]
Um binäre Likert-Antworten direkt zu modellieren, können sie in Binomialform dargestellt werden , indem die Antworten „Zustimmung“ und „Ablehnung“ separat summiert werden. Der Chi-Quadrat- Test , der Cochran-Q-Test oder der McNemar-Test sind gängige statistische Verfahren, die nach dieser Transformation angewendet werden. Nichtparametrische Tests wie der Chi-Quadrat-Test , der Mann-Whitney-Test , der Wilcoxon-Vorzeichenrangtest oder der Kruskal-Wallis-Test werden häufig zur Analyse von Likert-Skalen-Daten verwendet. [ 16 ]
Alternativ können Likert-Skalen-Antworten mit einem geordneten Probit- Modell analysiert werden , wodurch die Reihenfolge der Antworten erhalten bleibt, ohne dass eine Intervallskala angenommen werden muss. Die Verwendung eines geordneten Probit-Modells kann Fehler vermeiden, die auftreten, wenn geordnete Bewertungen als Intervallskalenmessungen behandelt werden. [ 17 ] Konsensbasierte Beurteilung (CBA) kann verwendet werden, um einen objektiven Standard für Likert-Skalen in Bereichen zu schaffen, in denen kein allgemein anerkannter oder objektiver Standard existiert. Konsensbasierte Beurteilung (CBA) kann verwendet werden, um allgemein anerkannte Standards zu verfeinern oder sogar zu validieren.
Latentvariablenmodelle
Eine gängige Praxis bei der Analyse von Antworten auf Sammlungen von Likert-Skalen-Items besteht darin, diese über ein latentes Variablenmodell zusammenzufassen , beispielsweise durch Verwendung einer Faktorenanalyse oder der Item-Response-Theorie .
Rasch-Modell
Daten der Likert-Skala können prinzipiell als Grundlage für die Schätzung von Intervallskalenwerten auf einem Kontinuum dienen, indem das polytome Rasch-Modell angewendet wird , sofern geeignete Daten vorliegen. Darüber hinaus ermöglicht das polytome Rasch-Modell die Überprüfung der Hypothese , dass die Aussagen, wie beabsichtigt, zunehmende Ausprägungen einer Einstellung oder eines Merkmals widerspiegeln. Beispielsweise zeigt die Anwendung des Modells häufig, dass die neutrale Kategorie keine Ausprägung zwischen den Kategorien „Stimme nicht zu“ und „Stimme zu“ repräsentiert.
Nicht alle Likert-skalierten Items eignen sich für die Rasch-Messung. Die Daten müssen sorgfältig geprüft werden, um die strengen formalen Axiome des Modells zu erfüllen. Die Rohwerte sind jedoch die hinreichende statistische Grundlage für die Rasch-Maße – eine bewusste Entscheidung von Georg Rasch . Wenn Sie also die Rohwerte als gültig akzeptieren, können Sie auch die Rasch-Maße als gültig ansehen.
Visuelle Darstellung von Likert-Daten
Ein wichtiger Bestandteil der Datenanalyse und -präsentation ist die Visualisierung (oder grafische Darstellung) der Daten. Die grafische Darstellung von Likert-Skalen-Daten (und anderen Bewertungsskalen) wird in zwei Artikeln von Robbins und Heiberger ausführlich behandelt. [ 18 ] [ 19 ]
In ihrer ersten Arbeit empfehlen Robbins und Heiberger die Verwendung sogenannter divergierender gestapelter Balkendiagramme und vergleichen diese mit anderen Darstellungsformen. [ 18 ]
Die zweite Arbeit beschreibt die Verwendung der Likert-Funktion im HH-Paket für R und liefert zahlreiche Anwendungsbeispiele. [ 19 ]
Eine weitere Arbeit von Koo und Yang enthält ebenfalls Python- Code, der zeigt, wie man ein gruppiertes, divergierendes gestapeltes Balkendiagramm für Antworten auf einer 5-stufigen Likert-Skala erstellt. [ 20 ]
Messniveau
Die fünf Antwortkategorien werden häufig als Intervallskala interpretiert . Dies trifft jedoch nur zu, wenn die Abstände zwischen den Skalenpunkten empirischen Beobachtungen im metrischen Sinne entsprechen. Reips und Funke (2008) [ 21 ] zeigen, dass dieses Kriterium durch eine visuelle Analogskala deutlich besser erfüllt wird . Tatsächlich können auch Phänomene auftreten, die das Niveau einer Ordinalskala bei Likert-Skalen infrage stellen [ 22 ] . Beispielsweise können in einer Gruppe von Items A , B und C , die mit einer Likert-Skala bewertet werden, zirkuläre Beziehungen wie A > B , B > C und C > A auftreten. Dies verletzt das Transitivitätsaxiom der Ordinalskala.
Untersuchungen von Labovitz [ 23 ] und Traylor [ 24 ] belegen, dass Likert-Skalen selbst bei erheblichen Verzerrungen der wahrgenommenen Abstände zwischen Skalenpunkten ähnlich wie Skalen mit gleich großen Intervallen funktionieren. Daher sind diese und andere scheinbar gleich große Skalen in Fragebögen robust gegenüber Verletzungen der Annahme gleicher Abstände, die nach Ansicht vieler Forscher für parametrische statistische Verfahren und Tests erforderlich ist.
Aussprache
Rensis Likert , der Entwickler der Skala, sprach seinen Namen / ˈlɪkərt / LIK - ərt aus [ 25 ] [ 26 ] , was phonetisch wie „LICK-ert“ klingt , im Gegensatz zur häufigeren Fehlpronunziation „LIKE-ert“ [ 27 ] . Manche behaupten, Likerts Name gehöre zu den am häufigsten falsch ausgesprochenen Namen auf diesem Gebiet [ 28 ] , da viele den Namen der Skala als / ˈlaɪkərt / LY - kərt aussprechen . [ 27 ]
Siehe auch
- Borg-Skala – Skala der wahrgenommenen Anstrengung
- Bogardus-Skala zur sozialen Distanzierung – Skala zur Messung der Bereitschaft einer Person, mit verschiedenen Personengruppen in Kontakt zu treten.
- Diamant der Gegensätze – Handlungstyp, der in Psychodrama-Gruppen verwendet wird
- Discan-Skala – Skala und Methode in der klinischen Psychologie
- K-Faktor – Standardisiertes psychometrisches Messinstrument für Psychopathologie und Persönlichkeit
- Guttman-Skala – Einzelne, ordinale psychometrische Skala
- Ipsativ – Attribut einer Bewertungsskala in Umfragen
- Mokken-Skala
- Satzvervollständigungsskalen – Psychometrische Skala zur Verwendung in Fragebögen
- Fragebogen – Eine Reihe von Fragen zur Informationssammlung
- Fragebogenerstellung – Entwicklung eines Fragebogens zur Erhebung statistisch aussagekräftiger Informationen zu einem bestimmten Thema
- Bewertungsskala – Art der Informationsmessskala
- Bewertungsportale – Websites, die es Nutzern ermöglichen, Personen, Inhalte oder andere Dinge zu bewerten.
- Rosenberg-Selbstwertskala – Selbstbeurteilungsfragebogen
- Satisficing – Kognitive Heuristik zur Suche nach einer akzeptablen Entscheidung
- Semantisches Differential – Empirische Methode in der Linguistik
- Thurstone-Skala – Erste formale Methode zur Messung einer Einstellung
- Wahlsystem – Methode, mit der Wähler eine Wahl zwischen Optionen treffen
Anmerkungen
- ^ Wird häufig falsch ausgesprochen als / ˈ l aɪ k ər t / LY -kərt
Referenzen
- ^ Wuensch, Karl L. (4. Oktober 2005). „Was ist eine Likert-Skala? Und wie spricht man ‚Likert‘ aus?“" . East Carolina University. Archiviert vom Original am 21. Juli 2024 . Abgerufen am 16. Dezember 2023 ."
- ^ Likert, Rensis (1932). „Eine Technik zur Messung von Einstellungen“. Archives of Psychology . 140 : 1–55 .
- ^ Spector, Paul E (1992). Summated Rating Scale Construction . Sage .
- ^ a b c Derrick, B; White, P (2017). „Vergleich zweier Stichproben einer einzelnen Likert-Frage“. International Journal of Mathematics and Statistics . 18 (3): 1– 13.
- ^ a b Carifio, James; Perla, Rocco (2007). „Zehn häufige Missverständnisse, Fehlvorstellungen, hartnäckige Mythen und Legenden über Likert-Skalen und Likert-Antwortformate und ihre Gegenmittel“. Journal of Social Sciences . 3 (3): 106–116 . doi : 10.3844/jssp.2007.106.116 .
- ^ Burns, Alvin; Burns, Ronald (2008). Grundlagen der Marktforschung (2. Aufl.). New Jersey: Pearson Education. 245 Seiten . ISBN 978-0-13-205958-9Die
- ^ van Alphen, A.; Halfens, R.; Hasman, A.; Imbos, T. (1994). „Likert oder Rasch? Nichts ist anwendbarer als eine gute Theorie“. Journal of Advanced Nursing . 20 (1): 196–201 . doi : 10.1046/j.1365-2648.1994.20010196.x . PMID 7930122 .
- ^ Rusch, Thomas; Lowry, Paul B.; Mair, Patrick; Treiblmaier, Horst (2017). „Überwindung der Beschränkungen der klassischen Testtheorie: Entwicklung und Messung von Skalen für Informationssysteme mithilfe der Item-Response-Theorie“ (PDF) . Information & Management . 54 (2): 189–203 . doi : 10.1016/j.im.2016.06.005 .
- ^ Burns, Alvin; Burns, Ronald (2008). Grundlagen der Marktforschung (2. Aufl.). New Jersey: Pearson Education. 250 Seiten . ISBN 978-0-13-205958-9Die
- ^ Allen, Elaine; Seaman, Christopher (2007). „Likert-Skalen und Datenanalysen“ . Quality Progress . S. 64–65 .
- ^ Armstrong, Robert (1987). „Der Mittelpunkt einer fünfstufigen Likert-Skala“. Perceptual and Motor Skills . 64 (2): 359–362 . doi : 10.2466/pms.1987.64.2.359 . S2CID 145705789 .
- ^ Jamieson, Susan (2004). „Likert-Skalen: Wie man sie (miss)braucht“ (PDF) . Medical Education . 38 (12): 1217–1218 . doi : 10.1111/j.1365-2929.2004.02012.x . PMID 15566531. S2CID 42509064 .
- ^ a b Norman, Geoff (2010). „Likert-Skalen, Messniveaus und die „Gesetze“ der Statistik“. Advances in Health Sciences Education . 15 (5): 625–632 . doi : 10.1007/s10459-010-9222-y . PMID 20146096. S2CID 6566608 .
- ^ „Erklärung der Likert-Skala – mit einem interaktiven Beispiel“ . SurveyKing . Abgerufen am 13.08.2017 .
- ^ Pratt, J. (1959). „Bemerkungen zu Nullen und Bindungen im Wilcoxon-Vorzeichenrangtest“. Journal of the American Statistical Association . 54 (287): 655–667 . doi : 10.1080/01621459.1959.10501526 .
- ^ Mogey, Nora (25.03.1999). „Sie möchten also eine Likert-Skala verwenden?“ . Learning Technology Dissemination Initiative . Heriot-Watt University. Archiviert vom Original am 24.03.2009 . Abgerufen am 30.04.2009 .
- ^ Liddell, Torrin M.; Kruschke, John K. (2018). „Analyse ordinaler Daten mit metrischen Modellen: Was kann schiefgehen?“. Journal of Experimental Social Psychology . 79 : 328–348 . doi : 10.1016/j.jesp.2018.08.009 . hdl : 2022/21970 .
- ^ a b Robbins, NB; Heiberger, RM (2011). „Plotting Likert and Other Rating Scales“ (PDF) . JSM Proceedings, Section on Survey Research Methods . American Statistical Association. S. 1058–1066 .
- ^ a b Heiberger, RM; Robbins, NB (2014). „Design of Diverging Stacked Bar Charts for Likert Scales and Other Applications“ . Journal of Statistical Software . Band 57. American Statistical Association. S. 1–32 . doi : 10.18637/jss.v057.i05 . S2CID 61139330 .
- ^ Koo, M.; Yang, SW (2025). "Likert-Type Scale" . Encyclopedia . 5 (1): 18. doi : 10.3390/encyclopedia5010018 .
- ^ Reips, Ulf-Dietrich; Funke, Frederik (2008). „Intervallniveaumessung mit visuellen Analogskalen in internetbasierten Studien: VAS-Generator“ . Behavior Research Methods . 40 (3): 699–704 . doi : 10.3758/BRM.40.3.699 . PMID 18697664 .
- ^ Johanson, George A.; Gips, Crystal J. (12.–16. April 1993). Intransitivität bei Paarvergleichen: Nützliche Information oder Ärgernis? (PDF) . Jahrestagung der American Educational Research Association. Atlanta, GA.
- ^ Labovitz, S. (1967). „Einige Beobachtungen zu Messung und Statistik“. Social Forces . 46 (2): 151–160 . doi : 10.2307/2574595 . JSTOR 2574595 .
- ^ Traylor, Mark (Oktober 1983). „Ordinale und Intervallskalierung“. Journal of the Market Research Society . 25 (4): 297–303 .
- ^ Babbie, Earl R. (2005). Grundlagen der Sozialforschung . Belmont, CA: Thomson Wadsworth. S. 174. ISBN 978-0-534-63036-2Die
- ^ Meyers, Lawrence S.; Guarino, Anthony; Gamst, Glenn (2005). Angewandte multivariate Forschung: Design und Interpretation . Sage Publications. S. 20. ISBN 978-1-4129-0412-4Die
- ^ a b Kero, Patty; Lee, Daniel (2016). „Likert wird "LICK-urt" und nicht "LIE-kurt" ausgesprochen, und die Daten sind ordinal und nicht intervallskaliert . “ Journal of Applied Measurement . 17 (4): 502–509 . ISSN 1529-7713 . PMID 28009595 .
- ^ Latham, Gary P. (2006). Arbeitsmotivation: Geschichte, Theorie, Forschung und Praxis . Thousand Oaks , Kalifornien: Sage Publications. S. 15. ISBN 978-0-7619-2018-2Die
Externe Links
- Trochim, William MK (20. Oktober 2006). „Likert-Skala“ . Research Methods Knowledge Base, 2. Auflage . Abgerufen am 30. April 2009 .
- Galili, Tal (7. April 2010). „Korrelations-Streudiagrammmatrix für geordnete kategoriale Daten“ . R-Statistik-Blog . Abgerufen am 7. November 2017 .
- Uebersax, John S. Likert-Skalen: Die Verwirrung aufklären . 2006.
- Jebb, A. T., Ng, V. & Tay, L. (2021). Ein Überblick über die Fortschritte in der Entwicklung wichtiger Likert-Skalen: 1995–2019. Frontiers in Psychology , 12, 637547. https://doi.org/10.3389/fpsyg.2021.637547


