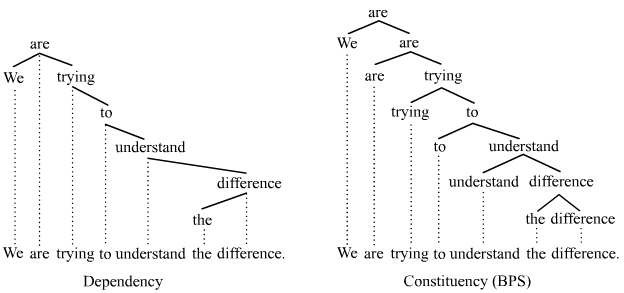
Die Operatorgrammatik ist eine mathematische Theorie der menschlichen Sprache, die erklärt, wie Sprache Information transportiert . Sie stellt den Höhepunkt des Lebenswerks von Zellig Harris dar , dessen wichtigste Veröffentlichungen gegen Ende des letzten Jahrhunderts erschienen. Die Operatorgrammatik geht davon aus, dass jede menschliche Sprache ein selbstorganisierendes System ist, in dem die syntaktischen und semantischen Eigenschaften eines Wortes ausschließlich in Bezug auf andere Wörter festgelegt werden. Daher ist kein externes System ( Metasprache ) erforderlich, um die Regeln einer Sprache zu definieren. Stattdessen werden diese Regeln durch Anwendung und aktive Teilnahme erlernt, wie es bei den meisten sozialen Verhaltensweisen der Fall ist . Die Theorie steht im Einklang mit der Vorstellung, dass sich Sprache schrittweise entwickelt hat, wobei jede nachfolgende Generation neue Komplexität und Variationen einführte.
Die Operatorgrammatik postuliert drei universelle Beschränkungen: Abhängigkeit (bestimmte Wörter sind für die Bildung einer Äußerung auf das Vorhandensein anderer Wörter angewiesen), Wahrscheinlichkeit (manche Kombinationen von Wörtern und ihren abhängigen Wörtern sind wahrscheinlicher als andere) und Reduktion (Wörter in wahrscheinlichen Kombinationen können zu kürzeren Formen reduziert und manchmal ganz weggelassen werden). Zusammen bilden diese eine Theorie der Sprachinformation : Abhängigkeit bildet eine Prädikat-Argument-Struktur ; Wahrscheinlichkeit erzeugt unterschiedliche Bedeutungen; Reduktion ermöglicht kompakte Formen für die Kommunikation.
Abhängigkeit
Der grundlegende Mechanismus der Operatorgrammatik ist die Abhängigkeitsbedingung: Bestimmte Wörter ( Operatoren ) erfordern das Vorhandensein eines oder mehrerer Wörter (Argumente) in einer Äußerung. Im Satz „John trägt Stiefel“ erfordert der Operator „ trägt“ das Vorhandensein zweier Argumente, nämlich „John“ und „Stiefel“ . (Diese Definition von Abhängigkeit unterscheidet sich von anderen Abhängigkeitsgrammatiken, in denen die Argumente von den Operatoren abhängen.)
In jeder Sprache führen die Abhängigkeitsbeziehungen zwischen Wörtern zu syntaktischen Kategorien , in denen die zulässigen Argumente eines Operators anhand ihrer Abhängigkeitsbedingungen definiert werden. Klasse N enthält Wörter, die keine anderen Wörter benötigen (z. B. John ). Klasse O N enthält Wörter, die genau ein Wort vom Typ N benötigen (z. B. stolpern ). Klasse O O enthält Wörter, die genau ein Wort vom Typ O benötigen (z. B. gutaussehend ). Klasse O NN enthält Wörter, die zwei Wörter vom Typ N benötigen (z. B. tragen ). Klasse O OO enthält Wörter, die zwei Wörter vom Typ O benötigen (z. B. weil ), wie in John stolpert, weil John Stiefel trägt . Weitere Klassen sind O ON (z . B. mit ), O NO (z. B. sagen ), O NNN (z. B. setzen ) und O NNO (z. B. fragen ).
Die Kategorien in der Operatorgrammatik sind universell und werden ausschließlich anhand der Beziehungen zwischen Wörtern definiert; sie basieren nicht auf einem externen Kategoriensystem wie Substantiv, Verb, Adjektiv, Adverb , Präposition, Konjunktion usw. Die Abhängigkeitseigenschaften jedes Wortes sind durch den Gebrauch beobachtbar und daher erlernbar.
Wahrscheinlichkeit
Die Abhängigkeitsbedingung erzeugt eine Struktur (Syntax), in der jedes Wort der entsprechenden Klasse als Argument für einen gegebenen Operator dienen kann. Die Wahrscheinlichkeitsbedingung schränkt diese Struktur zusätzlich ein, indem sie manche Operator-Argument-Kombinationen wahrscheinlicher macht als andere. So ist „John trägt Hüte“ wahrscheinlicher als „John trägt Schnee“ , was wiederum wahrscheinlicher ist als „John trägt Urlaub“ . Die Wahrscheinlichkeitsbedingung erzeugt Bedeutung (Semantik), indem sie jedes Wort anhand der Wörter definiert, die es als Argumente haben kann oder von denen es selbst als Argument dienen kann.
Jedes Wort hat eine einzigartige Menge an Wörtern, mit denen es häufig vorkommt – seine sogenannte Selektion . Die kohärente Selektion eines Wortes ist die Menge der Wörter, für die die Abhängigkeitsbeziehung überdurchschnittlich wahrscheinlich ist. Wörter mit ähnlicher Bedeutung haben eine ähnliche kohärente Selektion. Dieser Bedeutungsansatz ist selbstorganisierend, da kein externes System zur Definition der Wortbedeutung erforderlich ist. Stattdessen wird die Bedeutung eines Wortes durch seinen Gebrauch innerhalb einer Sprechergruppe bestimmt. Häufige Gebrauchsmuster sind beobachtbar und somit erlernbar. Neue Wörter können jederzeit eingeführt und durch ihren Gebrauch definiert werden.
In diesem Sinne könnte die Linkgrammatik als eine Art Operatorgrammatik betrachtet werden, da die Verknüpfung von Wörtern ausschließlich durch ihren Kontext bestimmt wird und jeder Auswahl eine Log-Likelihood zugewiesen wird.
Reduktion
Die Reduktionsbeschränkung wirkt auf Kombinationen von Operatoren und Argumenten mit hoher Wahrscheinlichkeit und führt zu kompakteren Formen. Bestimmte Reduktionen erlauben das vollständige Weglassen von Wörtern in einer Äußerung. Beispielsweise lässt sich „ Ich erwarte, dass John kommt“ auf „Ich erwarte John“ reduzieren , da „ kommen “ unter „erwarten“ sehr wahrscheinlich ist . Der Satz „John trägt Stiefel und John trägt Hüte“ kann auf „John trägt Stiefel und Hüte“ reduziert werden, da die Wiederholung des ersten Arguments „John“ unter dem Operator „ und “ sehr wahrscheinlich ist. „John liest Dinge“ kann auf „John liest“ reduziert werden , da das Argument „ Dinge“ unter jedem Operator mit hoher Wahrscheinlichkeit auftritt.
Bestimmte Reduktionen verkürzen Wörter und bilden so Pronomen, Suffixe und Präfixe ( Morphologie ). „John trägt Stiefel“ und „John trägt Hüte“ lassen sich zu „John trägt Stiefel“ und „er trägt Hüte“ verkürzen , wobei das Pronomen „ er “ eine Kurzform von „John“ ist . Suffixe und Präfixe entstehen durch Anhängen anderer, frei vorkommender Wörter oder deren Varianten. „John kann gemocht werden“ lässt sich zu „John ist sympathisch“ verkürzen . „John ist nachdenklich“ ist eine Kurzform von „John ist voller Nachdenklichkeit“ , und „John ist gegen den Krieg“ ist eine Kurzform von „John ist gegen den Krieg“ .
Modifikatoren sind das Ergebnis mehrerer solcher Reduktionen, aus denen Adjektive, Adverbien, Präpositionalphrasen , Nebensätze usw. entstehen.
- John trägt Stiefel; die Stiefel sind aus Leder (zwei durch ein Semikolon verbundene Sätze ) →
- John trägt Stiefel aus Leder (Reduktion eines wiederholten Substantivs zum Relativpronomen ) →
- John trägt Lederstiefel (Auslassung der wahrscheinlichen Formulierung „ die sind “) →
- John trägt Lederstiefel (Auslassung des wahrscheinlichen Operators von , Vertauschung des kurzen Attributs links vom Substantiv)
Jede Sprache verfügt über ein einzigartiges Reduktionssystem. Beispielsweise besitzen manche Sprachen Morphologie, andere nicht; manche transponieren kurze Modifikatoren, andere nicht. Jedes Wort einer Sprache ist nur an bestimmten Reduktionen beteiligt. In jedem Fall lässt sich das reduzierte Material jedoch aus dem Wissen über die Wahrscheinlichkeit der jeweiligen Operator-Argument-Kombination rekonstruieren. Die Reduktionen, an denen jedes Wort beteiligt ist, sind beobachtbar und somit erlernbar, ebenso wie die Abhängigkeits- und Wahrscheinlichkeitseigenschaften eines Wortes.
Information
Die Bedeutung von Reduktionen in der Operatorgrammatik liegt darin, dass sie Sätze mit reduzierten Formen von solchen ohne (Basissätze) unterscheiden. Alle Reduktionen sind Paraphrasen , da sie keine Information entfernen, sondern Sätze lediglich kompakter gestalten. Die Basissätze enthalten somit die gesamte Information der Sprache, und die reduzierten Sätze sind Varianten davon. Basissätze bestehen aus einfachen Wörtern ohne Modifikatoren und weitgehend ohne Affixe, z. B. „ Schnee fällt“ , „Schafe fressen Gras“ , „John weiß, dass Schafe Gras fressen“ , „dass Schafe Schnee fressen, überrascht John“ .
Jeder Operator in einem Satz trägt je nach Wahrscheinlichkeit seines Auftretens mit seinen Argumenten zur Information bei. Häufig erwartete Kombinationen haben einen geringen Informationsgehalt, seltene Kombinationen einen hohen. Der genaue Informationsgehalt eines Operators hängt von seiner Wortauswahl ab, also der Menge der Wörter, mit denen er häufig vorkommt. Die Argumente „ Stiefel“ , „Hüte“ , „Schafe“ , „Gras“ und „Schnee“ unterscheiden sich in ihrer Bedeutung je nachdem, mit welchen Operatoren sie mit hoher Wahrscheinlichkeit als erstes oder zweites Argument auftreten können. Beispielsweise ist „Schnee“ als erstes Argument von „fallen“ zu erwarten , nicht aber von „essen“ , während das Gegenteil für „Schafe“ gilt . Ebenso unterscheiden sich die Operatoren „essen“ , „verschlingen “ , „kauen“ und „schlucken“ in ihrer Bedeutung, je nachdem, welche Argumente und Operatoren sie auswählen.
Die Operatorgrammatik besagt, dass die Information eines Satzes die Summe der Beiträge jedes Arguments und Operators ist. Der Informationszuwachs, den ein Wort zu einem neuen Satz beiträgt, hängt von seiner vorherigen Verwendung ab. Neue Verwendungen wiederum erweitern oder verändern den mit einem Wort verbundenen Informationsgehalt. Da dieser Prozess auf häufigem Gebrauch beruht, sind die Bedeutungen von Wörtern über die Zeit relativ stabil, können sich aber den Bedürfnissen einer Sprachgemeinschaft anpassen.
Bibliographie
- Harris , Zellig (1982), Eine Grammatik des Englischen auf mathematischen Prinzipien , New York: John Wiley and Sons, ISBN 0-471-02958-0
{{citation}}: CS1 Wartung: Herausgeberstandort ( Link ) - Harris , Zellig (1988), Sprache und Information , New York: Columbia University Press, ISBN 0-231-06662-7
{{citation}}: CS1 Wartung: Herausgeberstandort ( Link ) - Harris , Zellig (1989), Die Form der Information in der Wissenschaft: Analyse einer immunologischen Teilsprache , Springer, ISBN 90-277-2516-0
- Harris , Zellig (1991), Eine Theorie der Sprache und Information: Ein mathematischer Ansatz , Oxford University Press, USA, ISBN 0-19-824224-7