
| Teil einer Serie über | ||||
| Netzwerkwissenschaft | ||||
|---|---|---|---|---|
| Netzwerktypen | ||||
| Diagramme | ||||
| ||||
| Modelle | ||||
| ||||
| ||||
| ||||
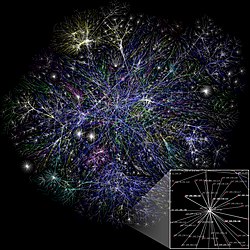
Ein skalenfreies Netzwerk ist ein Netzwerk , dessen Knotengradverteilung zumindest asymptotisch einem Potenzgesetz folgt . Das heißt, der Anteil P ( k ) der Knoten im Netzwerk, die k Verbindungen zu anderen Knoten haben, strebt für große Werte von k gegen exponentiell.

Hierbei handelt es sich um einen Parameter, dessen Wert typischerweise im Bereich liegt (wobei das zweite Moment ( Skalenparameter ) von unendlich, das erste Moment jedoch endlich ist), obwohl er gelegentlich auch außerhalb dieser Grenzen liegen kann. [ 1 ] [ 2 ] Die Bezeichnung „skalenfrei“ lässt sich dadurch erklären, dass einige Momente der Gradverteilung nicht definiert sind, sodass das Netzwerk keine charakteristische Skala oder „Größe“ aufweist.


Präferenzielle Anbindung und das Fitnessmodell wurden als Mechanismen vorgeschlagen, um die Potenzgesetz-Gradverteilungen in realen Netzwerken zu erklären. Alternative Modelle wie superlineare Präferenzielle Anbindung und Zweitnachbar-Präferenzielle Anbindung können zwar vorübergehende skalenfreie Netzwerke erzeugen, doch weicht die Gradverteilung bei sehr großen Netzwerken vom Potenzgesetz ab. [ 3 ] [ 4 ]
Geschichte
In Studien zu Zitationen zwischen wissenschaftlichen Artikeln zeigte Derek de Solla Price 1965, dass die Anzahl der Zitationen eines Artikels einer Pareto -Verteilung bzw. einem Potenzgesetz folgt . In einer späteren Arbeit von 1976 schlug Price zudem einen Mechanismus zur Erklärung des Auftretens von Potenzgesetzen in Zitationsnetzwerken vor, den er als „kumulativen Vorteil“ bezeichnete. Allerdings handelt es sich bei den untersuchten Zitationen um skalare Größen und nicht um ein grundlegendes Merkmal einer neuen Netzwerkklasse.
Das Interesse an skalenfreien Netzwerken begann 1999 mit Arbeiten von Albert-László Barabási und Réka Albert an der University of Notre Dame. Sie kartierten die Topologie eines Teils des World Wide Web [ 5 ] und stellten fest, dass einige Knoten, die sie „Hubs“ nannten, deutlich mehr Verbindungen aufwiesen als andere und dass die Anzahl der Verbindungen zu einem Knoten im gesamten Netzwerk einer Potenzgesetzverteilung folgte. In einer nachfolgenden Arbeit [ 6 ] zeigten Barabási und Albert , dass Potenzgesetze keine einzigartige Eigenschaft des WWW sind, sondern in einigen realen Netzwerken auftreten. Dies veranlasste sie, den Begriff „skalenfreies Netzwerk“ zu prägen, um die Klasse von Netzwerken mit einer Potenzgesetzverteilung des Knotengrades zu beschreiben.
Barabási und Réka Albert schlugen einen generativen Mechanismus [ 6 ] zur Erklärung des Auftretens von Potenzgesetzverteilungen vor, den sie als „ präferentielle Anbindung “ bezeichneten. Analytische Lösungen für diesen Mechanismus wurden im Jahr 2000 von Dorogovtsev, Mendes und Samukhin [ 7 ] sowie unabhängig davon von Krapivsky, Redner und Leyvraz vorgestellt und später von dem Mathematiker Béla Bollobás rigoros bewiesen . [ 8 ]
Überblick
When the concept of "scale-free" was initially introduced in the context of networks,[6] it primarily referred to a specific trait: a power-law distribution for a given variable , expressed as . This property maintains its form when subjected to a continuous scale transformation , evoking parallels with the renormalization group techniques in statistical field theory.[9][10]


However, there's a key difference. In statistical field theory, the term "scale" often pertains to system size. In the realm of networks, "scale" is a measure of connectivity, generally quantified by a node's degree—that is, the number of links attached to it. Networks featuring a higher number of high-degree nodes are deemed to have greater connectivity.
The power-law degree distribution enables us to make "scale-free" assertions about the prevalence of high-degree nodes.[11] For instance, we can say that "nodes with triple the average connectivity occur half as frequently as nodes with average connectivity". The specific numerical value of what constitutes "average connectivity" becomes irrelevant, whether it's a hundred or a million.[12]
Characteristics


The most notable characteristic in a scale-free network is the relative commonness of vertices with a degree that greatly exceeds the average. The highest-degree nodes are often called "hubs", and are thought to serve specific purposes in their networks, although this depends greatly on the domain. In a random network the maximum degree, or the expected largest hub, scales as kmax~ log N, where N is the network size, a very slow dependence. In contrast, in scale-free networks the largest hub scales as kmax~ ~N1/(γ−1) indicating that the hubs increase polynomically with the size of the network.
A key feature of scale-free networks is their high degree heterogeneity, κ= <k2>/<k>, which governs multiple network-based processes, from network robustness to epidemic spreading and network synchronization. While for a random network κ= <k> + 1, i.e. the ration is independent of the network size N, for a scale-free network we have κ~ N(3−γ)/(γ−1), increasing with the network size, indicating that for these networks the degree heterogeneity increases.
Clustering
Ein weiteres wichtiges Merkmal skalenfreier Netzwerke ist die Verteilung des Clustering-Koeffizienten , der mit steigendem Knotengrad abnimmt. Diese Verteilung folgt einem Potenzgesetz. Das bedeutet, dass Knoten mit niedrigem Grad zu sehr dichten Teilgraphen gehören, die wiederum über zentrale Knoten (Hubs) miteinander verbunden sind. Man stelle sich ein soziales Netzwerk vor, in dem die Knoten Personen und die Verbindungen Bekanntschaften zwischen Personen darstellen. Es ist leicht zu erkennen, dass Menschen dazu neigen, Gemeinschaften zu bilden, also kleine Gruppen, in denen jeder jeden kennt (eine solche Gemeinschaft kann man sich als vollständigen Graphen vorstellen ). Darüber hinaus haben die Mitglieder einer Gemeinschaft auch einige Bekanntschaften zu Personen außerhalb dieser Gemeinschaft. Manche Menschen sind jedoch mit einer Vielzahl von Gemeinschaften verbunden (z. B. Prominente, Politiker). Diese Personen können als die zentralen Knoten betrachtet werden, die für das Small-World-Phänomen verantwortlich sind .
Die spezifischen Eigenschaften skalenfreier Netzwerke variieren derzeit je nach dem verwendeten Erzeugungsmechanismus. Beispielsweise platzieren Netzwerke, die durch bevorzugte Anbindung generiert werden, typischerweise die Knoten mit hohem Grad im Zentrum und verbinden sie zu einem Kern. Knoten mit zunehmend niedrigerem Grad bilden die Bereiche zwischen Kern und Peripherie. Selbst das zufällige Entfernen eines großen Teils der Knoten beeinträchtigt die Gesamtvernetzung des Netzwerks kaum, was darauf hindeutet, dass solche Topologien für die Sicherheit nützlich sein könnten . Gezielte Angriffe hingegen zerstören die Vernetzung sehr schnell. Andere skalenfreie Netzwerke, bei denen die Knoten mit hohem Grad in der Peripherie liegen, weisen diese Eigenschaften nicht auf. Auch der Clustering-Koeffizient skalenfreier Netzwerke kann je nach anderen topologischen Details stark variieren.
Immunisierung
Die Frage, wie man skalenfreie Netzwerke, die realistische Netzwerke wie das Internet und soziale Netzwerke repräsentieren, effizient immunisieren kann, wurde eingehend untersucht. Eine Strategie besteht darin, die Knoten mit dem höchsten Grad zu immunisieren, d. h. gezielte (vorsätzliche) Angriffe durchzuführen, da in diesem Fall p relativ hoch ist und weniger Knoten immunisiert werden müssen. In vielen realistischen Fällen ist die globale Struktur jedoch nicht verfügbar und die Knoten mit dem höchsten Grad sind unbekannt.

Die Eigenschaften von Zufallsgraphen können sich unter Graphtransformationen ändern oder unverändert bleiben. Mashaghi et al. zeigten beispielsweise, dass eine Transformation, die Zufallsgraphen in ihre kantendualen Graphen (oder Liniengraphen) überführt, eine Menge von Graphen mit nahezu derselben Gradverteilung, aber mit Gradkorrelationen und einem deutlich höheren Clustering-Koeffizienten erzeugt. Skalenfreie Graphen bleiben somit unter solchen Transformationen skalenfrei. [ 13 ]
Beispiele
Beispiele für Netzwerke, die sich als skalenfrei erwiesen haben, sind:
- Einige soziale Netzwerke , darunter auch Kollaborationsnetzwerke. Zwei Beispiele, die eingehend untersucht wurden, sind die Zusammenarbeit von Filmschauspielern bei Filmen und die gemeinsame Veröffentlichung von wissenschaftlichen Artikeln durch Mathematiker .
- Viele Arten von Computernetzwerken , einschließlich des Internets , des Webgraphen des World Wide Web und der Abhängigkeitsgraphen von Softwaremodulen [ 14 ] .
- Einige Finanznetzwerke wie beispielsweise Interbanken-Zahlungsnetzwerke [ 15 ] [ 16 ]
- Protein-Protein- Interaktionsnetzwerke.
- Semantische Netze . [ 17 ]
- Fluggesellschaften.
Skalenfreie Topologie wurde auch in Hochtemperatursupraleitern gefunden. [ 18 ] Die Eigenschaften eines Hochtemperatursupraleiters – einer Verbindung, in der Elektronen den Gesetzen der Quantenphysik gehorchen und perfekt synchron und reibungsfrei fließen – scheinen mit der fraktalen Anordnung scheinbar zufälliger Sauerstoffatome und Gitterverzerrungen zusammenzuhängen. [ 19 ]
Generative Modelle
Skalenfreie Netzwerke entstehen nicht zufällig. Erdős und Rényi (1960) untersuchten ein Wachstumsmodell für Graphen, in dem in jedem Schritt zwei Knoten gleichverteilt zufällig ausgewählt und eine Verbindung zwischen ihnen eingefügt wird. Die Eigenschaften dieser Zufallsgraphen unterscheiden sich von denen skalenfreier Netzwerke, weshalb ein Modell für diesen Wachstumsprozess erforderlich ist.
Das bekannteste generative Modell für eine Teilmenge skalenfreier Netzwerke ist das „ Rich-get-richer“ -Modell von Barabási und Albert (1999). In diesem Modell erzeugt jede neue Webseite Links zu bestehenden Webseiten mit einer Wahrscheinlichkeitsverteilung, die nicht gleichmäßig, sondern proportional zum aktuellen Eingangsgrad der Webseiten ist. Demnach zieht eine Seite mit vielen eingehenden Links mehr eingehende Links an als eine Seite mit wenigen Links. Dies führt zu einem Potenzgesetz, doch der resultierende Graph unterscheidet sich vom tatsächlichen Webgraphen in anderen Eigenschaften, wie beispielsweise dem Vorhandensein kleiner, eng vernetzter Gemeinschaften. Es wurden allgemeinere Modelle und Netzwerkcharakteristika vorgeschlagen und untersucht. Pachon et al. (2018) schlugen beispielsweise eine Variante des „ Rich-get-richer“ -Modells vor, die zwei verschiedene Verknüpfungsregeln berücksichtigt: einen bevorzugten Verknüpfungsmechanismus und eine gleichmäßige Auswahl nur für die neuesten Knoten. [ 20 ] Einen Überblick bietet das Buch von Dorogovtsev und Mendes . Einige Mechanismen, wie beispielsweise die superlineare bevorzugte Anbindung und die Anbindung zweiter Nachbarn, erzeugen Netzwerke, die vorübergehend skalenfrei sind, aber mit zunehmender Netzwerkgröße von einem Potenzgesetz abweichen. [ 3 ] [ 4 ]
Pennock et al. (2002) schlugen ein etwas anderes generatives Modell für Weblinks vor. Sie untersuchten Communities mit Interessen an einem bestimmten Thema, wie beispielsweise die Homepages von Universitäten, Aktiengesellschaften, Zeitungen oder Wissenschaftlern, und schlossen die großen Knotenpunkte des Webs aus. In diesem Fall folgte die Verteilung der Links keinem Potenzgesetz mehr, sondern ähnelte einer Normalverteilung . Basierend auf diesen Beobachtungen entwickelten die Autoren ein generatives Modell, das die bevorzugte Verknüpfung mit einer Basiswahrscheinlichkeit für den Erhalt eines Links kombiniert.
Ein weiteres generatives Modell ist das von Kumar et al. [ 21 ] (2000) untersuchte Kopiermodell , bei dem neue Knoten zufällig einen bestehenden Knoten auswählen und einen Teil der Verbindungen des bestehenden Knotens kopieren. Auch dies erzeugt ein Potenzgesetz.
Es gibt zwei Hauptkomponenten, die das Auftreten der Potenzgesetzverteilung im Barabási-Albert-Modell erklären : Wachstum und bevorzugte Anbindung. [ 22 ] Mit „Wachstum“ ist ein Wachstumsprozess gemeint, bei dem sich über einen längeren Zeitraum neue Knoten einem bereits bestehenden System, einem Netzwerk (wie dem World Wide Web, das innerhalb von zehn Jahren um Milliarden von Webseiten gewachsen ist), anschließen. Mit „bevorzugter Anbindung“ ist gemeint, dass sich neue Knoten bevorzugt mit Knoten verbinden, die bereits viele Verbindungen zu anderen Knoten aufweisen. Dadurch steigt die Wahrscheinlichkeit, dass sich immer mehr Knoten mit einem Knoten verbinden, der bereits viele Verbindungen besitzt, wodurch dieser Knoten schließlich zu einem Hub wird . [ 6 ] Je nach Netzwerk können die Hubs entweder assortativ oder disassortativ sein. Assortativität findet sich in sozialen Netzwerken, in denen gut vernetzte/bekannte Personen einander tendenziell besser kennen. Disassortativität findet sich in technologischen (Internet, World Wide Web) und biologischen (Proteininteraktion, Stoffwechsel) Netzwerken. [ 22 ]
Das Wachstum von Netzwerken (Hinzufügen neuer Knoten) ist jedoch keine notwendige Bedingung für die Entstehung eines skalenfreien Netzwerks (siehe Dangalchev [ 23 ] ). Eine Möglichkeit (Caldarelli et al. 2002) besteht darin, die Struktur als statisch zu betrachten und Verbindungen zwischen Knoten anhand einer bestimmten Eigenschaft der beiden beteiligten Knoten herzustellen. Sobald die statistische Verteilung dieser Knoteneigenschaften (Fitnesswerte) festgelegt ist, zeigt sich, dass unter bestimmten Umständen auch statische Netzwerke skalenfreie Eigenschaften entwickeln.
Verallgemeinertes skalenfreies Modell
Die Modellierung skalenfreier komplexer Netzwerke hat in letzter Zeit einen regelrechten Boom erlebt . Dem Ansatz von Barabási und Albert [ 24 ] folgten zahlreiche Variationen und Verallgemeinerungen [ 25 ] [ 26 ] [ 27 ] [ 28 ] [ 20 ] sowie die Überarbeitung früherer mathematischer Arbeiten. [ 29 ]
Heutzutage wird ein komplexes Netzwerk, dessen Metriken einer Potenzgesetzverteilung folgen, allgemein als skalenfreies Netzwerk bezeichnet. Entsprechend wird jedes Modell mit dieser Eigenschaft als skalenfreies Modell bezeichnet. [ 11 ]
Merkmale
Viele reale Netzwerke sind (annähernd) skalenfrei und erfordern daher skalenfreie Modelle zu ihrer Beschreibung. In Prices Schema sind zwei Komponenten notwendig, um ein skalenfreies Modell zu erstellen:
1. Hinzufügen oder Entfernen von Knoten . Normalerweise konzentrieren wir uns auf das Wachstum des Netzwerks, d. h. auf das Hinzufügen von Knoten.
2. Preferential attachment: The probability that new nodes will be connected to the "old" node.

Note that some models (see Dangalchev[23] and Fitness model below) can work also statically, without changing the number of nodes. It should also be kept in mind that the fact that "preferential attachment" models give rise to scale-free networks does not prove that this is the mechanism underlying the evolution of real-world scale-free networks, as there might exist different mechanisms at work in real-world systems that nevertheless give rise to scaling.
Examples
There have been several attempts to generate scale-free network properties. Here are some examples:
The Barabási–Albert model
The Barabási–Albert model, an undirected version of Price's model has a linear preferential attachment and adds one new node at every time step.

(Note, another general feature of in real networks is that , i.e. there is a nonzero probability that a new node attaches to an isolated node. Thus in general has the form , where is the initial attractiveness of the node.)


Two-level network model
Dangalchev (see [23]) builds a 2-L model by considering the importance of each of the neighbours of a target node in preferential attachment. The attractiveness of a node in the 2-L model depends not only on the number of nodes linked to it but also on the number of links in each of these nodes.

where C is a coefficient between 0 and 1.
A variant of the 2-L model, the k2 model, where first and second neighbour nodes contribute equally to a target node's attractiveness, demonstrates the emergence of transient scale-free networks.[4] In the k2 model, the degree distribution appears approximately scale-free as long as the network is relatively small, but significant deviations from the scale-free regime emerge as the network grows larger. This results in the relative attractiveness of nodes with different degrees changing over time, a feature also observed in real networks.
Non-linear preferential attachment
The Barabási–Albert model assumes that the probability that a node attaches to node is proportional to the degree of node . This assumption involves two hypotheses: first, that depends on , in contrast to random graphs in which , and second, that the functional form of is linear in .


In non-linear preferential attachment, the form of is not linear, and recent studies have demonstrated that the degree distribution depends strongly on the shape of the function
Krapivsky, Redner, and Leyvraz[27] demonstrate that the scale-free nature of the network is destroyed for nonlinear preferential attachment. The only case in which the topology of the network is scale free is that in which the preferential attachment is asymptotically linear, i.e. as . In this case the rate equation leads to


This way the exponent of the degree distribution can be tuned to any value between 2 and .

Hierarchical network model
Hierarchical network models are, by design, scale free and have high clustering of nodes.[30]
The iterative construction leads to a hierarchical network. Starting from a fully connected cluster of five nodes, we create four identical replicas connecting the peripheral nodes of each cluster to the central node of the original cluster. From this, we get a network of 25 nodes (N = 25). Repeating the same process, we can create four more replicas of the original cluster – the four peripheral nodes of each one connect to the central node of the nodes created in the first step. This gives N = 125, and the process can continue indefinitely.
Fitness model
The idea is that the link between two vertices is assigned not randomly with a probability p equal for all the couple of vertices. Rather, for every vertex j there is an intrinsic fitnessxj and a link between vertex i and j is created with a probability .[31] In the case of World Trade Web it is possible to reconstruct all the properties by using as fitnesses of the country their GDP, and taking


Hyperbolic geometric graphs
Assuming that a network has an underlying hyperbolic geometry, one can use the framework of spatial networks to generate scale-free degree distributions. This heterogeneous degree distribution then simply reflects the negative curvature and metric properties of the underlying hyperbolic geometry.[33]
Edge dual transformation to generate scale free graphs with desired properties
Starting with scale free graphs with low degree correlation and clustering coefficient, one can generate new graphs with much higher degree correlations and clustering coefficients by applying edge-dual transformation.[13]
Uniform-preferential-attachment model (UPA model)
UPA model is a variant of the preferential attachment model (proposed by Pachon et al.) which takes into account two different attachment rules: a preferential attachment mechanism (with probability 1−p) that stresses the rich get richer system, and a uniform choice (with probability p) for the most recent nodes. This modification is interesting to study the robustness of the scale-free behavior of the degree distribution. It is proved analytically that the asymptotically power-law degree distribution is preserved.[20]
Scale-free ideal networks
In the context of network theory a scale-free ideal network is a random network with a degree distribution following the scale-free ideal gasdensity distribution. These networks are able to reproduce city-size distributions and electoral results by unraveling the size distribution of social groups with information theory on complex networks when a competitive cluster growth process is applied to the network.[34][35] In models of scale-free ideal networks it is possible to demonstrate that Dunbar's number is the cause of the phenomenon known as the 'six degrees of separation'.
Novel characteristics
For a scale-free network with nodes and power-law exponent , the induced subgraph constructed by vertices with degrees larger than is a scale-free network with , almost surely.[36]


The scale-free metric
On a theoretical level, refinements to the abstract definition of scale-free have been proposed. For example, Li et al. (2005) offered a potentially more precise "scale-free metric". Briefly, let G be a graph with edge set E, and denote the degree of a vertex (that is, the number of edges incident to ) by . Define


This is maximized when high-degree nodes are connected to other high-degree nodes. Now define

where smax is the maximum value of s(H) for H in the set of all graphs with degree distribution identical to that of G. This gives a metric between 0 and 1, where a graph G with small S(G) is "scale-rich", and a graph G with S(G) close to 1 is "scale-free". This definition captures the notion of self-similarity implied in the name "scale-free".
Estimating the power law exponent
Estimating the power-law exponent of a scale-free network is typically done by using the maximum likelihood estimation with the degrees of a few uniformly sampled nodes.[37] However, since uniform sampling does not obtain enough samples from the important heavy-tail of the power law degree distribution, this method can yield a large bias and a variance. It has been recently proposed to sample random friends (i.e., random ends of random links) who are more likely come from the tail of the degree distribution as a result of the friendship paradox.[38][39] Theoretically, maximum likelihood estimation with random friends lead to a smaller bias and a smaller variance compared to classical approach based on uniform sampling.[39]
Not all networks are scale-free
The widespread property of the scale-free property in social, biological and technological systems does not mean that all real networks are scale-free. Rather, several important networks do not share this property, like networks appearing in material science, describing the bonds between the atoms in crystalline or amorphous materials. In these networks each node has the same degree, determined by chemistry. Also, the neural network of the C. elegans worm and the power grid, consisting of generators and switches connected by transmission lines, have been shown to have exponential degree distributions. Further, in some real-world network's scale-free quality can be stronger or weaker. For example, social networks tend to be weakly scale-free, while some technological and biological networks can be strongly scale-free. [40]
See also
- Random graph – Graph generated by a random process
- Erdős–Rényi model – Two closely related models for generating random graphs
- Non-linear preferential attachment
- Bose–Einstein condensation (network theory) – Model in network science
- Scale invariance – Features that do not change if length or energy scales are multiplied by a common factor
- Complex network – Network with non-trivial topological features
- Webgraph – Graph of connected web pages
- Barabási–Albert model – Scale-free network generation algorithm
- Bianconi–Barabási model – Model in network science
References
- ^ Onnela, J.-P.; Saramaki, J.; Hyvonen, J.; Szabo, G.; Lazer, D.; Kaski, K.; Kertesz, J.; Barabasi, A.-L. (2007). „Struktur und Verbindungsstärken in Mobilkommunikationsnetzen“ . Proceedings of the National Academy of Sciences . 104 (18): 7332–7336 . arXiv : physics/0610104 . Bibcode : 2007PNAS..104.7332O . doi : 10.1073 / pnas.0610245104 . PMC 1863470. PMID 17456605 .
- ^ Choromański, K.; Matuszak, M.; MiȩKisz, J. (2013). „Scale-Free Graph with Preferential Attachment and Evolving Internal Vertex Structure“ . Journal of Statistical Physics . 151 (6): 1175–1183 . Bibcode : 2013JSP...151.1175C . doi : 10.1007/s10955-013-0749-1 .
- ^ a b Krapivsky, Paul; Krioukov, Dmitri (21. August 2008). „Scale-free networks as preasymptotic regimes of superlinear preferential attachment“. Physical Review E . 78 (2) 026114. arXiv : 0804.1366 . Bibcode : 2008PhRvE..78b6114K . doi : 10.1103/PhysRevE.78.026114 . PMID 18850904 . S2CID 14292535 .
- Falkenberg , Max; Lee, Jong-Hyeok; Amano, Shun-ichi; Ogawa, Ken-ichiro; Yano, Kazuo; Miyake, Yoshihiro; Evans, Tim S.; Christensen, Kim (18. Juni 2020). „ Identifying time dependence in network growth“ . Physical Review Research . 2 (2) 023352. arXiv : 2001.09118 . Bibcode : 2020PhRvR...2b3352F . doi : 10.1103/PhysRevResearch.2.023352 .
- ^ Albert, Réka; Jeong, Hawoong; Barabási, Albert-László (9. September 1999). „Durchmesser des World Wide Web“ . Natur . 401 (6749): 130– 131. arXiv : cond-mat/9907038 . doi : 10.1038/43601 . ISSN 1476-4687 .
- ^ a b c d Barabási, Albert-László ; Albert, Réka. (15. Oktober 1999). „Entstehung der Skalierung in zufälligen Netzwerken“. Wissenschaft . 286 (5439): 509–512 . arXiv : cond-mat/9910332 . Bibcode : 1999Sci...286..509B . doi : 10.1126/science.286.5439.509 . HERR 2091634 . PMID 10521342 . S2CID 524106 .
- ^ Dorogovtsev, S.; Mendes, J.; Samukhin, A. (2000). „Struktur wachsender Netzwerke mit bevorzugter Verknüpfung“. Physical Review Letters . 85 (21): 4633–4636 . arXiv : cond-mat/0004434 . Bibcode : 2000PhRvL..85.4633D . doi : 10.1103 /PhysRevLett.85.4633 . PMID 11082614. S2CID 118876189 .
- ^ Bollobás, B.; Riordan, O.; Spencer, J.; Tusnády, G. (2001). „Die Gradfolge eines skalenfreien Zufallsgraphenprozesses“. Random Structures and Algorithms . 18 (3): 279–290 . doi : 10.1002/rsa.1009 . MR 1824277. S2CID 1486779 .
- ^ Itzykson, Claude; Drouffe, Jean-Michel (1989). Statistische Feldtheorie: Band 1, Von der Brownschen Bewegung zur Renormierung und Gittereichtheorie (1. Aufl.). New York: Cambridge University Press. ISBN 978-0-521-34058-8Die
- ^ Itzykson, Claude; Drouffe, Jean-Michel (1989). Statistische Feldtheorie: Band 2, Starke Kopplung, Monte-Carlo-Methoden, Konforme Feldtheorie und Zufallssysteme (1. Aufl.). New York: Cambridge University Press. ISBN 978-0-521-37012-7Die
- ^ a b Meng, Xiangyi; Zhou, Bin (2023). „Scale-Free Networks beyond Pot-Law Degree Distribution“. Chaos, Solitons & Fractals . 176 114173. arXiv : 2310.08110 . Bibcode : 2023CSF...17614173M . doi : 10.1016/j.chaos.2023.114173 . S2CID 263909425 .
- ^ Tanaka, Reiko (2005). „Scale-Rich Metabolic Networks“. Phys. Rev. Lett . 94 (16) 168101. Bibcode : 2005PhRvL..94p8101T . doi : 10.1103/PhysRevLett.94.168101 . PMID 15904266 .
- ^ a b Ramezanpour, A.; Karimipour, V.; Mashaghi, A. (2003). „Generating correlated networks from uncorrelated ones“. Phys. Rev. E . 67 (4) 046107. arXiv : cond-mat/0212469 . Bibcode : 2003PhRvE..67d6107R . doi : 10.1103/PhysRevE.67.046107 . PMID 12786436 . S2CID 33054818 .
- ^ T. Mens (2016). „Forschungstrends in der strukturellen Softwarekomplexität“. ArXiv.abs /1608.01533. arXiv : 1608.01533 .
- ^ De Masi, Giulia; et al. (2006). „Fitnessmodell für den italienischen Interbanken-Geldmarkt“. Physical Review E. 74 ( 6) 066112. arXiv : physics/0610108 . Bibcode : 2006PhRvE..74f6112D . doi : 10.1103 / PhysRevE.74.066112 . PMID 17280126. S2CID 30814484 .
- ^ Soramäki, Kimmo; et al. (2007). „Die Topologie von Interbanken-Zahlungsströmen“. Physica A: Statistical Mechanics and Its Applications . 379 (1): 317–333 . Bibcode : 2007PhyA..379..317S . doi : 10.1016/j.physa.2006.11.093 . hdl : 10419/60649 .
- ^ Steyvers, Mark; Joshua B. Tenenbaum (2005). „Die großskalige Struktur semantischer Netzwerke: Statistische Analysen und ein Modell des semantischen Wachstums“. Cognitive Science . 29 (1): 41–78 . arXiv : cond-mat/0110012 . doi : 10.1207/s15516709cog2901_3 . PMID 21702767. S2CID 6000627 .
- ^Fratini, Michela; Poccia, Nicola; Ricci, Alessandro; Campi, Gaetano; Burghammer, Manfred; Aeppli, Gabriel; Bianconi, Antonio (2010). "Scale-free structural organization of oxygen interstitials in La2CuO4+y". Nature. 466 (7308): 841–4. arXiv:1008.2015. Bibcode:2010Natur.466..841F. doi:10.1038/nature09260. PMID 20703301. S2CID 4405620.
- ^Poccia, Nicola; Ricci, Alessandro; Campi, Gaetano; Fratini, Michela; Puri, Alessandro; Di Gioacchino, Daniele; Marcelli, Augusto; Reynolds, Michael; Burghammer, Manfred; Saini, Naurang L.; Aeppli, Gabriel; Bianconi, Antonio (2012). "Optimum inhomogeneity of local lattice distortions in La2CuO4+y". PNAS. 109 (39): 15685–15690. arXiv:1208.0101. Bibcode:2012PNAS..10915685P. doi:10.1073/pnas.1208492109. PMC 3465392. PMID 22961255.
- ^ abcPachon, Angelica; Sacerdote, Laura; Yang, Shuyi (2018). "Scale-free behavior of networks with the copresence of preferential and uniform attachment rules". Physica D: Nonlinear Phenomena. 371: 1–12. arXiv:1704.08597. Bibcode:2018PhyD..371....1P. doi:10.1016/j.physd.2018.01.005. S2CID 119320331.
- ^Kumar, Ravi; Raghavan, Prabhakar (2000). Stochastic Models for the Web Graph(PDF). Foundations of Computer Science, 41st Annual Symposium on. pp. 57–65. doi:10.1109/SFCS.2000.892065. Archived(PDF) from the original on 2016-03-03. Retrieved 2016-02-10.
- ^ abBarabási, Albert-László; Zoltán N., Oltvai. (2004). "Network biology: understanding the cell's functional organization". Nature Reviews Genetics. 5 (2): 101–113. doi:10.1038/nrg1272. PMID 14735121. S2CID 10950726.
- ^ a b c Dangalchev, Chavdar (Juli 2004). „Generationsmodelle für skalenfreie Netzwerke“ . Physica A: Statistische Mechanik und ihre Anwendungen . 338 ( 3–4 ): 659–671 . Bibcode : 2004PhyA..338..659D . doi : 10.1016/j.physa.2004.01.056 .
- ^ Barabási, A.-L. und R. Albert, Science 286 , 509 (1999).
- ^ R. Albert und AL Barabási, Phys. Rev. Lett. 85 , 5234 (2000).
- ^ SN Dorogovtsev, JFF Mendes und AN Samukhim, cond-mat/0011115.
- ^ a b P.L. Krapivsky, S. Redner und F. Leyvraz, Phys. Rev. Lett. 85 , 4629 (2000).
- ^ B. Tadic, Physica A 293 , 273(2001).
- ^ S. Bomholdt und H. Ebel, cond-mat/0008465; HA Simon, Bimetrika 42 , 425 (1955).
- ^ Ravasz, E.; Barabási (2003). „Hierarchische Organisation in komplexen Netzwerken“. Physik. Rev. E. 67 (2) 026112. arXiv : cond-mat/0206130 . Bibcode : 2003PhRvE..67b6112R . doi : 10.1103/physreve.67.026112 . PMID 12636753 . S2CID 17777155 .
- ^ Caldarelli, G.; et al. (2002). „Scale-free networks from varying vertex intrinsic fitness“ (PDF) . Phys. Rev. Lett . 89 (25) 258702. Bibcode : 2002PhRvL..89y8702C . doi : 10.1103/physrevlett.89.258702 . PMID 12484927 .
- ^ Garlaschelli, D.; et al. (2004). „Fitness-Dependent Topological Properties of the World Trade Web“. Phys. Rev. Lett . 93 (18) 188701. arXiv : cond-mat/0403051 . Bibcode : 2004PhRvL..93r8701G . doi : 10.1103 / physrevlett.93.188701 . PMID 15525215. S2CID 16367275 .
- ^ Krioukov, Dmitri; Papadopoulos, Fragkiskos; Kitsak, Maksim; Vahdat, Amin; Boguñá, Marián (2010). „Hyperbolische Geometrie komplexer Netzwerke“. Körperliche Überprüfung E . 82 (3) 036106. arXiv : 1006.5169 . Bibcode : 2010PhRvE..82c6106K . doi : 10.1103/PhysRevE.82.036106 . PMID 21230138 . S2CID 6451908 .
- ^ A. Hernando; D. Villuendas; C. Vesperinas; M. Abad; A. Plastino (2009). „Entschlüsselung der Größenverteilung sozialer Gruppen mithilfe der Informationstheorie komplexer Netzwerke“. arXiv : 0905.3704 [ physics.soc-ph ].eingereicht beim European Physical Journal B
- ^ André A. Moreira; Demétrius R. Paula; Raimundo N. Costa Filho; José S. Andrade, Jr. (2006). „Wettbewerbsfähiges Clusterwachstum in komplexen Netzwerken“. Körperliche Überprüfung E . 73 (6) 065101. arXiv : cond-mat/0603272 . Bibcode : 2006PhRvE..73f5101M . doi : 10.1103/PhysRevE.73.065101 . PMID 16906890 . S2CID 45651735 .
- ^ Heydari, H.; Taheri, SM; Kaveh, K. (2018). „Verteilte maximale unabhängige Menge auf skalenfreien Netzwerken“. arXiv : 1804.02513 [ cs.DC ].
- Clauset , Aaron; Cosma Rohilla Shalizi; ME J Newman (2009). „Potenzgesetzverteilungen in empirischen Daten“. SIAM Review . 51 (4): 661–703 . arXiv : 0706.1062 . Bibcode : 2009SIAMR..51..661C . doi : 10.1137/070710111 . S2CID 9155618 .
- ^ Eom, Young-Ho; Jo, Hang-Hyun (11.05.2015). „Tail-scope: Using friends to estimate heavy tails of degree distributions in large-scale complex networks“ . Scientific Reports . 5 (1): 9752. arXiv : 1411.6871 . Bibcode : 2015NatSR...5.9752E . doi : 10.1038/srep09752 . ISSN 2045-2322 . PMC 4426729. PMID 25959097 .
- ^ a b Nettasinghe, Buddhika; Krishnamurthy, Vikram (19.05.2021). „Maximum-Likelihood-Schätzung von Potenzgesetz-Gradverteilungen mittels Friendship-Paradox-basiertem Sampling“ . ACM Transactions on Knowledge Discovery from Data . 15 (6): 1–28 . arXiv : 1908.00310 . doi : 10.1145/3451166 . ISSN 1556-4681 .
- ^ Broido, Anna D.; Clauset, Aaron (2019). „Scale-free networks are rare“ . Nature Communications . 10 : 1017. doi : 10.1038/s41467-019-08746-5 . PMC 6399239 .
Weiterführende Literatur
- Albert R.; Barabási A.-L. (2002). „Statistische Mechanik komplexer Netzwerke“ . Rev. Mod. Phys . 74 (1): 47–97 . arXiv : cond-mat/0106096 . Bibcode : 2002RvMP...74...47A . doi : 10.1103/RevModPhys.74.47 . S2CID 60545 .
- Amaral LAN, Scala A, Barthelemy M, Stanley HE (2000). „Klassen von Small-World-Netzwerken“ . PNAS . 97 (21): 11149–52 . arXiv : cond-mat/0001458 . Bibcode : 2000PNAS ...9711149A . doi : 10.1073/pnas.200327197 . PMC 17168. PMID 11005838 .
- Barabási, Albert-László (2004). Verlinkt: Wie alles mit allem anderen verbunden ist . Perseus Pub. ISBN 0-452-28439-2Die
- Barabási, Albert-László; Bonabeau, Eric (Mai 2003). „Skalenfreie Netzwerke“ (PDF) . Wissenschaftlicher Amerikaner . 288 (5): 50– 9. Bibcode : 2003SciAm.288e..60B . doi : 10.1038/scientificamerican0503-60 . PMID 12701331 .
- Dan Braha; Yaneer Bar-Yam (2004). „Topologie großskaliger Netzwerke zur Lösung technischer Probleme“ (PDF) . Phys. Rev. E. 69 ( 1) 016113. Bibcode : 2004PhRvE..69a6113B . doi : 10.1103/ PhysRevE.69.016113 . PMID 14995673. S2CID 1001176 .
- Caldarelli G. „ Scale-Free Networks“ Oxford University Press, Oxford (2007).
- Caldarelli G.; Capocci A.; De Los Rios P.; Muñoz MA (2002). „Skalenfreie Netzwerke mit variierender intrinsischer Fitness der Knoten“. Physical Review Letters . 89 (25) 258702. arXiv : cond-mat/0207366 . Bibcode : 2002PhRvL..89y8702C . doi : 10.1103/PhysRevLett.89.258702 . PMID 12484927 .
- Dangalchev, Ch. (2004). „Generationsmodelle für skalenfreie Netzwerke“ . Physica A. 338 ( 3–4 ) : 659–671 . Bibcode : 2004PhyA..338..659D . doi : 10.1016/j.physa.2004.01.056 .
- Dorogovtsev, SN; Mendes, JFF; Samukhin, AN (2000). „Struktur wachsender Netzwerke: Exakte Lösung des Barabási-Albert-Modells“. Phys. Rev. Lett . 85 (21): 4633–6 . arXiv : cond-mat/0004434 . Bibcode : 2000PhRvL..85.4633D . doi : 10.1103 /PhysRevLett.85.4633 . PMID 11082614. S2CID 118876189 .
- Dorogovtsev, S. N.; Mendes, J. F. F. (2003). Evolution of Networks: from biological networks to the Internet and WWW . Oxford University Press. ISBN 0-19-851590-1Die
- Dorogovtsev, SN; Goltsev AV; Mendes, JFF (2008). „Kritische Phänomene in komplexen Netzwerken“. Rev. Mod. Phys . 80 (4): 1275–1335 . arXiv : 0705.0010 . Bibcode : 2008RvMP...80.1275D . doi : 10.1103/RevModPhys.80.1275 . S2CID 3174463 .
- Dorogovtsev, S.N.; Mendes, J.F.F. (2002). "Evolution of networks". Advances in Physics. 51 (4): 1079–1187. arXiv:cond-mat/0106144. Bibcode:2002AdPhy..51.1079D. doi:10.1080/00018730110112519. S2CID 429546.
- Erdős, P.; Rényi, A. (1960). On the Evolution of Random Graphs(PDF). Vol. 5. Publication of the Mathematical Institute of the Hungarian Academy of Science. pp. 17–61.
- Faloutsos, M.; Faloutsos, P.; Faloutsos, C. (1999). "On power-law relationships of the internet topology". ACM SIGCOMM Computer Communication Review. 29 (4): 251–262. doi:10.1145/316194.316229.
- Li, L.; Alderson, D.; Tanaka, R.; Doyle, J.C.; Willinger, W. (2005). "Towards a Theory of Scale-Free Graphs: Definition, Properties, and Implications (Extended Version)". arXiv:cond-mat/0501169.
- Kumar, R.; Raghavan, P.; Rajagopalan, S.; Sivakumar, D.; Tomkins, A.; Upfal, E. (2000). "Stochastic models for the web graph"(PDF). Proceedings of the 41st Annual Symposium on Foundations of Computer Science (FOCS). Redondo Beach, CA: IEEE CS Press. pp. 57–65.
- Matlis, Jan (November 4, 2002). "Scale-Free Networks".
- Newman, Mark E.J. (2003). "The structure and function of complex networks". SIAM Review. 45 (2): 167–256. arXiv:cond-mat/0303516. Bibcode:2003SIAMR..45..167N. doi:10.1137/S003614450342480. S2CID 221278130.
- Pastor-Satorras, R.; Vespignani, A. (2004). Evolution and Structure of the Internet: A Statistical Physics Approach. Cambridge University Press. ISBN 0-521-82698-5.
- Pennock, D.M.; Flake, G.W.; Lawrence, S.; Glover, E.J.; Giles, C.L. (2002). "Winners don't take all: Characterizing the competition for links on the web". PNAS. 99 (8): 5207–11. Bibcode:2002PNAS...99.5207P. doi:10.1073/pnas.032085699. PMC 122747. PMID 16578867.
- Robb, John. Scale-Free Networks and Terrorism , 2004.
- Keller, EF (2005). „Eine Neubetrachtung von „skalenfreien“ Netzwerken“ . BioEssays . 27 (10): 1060–8 . doi : 10.1002/bies.20294 . PMID 16163729 .
{{cite journal}}: CS1 maint: deprecated archival service (link) - Onody, RN; de Castro, PA (2004). „Komplexe Netzwerkstudie eines brasilianischen Fußballspielers“. Phys. Rev. E. 70 ( 3) 037103. arXiv : cond-mat/0409609 . Bibcode : 2004PhRvE..70c7103O . doi : 10.1103 /PhysRevE.70.037103 . PMID 15524675. S2CID 31653489 .
- Kasthurirathna, D.; Piraveenan, M. (2015). „Komplexe Netzwerkstudie brasilianischer Fußballspieler“. Sci. Rep . Im Druck.


