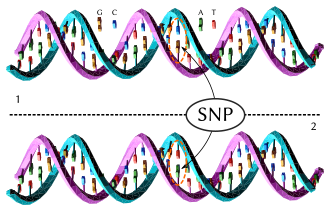
In der Genetik und Bioinformatik bezeichnet ein Einzelnukleotid-Polymorphismus ( SNP / snɪp / ; Plural SNPs / snɪps / ) eine Keimbahn- Substitution eines einzelnen Nukleotids an einer spezifischen Position im Genom . Obwohl manche Definitionen voraussetzen , dass die Substitution in einem ausreichend großen Anteil der Bevölkerung (z . B. 1 % oder mehr) vorkommt [ 1 ] , verzichten viele Publikationen [ 2 ] [ 3 ] [ 4 ] auf eine solche Häufigkeitsschwelle.
Beispielsweise kann ein G-Nukleotid, das an einer bestimmten Stelle in einem Referenzgenom vorkommt, bei einer Minderheit der Individuen durch ein A ersetzt sein . Die beiden möglichen Nukleotidvarianten dieses SNP – G oder A – werden als Allele bezeichnet . [ 5 ]
SNPs können dazu beitragen, Unterschiede in der Anfälligkeit für eine Vielzahl von Krankheiten innerhalb einer Bevölkerung zu erklären. Beispielsweise ist ein häufiger SNP im CFH -Gen mit einem erhöhten Risiko für altersbedingte Makuladegeneration assoziiert . [ 6 ] Auch Unterschiede im Schweregrad einer Erkrankung oder im Ansprechen auf Behandlungen können auf genetische Variationen zurückzuführen sein, die durch SNPs verursacht werden. So führen beispielsweise zwei häufige SNPs im APOE -Gen, rs429358 und rs7412, zu drei Haupt -APOE-Allelen mit unterschiedlichen Risiken für die Entwicklung der Alzheimer-Krankheit und unterschiedlichem Erkrankungsalter. [ 7 ]
Einzelnukleotid-Substitutionen mit einer Allelfrequenz von unter 1 % werden mitunter als Einzelnukleotidvarianten (SNPs) bezeichnet. [ 8 ] Der Begriff „Variante“ kann auch als Oberbegriff für jede einzelne Nukleotidveränderung in einer DNA-Sequenz verwendet werden [ 9 ] und umfasst sowohl häufige SNPs als auch seltene Mutationen , unabhängig davon, ob sie in der Keimbahn oder somatisch auftreten . [ 10 ] [ 11 ] Der Begriff Einzelnukleotidvariante wird daher auch für Punktmutationen in Krebszellen verwendet. [ 12 ] DNA-Varianten müssen auch häufig in molekulardiagnostischen Anwendungen berücksichtigt werden, beispielsweise bei der Entwicklung von PCR- Primern zum Nachweis von Viren, da die virale RNA- oder DNA-Probe Einzelnukleotidvarianten enthalten kann. [ 13 ] Diese Nomenklatur verwendet jedoch willkürliche Unterscheidungen (wie eine Allelfrequenz von 1 %) und wird nicht in allen Bereichen einheitlich angewendet; die daraus resultierende Uneinigkeit hat Forderungen nach einem einheitlicheren Rahmen für die Benennung von Unterschieden in DNA-Sequenzen zwischen zwei Proben laut werden lassen. [ 14 ] [ 15 ]
Typen

Einzelnukleotid- Polymorphismen (SNPs ) können in kodierenden Sequenzen von Genen , in nicht-kodierenden Bereichen von Genen oder in intergenischen Regionen (Bereichen zwischen Genen) auftreten. SNPs innerhalb einer kodierenden Sequenz verändern aufgrund der Degeneration des genetischen Codes nicht zwangsläufig die Aminosäuresequenz des produzierten Proteins . [ 16 ]
SNPs in der kodierenden Region lassen sich in zwei Typen unterteilen: synonyme und nicht-synonyme SNPs. Synonymiell wirkende SNPs haben keinen Einfluss auf die Proteinsequenz, während nicht-synonyme SNPs die Aminosäuresequenz des Proteins verändern. [ 17 ]
- SNPs in nicht-kodierenden Regionen können sich in einem erhöhten Krebsrisiko manifestieren [ 18 ] und die mRNA-Struktur sowie die Krankheitsanfälligkeit beeinflussen [ 19 ] . Nicht-kodierende SNPs können als eQTL (Expression Quantitative Trait Locus) auch die Expressionsstärke eines Gens verändern.
- SNPs in kodierenden Regionen :
- Synonymische Substitutionen führen definitionsgemäß nicht zu einer Veränderung der Aminosäure im Protein, können aber dessen Funktion auf andere Weise beeinflussen. Ein Beispiel hierfür ist eine scheinbar stumme Mutation im Multidrug-Resistenzgen 1 ( MDR1 ), das für eine zelluläre Membranpumpe kodiert, die Medikamente aus der Zelle transportiert. Diese Mutation kann die Translation verlangsamen und dazu führen, dass sich die Peptidkette in eine ungewöhnliche Konformation faltet, wodurch die mutierte Pumpe weniger funktionsfähig wird (beispielsweise verändert der Polymorphismus C1236T im MDR1-Protein das Codon GGC in GGT an Aminosäureposition 412 des Polypeptids (beide kodieren für Glycin), und der Polymorphismus C3435T verändert ATC in ATT an Position 1145 (beide kodieren für Isoleucin)). [ 20 ]
- nicht-synonyme Substitutionen :
- Missense -Mutation – eine einzelne Basenveränderung führt zu einer Veränderung der Aminosäuresequenz eines Proteins und dessen Funktionsstörung, was zu einer Krankheit führt (z. B. SNP 1580G>T im LMNA -Gen – Position 1580 (nt) in der DNA-Sequenz (CGT-Codon), wodurch Guanin durch Thymin ersetzt wird , was zum CTT-Codon in der DNA-Sequenz führt und auf Proteinebene den Austausch von Arginin durch Leucin an Position 527 zur Folge hat [ 21 ] auf Phänotypebene manifestiert sich dies in einem überlappenden mandibuloakralen Dysplasie- und Progerie-Syndrom ).
- Nonsense - Mutation – Punktmutation in einer DNA-Sequenz, die zu einem vorzeitigen Stoppcodon oder einem Nonsense-Codon in der transkribierten mRNA und zu einem verkürzten , unvollständigen und in der Regel nicht funktionsfähigen Proteinprodukt führt (z. B. Mukoviszidose, verursacht durch die G542X-Mutation im CFTR- Gen). [ 22 ]
SNPs, die nicht in proteinkodierenden Regionen liegen, können dennoch das Spleißen von Genen , die Bindung von Transkriptionsfaktoren , den Abbau von mRNA oder die Sequenz nichtkodierender RNA beeinflussen. Die durch diese Art von SNP beeinflusste Genexpression wird als eSNP (Expression SNP) bezeichnet und kann stromaufwärts oder stromabwärts des Gens liegen.
Frequenz
Im gesamten menschlichen Genom wurden in der Weltbevölkerung mehr als 600 Millionen SNPs identifiziert. [ 23 ] Ein typisches Genom unterscheidet sich vom Referenzgenom des Menschen an 4–5 Millionen Stellen, von denen die meisten (mehr als 99,9 %) aus SNPs und kurzen Indels bestehen . [ 24 ]
Innerhalb eines Genoms
Die genomische Verteilung von SNPs ist nicht homogen; SNPs treten in nicht-kodierenden Regionen häufiger auf als in kodierenden Regionen oder allgemein dort, wo die natürliche Selektion wirkt und das Allel des SNPs „fixiert“ (andere Varianten eliminiert), das die günstigste genetische Anpassung darstellt. [ 25 ] Andere Faktoren wie genetische Rekombination und Mutationsrate können die SNP-Dichte ebenfalls bestimmen. [ 26 ]
Die SNP-Dichte lässt sich anhand des Vorhandenseins von Mikrosatelliten vorhersagen : Insbesondere AT-Mikrosatelliten sind aussagekräftige Prädiktoren für die SNP-Dichte, wobei lange (AT)(n)-Wiederholungssequenzen tendenziell in Regionen mit deutlich reduzierter SNP-Dichte und niedrigem GC-Gehalt zu finden sind . [ 27 ]
Innerhalb einer Population
Da es Unterschiede zwischen menschlichen Populationen gibt, kann ein SNP-Allel, das in einer geografischen oder ethnischen Gruppe häufig vorkommt, in einer anderen seltener sein. Dieses Variationsmuster ist jedoch relativ selten; in einer globalen Stichprobe von 67,3 Millionen SNPs fand das Human Genome Diversity Project „keine derartigen Varianten, die auf einen bestimmten Kontinent oder eine bestimmte Region beschränkt sind . Die höchsten Frequenzen erreichen einige Dutzend Varianten mit >70 % (und einige Tausend mit >50 %) in Afrika, Amerika und Ozeanien. Im Gegensatz dazu erreichen die häufigsten Varianten, die nur in Europa, Ostasien, dem Nahen Osten oder Zentral- und Südasien vorkommen, lediglich 10 bis 30 %.“ [ 28 ]
Innerhalb einer Population kann SNPs eine Minor-Allelfrequenz (MAF) zugeordnet werden – die niedrigste Allelfrequenz an einem Locus , die in einer bestimmten Population beobachtet wird. [ 29 ] Dies ist einfach die niedrigere der beiden Allelfrequenzen für Einzelnukleotid-Polymorphismen.
Auf dieser Grundlage haben Wissenschaftler neue Methoden zur Analyse von Populationsstrukturen weniger erforschter Arten entwickelt. [ 30 ] [ 31 ] [ 32 ] Durch den Einsatz von Pooling-Techniken lassen sich die Analysekosten deutlich senken. [ 33 ] Diese Techniken basieren auf der Sequenzierung einer Population in einer gepoolten Probe anstatt der Sequenzierung jedes einzelnen Individuums. Mithilfe neuer bioinformatischer Werkzeuge können Populationsstruktur, Genfluss und Genmigration durch die Beobachtung der Allelfrequenzen innerhalb der gesamten Population untersucht werden. Diese Protokolle ermöglichen die Kombination der Vorteile von SNPs mit denen von Mikrosatellitenmarkern. [ 34 ] [ 35 ] Allerdings gehen dabei Informationen verloren, beispielsweise zur Kopplungsungleichgewicht und zur Zygosität.
Anwendungen
Einzelnukleotid-Polymorphismen (SNPs) dienen als aussagekräftige molekulare Marker in der modernen Genforschung und klinischen Praxis. Assoziationsstudien, insbesondere genomweite Assoziationsstudien (GWAS) , stellen die wichtigste Anwendung der SNP-Technologie zur Identifizierung genetischer Varianten dar, die mit menschlichen Krankheiten und Merkmalen in Verbindung stehen. [ 36 ] Diese umfassenden Analysen untersuchen Hunderttausende genetischer Marker gleichzeitig, um statistische Assoziationen zwischen spezifischen SNPs und phänotypischen Merkmalen aufzudecken. Dadurch können Forscher genetische Beiträge zu komplexen Erkrankungen wie Herz-Kreislauf-Erkrankungen , Diabetes und neurologischen Erkrankungen identifizieren . [ 37 ]
Die Entwicklung der Tag-SNP-Methodik hat die Effizienz genomischer Studien durch die Nutzung von Kopplungsungleichgewichtsmustern im gesamten menschlichen Genom deutlich verbessert . Tag-SNPs fungieren als repräsentative Marker, die genetische Variationen innerhalb spezifischer Chromosomenregionen erfassen und es Forschern ermöglichen, große genomische Bereiche zu untersuchen, ohne jede einzelne Variante genotypisieren zu müssen . [ 38 ] Dieser Ansatz reduziert sowohl die Kosten als auch den Rechenaufwand groß angelegter genetischer Studien und gewährleistet gleichzeitig eine ausreichende statistische Aussagekraft zum Nachweis krankheitsassoziierter Loci. Die Auswahl optimaler Tag-SNPs basiert auf komplexen Algorithmen, die Marker identifizieren, welche die maximale Menge an genetischer Information innerhalb definierter genomischer Intervalle erfassen können. [ 39 ]
Die Haplotyp- Rekonstruktion stellt eine weitere grundlegende Anwendung dar, bei der SNPs die Charakterisierung vererbter genetischer Blöcke ermöglichen. Forscher nutzen dichte SNP-Karten, um Haplotypstrukturen zu identifizieren und zu analysieren. Diese bestehen aus Gruppen eng gekoppelter Allele, die tendenziell gemeinsam über Generationen weitergegeben werden. [ 40 ] Diese Haplotypmuster liefern Einblicke in die Populationsgeschichte, demografische Ereignisse und evolutionäre Prozesse, die die heutige genetische Vielfalt geprägt haben. Das Internationale HapMap-Projekt veranschaulichte diese Anwendung durch die Erstellung umfassender Karten häufiger Haplotypmuster in verschiedenen menschlichen Populationen. [ 41 ]
Die Analyse des Kopplungsungleichgewichts bildet die theoretische Grundlage für viele SNP-basierte Anwendungen in der Populationsgenetik und der Krankheitskartierung. Dieses Phänomen beschreibt die nicht-zufällige Assoziation von Allelen an verschiedenen genomischen Positionen, die auftritt, wenn Varianten häufiger gemeinsam vererbt werden, als es rein zufällig zu erwarten wäre. [ 42 ] Das Ausmaß des Kopplungsungleichgewichts zwischen SNPs hängt primär von der physikalischen Distanz entlang der Chromosomen und den lokalen Rekombinationsraten ab , wobei näher beieinander liegende Varianten im Allgemeinen stärkere Assoziationen aufweisen. Das Verständnis dieser Muster ermöglicht es Forschern, vorherzusagen, welche SNPs redundante Informationen liefern, und die Auswahl informativer Marker für Assoziationsstudien zu steuern. [ 43 ]
In der genetischen Epidemiologie haben sich SNPs als unverzichtbare Werkzeuge zur Untersuchung von Krankheitsübertragungsmustern und Populationsstrukturen etabliert. Sequenzierungsverfahren des gesamten Genoms nutzen SNP-Variationen, um Übertragungscluster bei Ausbrüchen von Infektionskrankheiten zu identifizieren. Fälle mit ähnlichen genetischen Profilen können dabei auf miteinander verbundene Übertragungsereignisse hinweisen. [ 44 ] Diese Anwendung hat sich insbesondere für die Tuberkuloseüberwachung und die Kontaktverfolgung als wertvoll erwiesen, da traditionelle epidemiologische Methoden hier möglicherweise nicht alle Übertragungswege aufdecken. Darüber hinaus tragen SNP-basierte Analysen zum Verständnis der Populationsschichtung und der Abstammung bei, welche entscheidende Faktoren für die Gestaltung geeigneter Kontrollgruppen und die Interpretation von Assoziationsergebnissen in verschiedenen ethnischen Gruppen darstellen. [ 45 ]
Bedeutung
Variationen in den DNA-Sequenzen des Menschen können Einfluss darauf haben, wie Krankheiten entstehen und wie der Körper auf Krankheitserreger , Chemikalien , Medikamente , Impfstoffe und andere Substanzen reagiert. SNPs sind auch für die personalisierte Medizin von entscheidender Bedeutung . [ 46 ] Beispiele hierfür sind die biomedizinische Forschung, die Forensik, die Pharmakogenetik und die Erforschung von Krankheitsursachen, wie im Folgenden erläutert.
Klinische Forschung
Genomweite Assoziationsstudie (GWAS)
Einer der wichtigsten Beiträge von SNPs in der klinischen Forschung ist die genomweite Assoziationsstudie (GWAS). [ 47 ] Genomweite genetische Daten können mit verschiedenen Technologien generiert werden, darunter SNP-Arrays und die Sequenzierung des gesamten Genoms. GWAS werden häufig eingesetzt, um SNPs zu identifizieren, die mit Krankheiten, klinischen Phänotypen oder Merkmalen assoziiert sind. Da GWAS eine genomweite Analyse darstellt, ist eine große Stichprobe erforderlich, um eine ausreichende statistische Aussagekraft zum Nachweis aller möglichen Assoziationen zu erzielen. Einige SNPs haben einen relativ geringen Einfluss auf Krankheiten, klinische Phänotypen oder Merkmale. Zur Abschätzung der statistischen Aussagekraft einer Studie muss das genetische Modell der Krankheit berücksichtigt werden, z. B. dominante, rezessive oder additive Effekte. Aufgrund der genetischen Heterogenität muss die GWAS-Analyse hinsichtlich der ethnischen Zugehörigkeit adjustiert werden.
Kandidatengen-Assoziationsstudie
Die Kandidatengen-Assoziationsstudie wurde vor der Entwicklung von Hochdurchsatz-Genotypisierungs- oder Sequenzierungstechnologien häufig in der Genetik eingesetzt. [ 48 ] Ziel dieser Studie ist die Untersuchung einer begrenzten Anzahl vorab festgelegter SNPs auf Assoziationen mit Krankheiten, klinischen Phänotypen oder Merkmalen. Es handelt sich also um einen hypothesengetriebenen Ansatz. Da nur eine begrenzte Anzahl von SNPs getestet wird, reicht eine relativ kleine Stichprobengröße aus, um die Assoziation nachzuweisen. Der Kandidatengen-Assoziationsansatz wird auch häufig verwendet, um Ergebnisse von GWAS in unabhängigen Stichproben zu bestätigen.
Kartierung der Homozygotie bei Krankheiten
Genomweite SNP-Daten können für die Kartierung von Homozygotie verwendet werden. [ 49 ] Die Kartierung von Homozygotie ist eine Methode zur Identifizierung homozygoter autosomal-rezessiver Loci und stellt ein leistungsstarkes Werkzeug zur Kartierung genomischer Regionen oder Gene dar, die an der Pathogenese von Krankheiten beteiligt sind.
Methylierungsmuster

Jüngste vorläufige Ergebnisse deuten darauf hin, dass SNPs wichtige Bestandteile des epigenetischen Programms in Organismen sind. [ 50 ] [ 51 ] Kosmopolitische Studien an europäischen und südasiatischen Populationen haben zudem den Einfluss von SNPs auf die Methylierung spezifischer CpG-Stellen aufgezeigt. [ 52 ] Darüber hinaus demonstrierte die meQTL-Anreicherung mithilfe der GWAS-Datenbank, dass diese Assoziationen für die Vorhersage biologischer Merkmale von Bedeutung sind. [ 52 ] [ 53 ] [ 54 ]
Forensische Wissenschaften
SNPs wurden in der Vergangenheit verwendet, um forensische DNA-Proben mit Verdächtigen abzugleichen, sind aber durch die Weiterentwicklung STR -basierter DNA-Fingerprinting- Techniken überholt. Die Entwicklung der Next-Generation-Sequenzierung (NGS) eröffnet jedoch neue Möglichkeiten für den Einsatz von SNPs in phänotypischen Merkmalen wie Ethnizität , Haar- und Augenfarbe mit hoher Trefferwahrscheinlichkeit. Dies kann zudem die Genauigkeit von Gesichtsrekonstruktionen verbessern, indem es Informationen liefert, die sonst unbekannt wären. Diese Informationen können auch ohne Übereinstimmung im STR -DNA-Profil zur Identifizierung von Verdächtigen beitragen .
Ein Nachteil der Verwendung von SNPs gegenüber STRs besteht darin, dass SNPs weniger Informationen liefern und daher mehr SNPs für die Analyse benötigt werden, bevor ein Profil eines Verdächtigen erstellt werden kann. Zudem sind SNPs stark auf eine Datenbank für vergleichende Probenanalysen angewiesen. Bei degradierten oder kleinen Probenmengen stellen SNP-Techniken jedoch eine hervorragende Alternative zu STR-Methoden dar. SNPs (im Gegensatz zu STRs) bieten eine Vielzahl potenzieller Marker, können vollständig automatisiert werden und ermöglichen die Reduzierung der erforderlichen Fragmentlänge auf unter 100 bp. [ 27 ]
Pharmakogenetik
Die Pharmakogenetik konzentriert sich auf die Identifizierung genetischer Variationen, einschließlich SNPs, die mit unterschiedlichen Reaktionen auf Behandlungen assoziiert sind. [ 55 ] Viele arzneimittelmetabolisierende Enzyme, Wirkstoffziele oder Zielwege können durch SNPs beeinflusst werden. SNPs, die an der Aktivität arzneimittelmetabolisierender Enzyme beteiligt sind, können die Pharmakokinetik von Arzneimitteln verändern, während SNPs, die an Wirkstoffzielen oder deren Signalwegen beteiligt sind, die Pharmakodynamik von Arzneimitteln verändern können . Daher sind SNPs potenzielle genetische Marker, die zur Vorhersage der Arzneimittelexposition oder der Wirksamkeit einer Behandlung verwendet werden können. Die genomweite pharmakogenetische Untersuchung wird als Pharmakogenomik bezeichnet . Pharmakogenetik und Pharmakogenomik sind wichtig für die Entwicklung der Präzisionsmedizin, insbesondere bei lebensbedrohlichen Erkrankungen wie Krebs.
Krankheit
Nur wenige SNPs im menschlichen Genom können Auswirkungen auf menschliche Krankheiten haben. Für die wichtigsten menschlichen Krankheiten, darunter Herzkrankheiten , Stoffwechselerkrankungen , Autoimmunerkrankungen sowie neurodegenerative und psychiatrische Erkrankungen , wurden groß angelegte genomweite Assoziationsstudien (GWAS) durchgeführt. [ 47 ] Die meisten SNPs mit relativ großen Auswirkungen auf diese Krankheiten wurden identifiziert. Diese Erkenntnisse haben das Verständnis der Pathogenese und der molekularen Signalwege dieser Krankheiten deutlich verbessert und die Entwicklung besserer Therapien ermöglicht. Weitere GWAS mit größeren Stichproben werden die SNPs mit relativ geringen Auswirkungen auf Krankheiten aufdecken. Bei häufigen und komplexen Krankheiten wie Typ-2-Diabetes , rheumatoider Arthritis und Alzheimer sind mehrere genetische Faktoren an der Krankheitsentstehung beteiligt. Darüber hinaus spielen Gen-Gen-Interaktionen und Gen-Umwelt-Interaktionen eine wichtige Rolle bei der Entstehung und dem Fortschreiten der Krankheit. [ 56 ]
Beispiele
- rs6311 und rs6313 sind SNPs im Serotonin-5-HT2A- Rezeptorgen auf dem menschlichen Chromosom 13. [ 57 ]
- Der SNP − 3279C/A (rs3761548) gehört zu den SNPs, die sich in der Promotorregion des Foxp3 -Gens befinden und möglicherweise an der Krebsentstehung beteiligt sind. [ 58 ]
- Eine SNP im F5- Gen verursacht die Faktor-V-Leiden-Thrombophilie. [ 59 ]
- rs3091244 ist ein Beispiel für einen triallelen SNP im CRP -Gen auf dem menschlichen Chromosom 1. [ 60 ]
- TAS2R38 kodiert für die PTC- Schmeckfähigkeit und enthält 6 annotierte SNPs. [ 61 ]
- Die Mutationen rs148649884 und rs138055828 im FCN1- Gen, das für M-Ficolin kodiert, beeinträchtigten die Ligandenbindungsfähigkeit des rekombinanten M-Ficolins. [ 62 ]
- Die Variante rs12821256 in einem cis- regulatorischen Modul verändert die Transkriptionsmenge des KIT-Liganden -Gens. Bei Nordeuropäern führt eine hohe Transkriptionsrate zu braunem Haar, eine niedrige hingegen zu blondem Haar. Dies ist ein Beispiel für eine sichtbare, aber nicht-pathologische Phänotypveränderung durch einen einzelnen SNP. [ 63 ]
- Ein intronischer SNP im DNA-Mismatch-Reparaturgen PMS2 ( rs1059060, Ser775Asn) ist mit vermehrten Spermien -DNA-Schäden und einem erhöhten Risiko für männliche Unfruchtbarkeit assoziiert . [ 64 ]
Datenbanken
Analog zu Genen existieren auch für SNPs bioinformatische Datenbanken.
- dbSNP ist eine SNP-Datenbank des National Center for Biotechnology Information (NCBI). Stand 8. Juni 2015 enthielt dbSNP 149.735.377 SNPs beim Menschen. [ 65 ] [ 66 ]
- Kaviar [ 67 ] ist ein Kompendium von SNPs aus verschiedenen Datenquellen, darunter dbSNP.
- SNPedia ist eine Wiki-artige Datenbank, die die persönliche Genomannotation, -interpretation und -analyse unterstützt.
- Die OMIM- Datenbank beschreibt den Zusammenhang zwischen Polymorphismen und Krankheiten (z. B. werden Krankheiten in Textform angegeben).
- dbSAP – Datenbank für Einzelaminosäure-Polymorphismen zur Erkennung von Proteinvariationen [ 68 ]
- Die Human Gene Mutation Database (Datenbank für menschliche Genmutationen) bietet Informationen zu Genmutationen, die menschliche Erbkrankheiten verursachen oder mit ihnen in Zusammenhang stehen, sowie zu funktionellen SNPs.
- Das internationale HapMap-Projekt , bei dem Forscher Tag-SNPs identifizieren , um die Gesamtheit der in jedem Probanden vorhandenen Haplotypen bestimmen zu können .
- GWAS Central ermöglicht es Benutzern, die tatsächlichen Assoziationsdaten auf Zusammenfassungsebene in einer oder mehreren genomweiten Assoziationsstudien visuell zu untersuchen .
Die Arbeitsgruppe „International SNP Map“ kartierte die Sequenzen, die jeden SNP flankieren, durch Alignment mit den genomischen Sequenzen von Klonen mit großen Inserts in der Genbank. Diese Alignments wurden in chromosomale Koordinaten umgerechnet, die in Tabelle 1 dargestellt sind. [ 69 ] Diese Liste hat sich seitdem stark erweitert; so verzeichnet beispielsweise die Kaviar-Datenbank mittlerweile 162 Millionen Einzelnukleotidvarianten.
| Chromosom | Länge (bp) | Alle SNPs | TSC- SNPs | ||
|---|---|---|---|---|---|
| Gesamtzahl der SNPs | kb pro SNP | Gesamtzahl der SNPs | kb pro SNP | ||
| 1 | 214.066.000 | 129.931 | 1,65 | 75.166 | 2,85 |
| 2 | 222.889.000 | 103.664 | 2.15 | 76.985 | 2,90 |
| 3 | 186.938.000 | 93.140 | 2.01 | 63.669 | 2,94 |
| 4 | 169.035.000 | 84.426 | 2,00 | 65.719 | 2,57 |
| 5 | 170.954.000 | 117.882 | 1,45 | 63.545 | 2,69 |
| 6 | 165.022.000 | 96.317 | 1,71 | 53.797 | 3.07 |
| 7 | 149.414.000 | 71.752 | 2.08 | 42.327 | 3,53 |
| 8 | 125.148.000 | 57.834 | 2.16 | 42.653 | 2,93 |
| 9 | 107.440.000 | 62.013 | 1,73 | 43.020 | 2,50 |
| 10 | 127.894.000 | 61.298 | 2.09 | 42.466 | 3.01 |
| 11 | 129.193.000 | 84.663 | 1,53 | 47.621 | 2,71 |
| 12 | 125.198.000 | 59.245 | 2.11 | 38.136 | 3.28 |
| 13 | 93.711.000 | 53.093 | 1,77 | 35.745 | 2,62 |
| 14 | 89.344.000 | 44.112 | 2.03 | 29.746 | 3,00 |
| 15 | 73.467.000 | 37.814 | 1,94 | 26.524 | 2,77 |
| 16 | 74.037.000 | 38.735 | 1,91 | 23.328 | 3.17 |
| 17 | 73.367.000 | 34.621 | 2.12 | 19.396 | 3,78 |
| 18 | 73.078.000 | 45.135 | 1,62 | 27.028 | 2,70 |
| 19 | 56.044.000 | 25.676 | 2.18 | 11.185 | 5.01 |
| 20 | 63.317.000 | 29.478 | 2.15 | 17.051 | 3,71 |
| 21 | 33.824.000 | 20.916 | 1,62 | 9.103 | 3,72 |
| 22 | 33.786.000 | 28.410 | 1.19 | 11.056 | 3.06 |
| X | 131.245.000 | 34.842 | 3,77 | 20.400 | 6,43 |
| Y | 21.753.000 | 4.193 | 5.19 | 1.784 | 12.19 |
| RefSeq | 15.696.674 | 14.534 | 1,08 | ||
| Summen | 2.710.164.000 | 1.419.190 | 1,91 | 887.450 | 3.05 |
Nomenklatur
Die Nomenklatur für SNPs umfasst mehrere Varianten für ein und dasselbe SNP, ohne dass ein allgemeiner Konsens besteht.
Der rs###-Standard, der von dbSNP übernommen wurde , verwendet das Präfix „rs“ für „Referenz-SNP“, gefolgt von einer eindeutigen und willkürlichen Nummer. [ 70 ] SNPs werden häufig anhand ihrer dbSNP-rs-Nummer referenziert, wie in den obigen Beispielen.
Die Human Genome Variation Society (HGVS) verwendet einen Standard, der detailliertere Informationen über den SNP enthält. Der erste Abschnitt ist üblicherweise eine Chromosomen- oder mRNA-Kennung, z. B. NC_000023.10 (DNA) oder NM_004006.3 (mRNA). Die Art der Veränderung wird durch eine Zeichenkette angegeben.
>(größer als) kennzeichnet eine Substitution (DNA- und RNA-Ebene); g.123456G>A, r.123c>u (gilt für DNA, RNA).delsteht für eine Deletion; c.76del (gilt für DNA, RNA, Protein).dupsteht für eine Duplikation; c.76dup (gilt für DNA, RNA, Protein).insEs handelt sich um eine Insertion; c.76_77insG (gilt für DNA, RNA, Protein). Duplizierende Insertionen werden als Duplikationen und nicht als Insertionen bezeichnet.invKennzeichnet eine Inversion; c.76_83inv (gilt für DNA und RNA). Wird auf Proteinebene nicht verwendet, wird üblicherweise als Deletion-Insertion beschrieben.fsdeutet auf eine Leserasterverschiebung hin; p.Arg456GlyfsTer17.extweist auf eine Erweiterung hin; S.Met1ext-5 (siehe Erweiterung).
Beispiele sind:
- c.76A>T: "c." für codierende Region , gefolgt von einer Zahl für die Position des Nukleotids, gefolgt von einer Einbuchstabenabkürzung für das Nukleotid (A, C, G, T oder U), gefolgt von einem Größer-als-Zeichen (">") zur Kennzeichnung der Substitution, gefolgt von der Abkürzung des Nukleotids, das das vorherige ersetzt [ 71 ] [ 72 ] [ 73 ]
- p.Ser123Arg: „p.“ steht für Protein, gefolgt von einer dreibuchstabigen Abkürzung für die Aminosäure, gefolgt von einer Zahl für die Position der Aminosäure, gefolgt von der Abkürzung der Aminosäure, die die erstere ersetzt. [ 74 ]
- g.1234_2345inv: "g." steht für Genomregion, gefolgt von einer Zahl für die Start- und Endkoordinaten und "inv" für Inversion.
SNP-Analyse
SNPs lassen sich aufgrund der nur zwei möglichen Allele und der drei möglichen Genotypen ( homozygot A, homozygot B und heterozygot AB) leicht analysieren, was zahlreiche Analysemethoden ermöglicht. Dazu gehören: DNA-Sequenzierung , Kapillarelektrophorese , Massenspektrometrie , Einzelstrangkonformationspolymorphismus (SSCP), Einzelbasenverlängerung , elektrochemische Analyse, denaturierende HPLC und Gelelektrophorese , Restriktionsfragmentlängenpolymorphismus und Hybridisierungsanalyse .
Programme zur Vorhersage von SNP-Effekten
Eine wichtige Gruppe von SNPs sind solche, die Missense-Mutationen entsprechen und zu Aminosäureaustauschen auf Proteinebene führen. Punktmutationen bestimmter Aminosäurereste können unterschiedliche Auswirkungen auf die Proteinfunktion haben (von keiner Auswirkung bis hin zum vollständigen Funktionsverlust). Üblicherweise hat der Austausch von Aminosäuren mit ähnlicher Größe und ähnlichen physikalisch-chemischen Eigenschaften (z. B. die Substitution von Leucin durch Valin) eine geringe, ansonsten eine gegenteilige Auswirkung. Ebenso kann eine SNP, die Sekundärstrukturelemente stört (z. B. die Substitution von Prolin in der Alpha-Helix -Region), in der Regel die gesamte Proteinstruktur und -funktion beeinträchtigen. Mithilfe dieser einfachen und vieler weiterer, durch maschinelles Lernen abgeleiteter Regeln wurde eine Gruppe von Programmen zur Vorhersage der SNP-Auswirkung entwickelt: [ 75 ]
- SIFT Dieses Programm liefert Erkenntnisse darüber, wie sich eine im Labor induzierte Missense- oder nicht-synonyme Mutation auf die Proteinfunktion auswirkt, basierend auf den physikalischen Eigenschaften der Aminosäure und der Sequenzhomologie.
- LIST (Local Identity and Shared Taxa) [ 76 ] [ 77 ] schätzt die potenzielle Schädlichkeit von Mutationen ab, die durch die Veränderung von Proteinfunktionen entstehen. Es basiert auf der Annahme, dass Variationen in eng verwandten Arten bei der Beurteilung der Konservierung bedeutsamer sind als solche in entfernt verwandten Arten.
- SNAP2
- Verdächtig
- PolyPhen-2
- PredictSNP
- MutationTaster : offizielle Website
- Variant Effect Predictor aus dem Ensembl- Projekt
- SNPViz, archiviert am 07.08.2020 in der Wayback Machine : [ 78 ] Dieses Programm bietet eine 3D-Darstellung des betroffenen Proteins und hebt die Aminosäureänderung hervor, damit Ärzte die Pathogenität des mutierten Proteins bestimmen können.
- PROVEAN
- PhyreRisk ist eine Datenbank, die Varianten experimentellen und vorhergesagten Proteinstrukturen zuordnet. [ 79 ]
- Missense3D ist ein Tool, das einen stereochemischen Bericht über die Auswirkungen von Missense-Varianten auf die Proteinstruktur liefert. [ 80 ]
Siehe auch
Referenzen
- ^ „Einzelnukleotid-Polymorphismus / SNP | Wissenschaft lernen mit Scitable“ . www.nature.com . Archiviert vom Original am 10.11.2015 . Abgerufen am 13.11.2015 .
- ^ Sherry, ST; Ward, M.; Sirotkin, K. (1999). „dbSNP – Datenbank für Einzelnukleotid-Polymorphismen und andere Klassen geringfügiger genetischer Variation“ . Genome Research . 9 (8): 677–679 . doi : 10.1101/gr.9.8.677 . PMID 10447503. S2CID 10775908 .
- ^ Lander, ES; et al. (2001). „Erste Sequenzierung und Analyse des menschlichen Genoms“ . Nature . 409 (6822): 860–921 . Bibcode : 2001Natur.409..860L . doi : 10.1038/35057062 . hdl : 2027.42/62798 . PMID 11237011 .
- ^ Auton, Adam; et al. (2015). „Eine globale Referenz für die genetische Variation des Menschen“ . Nature . 526 ( 7571): 68–74 . Bibcode : 2015Natur.526...68T . doi : 10.1038/nature15393 . PMC 4750478. PMID 26432245 .
- ^ Monga, Isha; Qureshi, Abid; Thakur, Nishant; Gupta, Amit Kumar; Kumar, Manoj (September 2017). „ ASPsiRNA: Eine Ressource von ASP-siRNAs mit therapeutischem Potenzial für menschliche genetische Erkrankungen und ein Algorithmus zur Vorhersage ihrer inhibitorischen Wirksamkeit“ . G3 . 7 (9): 2931–2943 . doi : 10.1534/g3.117.044024 . PMC 5592921. PMID 28696921 .
- ^ Calippe, Bertrand; Guillonneau, Xavier; Sennlaub, Florian (März 2014). „Komplementfaktor H und verwandte Proteine bei altersbedingter Makuladegeneration“ . Comptes Rendus Biologies . 337 (3): 178–184 . doi : 10.1016/j.crvi.2013.12.003 . ISSN 1631-0691 . PMID 24702844 .
- ^ Husain, Mohammed Amir; Laurent, Benoit; Plourde, Mélanie (17.02.2021). „APOE und Alzheimer-Krankheit: Vom Lipidtransport zur Pathophysiologie und Therapie“ . Frontiers in Neuroscience . 15 630502. doi : 10.3389/fnins.2021.630502 . ISSN 1662-453X . PMC 7925634. PMID 33679311 .
- ^ „Definition von Einzelnukleotidvarianten – NCI-Wörterbuch der Genetikbegriffe“ . www.cancer.gov . 20.07.2012 . Abgerufen am 02.05.2023 .
- ^ Wright, Alan F. (23. September 2005), „Genetische Variation: Polymorphismen und Mutationen“, eLS , Wiley, doi : 10.1038/npg.els.0005005 , ISBN 978-0-470-01617-6, S2CID 82415195
- Goya , R.; Sun, MG; Morin, RD; Leung, G.; Ha, G.; Wiegand, KC; Senz, J.; Crisan, A.; Marra, MA; Hirst, M.; Huntsman, D.; Murphy, KP; Aparicio, S.; Shah, SP (2010). „SNVMix: Vorhersage von Einzelnukleotidvarianten aus der Next-Generation-Sequenzierung von Tumoren“ . Bioinformatics . 26 (6): 730–736 . doi : 10.1093/bioinformatics/btq040 . PMC 2832826. PMID 20130035 .
- ^ Katsonis, Panagiotis; Koire, Amanda; Wilson, Stephen Joseph; Hsu, Teng-Kuei; Lua, Rhonald C.; Wilkins, Angela Dawn; Lichtarge, Olivier (2014-10-20). „Einzelnukleotidvariationen: Biologische Auswirkungen und theoretische Interpretation“ . Protein Science . 23 (12): 1650–1666 . doi : 10.1002/pro.2552 . ISSN 0961-8368 . PMC 4253807. PMID 25234433 .
- ^ Khurana, Ekta; Fu, Yao; Chakravarty, Dimple; Demichelis, Francesca; Rubin, Mark A.; Gerstein, Mark (19.01.2016). „Rolle nicht-kodierender Sequenzvarianten bei Krebs“. Nature Reviews Genetics . 17 (2): 93–108 . doi : 10.1038/nrg.2015.17 . ISSN 1471-0056 . PMID 26781813. S2CID 14433306 .
- ^ Dong, Hongjie; Wang, Shuai; Zhang, Junmei; Zhang, Kundi; Zhang, Fengyu; Wang, Hongwei; Xie, Shiling; Hu, Wei; Gu, Lichuan (2021). „Strukturbasiertes Primerdesign minimiert das Risiko eines PCR-Fehlers durch SARS-CoV-2-Mutationen“ . Grenzen der Zell- und Infektionsmikrobiologie . 11 741147. doi : 10.3389/fcimb.2021.741147 . ISSN 2235-2988 . PMC 8573093 . PMID 34760717 .
- ^ Karki, Roshan; Pandya, Deep; Elston, Robert C.; Ferlini, Cristiano (15. Juli 2015). „Definition von „Mutation“ und „Polymorphismus“ im Zeitalter der persönlichen Genomik“ . BMC Medical Genomics . 8 (1). Springer Science and Business Media LLC: 37. doi : 10.1186/s12920-015-0115-z . ISSN 1755-8794 . PMC 4502642. PMID 26173390 .
- ^ Li, Heng (15. März 2021). „SNP vs SNV“ . Heng Lis Blog . Abgerufen am 3. Mai 2023 .
- Spencer , Paige S.; Barral, José M. (2012). „Genetische Code-Redundanz und ihr Einfluss auf die kodierten Polypeptide“ . Computational and Structural Biotechnology Journal . 1 e201204006. doi : 10.5936/csbj.201204006 . ISSN 2001-0370 . PMC 3962081. PMID 24688635 .
- ^ Chu, Duan; Wei, Lai (16.04.2019). „Nicht-synonyme, synonyme und Nonsense-Mutationen in menschlichen, krebsassoziierten Genen unterliegen einer stärkeren reinigenden Selektion als erwartet“ . BMC Cancer . 19 (1): 359. doi : 10.1186/s12885-019-5572-x . ISSN 1471-2407 . PMC 6469204. PMID 30991970 .
- ^ Li G, Pan T, Guo D, Li LC (2014). „Regulatorische Varianten und Krankheit: Der E-Cadherin -160C/A SNP als Beispiel“ . Molecular Biology International . 2014 967565. doi : 10.1155/2014/967565 . PMC 4167656. PMID 25276428 .
- ^ Lu YF, Mauger DM, Goldstein DB, Urban TJ, Weeks KM, Bradrick SS (November 2015). „Die IFNL3-mRNA-Struktur wird durch einen funktionellen, nicht-kodierenden Polymorphismus, der mit der Clearance des Hepatitis-C-Virus assoziiert ist , umgestaltet“ . Scientific Reports . 5 16037. Bibcode : 2015NatSR...516037L . doi : 10.1038/srep16037 . PMC 4631997. PMID 26531896 .
- ^ Kimchi-Sarfaty C, Oh JM, Kim IW, Sauna ZE, Calcagno AM, Ambudkar SV, Gottesman MM (Januar 2007). „ Ein „stiller“ Polymorphismus im MDR1-Gen verändert die Substratspezifität“ . Science . 315 (5811): 525–8 . Bibcode : 2007Sci...315..525K . doi : 10.1126/science.1135308 . PMID 17185560. S2CID 15146955 .
- ^ Al-Haggar M, Madej-Pilarczyk A, Kozlowski L, Bujnicki JM, Yahia S, Abdel-Hadi D, Shams A, Ahmad N, Hamed S, Puzianowska-Kuznicka M (November 2012). „Eine neuartige homozygote p.Arg527Leu LMNA-Mutation in zwei nicht verwandten ägyptischen Familien verursacht überlappende mandibuloakrale Dysplasie und Progerie-Syndrom . “ Europäisches Journal für Humangenetik . 20 (11): 1134– 40. doi : 10.1038/ejhg.2012.77 . PMC 3476705 . PMID 22549407 .
- ^ Cordovado SK, Hendrix M, Greene CN, Mochal S, Earley MC, Farrell PM, Kharrazi M, Hannon WH, Mueller PW (Februar 2012). „ CFTR-Mutationsanalyse und Haplotyp-Assoziationen bei CF-Patienten“ . Molecular Genetics and Metabolism . 105 (2): 249–54 . doi : 10.1016/j.ymgme.2011.10.013 . PMC 3551260. PMID 22137130 .
- ^ „Was sind Einzelnukleotid-Polymorphismen (SNPs)?: MedlinePlus Genetics“ . medlineplus.gov . Abgerufen am 22.03.2023 .
- ^ Auton A, Brooks LD, Durbin RM, Garrison EP, Kang HM, Korbel JO, Marchini JL, McCarthy S, McVean GA, Abecasis GR (Oktober 2015). „Eine globale Referenz für die genetische Variation des Menschen“ . Natur . 526 (7571): 68– 74. Bibcode : 2015Natur.526...68T . doi : 10.1038/nature15393 . PMC 4750478 . PMID 26432245 .
- ^ Barreiro LB, Laval G, Quach H, Patin E, Quintana-Murci L (März 2008). „Natürliche Selektion hat die Populationsdifferenzierung beim modernen Menschen vorangetrieben.“ Naturgenetik . 40 (3): 340– 5. doi : 10.1038/ng.78 . PMID 18246066 . S2CID 205357396 .
- ^ Nachman MW (September 2001). „Einzelnukleotid-Polymorphismen und Rekombinationsrate beim Menschen“. Trends in Genetics . 17 (9): 481–5 . doi : 10.1016/S0168-9525(01)02409-X . PMID 11525814 .
- ^ a b Varela MA, Amos W (März 2010). „Heterogene Verteilung von SNPs im menschlichen Genom: Mikrosatelliten als Prädiktoren für Nukleotiddiversität und -divergenz“. Genomics . 95 (3): 151–9 . doi : 10.1016/j.ygeno.2009.12.003 . PMID 20026267 .
- ^ Bergström A, McCarthy SA, Hui R, Almarri MA, Ayub Q, Danecek P; et al. (2020). „ Einblicke in die menschliche genetische Variation und Populationsgeschichte aus 929 verschiedenen Genomen“ . Science . 367 (6484) eaay5012. doi : 10.1126/science.aay5012 . PMC 7115999. PMID 32193295 .
{{cite journal}}: CS1 Wartung: Mehrere Namen: Autorenliste ( Link ) - ^ Zhu Z, Yuan D, Luo D, Lu X, Huang S (2015-07-24). „Anreicherung von Minor-Allelen häufiger SNPs und verbesserte Risikovorhersage für die Parkinson-Krankheit“ . PLOS ONE . 10 (7) e0133421. Bibcode : 2015PLoSO..1033421Z . doi : 10.1371/ journal.pone.0133421 . PMC 4514478. PMID 26207627 .
- ^ Hivert, Valentin; Leblois, Raphaël; Petit, Eric J.; Gautier, Mathieu; Vitalis, Renaud (30.07.2018). „ Measuring Genetic Differentiation from Pool-seq Data“ . Genetics . 210 (1): 315–330 . doi : 10.1534/genetics.118.300900 . ISSN 0016-6731 . PMC 6116966. PMID 30061425 .
- ^ Ekblom, R.; Galindo, J. (08.12.2010). „Anwendungen der Next-Generation-Sequenzierung in der molekularen Ökologie von Nicht-Modellorganismen“ . Heredity . 107 ( 1): 1–15 . doi : 10.1038/hdy.2010.152 . ISSN 0018-067X . PMC 3186121. PMID 21139633 .
- ^ Ellegren, Hans (Januar 2014). „Genomsequenzierung und Populationsgenomik in Nicht-Modellorganismen“. Trends in Ecology & Evolution . 29 (1): 51–63 . Bibcode : 2014TEcoE..29...51E . doi : 10.1016/j.tree.2013.09.008 . ISSN 0169-5347 . PMID 24139972 .
- ^ Chen, Chao; Parejo, Melanie; Momeni, Jamal; Langa, Jorge; Nielsen, Rasmus O.; Shi, Wei; Smartbees Wp Diversity Contributors, null; Vingborg, Rikke; Kryger, Per; Bouga, Maria; Estonba, Andone; Meixner, Marina (21.01.2022). „Populationsstruktur und Diversität bei europäischen Honigbienen (Apismellifera L.) – Ein empirischer Vergleich der Pool- und individuellen Sequenzierung des gesamten Genoms“ . Gene . 13 (2): 182. doi : 10.3390/genes13020182 . ISSN 2073-4425 . PMC 8872436 . PMID 35205227 .
{{cite journal}}:|last7=hat einen generischen Namen ( Hilfe ) - Dorant , Yann; Benestan, Laura; Rougemont, Quentin; Normandeau, Eric; Boyle, Brian; Rochette, Rémy; Bernatchez, Louis (2019). „Vergleich von Pool-seq-, Rapture- und GBS-Genotypisierung zur Ableitung schwacher Populationsstrukturen: Der Amerikanische Hummer (Homarus americanus) als Fallbeispiel“ . Ecology and Evolution . 9 (11): 6606–6623 . Bibcode : 2019EcoEv...9.6606D . doi : 10.1002/ece3.5240 . ISSN 2045-7758 . PMC 6580275. PMID 31236247 .
- Vendrami , David LJ; Telesca, Luca; Weigand, Hannah; Weiss, Martina; Fawcett, Katie; Lehman, Katrin; Clark, MS; Leese, Florian; McMinn, Carrie; Moore, Heather; Hoffman, Joseph I. (2017). „ RAD-Sequenzierung entschlüsselt die Populationsstruktur im Feinbereich eines benthischen Wirbellosen: Implikationen für das Verständnis phänotypischer Plastizität“ . Royal Society Open Science . 4 (2) 160548. Bibcode : 2017RSOS....460548V . doi : 10.1098/rsos.160548 . PMC 5367306. PMID 28386419 .
- ^ Uffelmann, Emil; Huang, Qin Qin; Munung, Nchangwi Syntia; de Vries, Jantina; Okada, Yukinori; Martin, Alicia R.; Martin, Hilary C.; Lappalainen, Tuuli; Posthuma, Danielle (26.08.2021). „Genomweite Assoziationsstudien“ . Nature Reviews Methods Primers . 1 (1): 59. doi : 10.1038/s43586-021-00056-9 . hdl : 1871.1/66fb93bd-20f0-498c-923a-88626cbba8c8 . ISSN 2662-8449 .
- ^ Buniello, Annalisa; MacArthur, Jacqueline AL; Cerezo, Maria; Harris, Laura W.; Hayhurst, James; Malangone, Cinzia; McMahon, Aoife; Morales, Joannella; Mountjoy, Edward; Sollis, Elliot; Suveges, Daniel; Vrousgou, Olga; Whetzel, Patricia L.; Amode, Ridwan; Guillen, Jose A. (08.01.2019). „Der NHGRI-EBI GWAS-Katalog veröffentlichter genomweiter Assoziationsstudien, gezielter Arrays und zusammenfassender Statistiken 2019“ . Nukleinsäureforschung . 47 (D1): D1005– D1012. doi : 10.1093/nar/gky1120 . ISSN 1362-4962 . PMC 6323933 . PMID 30445434 .
- ^ Carlson, Christopher S.; Eberle, Michael A.; Rieder, Mark J.; Yi, Qian; Kruglyak, Leonid; Nickerson, Deborah A. (Januar 2004). „Auswahl eines maximal informativen Satzes von Einzelnukleotid-Polymorphismen für Assoziationsanalysen mittels Kopplungsungleichgewicht“ . American Journal of Human Genetics . 74 (1): 106–120 . doi : 10.1086/381000 . ISSN 0002-9297 . PMC 1181897. PMID 14681826 .
- Sebastiani , Paola; Lazarus, Ross; Weiss, Scott T.; Kunkel, Louis M.; Kohane, Isaac S.; Ramoni, Marco F. (19.08.2003). „ Minimales Haplotyp-Tagging“ . Proceedings of the National Academy of Sciences of the United States of America . 100 (17): 9900–9905 . Bibcode : 2003PNAS..100.9900S . doi : 10.1073/pnas.1633613100 . ISSN 0027-8424 . PMC 187880. PMID 12900503 .
- Gabriel, Stacey B.; Schaffner, Stephen F.; Nguyen, Huy; Moore, Jamie M.; Roy, Jessica; Blumenstiel, Brendan; Higgins, John; DeFelice, Matthew; Lochner, Amy; Faggart, Maura; Liu-Cordero, Shau Neen; Rotimi, Charles; Adeyemo, Adebowale; Cooper, Richard; Ward, Ryk (21.06.2002). „Die Struktur von Haplotypblöcken im menschlichen Genom“. Science . 296 ( 5576): 2225–2229 . Bibcode : 2002Sci...296.2225G . doi : 10.1126/science.1069424 . ISSN 1095-9203 . PMID 12029063 .
- ^ Altshuler, David; Donnelly, Peter; The International HapMap Consortium (Oktober 2005). „Eine Haplotypkarte des menschlichen Genoms“ . Nature . 437 (7063): 1299–1320 . Bibcode : 2005Natur.437.1299T . doi : 10.1038 / nature04226 . ISSN 1476-4687 . PMC 1880871. PMID 16255080 .
- ^ Slatkin, Montgomery (Juni 2008). „Linkage disequilibrium—understanding the evolutionary past and mapping the medical future“ . Nature Reviews Genetics . 9 (6): 477–485 . doi : 10.1038 / nrg2361 . ISSN 1471-0064 . PMC 5124487. PMID 18427557 .
- ^ Wall, Jeffrey D.; Pritchard, Jonathan K. (September 2003). „Bewertung der Leistungsfähigkeit des Haplotyp-Block-Modells der Kopplungsungleichgewicht“ . American Journal of Human Genetics . 73 (3): 502–515 . doi : 10.1086/378099 . ISSN 0002-9297 . PMC 1180676. PMID 12916017 .
- Walker , Timothy M.; Ip, Camilla LC; Harrell, Ruth H.; Evans, Jason T.; Kapatai, Georgia; Dedicoat, Martin J.; Eyre, David W.; Wilson, Daniel J.; Hawkey, Peter M.; Crook, Derrick W.; Parkhill, Julian; Harris, David; Walker, A. Sarah; Bowden, Rory; Monk, Philip (Februar 2013). „Ganzgenomsequenzierung zur Abgrenzung von Ausbrüchen von Mycobacterium tuberculosis: eine retrospektive Beobachtungsstudie“ . The Lancet. Infectious Diseases . 13 (2): 137–146 . doi : 10.1016/S1473-3099(12)70277-3 . ISSN 1474-4457 . PMC 3556524 . PMID 23158499 .
- Price , Alkes L.; Patterson, Nick J.; Plenge, Robert M.; Weinblatt, Michael E.; Shadick, Nancy A.; Reich, David (August 2006). „Hauptkomponentenanalyse korrigiert die Stratifizierung in genomweiten Assoziationsstudien“ . Nature Genetics . 38 (8): 904–909 . doi : 10.1038/ng1847 . ISSN 1546-1718 . PMID 16862161 .
- ^ Carlson, Bruce (15. Juni 2008). „SNPs – Ein direkter Weg zur personalisierten Medizin“ . Genetic Engineering & Biotechnology News . 28 (12). Mary Ann Liebert, Inc. Archiviert vom Original am 26. Dezember 2010. Abgerufen am 6. Juli 2008. (
Untertitel) Medizinische Anwendungen sind der Bereich, in dem das Marktwachstum erwartet wird.
- Visscher , Peter M.; Wray, Naomi R.; Zhang, Qian; Sklar, Pamela; McCarthy, Mark I.; Brown, Matthew A.; Yang, Jian (Juli 2017). „ 10 Jahre GWAS-Entdeckungen: Biologie, Funktion und Translation“ . The American Journal of Human Genetics . 101 (1): 5–22 . doi : 10.1016/j.ajhg.2017.06.005 . ISSN 0002-9297 . PMC 5501872. PMID 28686856 .
- ^ Dong, Linda M.; Potter, John D.; White, Emily; Ulrich, Cornelia M.; Cardon, Lon R.; Peters, Ulrike (28.05.2008). „Genetische Prädisposition für Krebs“ . JAMA . 299 (20): 2423–2436 . doi : 10.1001 / jama.299.20.2423 . ISSN 0098-7484 . PMC 2772197. PMID 18505952 .
- ^ Alkuraya, Fowzan S. (April 2010). „Homozygotie-Kartierung: Ein weiteres Werkzeug im Repertoire des klinischen Genetikers“ . Genetics in Medicine . 12 (4): 236–239 . doi : 10.1097/ gim.0b013e3181ceb95d . ISSN 1098-3600 . PMID 20134328. S2CID 10789932 .
- Vohra , Manik; Sharma, Anu Radha; Prabhu B, Navya; Rai, Padmalatha S. (2020). „SNPs in DNA-Methylierungs-, Transkriptionsfaktor-Bindungs- und miRNA-Zielsequenzen, die zu allelspezifischer Genexpression führen und zum Risiko komplexer Erkrankungen beitragen: Eine systematische Übersicht“ . Public Health Genomics . 23 ( 5–6 ): 155–170 . doi : 10.1159/000510253 . ISSN 1662-4246 . PMID 32966991. S2CID 221886624 .
- ^ Wang, Jing; Ma, Xiaoqin; Zhang, Qi; Chen, Yinghui; Wu, Dan; Zhao, Pengjun; Yu, Yu (2021). „Interaktionsanalyse von SNP-Varianten und DNA-Methylierung identifiziert neue methylierte Pathogenese-Gene bei angeborenen Herzfehlern“ . Frontiers in Cell and Developmental Biology . 9: 665514. doi : 10.3389 /fcell.2021.665514 . ISSN 2296-634X . PMC 8143053. PMID 34041244 .
- ^ a b Hawe, Johann S.; Wilson, Rory; Schmid, Katharina T.; Zhou, Li; Lakshmanan, Lakshmi Narayanan; Lehne, Benjamin C.; Kühnel, Brigitte; Scott, William R.; Wielscher, Matthias; Yew, Yik Weng; Baumbach, Clemens; Lee, Dominic P.; Marouli, Eirini; Bernard, Manon; Pfeiffer, Liliane (Januar 2022). „Genetische Variationen, die die DNA-Methylierung beeinflussen, liefern Einblicke in molekulare Mechanismen , die die Genomfunktion regulieren“ . Nature Genetics . 54 (1): 18–29 . doi : 10.1038/s41588-021-00969-x . ISSN 1546-1718 . PMC 7617265. PMID 34980917 . S2CID 256821844 .
- ^ Perzel Mandell, Kira A.; Eagles, Nicholas J.; Wilton, Richard; Price, Amanda J.; Semick, Stephen A.; Collado-Torres, Leonardo; Ulrich, William S.; Tao, Ran; Han, Shizhong; Szalay, Alexander S.; Hyde, Thomas M.; Kleinman, Joel E.; Weinberger, Daniel R.; Jaffe, Andrew E. (2021-09-02). „Genomweite Sequenzierungs-basierte Identifizierung von Methylierungs-QTLs und deren Rolle im Schizophrenierisiko“ . Nature Communications . 12 (1): 5251. Bibcode : 2021NatCo..12.5251P . doi : 10.1038/s41467-021-25517-3 . ISSN 2041-1723 . PMC 8413445 . PMID 34475392 .
- ^ Hoffmann, Anke; Ziller, Michael; Spengler, Dietmar (Dezember 2016). „Die Zukunft ist die Vergangenheit: Methylierungs-QTLs bei Schizophrenie“ . Genes . 7 ( 12): 104. doi : 10.3390/genes7120104 . ISSN 2073-4425 . PMC 5192480. PMID 27886132 .
- ^ Daly, Ann K (11.10.2017). „Pharmakogenetik: Ein allgemeiner Überblick über den bisherigen Stand“ . British Medical Bulletin . 124 (1): 65–79 . doi : 10.1093/bmb/ldx035 . ISSN 0007-1420 . PMID 29040422 .
- Musci , Rashelle J.; Augustinavicius, Jura L.; Volk, Heather (13.08.2019). „Gen-Umwelt-Interaktionen in der Psychiatrie: Aktuelle Erkenntnisse und klinische Implikationen“ . Current Psychiatry Reports . 21 (9): 81. doi : 10.1007/s11920-019-1065-5 . ISSN 1523-3812 . PMC 7340157. PMID 31410638 .
- ^ Giegling I, Hartmann AM, Möller HJ, Rujescu D (November 2006). „Ärger- und Aggressionsbezogene Merkmale sind mit Polymorphismen im 5-HT-2A-Gen assoziiert“. Journal of Affective Disorders . 96 ( 1–2 ): 75–81 . doi : 10.1016/j.jad.2006.05.016 . PMID 16814396 .
- ^ Ezzeddini R, Somi MH, Taghikhani M, Moaddab SY, Masnadi Shirazi K, Shirmohammadi M, Eftekharsadat AT, Sadighi Moghaddam B, Salek Farrokhi A (Februar 2021). „Zusammenhang des Foxp3 rs3761548-Polymorphismus mit der Zytokinkonzentration bei Patienten mit Magenadenokarzinom“. Zytokin . 138 155351. doi : 10.1016/j.cyto.2020.155351 . ISSN 1043-4666 . PMID 33127257 . S2CID 226218796 .
- ^ Kujovich JL (Januar 2011). „Faktor-V-Leiden-Thrombophilie“ . Genetics in Medicine . 13 (1): 1–16 . doi : 10.1097/GIM.0b013e3181faa0f2 . PMID 21116184 .
- ^ Morita A, Nakayama T, Doba N, Hinohara S, Mizutani T, Soma M (Juni 2007). „Genotypisierung triallelischer SNPs mittels TaqMan-PCR“. Molecular and Cellular Probes . 21 (3): 171–6 . doi : 10.1016/j.mcp.2006.10.005 . PMID 17161935 .
- ^ Prodi DA, Drayna D, Forabosco P, Palmas MA, Maestrale GB, Piras D, Pirastu M, Angius A (Oktober 2004). „Eine Studie zum Bittergeschmack in einem sardischen Genisolat stützt die Assoziation der Phenylthiocarbamid-Empfindlichkeit mit dem Bitterrezeptor-Gen TAS2R38“ . Chemical Senses . 29 (8): 697–702 . doi : 10.1093/chemse/bjh074 . PMID 15466815 .
- ^ Ammitzbøll CG, Kjær TR, Steffensen R, Stengaard-Pedersen K, Nielsen HJ, Thiel S, Bøgsted M, Jensenius JC (28. November 2012). „Nicht-synonyme Polymorphismen im FCN1-Gen bestimmen die Ligandenbindungsfähigkeit und die Serumspiegel von M-Ficolin . “ PLUS EINS . 7 (11) e50585. Bibcode : 2012PLoSO...750585A . doi : 10.1371/journal.pone.0050585 . PMC 3509001 . PMID 23209787 .
- ^ Guenther, Catherine A.; Tasic, Bosiljka; Luo, Liqun; Bedell, Mary A.; Kingsley, David M. (Juli 2014). „Eine molekulare Grundlage für die klassische blonde Haarfarbe bei Europäern“ . Nature Genetics . 46 (7): 748–752 . doi : 10.1038/ng.2991 . ISSN 1546-1718 . PMC 4704868. PMID 24880339 .
- ^ Ji G, Long Y, Zhou Y, Huang C, Gu A, Wang X (Mai 2012). „Häufige Varianten in DNA-Reparaturgenen sind mit einem erhöhten Risiko für Spermien-DNA-Schäden und männliche Unfruchtbarkeit assoziiert“ . BMC Medicine . 10 49. doi : 10.1186/1741-7015-10-49 . PMC 3378460. PMID 22594646 .
- ^ National Center for Biotechnology Information, United States National Library of Medicine. 2014. NCBI dbSNP Build 142 für den Menschen. „[DBSNP-announce] DBSNP Human Build 142 (GRCh38 und GRCh37.p13)“ . Archiviert vom Original am 10.09.2017 . Abgerufen am 11.09.2017 .
- ^ National Center for Biotechnology Information, United States National Library of Medicine. 2015. NCBI dbSNP Build 144 für den Menschen. Zusammenfassungsseite. „DBSNP-Zusammenfassung“ . Archiviert vom Original am 10.09.2017 . Abgerufen am 11.09.2017 .
- ^ Glusman G, Caballero J, Mauldin DE, Hood L, Roach JC (November 2011). „Kaviar: ein zugängliches System zum Testen der Neuartigkeit von SNVs“ . Bioinformatics . 27 ( 22): 3216–7 . doi : 10.1093/bioinformatics/btr540 . PMC 3208392. PMID 21965822 .
- ^ Cao R, Shi Y, Chen S, Ma Y, Chen J, Yang J, Chen G, Shi T (Januar 2017). „dbSAP: Datenbank für Einzelaminosäure-Polymorphismen zur Erkennung von Proteinvarianten“ . Nucleic Acids Research . 45 (D1): D827– D832 . doi : 10.1093/nar/gkw1096 . PMC 5210569. PMID 27903894 .
- ^ Sachidanandam R, Weissman D, Schmidt SC, Kakol JM, Stein LD , Marth G, Sherry S, Mullikin JC, Mortimore BJ, Willey DL, Hunt SE, Cole CG, Coggill PC, Rice CM, Ning Z, Rogers J, Bentley DR, Kwok PY, Mardis ER, Yeh RT, Schultz B, Cook L, Davenport R, Dante M, Fulton L, Hillier L, Waterston RH, McPherson JD, Gilman B, Schaffner S, Van Etten WJ, Reich D, Higgins J, Daly MJ, Blumenstiel B, Baldwin J, Stange-Thomann N, Zody MC, Linton L, Lander ES, Altshuler D (Februar 2001). „Eine Karte der Sequenzvariation des menschlichen Genoms mit 1,42 Millionen Einzelnukleotid-Polymorphismen“ . Nature . 409 (6822): 928–33 . Bibcode : 2001Natur.409..928S . doi : 10.1038/35057149 . PMID 11237013 .
- ^ „Clustered RefSNPs (rs) and Other Data Computed in House“ . SNP FAQ Archive . Bethesda (MD): US National Center for Biotechnology Information. 2005.
- ^ JT Den Dunnen (20.02.2008). „Empfehlungen zur Beschreibung von Sequenzvarianten“ . Human Genome Variation Society . Archiviert vom Original am 14.09.2008 . Abgerufen am 05.09.2008 .
- ^ den Dunnen JT, Antonarakis SE (2000). „Erweiterungen und Vorschläge zur Beschreibung komplexer Mutationen in der Mutationsnomenklatur: eine Diskussion“ . Human Mutation . 15 (1): 7–12. doi : 10.1002 /(SICI)1098-1004(200001)15:1<7::AID-HUMU4>3.0.CO;2-N . PMID 10612815 .
- ^ Ogino S, Gulley ML, den Dunnen JT, Wilson RB (Februar 2007). „Standardisierte Mutationsnomenklatur in der Molekulardiagnostik: Praktische und pädagogische Herausforderungen“ . The Journal of Molecular Diagnostics . 9 (1): 1–6 . doi : 10.2353/jmoldx.2007.060081 . PMC 1867422. PMID 17251329 .
- ^ „Sequenzvarianten-Nomenklatur“ . varnomen.hgvs.org . Abgerufen am 2. Dezember 2019 .
- ^ Johnson, Andrew D. (Oktober 2009). „SNP-Bioinformatik: Ein umfassender Überblick über Ressourcen“ . Circulation : Cardiovascular Genetics . 2 (5): 530–536 . doi : 10.1161/CIRCGENETICS.109.872010 . ISSN 1942-325X . PMC 2789466. PMID 20031630 .
- ^ Malhis N, Jones SJ, Gsponer J (April 2019). „Verbesserte Maße für die evolutionäre Erhaltung, die taxonomische Distanzen nutzen“ . Nature Communications . 10 (1) 1556. Bibcode : 2019NatCo..10.1556M . doi : 10.1038/s41467-019-09583-2 . PMC 6450959. PMID 30952844 .
- ^ Nawar Malhis; Matthew Jacobson; Steven JM Jones; Jörg Gsponer (2020). „LIST-S2: Taxonomy Based Sorting of Deleterious Missense Mutations Across Species“ . Nucleic Acids Research . 48 (W1): W154– W161 . doi : 10.1093/nar/gkaa288 . PMC 7319545. PMID 32352516 .
- ^ „Ansicht von SNPViz – Visualisierung von SNPs in Proteinen“ . genomicscomputbiol.org . doi : 10.18547/gcb.2018.vol4.iss1.e100048 . Archiviert vom Original am 7. August 2020. Abgerufen am 20. Oktober 2018 .
- Ofoegbu TC, David A, Kelley LA, Mezulis S, Islam SA, Mersmann SF, et al. (Juni 2019). „PhyreRisk: Eine dynamische Webanwendung zur Verknüpfung von Genomik-, Proteomik- und 3D-Strukturdaten zur Interpretation menschlicher genetischer Varianten“ . Journal of Molecular Biology . 431 (13): 2460–2466 . doi : 10.1016/j.jmb.2019.04.043 . PMC 6597944. PMID 31075275 .
- ^ Ittisoponpisan S, Islam SA, Khanna T, Alhuzimi E, David A, Sternberg MJ (Mai 2019). „Können vorhergesagte 3D-Proteinstrukturen zuverlässige Einblicke in die Frage liefern, ob Missense-Varianten mit Krankheiten assoziiert sind?“ Journal of Molecular Biology . 431 (11): 2197–2212 . doi : 10.1016/j.jmb.2019.04.009 . PMC 6544567. PMID 30995449 .
Weiterführende Literatur
- "Glossar" . Nature Reviews .
- Informationen zum Humangenomprojekt – SNP-Datenblatt
Externe Links
- NCBI-Ressourcen , archiviert am 02.09.2013 in der Wayback Machine – Einführung in SNPs vom NCBI
- Das SNP Consortium LTD – SNP-Suche
- NCBI dbSNP-Datenbank – „ein zentrales Repository für Einzelbasen-Nukleotid-Substitutionen sowie kurze Deletions- und Insertionspolymorphismen“
- HGMD – die Datenbank für menschliche Genmutationen, umfasst seltene Mutationen und funktionelle SNPs.
- GWAS Central – eine zentrale Datenbank mit zusammenfassenden Ergebnissen genetischer Assoziationen.
- 1000-Genomes-Projekt – Ein umfassender Katalog menschlicher genetischer Variationen
- WatCut, archiviert am 18.06.2007 in der Wayback Machine – ein Online-Tool für die Entwicklung von SNP-RFLP-Assays
- SNPStats, archiviert am 13.10.2008 im Internetarchiv (Wayback Machine) – SNPStats, ein Webtool zur Analyse genetischer Assoziationsstudien
- Homepage für Restriktionsanalysen – eine Sammlung von Werkzeugen zur DNA-Restriktion und SNP-Detektion, einschließlich der Entwicklung mutagener Primer
- Informationsblatt der Amerikanischen Vereinigung für Krebsforschung zu Krebskonzepten und SNPs
- PharmGKB – Die Wissensdatenbank für Pharmakogenetik und Pharmakogenomik, eine Ressource für SNPs, die mit Arzneimittelwirkungen und Krankheitsverläufen in Zusammenhang stehen.
- GEN-SNiP , archiviert am 19.01.2010 in der Wayback Machine – Online-Tool zur Identifizierung von Polymorphismen in Test-DNA-Sequenzen.
- Regeln für die Nomenklatur von Genen, genetischen Markern, Allelen und Mutationen bei Maus und Ratte
- HGNC-Richtlinien für die Nomenklatur menschlicher Gene
- SNP-Effektprädiktor mit Galaxienintegration
- Open SNP – ein Portal zum Teilen eigener SNP-Testergebnisse
- dbSAP ( Archiviert am 20.12.2016 im Internet Archive) – SNP-Datenbank zur Erkennung von Proteinvarianten