Eine Silbe ist die grundlegende Organisationseinheit innerhalb einer Lautfolge, beispielsweise in einem Wort. In der Phonologie und Sprachwissenschaft gelten Silben oft als die „Bausteine“ von Wörtern . [ 1 ] Eine Silbe besteht üblicherweise aus einem Kern (meist einem Vokal ), dem ein Anlaut vorangehen und ein Auslaut folgen kann (zusammengefasst als Rand , meist Konsonanten ). Silben können Eigenschaften wie Betonung und Tonhöhe aufweisen und Operationen wie Reduplikation unterliegen . [ 2 ] Die gesprochene Sprache lässt sich in der Regel in eine ganze Anzahl von Silben unterteilen: So besteht beispielsweise das Wort „ignite“ aus zwei Silben: „ig“ und „nite“ . Die meisten Sprachen der Welt verwenden relativ einfache Silbenstrukturen, in denen häufig Vokale und Konsonanten wechseln. [ 3 ]
Obwohl Silben in praktisch allen menschlichen Sprachen vorkommen, gibt es immer noch keine präzise Definition, die für alle bekannten Sprachen gültig ist. Ein gängiges Kriterium zur Bestimmung von Silbengrenzen ist die Intuition von Muttersprachlern, doch die Meinungen darüber gehen mitunter auseinander. [ 4 ]
Die frühesten belegten Beispiele für Silbenschrift finden sich auf Tontafeln aus der sumerischen Stadt Ur , die um 2800 v. Chr. beschriftet wurden und den frühesten Belegen für alphabetische Schrift um mehrere Jahrhunderte vorausgehen. Der Übergang von der Bilderschrift zur Silbenschrift gilt als „der wichtigste Fortschritt in der Geschichte der Schrift “. [ 5 ]
Ein einsilbiges Wort (wie das englische „ dog“) wird als einsilbig bezeichnet . Ähnliche Begriffe sind zweisilbig (und zweisilbig ; auch zweisilbig und zweisilbig ) für ein zweisilbiges Wort; dreisilbig (und dreisilbig ) für ein dreisilbiges Wort; und mehrsilbig (und mehrsilbig ), was sich auf jedes Wort mit mehr als einer Silbe beziehen kann.
Etymologie
„Syllable“ ist eine anglonormannische Variante des altfranzösischen „sillabe“ , das vom lateinischen „ syllaba“ und vom Koine-Griechischen συλλαβή syllabḗ ( altgriechische Aussprache: [sylːabɛ̌ː] ) stammt. συλλαβή bedeutet „zusammen“ und bezieht sich auf Buchstaben, die zusammen einen einzigen Laut bilden. [ 6 ]
συλλαβή ist ein Verbalsubstantiv aus dem Verb συλλαμβάνω syllambánō , einer Verbindung der Präposition σύν sýn „mit“ und dem Verb λαμβάνω lambánō „nehmen“. [ 7 ] Das Substantiv verwendet die Wurzel λαβ- , die in der Aorist- Zeitform vorkommt; Der Präsensstamm λαμβάν- wird gebildet, indem vor dem β b einnasalesInfix ⟨ μ ⟩ ⟨m⟩ und am Ende einSuffix -αν -an hinzugefügt wird. [ 8 ]
Transkription
Im Internationalen Phonetischen Alphabet (IPA) kennzeichnet der Punkt ⟨ . ⟩ Silbentrennungen, wie im Wort „astronomical“ ⟨ /ˌæs.trə.ˈnɒm.ɪk.əl/ ⟩.
In der Praxis wird die IPA-Transkription jedoch typischerweise durch Leerzeichen in Wörter unterteilt, wobei diese Leerzeichen oft auch als Silbentrennungen gelten. Darüber hinaus steht das Betonungszeichen ⟨ ˈ ⟩ unmittelbar vor einer betonten Silbe, und wenn sich die betonte Silbe in der Mitte eines Wortes befindet, markiert das Betonungszeichen in der Praxis ebenfalls eine Silbentrennung, beispielsweise im Wort „understood“ ⟨ /ʌndərˈstʊd/ ⟩ (wobei die Silbengrenze dennoch explizit durch einen Punkt markiert sein kann, [ 9 ] z. B. ⟨ /ʌn.dər.ˈstʊd/ ⟩).
Wenn ein Wortleerzeichen mitten in einer Silbe steht (d. h., wenn eine Silbe mehrere Wörter umfasst), kann ein Bindestrich ⟨ ‿ ⟩ zur Liaison verwendet werden , wie in der französischen Kombination les amis ⟨ /lɛ.z‿a.mi/ ⟩. Der Bindestrich wird auch verwendet, um lexikalische Wörter zu phonologischen Wörtern zu verbinden , zum Beispiel hot dog ⟨ /ˈhɒt‿dɒɡ/ ⟩.
Das griechische Sigma, ⟨σ⟩ , dient als Platzhalter für „Silbe“, und das Dollar-/Peso-Zeichen, ⟨$⟩ , markiert eine Silbengrenze, an der der übliche Punkt missverstanden werden könnte. Beispielsweise steht ⟨σσ⟩ für ein Silbenpaar und ⟨V$⟩ für einen Silbenendvokal.
Komponenten


Onset–nucleus–ripe Segmentierung
In diesem Rahmen besteht die allgemeine Struktur einer Silbe (σ) aus drei Segmenten, die in zwei Komponenten gruppiert sind:
- Anlaut (ω): Ein Konsonant oder eine Konsonantengruppe , in manchen Sprachen obligatorisch, in anderen optional oder sogar eingeschränkt.
- Reim (ρ): Rechter Ast, kontrastiert mit dem Anlaut, teilt sich in Kern und Ausklang.
- Nucleus (ν): Ein Vokal oder silbischer Konsonant , obligatorisch in den meisten Sprachen
- Coda (κ): Ein Konsonant oder eine Konsonantengruppe, in manchen Sprachen optional, in anderen stark eingeschränkt oder verboten.
Die Silbe wird üblicherweise als rechtsverzweigend betrachtet, d. h. Nukleus und Koda werden als „Reim“ zusammengefasst und erst auf der zweiten Ebene unterschieden.
Die an diesen Positionen befindlichen Laute können auch mit folgender Notation bezeichnet werden:
- Konsonant (C oder, für einen Konsonanten aus einer idiosynkratischen Menge von Möglichkeiten, X)
- Obstruent (T)
- Nasalkonsonant (N)
- Liquider Konsonant (L)
- Gleiten (G oder, seltener, H)
- Vokal (V)
- Ton (T oder, falls Verwechslungsgefahr mit einem Obstruenten besteht, ᵀ)
- ein exaktes Phonem oder sogar ein bestimmtes IPA-Symbol (ein bestimmtes IPA- Symbol)
möglicherweise mit der folgenden Notation zur Angabe der Häufigkeit:
- "Genau eins" (ohne Exponent)
- „Null oder Eins“ (in Klammern oder, seltener, mit einem Fragezeichen nach dem Buchstaben)
- „Null oder mehr“ ( * nach dem Buchstaben)
- "Ein oder mehrere" ( + nach dem Buchstaben)
Der Silbenkern ist üblicherweise der Vokal in der Mitte einer Silbe. [ 10 ] Der Anlaut ist der Laut oder die Laute vor dem Silbenkern, und die Koda (wörtlich „Schwanz“) ist der Laut oder die Laute, die auf den Silbenkern folgen. Sie werden manchmal zusammenfassend als Silbenschale bezeichnet . Der Begriff Reim umfasst Silbenkern und Koda. Im einsilbigen englischen Wort „ cat“ ( Katze ) ist der Silbenkern „a“ (der Laut, der allein gerufen oder gesungen werden kann), der Anlaut „c“ , die Koda „ t“ und der Reim „at“ . Diese Silbe kann als Konsonant-Vokal-Konsonant- Silbe (KVK) dargestellt werden . Sprachen unterscheiden sich stark in den Beschränkungen der Laute, aus denen Anlaut, Silbenkern und Koda einer Silbe bestehen, gemäß der sogenannten Phonotaktik der jeweiligen Sprache .
Obwohl jede Silbe suprasegmentale Merkmale aufweist, werden diese in der Regel ignoriert, wenn sie nicht semantisch relevant sind, z. B. in Tonsprachen .
Chinesische Segmentierung

In der Silbenstruktur der sinotibetischen Sprachen wird der Anlaut durch einen Initiallaut ersetzt, und ein Halbvokal oder Liquid bildet ein weiteres Segment, das als Medial bezeichnet wird. Diese vier Segmente werden in zwei leicht unterschiedliche Komponenten unterteilt:
- Initial ⟨ι⟩ : Optionaler Anlaut, ausgenommen Halbvokale
- Final ⟨φ⟩ : Medialer, Nukleus- und finaler Konsonant zusammengefasst [ 11 ]
- Ton ⟨τ⟩ : Kann von der gesamten Silbe oder vom Reim getragen werden
In vielen Sprachen des südostasiatischen Festlandes , wie beispielsweise im Chinesischen , ist die Silbenstruktur um ein zusätzliches, optionales Mittelsegment erweitert , das zwischen dem Anlaut (in diesem Kontext oft als Initial bezeichnet ) und dem Reim steht. Das Mittelsegment ist normalerweise ein Halbvokal , doch Rekonstruktionen des Altchinesischen enthalten im Allgemeinen auch Liquide ( /r/ in modernen Rekonstruktionen, /l/ in älteren Versionen), und viele Rekonstruktionen des Mittelchinesischen beinhalten einen Mittelkontrast zwischen /i/ und /j/ , wobei /i/ phonologisch als Gleitlaut und nicht als Teil des Silbenkerns fungiert. Darüber hinaus enthalten viele Rekonstruktionen des Alt- und Mittelchinesischen komplexe Mittelsegmente wie /rj/ , /ji/ , /jw/ und /jwi/ . Das Mittelsegment gruppiert sich phonologisch mit dem Reim und nicht mit dem Anlaut, und die Kombination aus Mittelsegment und Reim wird als Finali bezeichnet .
Manche Linguisten, insbesondere bei der Diskussion moderner chinesischer Varietäten, verwenden die Begriffe „Finale“ und „Reim“ synonym. In der historischen chinesischen Phonologie ist die Unterscheidung zwischen „Finale“ (einschließlich des Medialen) und „Reim“ (ohne Medialen) jedoch wichtig für das Verständnis der Reimwörterbücher und Reimtabellen , die die Hauptquellen für das Mittelchinesische bilden . Daher unterscheiden die meisten Autoren die beiden gemäß der oben genannten Definition.
Gruppierung der Komponenten


In einigen phonologischen Theorien werden Silbenstrukturen als Baumdiagramme dargestellt (ähnlich den Bäumen in manchen Syntaxmodellen). Nicht alle Phonologen sind sich einig, dass Silben eine innere Struktur besitzen; tatsächlich bezweifeln einige Phonologen die Existenz der Silbe als theoretische Einheit. [ 13 ]
Es gibt viele Argumente für eine hierarchische, nicht lineare Beziehung zwischen den Silbenbestandteilen. Ein hierarchisches Modell gruppiert Silbenkern und -koda zu einer Zwischenebene, dem Reim . Dieses Modell erklärt die Rolle, die die Silbenkern - Koda- Kombination im Vers spielt (z. B. werden Reimwörter wie „Katze“ und „Fledermaus“ durch die Übereinstimmung von Kern und Koda bzw. des gesamten Reims gebildet), sowie die Unterscheidung zwischen schweren und leichten Silben . Diese Unterscheidung ist relevant für phonologische Prozesse wie beispielsweise den Lautwandel im Altenglischen (scipu und wordu) . Bei einem Prozess namens Vokaltilgung (HVD) erhielten die Nominativ-/Akkusativpluralformen einsilbiger Wurzeln mit leichter Silbe (wie „*scip-“) im Altenglischen die Endung „u“, während Wurzeln mit schwerer Silbe (wie „*word-“) diese nicht erhielten, was zu „scip-u“ statt „word-∅“ führte. [ 14 ] [ 15 ] [ 16 ]
Körper

In einigen traditionellen Beschreibungen bestimmter Sprachen wie Cree und Ojibwe wird die Silbe als linksverzweigend betrachtet, d. h. Anlaut und Silbenkern bilden eine Gruppe unterhalb einer übergeordneten Einheit, die als „Körper“ oder „Kern“ bezeichnet wird. Dies steht im Gegensatz zur Koda.
Raureif
Der Reim einer Silbe besteht aus einem Silbenkern und einem optionalen Silbenausklang . Er ist der Teil der Silbe, der in den meisten poetischen Reimen verwendet wird , und der Teil, der gedehnt oder betont wird , wenn eine Person ein Wort in der Sprache dehnt oder betont.
Der Reim ist üblicherweise der Teil einer Silbe vom ersten Vokal bis zum Ende. Beispielsweise ist /æt/ der Reim aller Wörter „ at“ , „sat“ und „flat“ . In manchen Sprachen, wie etwa im Englischen, muss der Silbenkern jedoch nicht unbedingt ein Vokal sein. So ist beispielsweise der Reim der zweiten Silbe der Wörter „ bottle“ und „fiddle“ einfach /l/ , ein Liquid .
So wie sich der Reim in Nukleus und Koda aufteilt, können sich Nukleus und Koda jeweils in mehrere Phoneme aufteilen . Die maximale Anzahl an Phonemen pro Phonem variiert je nach Sprache. Beispielsweise kennen Japanisch und die meisten sino-tibetischen Sprachen keine Konsonantencluster am Silbenanfang oder -ende, während viele osteuropäische Sprachen mehr als zwei Konsonanten am Silbenanfang oder -ende aufweisen können. Im Englischen kann der Anlaut bis zu drei und der Koda bis zu vier Konsonanten enthalten. [ 17 ]
Rime und rhyme sind Varianten desselben Wortes, wobei die seltenere Form rime manchmal speziell den Silbenreim bezeichnet, um ihn vom poetischen Reim abzugrenzen . Diese Unterscheidung wird von einigen Linguisten nicht getroffen und findet sich in den meisten Wörterbüchern nicht.
| Struktur: | Silbe = | Beginn | + Reim |
|---|---|---|---|
| C + V + C*: | C₁ ( C₂ ) V₁ ( V₂ )(C₃ ) ( C₄ ) = | C 1 (C 2 ) | + V 1 (V 2 )(C 3 )(C 4 ) |
| V + C*: | V 1 (V 2 )(C 3 )(C 4 ) = | ∅ | + V 1 (V 2 )(C 3 )(C 4 ) |
Gewicht
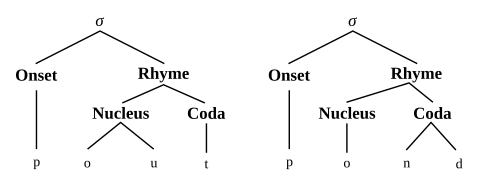
Eine schwere Silbe ist im Allgemeinen eine Silbe mit verzweigtem Reim , d. h. entweder eine geschlossene Silbe , die auf einen Konsonanten endet, oder eine Silbe mit verzweigtem Nukleus , also einem langen Vokal oder Diphthong . Die Bezeichnung ist metaphorisch und basiert auf der Vorstellung, dass der Nukleus oder die Koda in einem Baumdiagramm verzweigte Linien aufweist.
In manchen Sprachen gelten Silben mit VV (verzweigter Nukleus) und VC (verzweigter Reim) als schwer, im Gegensatz zu Silben mit V, die als leicht gelten . In anderen Sprachen werden nur VV-Silben als schwer betrachtet, während sowohl VC- als auch V-Silben als leicht gelten. Einige Sprachen unterscheiden einen dritten Typ von besonders schweren Silben , die aus VVC-Silben (mit verzweigtem Nukleus und Reim) oder VCC-Silben (mit einem Ausklang aus zwei oder mehr Konsonanten) oder beiden bestehen.
In der Moratheorie werden schwere Silben als Silben mit zwei Moras beschrieben, leichte Silben mit einer und besonders schwere Silben mit drei. Die japanische Phonologie wird im Allgemeinen auf diese Weise beschrieben.
Viele Sprachen verbieten überbetonte Silben, während eine beträchtliche Anzahl jegliche überbetonte Silben untersagt. Einige Sprachen streben nach einem gleichmäßigen Silbengewicht; beispielsweise treten im Italienischen in betonten, nicht finalen Silben kurze Vokale zusammen mit geschlossenen Silben auf, während lange Vokale mit offenen Silben vorkommen, sodass alle diese Silben überbetont sind (weder überbetont noch überbetont).
Der Unterschied zwischen betonten und unbetonten Silben bestimmt häufig, welche Silben betont werden – dies ist beispielsweise im Lateinischen und Arabischen der Fall. Das System des Versmaßes in vielen klassischen Sprachen, wie dem Altgriechischen , dem Altlateinischen , dem Alttamilischen und dem Sanskrit , basiert auf dem Silbengewicht und nicht auf der Betonung (sogenannter quantitativer Rhythmus oder quantitatives Metrum ).
Silbentrennung
Die Silbentrennung ist die Aufteilung eines Wortes in Silben, sowohl in der gesprochenen als auch in der geschriebenen Sprache. In den meisten Sprachen bilden die gesprochenen Silben auch die Grundlage für die schriftliche Silbentrennung. Da die Entsprechung zwischen Lauten und Buchstaben in der Rechtschreibung des modernen Englisch beispielsweise sehr schwach ist, basiert die schriftliche Silbentrennung im Englischen größtenteils auf etymologischen, d. h. morphologischen, anstatt auf phonetischen Prinzipien. Die geschriebenen englischen Silben entsprechen daher nicht den gesprochenen Silben der gesprochenen Sprache.
Phonotaktische Regeln legen fest, welche Laute in den einzelnen Silbenteilen erlaubt oder verboten sind. Im Englischen sind sehr komplexe Silben möglich; sie können mit bis zu drei Konsonanten beginnen (wie in „ strength “) und gelegentlich mit bis zu vier enden [ 17 ] (wie in „angsts“ , ausgesprochen [æŋsts]). Viele andere Sprachen sind deutlich restriktiver; Japanisch beispielsweise erlaubt im Silbenauslaut nur /ɴ/ und ein Chronem und kennt theoretisch überhaupt keine Konsonantencluster, da der Anlaut aus höchstens einem Konsonanten besteht. [ 18 ]
Die Verbindung eines Wortendkonsonanten mit einem Vokal am Wortanfang des unmittelbar folgenden Wortes ist ein fester Bestandteil der Phonetik einiger Sprachen, darunter Spanisch, Ungarisch und Türkisch. So wird im Spanischen der Ausdruck „ los hombres “ („die Männer“) als [loˈsom.bɾes] ausgesprochen , im Ungarischen „ az ember “ („der Mensch“) als [ɒˈzɛm.bɛr] und im Türkischen „ nefret ettim “ („ich hasste es“) als [nefˈɾe.tet.tim] . Im Italienischen kann ein finaler [j] -Laut in Enchaînement in die nächste Silbe verschoben werden, manchmal mit Gemination: z. B. wird „ non ne ho mai avuti “ („Ich habe noch nie einen davon gehabt“) in Silben zerlegt als [non.neˈɔ.ma.jaˈvuːti] und „io ci vado e lei anche“ („Ich gehe dorthin und sie auch“) wird realisiert als [jo.tʃiˈvaːdo.e.lɛjˈjaŋ.ke] . Ein verwandtes Phänomen, die Konsonantenmutation, findet sich in den keltischen Sprachen wie Irisch und Walisisch, wobei ungeschriebene (aber historische) Endkonsonanten den Anfangskonsonanten des folgenden Wortes beeinflussen.
Tautosyllabizität
Zwei oder mehr Segmente sind tautosyllabisch (zueinander verwandt), wenn sie in derselben Silbe vorkommen. [ 19 ] Beispielsweise ist das englische Wort „cat“ ( / k æ t / ) einsilbig , und somit sind seine drei Phoneme /k/ , /æ/ und /t/ tautosyllabisch. Man kann auch sagen, dass sie eine „tautosyllabische Verteilung“ aufweisen.
Phoneme, die nicht tautosyllabisch sind, heißen heterosyllabisch . Beispielsweise sind im englischen Wort „mustard“ / ˈ m ʌ s t ə r d / die Laute / m/ und /t/ heterosyllabisch, da sie zu verschiedenen Silben gehören.
Ambisyllabizität
Es kann Uneinigkeit über die Lage mancher Silbentrennungen in der gesprochenen Sprache geben. Die Problematik solcher Fälle wurde meist im Zusammenhang mit dem Englischen diskutiert. Im Fall eines Wortes wie „ hurry“ könnte die Trennung /hʌr.i/ oder /hʌ.ri/ lauten, wobei keine der beiden Varianten für einen nicht-rhotischen Akzent wie in der Standardaussprache (Received Pronunciation) eine zufriedenstellende Analyse darstellt : /hʌr.i/ führt zu einem silbenauslautenden /r/ , das normalerweise nicht vorkommt, während /hʌ.ri/ einen silbenauslautenden kurzen betonten Vokal ergibt, der ebenfalls nicht vorkommt.
Es lassen sich Argumente für die eine oder andere Lösung anführen: Eine allgemeine Regel besagt, dass „unter bestimmten Bedingungen […] Konsonanten mit der stärker betonten der beiden benachbarten Silben getrennt werden“ [ 20 ] , während viele andere Phonologen es vorziehen, Silben nach Möglichkeit mit dem oder den Konsonanten der folgenden Silbe zu trennen. Eine Alternative, die einige Zustimmung gefunden hat, ist die Behandlung eines intervokalischen Konsonanten als ambisyllabisch , d. h. als sowohl zur vorhergehenden als auch zur folgenden Silbe gehörig: /hʌṛi/ . Dies wird in der englischen Phonologie § Phonotaktik ausführlicher erörtert .
Ein weiteres Beispiel wäre der nasale Velar / ŋ / geschrieben ⟨ nh ⟩ im Galicischen, sodass das Wort ⟨unha⟩ in /'u.ŋa/ oder /'uŋ.a/ unterteilt werden könnte .
Beginn
Der Anlaut (auch Anlaut genannt ) ist der Konsonant oder die Konsonanten am Anfang einer Silbe, vor dem Silbenkern . Die meisten Silben haben einen Anlaut. Silben ohne Anlaut haben einen leeren Anlaut – es befindet sich also nichts an der Stelle , wo der Anlaut stehen würde.
Beginn des Clusters
Manche Sprachen beschränken den Anlaut auf einen einzigen Konsonanten, während andere nach verschiedenen Regeln auch mehrkonsonantige Anlaute zulassen. Im Englischen sind beispielsweise Anlaute wie pr- , pl- und tr- möglich , tl- jedoch nicht, und sk- ist möglich, ks- aber nicht. Im Griechischen hingegen sind sowohl ks- als auch tl- Anlaute möglich, während im klassischen Arabisch überhaupt keine mehrkonsonantigen Anlaute erlaubt sind.
Anlautcluster folgen oft dem Sonoritätssequenzierungsprinzip , d. h. Anlaute mit zunehmender Sonorität (/kl/) werden in der Regel solchen mit einem Plateau (/ll/) und noch stärker solchen mit abnehmender Sonorität (/lk/) vorgezogen; allerdings gibt es in vielen Sprachen Gegenbeispiele zu dieser Tendenz. [ 21 ]
Null-Onset
Manche Sprachen verbieten Nullansätze . In diesen Sprachen sind Wörter, die mit einem Vokal beginnen, wie das englische Wort „ at “, unmöglich.
Das ist weniger ungewöhnlich, als es zunächst scheinen mag, da die meisten dieser Sprachen Silben zulassen, die mit einem phonemischen Glottisverschluss beginnen (dem Laut in der Mitte des englischen „ uh-oh“ oder, in manchen Dialekten, dem doppelten T in „ button“ , im IPA als /ʔ/ wiedergegeben). Im Englischen kann ein Wort, das mit einem Vokal beginnt, nach einer Pause mit einem epenthetischen Glottisverschluss ausgesprochen werden , obwohl der Glottisverschluss in der jeweiligen Sprache kein Phonem sein muss.
Nur wenige Sprachen unterscheiden phonemisch zwischen Wörtern, die mit einem Vokal beginnen, und solchen, die mit einem Glottisverschluss und anschließendem Vokal beginnen, da dieser Unterschied in der Regel nur nach einem anderen Wort hörbar ist. Maltesisch und einige polynesische Sprachen hingegen unterscheiden tatsächlich, wie beispielsweise im Hawaiianischen /ahi/ („Feuer“) und /ʔahi / ← /kahi/ („Thunfisch“) sowie im Maltesischen /∅/ ← Arabisch /h/ und Maltesisch /k~ʔ/ ← Arabisch /q/ .
Im aschkenasischen und sephardischen Hebräisch werden א , ה und ע häufig ignoriert , und im Arabischen sind leere Anlaute verboten. Die Namen Israel , Abel , Abraham , Omar , Abdullah und Irak scheinen nicht in der ersten Silbe zu beginnen, aber in den ursprünglichen hebräischen und arabischen Formen beginnen sie tatsächlich mit verschiedenen Konsonanten: dem Halbvokal / j / in יִשְׂרָאֵל yisra'él , dem Stimmritzenfrikativ in / h / הֶבֶל heḇel , der Stimmritzenstopp / ʔ / in אַבְרָהָם 'aḇrāhām , oder der Rachenfrikativ / ʕ / in عُمَر ʿumar , عَبْدُ ٱللّٰه ʿabdu llāh , und عِرَاق ʿirāq . Umgekehrt verbietet die Arrernte-Sprache Zentralaustraliens möglicherweise Anlaute gänzlich; in diesem Fall haben alle Silben die Grundstruktur VC(C). [ 22 ]
Der Unterschied zwischen einer Silbe mit Nullanlaut und einer mit Glottisverschluss ist oft rein phonologischer Natur und betrifft nicht die tatsächliche Aussprache der Silbe. In manchen Fällen gibt die Aussprache eines (vermeintlich) vokalanlautenden Wortes nach einem anderen Wort – insbesondere das Einfügen eines Glottisverschlusses – Aufschluss darüber, ob das Wort als vokalanlautend gilt. Beispielsweise wird in vielen romanischen Sprachen wie Spanisch nie ein Glottisverschluss eingefügt, im Englischen hingegen nur gelegentlich, abhängig von Faktoren wie der Sprechgeschwindigkeit. In beiden Fällen deutet dies darauf hin, dass die betreffenden Wörter tatsächlich vokalanlautend sind.
Aber auch hier gibt es Ausnahmen. So verlangen sowohl das Standarddeutsche ( mit Ausnahme vieler süddeutscher Akzente) als auch das Arabische , dass zwischen einem Wort und einem folgenden, vermeintlich vokalanlautenden Wort ein Glottisverschluss eingefügt wird. Im Deutschen werden solche Wörter jedoch als mit einem Vokal beginnend wahrgenommen, im Arabischen hingegen als mit einem Glottisverschluss. Der Grund dafür liegt in anderen Eigenschaften der beiden Sprachen. Beispielsweise tritt im Deutschen in anderen Situationen kein Glottisverschluss auf, etwa vor einem Konsonanten oder am Wortende. Im Arabischen hingegen tritt der Glottisverschluss nicht nur in solchen Situationen auf (z. B. klassisch /saʔala/ „er fragte“, /raʔj/ „Meinung“, /dˤawʔ/ „Licht“), sondern auch in Alternationen, die eindeutig auf seinen phonemischen Status hinweisen (vgl. klassisch /kaːtib/ „Schreiber“ vs. /mak tuːb/ „geschrieben“, /ʔaːkil/ „Esser“ vs. /maʔkuːl/ „gegessen“). Mit anderen Worten: Während der Glottisverschluss im Deutschen vorhersehbar ist (er wird nur eingefügt, wenn eine betonte Silbe ansonsten mit einem Vokal beginnen würde), [ 23 ] ist derselbe Laut im Arabischen ein reguläres konsonantisches Phonem. Der Status dieses Konsonanten in den jeweiligen Schriftsystemen entspricht diesem Unterschied: In der deutschen Orthographie gibt es keinen Reflex des Glottisverschlusses , im arabischen Alphabet hingegen einen entsprechenden Buchstaben ( Hamza ).A)).
Das Schriftsystem einer Sprache stimmt möglicherweise nicht mit ihrer phonologischen Analyse hinsichtlich der Behandlung von (potenziellen) Nullanlauten überein. Beispielsweise wird in einigen Sprachen, die mit dem lateinischen Alphabet geschrieben werden , ein initialer Glottalverschluss nicht geschrieben (siehe das deutsche Beispiel). Andererseits verfügen einige Sprachen, die mit nicht-lateinischen Alphabeten wie Abjad- und Abugidas-Sprachen geschrieben werden, über einen speziellen Nullkonsonanten , um einen Nullanlaut darzustellen. Im Hangul , dem Alphabet der koreanischen Sprache , wird ein Nullanlaut beispielsweise durch ㅇ am linken oder oberen Ende eines Graphems dargestellt , wie in 역 „Bahnhof“, ausgesprochen „yeok “ , wobei der Diphthong yeo den Nukleus und k den Koda bildet.
Kern

| Wort | Kern |
|---|---|
| c a t [kæt] | [æ] |
| b e d [bɛd] | [ɛ] |
| o de [oʊd] | [oʊ] |
| bee t [ bit] | [ich] |
| b i te [baɪt] | [aɪ] |
| Regen [ ɻeɪn ] | [eɪ] |
| b i tt e n [ˈbɪt.ən] oder [ˈbɪt.n̩] | [ɪ] [ə] oder [n̩] |
Der Silbenkern ist üblicherweise der Vokal in der Mitte einer Silbe. Im Allgemeinen benötigt jede Silbe einen Silbenkern (manchmal auch als Silbenspitze bezeichnet ), und die Minimalsilbe besteht nur aus einem Silbenkern, wie in den englischen Wörtern „eye“ oder „owe“. Der Silbenkern ist üblicherweise ein Vokal in Form eines Monophthongs , Diphthongs oder Triphthongs , kann aber auch ein Silbenkonsonant sein .
Es wurde die These aufgestellt, dass eine Sprache, die das Auftreten bestimmter Konsonanten im Silbenkern erlaubt, auch alle Konsonanten mit höherer Sonorität zulässt , d. h. eine Sprache mit silbischen Frikativen müsste notwendigerweise auch silbische Nasale aufweisen, und silbische Obstruenten wären viel seltener als Liquide; beide Aussagen haben sich jedoch als falsch erwiesen. [ 24 ]
In den meisten germanischen Sprachen kommen ungespannte Vokale nur in geschlossenen Silben vor. Daher werden diese Vokale auch als gespannte Vokale bezeichnet , im Gegensatz zu den gespannten Vokalen, die als freie Vokale bezeichnet werden , da sie auch in offenen Silben vorkommen können.
Konsonantenkern
Einige Sprachen erlauben das Auftreten von Obstruenten im Silbenkern ohne dazwischenliegenden Vokal oder Sonoranten . [ 10 ] Die häufigsten silbischen Konsonanten sind Sonoranten wie [l] , [r] , [m] , [n] oder [ŋ] , wie im englischen „bottle “ oder im slowakischen „krv“ [krv]. [ 10 ] Im Englischen sind silbische Obstruenten jedoch in einigen paraverbalen onomatopoetischen Äußerungen wie „shh“ (um Stille zu befehlen) und „psst“ (um Aufmerksamkeit zu erregen) zulässig. Alle diese Laute wurden phonemisch als silbisch analysiert. Obstruentensilben kommen auch phonetisch in einigen prosodischen Situationen vor, wenn unbetonte Vokale zwischen Obstruenten elidieren, wie in potato [pʰˈteɪɾəʊ] und today [tʰˈdeɪ] , die sich trotz des Verlusts eines Silbenkerns nicht in ihrer Silbenzahl ändern.
Einige Sprachen besitzen sogenannte silbische Frikative , auch Frikativvokale genannt , auf phonemischer Ebene. (In der chinesischen Phonologie wird üblicherweise der verwandte, aber nicht synonyme Begriff „ apikaler Vokal“ verwendet.) Das Mandarin-Chinesische kennt solche Laute zumindest in einigen seiner Dialekte, beispielsweise die Pinyin -Silben sī shī rī , die üblicherweise [sź̩ ʂʐ̩́ ʐʐ̩́] ausgesprochen werden. Ähnlich wie beim r-Lautkern des englischen Wortes „ church“ besteht jedoch Uneinigkeit darüber, ob es sich bei diesen Lautkernen um Konsonanten oder Vokale handelt.
Die Sprachen der nordwestlichen Küste Nordamerikas, darunter Salishan , Wakashan und Chinook , erlauben Verschlusslaute und stimmlose Frikative als Silben auf phonemischer Ebene, selbst bei sorgfältigster Aussprache. Ein Beispiel ist Chinook [ɬtʰpʰt͡ʃʰkʰtʰ] ‚diese beiden Frauen kommen von hier aus dem Wasser‘. Silbische Obstruenten galten früher als sehr selten, doch Untersuchungen haben gezeigt, dass sie relativ häufig vorkommen und möglicherweise sogar häufiger sind als silbische Liquide . [ 25 ]
Weitere Beispiele:
- Nuxálk (Bella Coola)
- [ɬχʷtʰɬt͡sʰxʷ] 'Du hast mich angespuckt'
- [t͡sʼkʰtʰskʷʰt͡sʼ] 'Er ist angekommen'
- [xɬpʼχʷɬtʰɬpʰɬɬs] 'er hatte eine Kanadische Kornblume in seinem Besitz' [ 26 ]
- [sxs] 'Robbenfett'
Bagemihls Untersuchung bisheriger Analysen zeigt, dass das Bella-Coola-Wort /t͡sʼktskʷt͡sʼ/ „er kam an“ je nach Analysemethode in 0, 2, 3, 5 oder 6 Silben zerlegt werden könnte. Eine Analyse betrachtet alle Vokal- und Konsonantensegmente als Silbenkerne, eine andere nur eine kleine Untergruppe ( Frikative oder Zischlaute ) und eine weitere leugnet die Existenz von Silben gänzlich. Bei der Arbeit mit Aufnahmen anstelle von Transkriptionen sind die Silben in solchen Sprachen jedoch oft deutlich erkennbar, und Muttersprachler besitzen ein starkes intuitives Verständnis für deren Struktur.
Dieses Phänomen wurde auch in Berbersprachen (wie Indlawn Tashlhiyt Berber ), Mon-Khmer-Sprachen (wie Semai , Temiar , Khmu ) und dem Ōgami-Dialekt von Miyako , einer Ryukyu-Sprache , beobachtet . [ 27 ]
- Indlawn Tashlhiyt Berber
- [tftktst tfktstt] 'Du hast es dir verstaucht und es dann weitergegeben'
- [rkkm] 'rot' (imperf.) [ 28 ] [ 29 ]
- Semai
- [kckmrʔɛːc] 'kurze, dicke Arme' [ 30 ]
Sprachen mit langen Obstruentensequenzen stellen für verschiedene Silbenmodelle ein Problem dar. [ 25 ]
Koda
Die Koda (auch Auslaut genannt ) besteht aus den Konsonanten einer Silbe, die auf den Silbenkern folgen . Die Abfolge von Silbenkern und Koda wird als Reim bezeichnet . Manche Silben bestehen nur aus einem Silbenkern, nur aus einem Anlaut und einem Silbenkern ohne Koda oder nur aus einem Silbenkern und einer Koda ohne Anlaut.
Die Phonotaktik vieler Sprachen verbietet Silbenauslaute. Beispiele hierfür sind Suaheli und Hawaiianisch . In anderen Sprachen sind Auslaute auf eine kleine Auswahl der Anlautkonsonanten beschränkt. Im Japanischen beispielsweise darf ein Auslaut auf phonemischer Ebene nur ein Nasal (homorganisch mit jedem folgenden Konsonanten) oder, mitten im Wort, eine Gemination des folgenden Konsonanten sein. (Auf phonetischer Ebene entstehen weitere Auslaute durch die Elision von /i/ und /u/.) In anderen Sprachen ist nahezu jeder als Anlaut erlaubte Konsonant auch als Auslaut zulässig, sogar Konsonantencluster . Im Englischen beispielsweise sind alle Anlautkonsonanten außer /h/ als Silbenauslaute erlaubt.
Besteht der Auslaut aus einer Konsonantengruppe, nimmt die Sonorität typischerweise vom ersten zum letzten Konsonanten ab, wie im englischen Wort „help“ . Dies wird als Sonoritätshierarchie (oder Sonoritätsskala) bezeichnet. [ 31 ] Englische Anlaut- und Auslautkonsonantengruppen unterscheiden sich daher. Der Anlaut /str/ in „strengths“ kommt in keinem englischen Wort als Auslaut vor. Einige Konsonantengruppen treten jedoch sowohl als Anlaut als auch als Auslaut auf, wie beispielsweise /st/ in „stardust“ . Die Sonoritätshierarchie ist in manchen Sprachen strenger, in anderen weniger streng.
Geöffnet und geschlossen
Eine Silbe ohne Koda der Form V, CV, CCV usw. (V = Vokal, C = Konsonant) wird als offene oder freie Silbe bezeichnet , während eine Silbe mit Koda (VC, CVC, CVCC usw.) als geschlossene oder kontrollierte Silbe bezeichnet wird . Diese Definitionen von „offen“ und „geschlossen“ entsprechen nicht denen von offenen und geschlossenen Vokalen , sondern beziehen sich auf das Phonem am Silbenende: einen Vokal (offene Silbe) oder einen Konsonanten (geschlossene Silbe). Fast alle Sprachen kennen offene Silben, einige, wie beispielsweise Hawaiianisch , jedoch keine geschlossenen Silben.
Wenn eine Silbe nicht die letzte Silbe eines Wortes ist, müssen dem Silbenkern normalerweise zwei Konsonanten folgen, damit die Silbe geschlossen ist. Dies liegt daran, dass ein einzelner folgender Konsonant üblicherweise als Anlaut der folgenden Silbe gilt. Beispielsweise besteht das spanische Wort „ casar“ („heiraten“) aus einer offenen und einer geschlossenen Silbe ( ca-sar ), während „cansar “ („müde werden“) aus zwei geschlossenen Silben besteht ( can-sar ). Bei einem geminaten (doppelten) Konsonanten liegt die Silbengrenze in der Mitte, z. B. im italienischen „ panna “ ( „Sahne“ ); vgl. im italienischen „ pane “ („Brot“ ) .
Englische Wörter können aus einer einzigen geschlossenen Silbe bestehen, wobei der Nukleus mit ν und die Koda mit κ bezeichnet wird:
- i n : ν = /ɪ/ , κ = /n/
- cu p : ν = /ʌ/ , κ = /p/
- ta ll : ν = /ɔː/ , κ = /l/
- mi lk : ν = /ɪ/ , κ = /lk/
- ti nts : ν = /ɪ/ , κ = /nts/
- Fünftel : ν = /ɪ/ , κ = / fθs/
- si xths : ν = /ɪ/ , κ = /ksθs/
- zwölf Fünftel : ν = /ɛ/ , κ = /lfθs/
- Stärken : ν = /ɛ/ , κ = / ŋθs/
Englische Wörter können auch aus einer einzigen offenen Silbe bestehen, die mit einem Nukleus endet und keine Koda enthält:
- Kleber , ν = /uː/
- pie , ν = /aɪ/
- obwohl , ν = /oʊ/
- Junge , ν = /ɔɪ/
Eine Liste mit Beispielen für Silbenauslaute im Englischen finden Sie unter English phonology#Coda .
Null-Coda
Manche Sprachen verbieten Auslaute, sodass alle Silben offen sind. Beispiele hierfür sind Hawaiianisch aus der austronesischen Sprachfamilie und Swahili aus der atlantisch-kongoischen Sprachfamilie .
Suprasegmentale Merkmale
Der Bereich suprasegmentaler Merkmale ist eine Silbe (oder eine größere Einheit), aber nicht ein bestimmter Laut. Das heißt, diese Merkmale können mehr als ein einzelnes Segment und möglicherweise alle Segmente einer Silbe betreffen:
Manchmal wird auch die Silbenlänge als suprasegmentales Merkmal betrachtet; beispielsweise kommen in einigen germanischen Sprachen lange Vokale nur mit kurzen Konsonanten vor und umgekehrt. Silben lassen sich jedoch auch als Zusammensetzungen langer und kurzer Phoneme analysieren, wie im Finnischen und Japanischen, wo Konsonantengemination und Vokallänge unabhängig voneinander sind.
Ton
In den meisten Sprachen vermittelt die Tonhöhe oder Tonhöhenkontur , in der eine Silbe ausgesprochen wird, Bedeutungsnuancen wie Betonung oder Überraschung oder unterscheidet eine Aussage von einer Frage. In Tonsprachen hingegen beeinflusst die Tonhöhe die grundlegende lexikalische Bedeutung (z. B. „Katze“ vs. „Hund“) oder die grammatikalische Bedeutung (z. B. Vergangenheit vs. Gegenwart). In manchen Sprachen hat allein die Tonhöhe selbst (z. B. hoch vs. tief) diese Wirkung, während in anderen, insbesondere ostasiatischen Sprachen wie Chinesisch , Thailändisch oder Vietnamesisch , auch die Form oder Kontur (z. B. gleichbleibend vs. steigend vs. fallend) unterschieden werden muss.
Akzent
Die Silbenstruktur steht oft in Wechselwirkung mit der Betonung oder dem Tonhöhenakzent. Im Lateinischen beispielsweise wird die Betonung regelmäßig durch das Silbengewicht bestimmt ; eine Silbe gilt als stark betont, wenn sie mindestens eines der folgenden Merkmale aufweist:
In jedem Fall wird davon ausgegangen, dass die Silbe zwei Morae besitzt .
Die erste Silbe eines Wortes ist die Anfangssilbe und die letzte Silbe ist die Endsilbe .
In Sprachen, in denen eine der letzten drei Silben betont wird, heißt die letzte Silbe Ultima , die vorletzte Penultima und die drittletzte Antepenultima. Diese Begriffe stammen aus dem Lateinischen: ultima „letzte“, paenultima „fast letzte“ und antepaenultima „vor fast letzter“.
Im Altgriechischen gab es drei Akzentzeichen (Akut, Zirkumflex und Gravis), und Wörter wurden anhand der Position und Art des Akzents mit Begriffen beschrieben. Einige dieser Begriffe werden auch zur Beschreibung anderer Sprachen verwendet.
| Platzierung des Akzents | ||||
|---|---|---|---|---|
| Drittletzte Silbe | Vorletzter | Ultima | ||
| Akzentart | Zirkumflex | — | Properispomenon | Perispomenon |
| Akut | Proparoxyton | Paroxyton | Oxyton | |
| Beliebig | Baryton | — | ||
Geschichte
Guilhem Molinier , ein Mitglied des Consistori del Gay Saber , der ersten literarischen Akademie der Welt, die die Blumenspiele veranstaltete , um den besten Troubadour mit dem Hauptpreis violeta d'aur auszuzeichnen, gab in seinem Leys d'amor (1328–1337), einem Buch zur Regulierung der damals blühenden okzitanischen Dichtung, eine Definition der Silbe :
Sillaba votz es literals. Segon los ditz Gramaticals. Mit einem ausgesprochenen Akzent. Et en un trag: d'una alenada. | Eine Silbe ist der Klang mehrerer Buchstaben, so die sogenannten Grammatiker, ausgesprochen in einem Akzent und ununterbrochen: in einem Atemzug. |
Sprachübergreifende Muster
CV gilt als universeller Silbentyp, der in allen Sprachen der Welt vorkommt, wobei zwei australische Sprachen, Arrernte und der Oykangand-Dialekt von Kunjen , mögliche Ausnahmen darstellen. [ 32 ] CV ist der erste Silbentyp, den Kinder erwerben , und wenn eine Sprache nur einen Silbentyp besitzt, ist es immer CV (z. B. Hawaiianisch und Hua ). [ 33 ]
Es wurden mehrere Asymmetrien im Anlaut und Auslaut identifiziert. Alle Sprachen besitzen Silben mit Anlaut, aber etwa 12,6 % der Sprachen im WALS erlauben keinen Auslaut. [ 34 ] Die Liste der im Auslaut zulässigen Konsonanten ist in der Regel kleiner als die der im Anlaut zulässigen (z. B. gibt es in Norddeutschland keinen Kontrast zwischen stimmlosen und stimmhaften Konsonanten im Auslaut ). [ 34 ] Üblicherweise sind alle Kombinationen von Anlaut und Nukleus zulässig, der Auslautkonsonant ist jedoch manchmal durch den Nukleus eingeschränkt. [ 34 ]
Konsonantencluster sind im Anlaut typischer als im Auslaut. [ 35 ]
Antepenult, Penult und Ultima
Penult ist ein linguistischer Begriff für die vorletzte Silbe eines Wortes. Es ist eine Abkürzung von penultimate , was das vorletzte Element einer Aufzählung bezeichnet. Die Penult folgt auf die Antepenult (drittletzte Silbe) und geht der Ultima (letzten Silbe) voraus. Beispielsweise liegt die Hauptbetonung in englischen Wörtern wie banána und Mississippi sowie in fast allen Wörtern, die auf -ic enden , wie músic , frántic und phonétic , auf der Penult . Gelegentlich bezeichnet „penult“ auch das vorletzte Wort eines Satzes.
Die Begriffe werden häufig in Bezug auf Sprachen wie Latein und Altgriechisch verwendet , bei denen die Betonung eines Wortes nur auf einer der letzten drei Silben liegt, und manchmal auch in der Diskussion über das Versmaß . In bestimmten Sprachen, wie Walisisch [ 36 ] und Polnisch , liegt die Betonung immer auf der vorletzten Silbe. [ 37 ]
Morphologie
Komplexe Silben entstehen häufig durch morphologische Prozesse (z. B. hat das englische Wort „texts“ nach der Pluralbildung einen ungewöhnlichen Koda /kst-s/ ). [ 25 ] Manche Silbenmodelle schließen morphologisch komplexe Silben sogar von ihrer Analyse aus. [ 25 ] Gleichzeitig werden diese Silbencluster von Muttersprachlern früher erworben als solche, die innerhalb eines einzelnen Morphems entstehen, und sie sind weniger stark reduziert. [ 38 ]
Siehe auch
- Englische Phonologie #Phonotaktik . Behandelt die Silbenstruktur im Englischen.
- Zeile (Poesie)
- Liste der längsten englischen Wörter mit einer Silbe
- Nebensilbe
- Silbenschriftsystem
- Silbe (Informatik)
- Zeitliche Aspekte (Linguistik)
- Vokalese
Referenzen
- ^ de Jong, Kenneth (2003). „Zeitliche Beschränkungen und Charakterisierung der Silbenstrukturierung“. In: Local, John ; Ogden, Richard; Temple, Rosalind (Hrsg.). Phonetic Interpretation: Papers in Laboratory Phonology VI . Cambridge University Press. S. 254. doi : 10.1017/CBO9780511486425.015 . ISBN 978-0-521-82402-6Die
- ^ Ostersonntag 2019 , S. 3.
- ^ Ostersonntag 2019 , S. 1.
- ^ Ostersonntag 2019 , S. 3-4.
- ^ Hooker, JT (1990). „Einleitung“ . Die Vergangenheit lesen: Antike Schriften von der Keilschrift bis zum Alphabet . University of California Press; British Museum. S. 8. ISBN 0-520-07431-9Die
- ^ Harper, Douglas. „Silbe“ . Online Etymology Dictionary . Abgerufen am 5. Januar 2015 .
- ^ λαμβάνω . Liddell, Henry George ; Scott, Robert ; Ein griechisch-englisches Lexikon im Rahmen des Perseus-Projekts
- ^ Smyth 1920 , §523: Präsensstämme, die aus Suffixen mit ν gebildet werden.
- ^ Internationale Phonetische Vereinigung (Dezember 1989). „Bericht über die Kieler Konvention 1989: Internationale Phonetische Vereinigung“. Journal of the International Phonetic Association . 19 (2). Cambridge University Press: 75–76 . doi : 10.1017/S0025100300003868 . S2CID 249412330 .
- ^ a b c Ostersonntag 2019 , S. 10.
- ^ Allgemeiner bezeichnet der Buchstabe φ einen prosodischen Fuß aus zwei Silben.
- ^ Allgemeiner bezeichnet der Buchstabe μ eine Mora
- ^ Zur theoretischen Existenz der Silbe siehe „CUNY Conference on the Syllable“ . CUNY Phonology Forum . CUNY Graduate Center. Archiviert vom Original am 23. September 2015. Abgerufen am 21. Juni 2022 .
- ^ Bermúdez-Otero, Ricardo (2015). „Der Lebenszyklus der hohen Vokaltilgung im Altenglischen: von der Prosodie zur Schichtung und zum Verlust“ (PDF) . S. 2.
- ^ Fikkert, Paula; Dresher, Elan; Lahiri, Aditi (2006). „Kapitel 6, Prosodische Präferenzen: Vom Altenglischen zum Frühneuenglischen“. In: The Handbook of the History of English (PDF) . S. 134–135 . ISBN 9780470757048Die
- ^ Feng, Shengli (2003). Eine prosodische Grammatik des Chinesischen . Universität von Kansas. P. 3.
- ^ a b Hultzén, Lee S. (1965). „Consonant Clusters in English“ . American Speech . 40 (1): 5–19 . doi : 10.2307/454173 . ISSN 0003-1283 . JSTOR 454173 .
- ^ Shibatani, Masayoshi (1987). „Japanisch“. In: Bernard Comrie (Hrsg.). Die wichtigsten Sprachen der Welt . Oxford University Press. S. 855–880 . ISBN 0-19-520521-9Die
- ^ Sihler, Andrew L. (2000). Sprachgeschichte . Aktuelle Fragen der Sprachtheorie. Band 191. Amsterdam/Philadelphia: John Benjamins Publishing. S. 277. ISBN 90-272-3698-4Die
- ^ Wells, John C. (1990). „Syllabifizierung und Allophonie“. In: Ramsaran, Susan (Hrsg.). Studien zur Aussprache des Englischen: Ein Gedenkband zu Ehren von A. C. Gimson . Abingdon, UK: Routledge. S. 76–86 . ISBN 9781138918658Die
- ^ Ostersonntag 2019 , S. 9.
- ^ Breen, Gavan; Pensalfini, Rob (1999). „Arrernte: Eine Sprache ohne Silbenanlaute“ ( PDF) . Linguistic Inquiry . 30 (1): 1–25 . doi : 10.1162/002438999553940 . JSTOR 4179048. S2CID 57564955 .
- ^ Wiese, Richard (2000). Phonologie des Deutschen . Oxford University Press. S. 58–61 . ISBN 9780198299509Die
- ^ Ostersonntag 2019 , S. 10−11.
- ^ a b c d Ostersonntag 2019 , S. 11.
- ^ Bagemihl 1991 , S. 589, 593, 627
- ^ Pellard, Thomas (2010). „Ōgami (Miyako Ryukyuan)“. In: Shimoji, Michinori (Hrsg.). Einführung in die Ryukyu-Sprachen (PDF) . Fuchū, Tokio: Forschungsinstitut für Sprachen und Kulturen Asiens und Afrikas, Fremdsprachenuniversität Tokio. S. 113–166 . ISBN 978-4-86337-072-2Abgerufen am 21. Juni 2022 .HAL hal-00529598
- ^ Dell & Elmedlaoui 1985
- ^ Dell & Elmedlaoui 1988
- ^ Sloan 1988
- ^ Harrington, Jonathan; Cox, Felicity (August 2014). „Silbe und Fuß: Die silbischen und phonotaktischen Beschränkungen“ . Institut für Linguistik . Macquarie University . Abgerufen am 21. Juni 2022 .
- ^ Ostersonntag 2019 , S. 4−5.
- ^ Ostersonntag 2019 , S. 5.
- ^ a b c Ostersonntag 2019 , S. 6.
- ^ Ostersonntag 2019 , S. 6–7.
- ^ Walisisch, archiviert am 08.12.2015 in der Wayback Machine im Weltatlas der Sprachstrukturen
- ^ Kapitel 14: Feste Betonungspositionen (Archiviert am 07.12.2015 in der Wayback Machine im World Atlas of Language Structures)
- ^ Ostersonntag 2019 , S. 12.
Weiterführende Literatur
- Bagemihl, Bruce (1991). „Silbenstruktur im Bella Coola“. Linguistic Inquiry . 22 (4): 589–646 . JSTOR 4178744 .
- Clements, George N.; Keyser , Samuel J. (1983). CV-Phonologie: Eine generative Theorie der Silbe . Linguistic Inquiry Monographs. Band 9. Cambridge, Mass.: The MIT Press. ISBN 9780262030984Die
- Dell, François; Elmedlaoui, Mohamed (1985). „Syllabische Konsonanten und Silbentrennung im Imdlawn Tashlhiyt Berberischen“. Journal of African Languages and Linguistics . 7 (2): 105–130 . doi : 10.1515/jall.1985.7.2.105 . S2CID 29304770 .
- Dell, François; Elmedlaoui, Mohamed (1988). „Syllabische Konsonanten im Berberischen: Einige neue Erkenntnisse“. Journal of African Languages and Linguistics . 10 : 1–17 . doi : 10.1515/jall.1988.10.1.1 . S2CID 144470527 .
- Easterday, Shelece (2019). Hochkomplexe Silbenstruktur: Eine typologische und diachrone Studie . Language Science Press. ISBN 978-3-96110-194-8Abgerufen am 10.03.2025 .
- Ladefoged, Peter (2001). Phonetiklehre (4. Aufl.). Fort Worth, TX : Harcourt College Publishers. ISBN 0-15-507319-2Die
- Sloan, Kerry (1988). „Reduplikation von Konsonanten ohne Laute: Implikationen für eine prosodische Theorie der Reduplikation“. In: Borer, Hagit (Hrsg.). Proceedings of the Seventh West Coast Conference on Formal Linguistics . WCCFL 7. Irvine, CA: University of Chicago Press. S. 319–330 . ISBN 9780937073407Die
- Smyth, Herbert Weir (1920). Eine griechische Grammatik für Hochschulen . American Book Company . Abgerufen am 1. Januar 2014 – via CCEL .