In der Wahrscheinlichkeitstheorie und Statistik beschreibt die Exponentialverteilung bzw. negative Exponentialverteilung die Wahrscheinlichkeitsverteilung des Abstands zwischen Ereignissen in einem Poisson-Punktprozess , d. h. einem Prozess, in dem Ereignisse kontinuierlich und unabhängig mit einer konstanten mittleren Rate auftreten. Der Abstandsparameter kann jedes sinnvolle eindimensionale Maß des Prozesses sein, beispielsweise die Zeit zwischen Produktionsfehlern oder die Länge entlang einer Stoffrolle im Webereiprozess. [ 1 ] Sie ist ein Spezialfall der Gammaverteilung . Sie ist das kontinuierliche Analogon der geometrischen Verteilung und besitzt die wichtige Eigenschaft, gedächtnislos zu sein . [ 2 ] Neben ihrer Verwendung zur Analyse von Poisson-Punktprozessen findet sie Anwendung in verschiedenen anderen Kontexten. [ 3 ]
Die Exponentialverteilung ist nicht dasselbe wie die Klasse der Exponentialverteilungsfamilien . Letztere ist eine große Klasse von Wahrscheinlichkeitsverteilungen, zu der die Exponentialverteilung als eines ihrer Mitglieder gehört, aber auch viele andere Verteilungen wie die Normal- , Binomial- , Gamma- und Poissonverteilung . [ 3 ]
Definitionen
Wahrscheinlichkeitsdichtefunktion
Die Wahrscheinlichkeitsdichtefunktion (PDF) einer Exponentialverteilung ist

Hierbei ist λ > 0 der Parameter der Verteilung, oft auch Ratenparameter genannt . Die Verteilung ist im Intervall [0, ∞) definiert . Besitzt eine Zufallsvariable X diese Verteilung, so schreibt man X ~ Exp( λ ) .
Die Exponentialverteilung weist unendliche Teilbarkeit auf .
Kumulative Verteilungsfunktion
Die kumulative Verteilungsfunktion ist gegeben durch

Alternative Parametrisierung
Die Exponentialverteilung wird manchmal durch den Skalenparameter β = 1/ λ parametrisiert , der gleichzeitig der Mittelwert ist:

Eigenschaften
Mittelwert, Varianz, Momente und Median

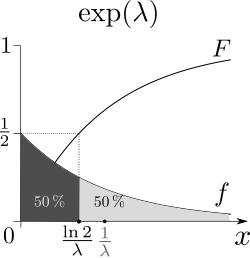
Der Mittelwert oder Erwartungswert einer exponentialverteilten Zufallsvariablen X mit Ratenparameter λ ist gegeben durch

Im Lichte der nachstehenden Beispiele ist dies nachvollziehbar; eine Person, die durchschnittlich zwei Anrufe pro Stunde erhält, kann davon ausgehen, dass die Zeit zwischen aufeinanderfolgenden Anrufen 0,5 Stunden oder 30 Minuten beträgt.
Die Varianz von X ist gegeben durch, daher ist die Standardabweichung gleich dem Mittelwert.

Die Momente von X , für sind gegeben durch


Die zentralen Momente von X , für sind gegeben durch wobei ! n die Subfakultät von n ist .

Der Median von X ist gegeben durch, wobei ln den natürlichen Logarithmus bezeichnet . Die absolute Differenz zwischen Mittelwert und Median beträgt somit


in Übereinstimmung mit der Median-Mittelwert-Ungleichung .
Gedächtnislosigkeitseigenschaft von Exponential-Zufallsvariablen
Eine exponentialverteilte Zufallsvariable T gehorcht der Beziehung

Dies lässt sich anhand der komplementären kumulativen Verteilungsfunktion erkennen :

Wenn T als Wartezeit bis zum Eintreten eines Ereignisses relativ zu einem Anfangszeitpunkt interpretiert wird, bedeutet diese Beziehung, dass die Verteilung der verbleibenden Wartezeit der ursprünglichen unbedingten Verteilung entspricht, wenn T unter der Bedingung steht, dass das Ereignis innerhalb eines anfänglichen Zeitraums s nicht beobachtet wird. Ist beispielsweise nach 30 Sekunden kein Ereignis eingetreten, so ist die bedingte Wahrscheinlichkeit , dass das Ereignis in mindestens weiteren 10 Sekunden eintritt, gleich der unbedingten Wahrscheinlichkeit, das Ereignis mehr als 10 Sekunden nach dem Anfangszeitpunkt zu beobachten.
Die Exponentialverteilung und die geometrische Verteilung sind die einzigen gedächtnislosen Wahrscheinlichkeitsverteilungen .
Folglich ist die Exponentialverteilung auch notwendigerweise die einzige stetige Wahrscheinlichkeitsverteilung mit einer konstanten Ausfallrate .
Quantile

Die Quantilfunktion (inverse kumulative Verteilungsfunktion) für Exp( λ ) ist

Die Quartile sind daher:
- erstes Quartil: ln(4/3)/ λ
- Median : ln(2)/ λ
- drittes Quartil: ln(4)/ λ
Und als Folge davon ist der Interquartilsabstand ln(3)/ λ .
Bedingter Wert bei Risiko (Erwarteter Verlust)
Der bedingte Value at Risk (CVaR), auch bekannt als Expected Shortfall oder Superquantil für Exp( λ ), wird wie folgt abgeleitet: [ 4 ]

Gepufferte Überschreitungswahrscheinlichkeit (bPOE)
Die gepufferte Überschreitungswahrscheinlichkeit ist eins minus dem Wahrscheinlichkeitsniveau, bei dem der CVaR dem Schwellenwert entspricht . Sie wird wie folgt hergeleitet: [ 4 ]


Kullback-Leibler-Divergenz
Die gerichtete Kullback-Leibler-Divergenz in nats der ("approximierenden" Verteilung) von der ("wahren" Verteilung) ist gegeben durch


Verteilung mit maximaler Entropie
Unter allen stetigen Wahrscheinlichkeitsverteilungen mit Träger [0, ∞) und Mittelwert μ besitzt die Exponentialverteilung mit λ = 1/ μ die größte differentielle Entropie . Anders ausgedrückt: Sie ist die Wahrscheinlichkeitsverteilung mit der maximalen Entropie für eine Zufallsvariable X , die größer oder gleich null ist und für die E[ X ] fest ist. [ 5 ]
Verteilung des Minimums von Exponential-Zufallsvariablen
Seien X₁ , ..., Xₙ unabhängige , exponentialverteilte Zufallsvariablen mit Ratenparametern λ₁ , ..., λₙ . Dann ist auch die Funktion exponentialverteilt mit dem Parameter


Dies lässt sich anhand der komplementären kumulativen Verteilungsfunktion erkennen :

Der Index der Variablen, die das Minimum erreicht, ist gemäß der kategorialen Verteilung verteilt.

Ein Beweis lässt sich durch Setzen von erbringen . Dann gilt:


Beachten Sie, dass die Verteilung nicht exponentialverteilt ist, wenn X 1 , ..., X n nicht alle den Parameter 0 haben. [ 6 ]

Gemeinsame Momente von iid Exponentialordnungsstatistiken
Seien unabhängige und identisch verteilte Exponential-Zufallsvariablen mit Ratenparameter λ . Seien die zugehörigen Ordnungsstatistiken . Für ist das gemeinsame Moment der Ordnungsstatistiken und gegeben durch


Dies lässt sich durch Anwendung des Gesetzes der totalen Erwartung und der Gedächtnislosigkeitseigenschaft zeigen:

Die erste Gleichung folgt aus dem Gesetz des totalen Erwartungswerts . Die zweite Gleichung nutzt die Tatsache, dass aus der Bedingung auf folgt, dass . Die dritte Gleichung beruht auf der Gedächtnislosigkeitseigenschaft, um durch zu ersetzen .


Summe zweier unabhängiger exponentialverteilter Zufallsvariablen
Die Wahrscheinlichkeitsdichtefunktion (PDF) einer Summe zweier unabhängiger Zufallsvariablen ist die Faltung ihrer einzelnen PDFs . Sind und unabhängige Exponential-Zufallsvariablen mit den jeweiligen Ratenparametern und , so ist die Wahrscheinlichkeitsdichte von gegeben durch . Die Entropie dieser Verteilung ist in geschlossener Form verfügbar: Unter der Annahme (ohne Beschränkung der Allgemeinheit) gilt , wobei die Euler -Mascheroni-Konstante und die Digammafunktion ist . [ 7 ]


Bei gleichen Ratenparametern ist das Ergebnis eine Erlang-Verteilung mit Form 2 und Parameter , die wiederum ein Spezialfall der Gamma-Verteilung ist .

Die Summe von n unabhängigen Exp( λ) exponentialverteilten Zufallsvariablen ist Gamma(n, λ) -verteilt.
Verwandte Distributionen
- Wenn X ~ Laplace(μ, β −1 ) , dann | X − μ| ~ Exp(β). [ 8 ]
- Wenn X ~ U (0, 1) dann −log( X ) ~ Exp(1).
- Wenn X ~ Pareto(1, λ) , dann ist log( X ) ~ Exp(λ). [ 8 ]
- Wenn X ~ SkewLogistic(θ) , dann .
- Wenn X i ~ U (0, 1) dann
- Die Exponentialverteilung ist ein Grenzwert einer skalierten Betaverteilung :
- Die Exponentialverteilung ist ein Spezialfall der Pearson-Verteilung vom Typ 3 .
- Die Exponentialverteilung ist der Spezialfall einer Gammaverteilung mit Formparameter 1. [ 8 ]
- Wenn X ~ Exp(λ) und X i ~ Exp(λ i ) dann:
- , Schließung unter Skalierung mit einem positiven Faktor.
- 1 + X ~ BenktanderWeibull (λ, 1), was sich auf eine abgeschnittene Exponentialverteilung reduziert.
- ke X ~ Pareto ( k , λ). [ 8 ]
- e −λX ~ U (0, 1) .
- e −X ~ Beta (λ, 1). [ 8 ]
- 1/ke X ~ Potenzgesetz ( k , λ )
- , die Rayleigh-Verteilung [ 8 ]
- , die Weibull-Verteilung [ 8 ]
- [ 8 ]
- μ − β log(λ X ) ∼ Gumbel (μ, β) .
- , eine geometrische Verteilung auf 0,1,2,3,...
- , eine geometrische Verteilung auf 1,2,3,4,...
- Wenn auch Y ~ Erlang( n , λ) oder dann
- Wenn auch λ ~ Gamma ( k , θ) (Form, Skalenparametrisierung), dann ist die Randverteilung von X Lomax ( k , 1/θ), die Gammamischung
- λ 1 X 1 − λ 2 Y 2 ~ Laplace(0, 1) .
- min{ X 1 , ..., X n } ~ Exp(λ 1 + ... + λ n ).
- Wenn auch λ i = λ gilt, dann:
- Wenn auch die X<sub> i</sub> unabhängig sind, dann:
- ~ U (0, 1)
- hat eine Wahrscheinlichkeitsdichtefunktion . Diese kann verwendet werden, um ein Konfidenzintervall für zu erhalten .
- Wenn auch λ = 1:
- , die logistische Verteilung
- μ − σ log( X ) ~ GEV(μ, σ, 0) .
- Weiterhin, wenn dann ( K-Verteilung )
- Wenn auch λ = 1/2, dann X ∼ χ2 2d. h., X ist χ²-verteilt mit 2 Freiheitsgraden . Daher:
- Wenn und ~ Poisson( X ) dann ( geometrische Verteilung )
- Die Hoyt-Verteilung kann aus der Exponentialverteilung und der Arcussinusverteilung abgeleitet werden.
- Die Exponentialverteilung ist in diesem Fall ein Grenzwert der κ -Exponentialverteilung .
- Die Exponentialverteilung ist ein Grenzwert der κ-verallgemeinerten Gammaverteilung in den Fällen und :


Weitere verwandte Distributionen:
- Hyperexponentielle Verteilung – die Verteilung, deren Dichte eine gewichtete Summe von Exponentialdichten ist.
- Hypoexponentialverteilung – die Verteilung einer allgemeinen Summe von Exponential-Zufallsvariablen. [ 8 ]
- ExGaussian-Verteilung – die Summe einer Exponentialverteilung und einer Normalverteilung .
Statistische Schlussfolgerung
Im Folgenden wird angenommen, dass die Zufallsvariable X exponentialverteilt ist mit dem Ratenparameter λ, und dass es sich um n unabhängige Stichproben aus X mit dem Stichprobenmittelwert handelt .


Parameterschätzung
Der Maximum-Likelihood -Schätzer für λ wird wie folgt konstruiert.
Die Likelihood-Funktion für λ, gegeben eine unabhängige und identisch verteilte Stichprobe x = ( x 1 , ..., x n ), die aus der Variablen gezogen wird, lautet:

wobei: der Stichprobenmittelwert ist.

Die Ableitung des Logarithmus der Likelihood-Funktion ist:

Folglich ergibt sich die Maximum-Likelihood -Schätzung für den Ratenparameter zu:

Dies ist kein erwartungstreuer Schätzer für , obwohl es sich um einen erwartungstreuen [ 10 ] MLE [ 11 ] Schätzer für und den Mittelwert der Verteilung handelt.


Die Verzerrung von ist gleich , was den verzerrungskorrigierten Maximum-Likelihood-Schätzer ergibt.


Ein approximativer Minimierer des mittleren quadratischen Fehlers (siehe auch: Bias-Varianz-Tradeoff ) kann unter der Annahme einer Stichprobengröße größer als zwei mit einem Korrekturfaktor für den MLE gefunden werden: Dieser wird aus dem Mittelwert und der Varianz der inversen Gammaverteilung abgeleitet . [ 12 ]


Fisher-Informationen
Die Fisher-Information , bezeichnet mit , für einen Schätzer des Ratenparameters ist gegeben als:


Durch Einsetzen der Verteilung und Auflösen erhält man:

Dies bestimmt, wie viel Information jede unabhängige Stichprobe einer Exponentialverteilung über den unbekannten Ratenparameter enthält .
Konfidenzintervalle
Ein exaktes 100(1 − α)% Konfidenzintervall für den Ratenparameter einer Exponentialverteilung ist gegeben durch: [ 13 ] was auch gleich ist, wobei χ2 p , vist das 100( p ) -Perzentil der Chi-Quadrat-Verteilung mit v Freiheitsgraden , n ist die Anzahl der Beobachtungen und x̄ der Stichprobenmittelwert. Eine einfache Näherung für die exakten Intervallgrenzen kann mithilfe einer Normalapproximation der χ²-Verteilung hergeleitet werden.2 p , vVerteilung. Diese Näherung liefert die folgenden Werte für ein 95%-Konfidenzintervall:


Diese Näherung kann für Proben mit mindestens 15 bis 20 Elementen akzeptabel sein. [ 14 ]
Bayes'sche Inferenz mit konjugiertem Prior
Die konjugierte A-priori- Verteilung der Exponentialverteilung ist die Gammaverteilung (deren Spezialfall die Exponentialverteilung ist). Die folgende Parametrisierung der Wahrscheinlichkeitsdichtefunktion der Gammaverteilung ist hilfreich:

Die A-posteriori-Verteilung p kann dann mithilfe der oben definierten Likelihood-Funktion und einer Gamma-Prior-Verteilung ausgedrückt werden:

Die A-posteriori-Dichte p ist nun bis auf eine fehlende Normierungskonstante angegeben. Da sie die Form einer Gamma-Wahrscheinlichkeitsdichtefunktion hat, kann diese leicht ergänzt werden, und man erhält:

Hierbei kann der Hyperparameter α als die Anzahl der vorherigen Beobachtungen und β als die Summe der vorherigen Beobachtungen interpretiert werden. Der a posteriori-Mittelwert ist hier:

Bayes'sche Inferenz mit kalibrierender Priori
Die Exponentialverteilung ist eine von mehreren statistischen Verteilungen mit Gruppenstruktur . Aufgrund dieser Gruppenstruktur besitzt die Exponentialverteilung ein zugehöriges Haar-Maß . Die Verwendung des Haar-Maßes als A- priori-Verteilung (bekannt als Haar-Prior) in einer Bayes'schen Vorhersage liefert perfekt kalibrierte Wahrscheinlichkeiten für beliebige zugrunde liegende wahre Parameterwerte. [ 15 ] [ 16 ] [ 17 ] Perfekt kalibrierte Wahrscheinlichkeiten haben die Eigenschaft, dass die vorhergesagten Wahrscheinlichkeiten exakt mit der Häufigkeit von Ereignissen außerhalb der Stichprobe übereinstimmen. Für die Exponentialverteilung existiert ein exakter Ausdruck für Bayes'sche Vorhersagen, die mithilfe des Haar-Priors generiert werden.


Dies ist ein Beispiel für die Kalibrierung der Prior-Vorhersage, bei der die Prior-Verteilung so gewählt wird, dass die Kalibrierung verbessert (und in diesem Fall perfektioniert) wird. Die Kalibrierung der Prior-Vorhersage für die Exponentialfunktion mithilfe der Haar-Prior-Verteilung ist im R -Softwarepaket fitdistcp implementiert. [1]
Dieselbe Vorhersage kann aus einer Reihe anderer Perspektiven abgeleitet werden, wie im Abschnitt „Vorhersage“ weiter unten erläutert wird.
Vorkommen und Anwendungen
Eintreten von Ereignissen
Die Exponentialverteilung ergibt sich auf natürliche Weise, wenn man die Längen der Zwischenankunftszeiten in einem homogenen Poisson-Prozess beschreibt .
Die Exponentialverteilung kann als kontinuierliches Gegenstück zur geometrischen Verteilung betrachtet werden , welche die Anzahl der Bernoulli-Versuche beschreibt , die für einen Zustandswechsel eines diskreten Prozesses erforderlich sind. Im Gegensatz dazu beschreibt die Exponentialverteilung die Zeit, die ein kontinuierlicher Prozess für einen Zustandswechsel benötigt.
In realen Szenarien ist die Annahme einer konstanten Rate (oder Wahrscheinlichkeit pro Zeiteinheit) selten erfüllt. Beispielsweise variiert die Anzahl eingehender Anrufe je nach Tageszeit. Betrachtet man jedoch ein Zeitintervall, in dem die Rate annähernd konstant ist, etwa von 14 bis 16 Uhr an Werktagen, kann die Exponentialverteilung als gutes Näherungsmodell für die Zeit bis zum nächsten Anruf verwendet werden. Ähnliche Einschränkungen gelten für die folgenden Beispiele, die zu annähernd exponentialverteilten Variablen führen:
- Die Zeit bis zum Zerfall eines radioaktiven Teilchens oder die Zeit zwischen zwei Klicks eines Geigerzählers.
- Die Zeitspanne zwischen dem Empfang eines Anrufs und dem nächsten
- Die Zeit bis zum Zahlungsausfall (gegenüber den Gläubigern des Unternehmens) in der reduzierten Form der Kreditrisikomodellierung
Exponentialvariablen können auch verwendet werden, um Situationen zu modellieren, in denen bestimmte Ereignisse mit einer konstanten Wahrscheinlichkeit pro Längeneinheit auftreten, wie zum Beispiel der Abstand zwischen Mutationen auf einem DNA- Strang oder zwischen Verkehrsopfern auf einer bestimmten Straße.
In der Warteschlangentheorie werden die Bedienzeiten von Akteuren in einem System (z. B. die Wartezeit eines Bankangestellten auf einen Kunden) häufig als exponentialverteilte Variablen modelliert. (Die Ankunft von Kunden wird beispielsweise ebenfalls durch die Poisson-Verteilung modelliert , sofern die Ankünfte unabhängig und identisch verteilt sind.) Die Dauer eines Prozesses, der als Folge mehrerer unabhängiger Aufgaben betrachtet werden kann, folgt der Erlang-Verteilung (der Verteilung der Summe mehrerer unabhängiger exponentialverteilter Variablen).
Zuverlässigkeitstheorie und Zuverlässigkeitstechnik nutzen die Exponentialverteilung häufig. Aufgrund ihrer Gedächtnislosigkeit eignet sie sich gut zur Modellierung des Abschnitts mit konstanter Ausfallrate in der Badewannenkurve der Zuverlässigkeitstheorie. Zudem ist sie sehr praktisch, da sich Ausfallraten leicht in ein Zuverlässigkeitsmodell integrieren lassen. Die Exponentialverteilung ist jedoch nicht geeignet, die Gesamtlebensdauer von Organismen oder technischen Geräten zu modellieren, da die Ausfallraten hier nicht konstant sind: Sehr junge und sehr alte Systeme weisen mehr Ausfälle auf.

In der Physik folgen die Höhen der einzelnen Moleküle eines Gases bei konstanter Temperatur und konstantem Druck in einem homogenen Gravitationsfeld annähernd einer Exponentialverteilung, der sogenannten barometrischen Formel . Dies ist eine Folge der unten erwähnten Entropie.
In der Hydrologie wird die Exponentialverteilung verwendet, um Extremwerte von Variablen wie monatlichen und jährlichen Maximalwerten der täglichen Niederschlagsmenge und der Flussabflussmengen zu analysieren. [ 18 ]
- Die blaue Abbildung veranschaulicht beispielhaft die Anpassung der Exponentialverteilung an die geordneten jährlichen maximalen Tagesniederschlagswerte und zeigt zudem den 90% -Konfidenzbereich basierend auf der Binomialverteilung . Die Niederschlagsdaten werden durch die Darstellung der Positionen im Rahmen der kumulativen Häufigkeitsanalyse visualisiert .
Im OP-Management bezeichnet man die Verteilung der Operationsdauer für eine Kategorie von Operationen ohne typischen Arbeitsinhalt (wie in einer Notaufnahme, die alle Arten von Operationen umfasst).
Vorhersage
Nachdem man n Datenpunkte aus einer unbekannten Exponentialverteilung beobachtet hat , besteht eine gängige Aufgabe darin, anhand dieser Stichproben Vorhersagen über zukünftige Daten aus derselben Quelle zu treffen. Eine häufig verwendete Vorhersageverteilung für zukünftige Stichproben ist die sogenannte Plug-in-Verteilung. Sie entsteht, indem man einen geeigneten Schätzwert für den Ratenparameter λ in die Exponentialdichtefunktion einsetzt. Ein gängiger Schätzwert ist derjenige, der sich aus dem Prinzip der maximalen Wahrscheinlichkeit ergibt. Mit diesem Schätzwert erhält man die Vorhersagedichte für eine zukünftige Stichprobe x <sub>n +1</sub> , bedingt durch die beobachteten Stichproben x = ( x <sub>1</sub> , ..., x <sub> n</sub> ), gegeben durch

Der Bayes'sche Ansatz liefert eine Vorhersageverteilung, die die Unsicherheit des geschätzten Parameters berücksichtigt, wobei dies jedoch entscheidend von der Wahl der A-priori-Verteilung abhängen kann.
Eine prädiktive Verteilung, die frei von den Problemen der Prior-Wahl ist, die im Rahmen des subjektiven Bayes'schen Ansatzes auftreten, ist

was als
- eine frequentistische Konfidenzverteilung , die aus der Verteilung der Pivotgröße gewonnen wird ; [ 19 ]
- eine Profilvorhersagewahrscheinlichkeit, die durch Eliminierung des Parameters λ aus der gemeinsamen Wahrscheinlichkeit von x n +1 und λ durch Maximierung erhalten wird; [ 20 ].
- Eine objektive Bayes'sche prädiktive A-posteriori-Verteilung, die mithilfe der nicht-informativen Jeffreys-Priorverteilung 1/ λ gewonnen wird, welche in diesem Fall der rechten Haar-Priorverteilung entspricht. Vorhersagen, die mit der rechten Haar-Priorverteilung generiert werden, liefern garantiert perfekt kalibrierte Wahrscheinlichkeiten. [ 21 ] [ 22 ]
- die bedingte normalisierte Maximum-Likelihood-Vorhersageverteilung (CNML) aus informationstheoretischen Überlegungen. [ 23 ]

Die Genauigkeit einer Vorhersageverteilung kann anhand der Distanz oder Divergenz zwischen der wahren Exponentialverteilung mit dem Ratenparameter λ₀ und der auf der Stichprobe x basierenden Vorhersageverteilung gemessen werden . Die Kullback - Leibler -Divergenz ist ein häufig verwendetes, parametrisierungsfreies Maß für die Differenz zwischen zwei Verteilungen. Bezeichnet Δ( λ₀ || p ) die Kullback-Leibler-Divergenz zwischen einer Exponentialverteilung mit dem Ratenparameter λ₀ und einer Vorhersageverteilung p, so lässt sich zeigen, dass

Dabei wird der Erwartungswert bezüglich der Exponentialverteilung mit dem Ratenparameter λ <sub> 0 </sub> ∈ (0, ∞) berechnet , und ψ(·) ist die Digammafunktion. Es ist ersichtlich, dass die CNML-Vorhersageverteilung der Maximum-Likelihood-Plug-in-Verteilung hinsichtlich der mittleren Kullback-Leibler-Divergenz für alle Stichprobenumfänge n > 0 deutlich überlegen ist .
Zufallsvariablengenerierung
Eine konzeptionell sehr einfache Methode zur Erzeugung von Exponentialvariablen basiert auf der inversen Transformationsstichprobe : Gegeben sei eine Zufallsvariable U, die aus der Gleichverteilung im Einheitsintervall (0, 1) gezogen wird .

besitzt eine Exponentialverteilung, wobei F −1 die Quantilfunktion ist , definiert durch

Wenn U auf (0, 1) gleichverteilt ist, dann ist auch 1 − U gleichverteilt . Das bedeutet, dass man Exponentialvariablen wie folgt erzeugen kann:

Weitere Methoden zur Erzeugung von Exponentialvariablen werden von Knuth [ 24 ] und Devroye [ 25 ] diskutiert.
Es ist auch eine schnelle Methode zur Erzeugung eines Satzes von fertig geordneten Exponentialvariablen ohne Verwendung einer Sortierroutine verfügbar. [ 25 ]
Siehe auch
- Totzeit – eine Anwendung der Exponentialverteilung auf die Analyse von Teilchendetektoren.
- Laplace-Verteilung oder die „doppelte Exponentialverteilung“.
- Beziehungen zwischen Wahrscheinlichkeitsverteilungen
- Marshall-Olkin-Exponentialverteilung
Referenzen
- ^ „7.2: Exponentialverteilung“ . Statistics LibreTexts . 15.07.2021 . Abgerufen am 11.10.2024 .
- ^ „Exponentialverteilung | Mathematik | Britannica“ . www.britannica.com . Abgerufen am 11.10.2024 .
- ^ a b Weisstein, Eric W. „Exponentialverteilung“ . mathworld.wolfram.com . Abgerufen am 11.10.2024 .
- ^ a b Norton, Matthew; Khokhlov, Valentyn; Uryasev, Stan (2019). „Calculating CVaR and bPOE for common probability distributions with application to portfolio optimization and density estimation“ (PDF) . Annals of Operations Research . 299 ( 1–2 ). Springer: 1281–1315 . arXiv : 1811.11301 . doi : 10.1007/s10479-019-03373-1 . Archiviert vom Original (PDF) am 31.03.2023 . Abgerufen am 27.02.2023 .
- ^ Park, Sung Y.; Bera, Anil K. (2009). „Maximum entropy autoregressive conditional heteroskedasticity model“ (PDF) . Journal of Econometrics . 150 (2). Elsevier: 219–230 . doi : 10.1016/j.jeconom.2008.12.014 . Archiviert vom Original (PDF) am 7. März 2016. Abgerufen am 2. Juni 2011 .
- ^ Michael, Lugo. „Der Erwartungswert des Maximums von Exponentialfunktionen“ (PDF) . Archiviert vom Original (PDF) am 20. Dezember 2016. Abgerufen am 13. Dezember 2016 .
- ^ Eckford, Andrew W.; Thomas, Peter J. (2016). „Entropie der Summe zweier unabhängiger, nicht identisch verteilter Exponential-Zufallsvariablen“. arXiv : 1609.02911 [ cs.IT ].
- ^ a b c d e f g h i Leemis, Lawrence M.; McQuestion, Jacquelyn T. (Februar 2008). „Univariate Verteilungsbeziehungen“ (PDF) . The American Statistician . 62 (1): 45–53. doi : 10.1198/000313008X270448 .
- ^ Ibe, Oliver C. (2014). Grundlagen der angewandten Wahrscheinlichkeitstheorie und Zufallsprozesse (2. Aufl.). Academic Press. S. 128. ISBN 9780128010358Die
- ^ Richard Arnold Johnson; Dean W. Wichern (2007). Angewandte multivariate statistische Analyse . Pearson Prentice Hall. ISBN 978-0-13-187715-3Abgerufen am 10. August 2012 .
- ^ NIST/SEMATECH e-Handbuch statistischer Methoden
- ^ Elfessi, Abdulaziz; Reineke, David M. (2001). „Ein Bayes’scher Blick auf die klassische Schätzung: Die Exponentialverteilung“ . Journal of Statistics Education . 9 (1). doi : 10.1080/10691898.2001.11910648 .
- Ross , Sheldon M. (2009). Einführung in Wahrscheinlichkeitstheorie und Statistik für Ingenieure und Naturwissenschaftler (4. Aufl.). Associated Press. S. 267. ISBN 978-0-12-370483-2Die
- ^ Guerriero, V. (2012). „Potenzgesetzverteilung: Methode der multiskaligen Inferenzstatistik“ . Journal of Modern Mathematics Frontier . 1 : 21–28 .
- Severini , TA (2002-12-01). „Über eine exakte Wahrscheinlichkeitsanpassungseigenschaft von rechtsinvarianten Priors“ . Biometrika . 89 (4): 952–957 . doi : 10.1093/biomet/89.4.952 . ISSN 0006-3444 .
- ^ Gerrard, R.; Tsanakas, A. (2011). „Fehlerwahrscheinlichkeit bei Parameterunsicherheit“ . Risk Analysis . 31 (5): 727–744 . Bibcode : 2011RiskA..31..727G . doi : 10.1111/j.1539-6924.2010.01549.x . ISSN 1539-6924 . PMID 21175720 .
- Jewson , Stephen; Sweeting, Trevor; Jewson, Lynne (2025-02-20). „Reduzierung von Zuverlässigkeitsverzerrungen bei der Bewertung von Extremwetterrisiken durch kalibrierende Priors“ . Advances in Statistical Climatology, Meteorology and Oceanography . 11 (1): 1–22 . Bibcode : 2025ASCMO..11....1J . doi : 10.5194/ascmo-11-1-2025 . ISSN 2364-3579 .
- ^ Ritzema, HP (Hrsg.) (1994). Frequenz- und Regressionsanalyse . Kapitel 6 in: Entwässerungsprinzipien und -anwendungen, Publikation 16, Internationales Institut für Landgewinnung und -verbesserung (ILRI), Wageningen, Niederlande. S. 175–224 . ISBN 90-70754-33-9Die
- ^ Lawless, JF; Fredette, M. (2005). „Frequentistische Vorhersageintervalle und Vorhersageverteilungen“. Biometrika . 92 (3): 529–542 . doi : 10.1093/biomet/92.3.529 .
- ^ Bjornstad, JF (1990). „Predictive Likelihood: A Review“ . Statist. Sci . 5 (2): 242–254 . doi : 10.1214/ss/1177012175 .
- Severini , Thomas A.; Mukerjee, Rahul; Ghosh, Malay (1. Dezember 2002). „Über eine exakte Wahrscheinlichkeitsanpassungseigenschaft von rechtsinvarianten Priors“ . Biometrika . 89 (4): 952–957 . doi : 10.1093/biomet/89.4.952 . ISSN 0006-3444 .
- Jewson , Stephen; Sweeting, Trevor; Jewson, Lynne (2025-02-20). „Reduzierung von Zuverlässigkeitsverzerrungen bei der Bewertung von Extremwetterrisiken durch kalibrierende Priors“ . Advances in Statistical Climatology, Meteorology and Oceanography . 11 (1): 1–22 . Bibcode : 2025ASCMO..11....1J . doi : 10.5194/ascmo-11-1-2025 . ISSN 2364-3579 .
- ^ D. F. Schmidt und E. Makalic, „ Universelle Modelle für die Exponentialverteilung “, IEEE Transactions on Information Theory , Band 55, Nummer 7, S. 3087–3090, 2009, doi : 10.1109/TIT.2009.2018331
- ^ Donald E. Knuth (1998). Die Kunst der Computerprogrammierung , Band 2: Seminumerische Algorithmen , 3. Auflage. Boston: Addison-Wesley. ISBN 0-201-89684-2Siehe Abschnitt 3.4.1, S. 133.
- ^ a b Luc Devroye (1986). Nicht-uniforme Zufallsvariablenerzeugung . New York: Springer-Verlag. ISBN 0-387-96305-7Siehe Kapitel IX , Abschnitt 2, S. 392–401 .