| Teil einer Serie über |
| Maschinelles Lernen und Data Mining |
|---|
| Teil einer Serie über |
| Künstliche Intelligenz (KI) |
|---|
Maschinelles Lernen ( ML ) ist ein Forschungsgebiet der künstlichen Intelligenz, das sich mit der Entwicklung und Untersuchung statistischer Algorithmen befasst , die aus Daten lernen und auf unbekannte Daten generalisieren können und somit Aufgaben ausführen , ohne explizit programmiert zu werden . [ 1 ] Fortschritte im Bereich des Deep Learning haben es neuronalen Netzen , einer Klasse statistischer Algorithmen, ermöglicht, viele frühere Ansätze des maschinellen Lernens hinsichtlich ihrer Leistungsfähigkeit zu übertreffen.
Statistik und mathematische Optimierungsmethoden bilden die Grundlage des maschinellen Lernens. Data Mining ist ein verwandtes Forschungsgebiet, das sich mit explorativer Datenanalyse (EDA) mittels unüberwachtem Lernen befasst . [ 3 ] [ 4 ]
Aus theoretischer Sicht bietet das wahrscheinlich annähernd korrekte Lernen einen mathematischen und statistischen Rahmen zur Beschreibung von maschinellem Lernen. Die meisten traditionellen Algorithmen des maschinellen Lernens und des Deep Learning lassen sich in diesem Rahmen als empirische Risikominimierung beschreiben .
Geschichte
Der Begriff „maschinelles Lernen“ wurde 1959 von Arthur Samuel , einem IBM- Mitarbeiter und Pionier auf dem Gebiet der Computerspiele und der künstlichen Intelligenz, geprägt . [ 5 ] [ 6 ] Das Synonym „ selbstlernende Computer“ wurde in dieser Zeit ebenfalls verwendet. [ 7 ] [ 8 ]
Das erste maschinelle Lernprogramm wurde in den 1950er Jahren eingeführt, als Samuel ein Computerprogramm entwickelte , das die Gewinnchancen beim Damespiel für jede Seite berechnete. Die Geschichte des maschinellen Lernens wurzelt jedoch in jahrzehntelangen Bemühungen, menschliche kognitive Prozesse zu erforschen. [ 9 ] 1949 veröffentlichte der kanadische Psychologe Donald Hebb das Buch „Die Organisation des Verhaltens“ , in dem er eine theoretische neuronale Struktur vorstellte, die durch bestimmte Interaktionen zwischen Nervenzellen gebildet wird . [ 10 ] Die Hebbsche Theorie der neuronalen Interaktion legte den Grundstein für die Funktionsweise vieler Algorithmen des maschinellen Lernens, wobei verbundene künstliche Neuronen die Stärke ihrer Verbindungen anhand von Daten verändern. [ 9 ] Auch andere Forscher, die menschliche kognitive Systeme untersuchten, trugen zu den modernen Technologien des maschinellen Lernens bei, darunter Walter Pitts und Warren McCulloch , die das erste mathematische Modell neuronaler Netze vorschlugen, das Algorithmen enthält , die menschliche Denkprozesse widerspiegeln. [ 9 ]
Anfang der 1960er-Jahre entwickelte die Raytheon Company mit Cybertron eine experimentelle „Lernmaschine“ mit Lochstreifenspeicher . Diese analysierte Sonarsignale , Elektrokardiogramme und Sprachmuster mithilfe rudimentärer Methoden des bestärkenden Lernens . Sie wurde von einem menschlichen Bediener/Lehrer wiederholt trainiert, um Muster zu erkennen, und war mit einer „ Fehlertaste “ ausgestattet, die eine Neubewertung fehlerhafter Entscheidungen veranlasste. [ 11 ] Ein repräsentatives Werk zur Forschung im Bereich des maschinellen Lernens in den 1960er-Jahren war Nils Nilssons Buch „Learning Machines“, das sich hauptsächlich mit maschinellem Lernen für die Musterklassifizierung befasste . [ 12 ] Das Interesse an Mustererkennung hielt auch in den 1970er-Jahren an, wie Duda und Hart 1973 beschrieben. [ 13 ] 1981 wurde ein Bericht über die Anwendung von Lehrstrategien veröffentlicht, mit denen ein künstliches neuronales Netzwerk lernt, 40 Zeichen (26 Buchstaben, 10 Ziffern und 4 Sonderzeichen) von einem Computerterminal zu erkennen. [ 14 ]
Tom M. Mitchell lieferte eine vielzitierte, formalere Definition der im Bereich des maschinellen Lernens untersuchten Algorithmen: „Ein Computerprogramm lernt aus Erfahrung E in Bezug auf eine Klasse von Aufgaben T und ein Leistungsmaß P, wenn sich seine Leistung bei Aufgaben in T , gemessen durch P , mit der Erfahrung E verbessert .“ [ 15 ] Diese Definition der Aufgaben, mit denen sich maschinelles Lernen befasst, ist im Wesentlichen operational und definiert das Feld nicht kognitiv. Sie folgt Alan Turings Vorschlag in seinem Aufsatz „ Computing Machinery and Intelligence “, in dem die Frage „Können Maschinen denken?“ durch die Frage ersetzt wird, ob Maschinen einen Menschen in seinen Antworten auf von Menschen gestellte Fragen überzeugend imitieren können. [ 16 ] [ 17 ]
Im Jahr 2014 führten Ian Goodfellow und andere generative adversarial networks (GANs) ein, die realistische synthetische Daten erzeugen können. [ 18 ] Bis 2016 hatte AlphaGo mithilfe von Reinforcement-Learning- Techniken gegen die besten menschlichen Go- Spieler gewonnen . [ 19 ]
Beziehungen zu anderen Bereichen
Künstliche Intelligenz

Als wissenschaftliches Unterfangen entstand maschinelles Lernen aus dem Streben nach künstlicher Intelligenz (KI). In den Anfängen der KI als akademische Disziplin interessierten sich einige Forscher dafür, Maschinen aus Daten lernen zu lassen. Sie versuchten, das Problem mit verschiedenen symbolischen Methoden sowie mit sogenannten „ neuronalen Netzen “ anzugehen; dabei handelte es sich meist um Perzeptronen und andere Modelle , die sich später als Weiterentwicklungen der verallgemeinerten linearen Modelle der Statistik herausstellten. [ 21 ] Auch probabilistisches Schließen wurde eingesetzt, insbesondere in der automatisierten medizinischen Diagnose . [ 22 ] : 488
Die zunehmende Betonung des logischen, wissensbasierten Ansatzes führte jedoch zu einer Kluft zwischen KI und maschinellem Lernen. Probabilistische Systeme litten unter theoretischen und praktischen Problemen der Datenerfassung und -repräsentation. [ 22 ] : 488 Um 1980 dominierten Expertensysteme die KI, und die Statistik verlor an Bedeutung. [ 23 ] Die Forschung zum symbolischen/wissensbasierten Lernen wurde innerhalb der KI fortgesetzt und führte zur induktiven logischen Programmierung (ILP). Der eher statistische Forschungszweig verlagerte sich jedoch nun außerhalb des eigentlichen KI-Bereichs hin zur Mustererkennung und Informationswiedergewinnung . [ 22 ] : 708–710, 755 Die Forschung zu neuronalen Netzen wurde von KI und Informatik etwa zur gleichen Zeit aufgegeben. Dieses Teilgebiet, der sogenannte Konnektionismus , wurde von Forschern anderer Disziplinen, darunter John Hopfield , David Rumelhart und Geoffrey Hinton , weitergeführt . Ihren größten Erfolg erzielten sie Mitte der 1980er Jahre mit der Wiederentdeckung der Backpropagation . [ 22 ] : 25
Maschinelles Lernen (ML), das neu organisiert und als eigenständiges Forschungsgebiet anerkannt wurde, erlebte in den 1990er Jahren einen Aufschwung. Das Ziel des Forschungsfeldes verlagerte sich von der Entwicklung künstlicher Intelligenz hin zur Lösung praktischer Probleme. Der Fokus verlagerte sich weg von den symbolischen Ansätzen, die es von der KI übernommen hatte, hin zu Methoden und Modellen aus Statistik, Fuzzy-Logik und Wahrscheinlichkeitstheorie . [ 23 ]
Datenkomprimierung
Zwischen maschinellem Lernen und Datenkomprimierung besteht ein enger Zusammenhang. Ein System, das die A -posteriori-Wahrscheinlichkeiten einer Sequenz anhand ihrer gesamten Historie vorhersagt, kann zur optimalen Datenkomprimierung genutzt werden (durch arithmetische Codierung der Ausgabeverteilung). Umgekehrt kann ein optimaler Kompressor zur Vorhersage verwendet werden (indem das Symbol ermittelt wird, das sich unter Berücksichtigung der vorherigen Historie am besten komprimieren lässt). Diese Äquivalenz wurde als Begründung dafür herangezogen, Datenkomprimierung als Maßstab für „allgemeine Intelligenz“ zu verwenden. [ 24 ] [ 25 ] [ 26 ]
Eine alternative Sichtweise zeigt, dass Kompressionsalgorithmen Zeichenketten implizit auf implizite Merkmalsraumvektoren abbilden und kompressionsbasierte Ähnlichkeitsmaße die Ähnlichkeit innerhalb dieser Merkmalsräume berechnen. Für jeden Kompressor C(.) definieren wir einen zugehörigen Vektorraum ℵ, sodass C(.) eine Eingabezeichenkette x auf die Vektornorm ||~x|| abbildet. Eine vollständige Untersuchung der allen Kompressionsalgorithmen zugrunde liegenden Merkmalsräume ist aus Platzgründen nicht möglich; stattdessen werden in „Feature Vectors“ drei repräsentative verlustfreie Kompressionsverfahren untersucht: LZW, LZ77 und PPM. [ 27 ]
Laut der AIXI- Theorie, deren Zusammenhang im Hutter-Preis genauer erläutert wird , ist die bestmögliche Komprimierung von x die kleinstmögliche Software, die x erzeugt. Beispielsweise umfasst die komprimierte Größe einer ZIP-Datei in diesem Modell sowohl die ZIP-Datei selbst als auch die Entpackungssoftware, da sie ohne beides nicht entpackt werden kann. Es könnte jedoch eine noch kleinere kombinierte Form geben.
Beispiele für KI-gestützte Audio-/Videokomprimierungssoftware sind NVIDIA Maxine und AIVC. [ 28 ] Beispiele für Software, die KI-gestützte Bildkomprimierung durchführen kann, sind OpenCV , TensorFlow , die Image Processing Toolbox (IPT) von MATLAB und High-Fidelity Generative Image Compression. [ 29 ]
Im unüberwachten maschinellen Lernen kann das K-Means-Clustering zur Datenkomprimierung eingesetzt werden, indem ähnliche Datenpunkte in Clustern gruppiert werden. Diese Technik vereinfacht die Handhabung umfangreicher Datensätze ohne vordefinierte Labels und findet breite Anwendung in Bereichen wie der Bildkomprimierung . [ 30 ]
Die Datenkomprimierung zielt darauf ab, die Größe von Datendateien zu reduzieren, die Speichereffizienz zu steigern und die Datenübertragung zu beschleunigen. K-Means-Clustering, ein unüberwachter Algorithmus des maschinellen Lernens, wird eingesetzt, um einen Datensatz in eine festgelegte Anzahl von Clustern (k) zu unterteilen, wobei jeder Cluster durch den Schwerpunkt seiner Punkte repräsentiert wird. Dieser Prozess komprimiert umfangreiche Datensätze zu einer kompakteren Menge repräsentativer Punkte. K-Means-Clustering ist besonders vorteilhaft in der Bild- und Signalverarbeitung , da es die Datenmenge reduziert, indem es Gruppen von Datenpunkten durch ihre Schwerpunkte ersetzt. Dadurch bleiben die Kerninformationen der Originaldaten erhalten, während der benötigte Speicherplatz deutlich verringert wird. [ 31 ]
Große Sprachmodelle (LLMs) eignen sich auch hervorragend zur verlustfreien Datenkomprimierung bestimmter Datensätze, wie die Forschung von DeepMind mit dem Modell Chinchilla 70B gezeigt hat. Das von DeepMind entwickelte Chinchilla 70B komprimierte Daten effektiv und übertraf dabei herkömmliche Methoden wie PNG für Bilder und FLAC für Audio. Es erreichte eine Komprimierung von Bild- und Audiodaten auf 43,4 % bzw. 16,4 % ihrer ursprünglichen Größe. Allerdings besteht Anlass zur Sorge, dass sich der für die Tests verwendete Datensatz mit dem Trainingsdatensatz des LLM überschneidet. Daher ist es möglich, dass das Modell Chinchilla 70B nur bei Daten, mit denen es bereits trainiert wurde, effizient komprimiert. [ 32 ] [ 33 ]
Data-Mining
Maschinelles Lernen und Data Mining verwenden oft dieselben Methoden und überschneiden sich stark. Während sich maschinelles Lernen auf Vorhersagen basierend auf bekannten , aus den Trainingsdaten gelernten Eigenschaften konzentriert, zielt Data Mining auf die Entdeckung bisher unbekannter Eigenschaften in den Daten ab (dies ist der Analyseschritt der Wissensentdeckung in Datenbanken). Data Mining nutzt viele Methoden des maschinellen Lernens, jedoch mit unterschiedlichen Zielen. Umgekehrt verwendet maschinelles Lernen auch Data-Mining-Methoden als „ unüberwachtes Lernen “ oder als Vorverarbeitungsschritt zur Verbesserung der Genauigkeit der Lernalgorithmen. Ein Großteil der Verwirrung zwischen diesen beiden Forschungsbereichen rührt von den grundlegenden Annahmen her, mit denen sie arbeiten: Im maschinellen Lernen wird die Leistung üblicherweise anhand der Fähigkeit bewertet, bekanntes Wissen zu reproduzieren, während bei Wissensentdeckung und Data Mining (KDD) die Entdeckung bisher unbekannten Wissens im Vordergrund steht. Bezogen auf bekanntes Wissen wird eine unüberwachte Methode von anderen überwachten Methoden leicht übertroffen. In einer typischen KDD-Aufgabe können überwachte Methoden jedoch aufgrund fehlender Trainingsdaten nicht eingesetzt werden.
Maschinelles Lernen ist eng mit Optimierung verknüpft : Viele Lernprobleme werden als Minimierung einer Verlustfunktion auf einem Trainingsdatensatz formuliert. Verlustfunktionen drücken die Diskrepanz zwischen den Vorhersagen des trainierten Modells und den tatsächlichen Problemfällen aus (beispielsweise möchte man bei der Klassifizierung Instanzen ein Label zuweisen , und Modelle werden trainiert, um die vorgegebenen Labels eines Beispieldatensatzes korrekt vorherzusagen). [ 34 ]
Verallgemeinerung
Die Charakterisierung der Generalisierungsfähigkeit verschiedener Lernalgorithmen ist ein aktives Thema aktueller Forschung, insbesondere im Hinblick auf Deep-Learning -Algorithmen.
Statistiken
Maschinelles Lernen und Statistik sind methodisch eng verwandte Gebiete, unterscheiden sich aber in ihrem Hauptziel: Die Statistik zieht Rückschlüsse auf die Gesamtpopulation aus einer Stichprobe , während maschinelles Lernen verallgemeinerbare Vorhersagemuster findet. [ 35 ]
Konventionelle statistische Analysen erfordern die Vorauswahl eines für den Datensatz am besten geeigneten Modells. Zudem werden nur signifikante oder theoretisch relevante Variablen, basierend auf bisherigen Erfahrungen, in die Analyse einbezogen. Maschinelles Lernen hingegen basiert nicht auf einem vordefinierten Modell; vielmehr formen die Daten das Modell, indem sie zugrundeliegende Muster erkennen. Je mehr Variablen (Eingabedaten) zum Trainieren des Modells verwendet werden, desto genauer ist das resultierende Modell. [ 36 ]
Leo Breiman unterschied zwei statistische Modellierungsparadigmen: das Datenmodell und das algorithmische Modell, [ 37 ] wobei „algorithmisches Modell“ mehr oder weniger die Algorithmen des maschinellen Lernens wie Random Forest meint .
Einige Statistiker haben Methoden des maschinellen Lernens übernommen und damit das Gebiet des statistischen Lernens geschaffen . [ 38 ]
Statistische Physik
Analytische und computergestützte Verfahren, die auf den Grundlagen der Physik ungeordneter Systeme basieren, lassen sich auf großskalige Probleme, wie beispielsweise maschinelles Lernen, ausweiten, etwa zur Analyse des Gewichtsraums tiefer neuronaler Netze . [ 39 ] Die statistische Physik findet somit Anwendung im Bereich der medizinischen Diagnostik . [ 40 ]
Theorie
Ein zentrales Ziel eines Lernsystems ist die Generalisierung aus seinen Erfahrungen. [ 2 ] [ 41 ] Generalisierung bezeichnet in diesem Zusammenhang die Fähigkeit eines Lernsystems, nach dem Training mit einem Datensatz neue, unbekannte Beispiele/Aufgaben präzise zu lösen. Die Trainingsbeispiele stammen aus einer im Allgemeinen unbekannten Wahrscheinlichkeitsverteilung (die als repräsentativ für den Raum der möglichen Ereignisse gilt), und das Lernsystem muss ein allgemeines Modell dieses Raums entwickeln, das es ihm ermöglicht, in neuen Fällen ausreichend genaue Vorhersagen zu treffen.
Die computergestützte Analyse von Algorithmen des maschinellen Lernens und ihrer Leistungsfähigkeit ist ein Teilgebiet der theoretischen Informatik, die sogenannte Lerntheorie . Ein wichtiger Ansatz ist das Modell des wahrscheinlich annähernd korrekten Lernens . Da Trainingsdatensätze endlich und die Zukunft ungewiss sind, liefert die Lerntheorie in der Regel keine Leistungsgarantien für Algorithmen. Stattdessen sind probabilistische Leistungsgrenzen üblich. Die Bias-Varianz-Zerlegung ist eine Möglichkeit, den Generalisierungsfehler zu quantifizieren .
Für eine optimale Generalisierung sollte die Komplexität der Hypothese der Komplexität der den Daten zugrunde liegenden Funktion entsprechen. Ist die Hypothese weniger komplex als die Funktion, ist das Modell unterangepasst. Eine Erhöhung der Modellkomplexität verringert den Trainingsfehler. Ist die Hypothese jedoch zu komplex, neigt das Modell zur Überanpassung , und die Generalisierungsfähigkeit verschlechtert sich. [ 42 ]
Neben Leistungsgrenzen untersuchen Lerntheoretiker auch die Zeitkomplexität und die Durchführbarkeit von Lernprozessen. In der algorithmischen Lerntheorie gilt eine Berechnung als durchführbar, wenn sie in Polynomialzeit abgeschlossen werden kann . Es gibt zwei Arten von Ergebnissen zur Zeitkomplexität : Positive Ergebnisse zeigen, dass eine bestimmte Funktionsklasse in Polynomialzeit erlernt werden kann. Negative Ergebnisse zeigen, dass bestimmte Klassen nicht in Polynomialzeit erlernt werden können.
Ansätze

Maschinelle Lernverfahren werden traditionell in drei große Kategorien unterteilt, die Lernparadigmen entsprechen, je nach Art des dem Lernsystem zur Verfügung stehenden „Signals“ oder „Feedbacks“:
- Überwachtes Lernen : Dem Computer werden von einem „Lehrer“ Beispieleingaben und die dazugehörigen gewünschten Ausgaben präsentiert. Ziel ist es, eine allgemeine Regel zu lernen, die Eingaben Ausgaben zuordnet .
- Unüberwachtes Lernen : Dem Lernalgorithmus werden keine Labels vorgegeben, sodass er selbstständig Strukturen in den Eingabedaten erkennen muss. Unüberwachtes Lernen kann ein Selbstzweck sein (Entdeckung verborgener Muster in Daten) oder ein Mittel zum Zweck ( Merkmalslernen ).
- Reinforcement Learning : Ein Computerprogramm interagiert mit einer dynamischen Umgebung, in der es ein bestimmtes Ziel erreichen muss (z. B. ein Fahrzeug steuern oder ein Spiel gegen einen Gegner spielen). Während es sich in seinem Problemraum bewegt, erhält das Programm Belohnungen als Feedback, die es zu maximieren versucht, wodurch es aus Erfahrung lernt. [ 2 ]
Obwohl jeder Algorithmus Vor- und Nachteile hat, ist kein einzelner Algorithmus für alle Probleme geeignet. [ 43 ] [ 44 ] [ 45 ]
Überwachtes Lernen

Überwachte Lernalgorithmen erstellen ein mathematisches Modell eines Datensatzes, das sowohl die Eingaben als auch die gewünschten Ausgaben enthält. [ 46 ] Die Daten, die als Trainingsdaten bezeichnet werden , bestehen aus einer Menge von Trainingsbeispielen. Jedes Trainingsbeispiel besitzt eine oder mehrere Eingaben und die gewünschte Ausgabe, auch als Überwachungssignal bezeichnet. Im mathematischen Modell wird jedes Trainingsbeispiel durch ein Array oder einen Vektor, manchmal auch Merkmalsvektor genannt, repräsentiert , und die Trainingsdaten werden durch eine Matrix dargestellt . Durch iterative Optimierung einer Zielfunktion lernen überwachte Lernalgorithmen eine Funktion, mit der die Ausgabe für neue Eingaben vorhergesagt werden kann. [ 47 ] Eine optimale Funktion ermöglicht es dem Algorithmus, die Ausgabe auch für Eingaben, die nicht Teil der Trainingsdaten waren, korrekt zu bestimmen. Ein Algorithmus, der die Genauigkeit seiner Ausgaben oder Vorhersagen im Laufe der Zeit verbessert, hat diese Aufgabe gelernt. [ 15 ]
Zu den Arten von überwachten Lernalgorithmen gehören aktives Lernen , Klassifizierung und Regression . [ 48 ] Klassifizierungsalgorithmen kommen zum Einsatz, wenn die Ausgaben auf eine begrenzte Anzahl von Werten beschränkt sind, während Regressionsalgorithmen verwendet werden, wenn die Ausgaben jeden numerischen Wert innerhalb eines Bereichs annehmen können. Beispielsweise ist bei einem Klassifizierungsalgorithmus, der E-Mails filtert, die Eingabe eine eingehende E-Mail und die Ausgabe der Ordner, in dem die E-Mail abgelegt werden soll. Im Gegensatz dazu wird die Regression für Aufgaben wie die Vorhersage der Körpergröße einer Person anhand von Faktoren wie Alter und Genetik oder die Prognose zukünftiger Temperaturen auf Basis historischer Daten verwendet. [ 49 ]
Ähnlichkeitslernen ist ein Bereich des überwachten maschinellen Lernens, der eng mit Regression und Klassifizierung verwandt ist. Ziel ist es, anhand von Beispielen mithilfe einer Ähnlichkeitsfunktion zu lernen, die die Ähnlichkeit oder Verwandtschaft zweier Objekte misst. Es findet Anwendung in Ranking- Systemen , Empfehlungssystemen , visueller Identitätserkennung, Gesichtserkennung und Sprecherverifizierung.
Unüberwachtes Lernen
Unüberwachte Lernalgorithmen erkennen Strukturen in Daten, die weder gelabelt noch klassifiziert oder kategorisiert wurden. Anstatt auf Feedback zu reagieren, identifizieren sie Gemeinsamkeiten in den Daten und reagieren auf deren Vorhandensein oder Fehlen in jedem neuen Datenelement. Zentrale Anwendungen des unüberwachten maschinellen Lernens sind Clustering , Dimensionsreduktion [ 4 ] und Dichteschätzung [ 50 ] .
Die Clusteranalyse ordnet eine Menge von Beobachtungen Teilmengen (Clustern ) zu , sodass Beobachtungen innerhalb desselben Clusters nach einem oder mehreren vordefinierten Kriterien ähnlich sind, während Beobachtungen aus verschiedenen Clustern unähnlich sind. Verschiedene Clustering-Verfahren treffen unterschiedliche Annahmen über die Struktur der Daten, die häufig durch ein Ähnlichkeitsmaß definiert und beispielsweise durch interne Kompaktheit (die Ähnlichkeit zwischen den Elementen desselben Clusters) und Separation (den Unterschied zwischen Clustern) bewertet werden. Andere Methoden basieren auf geschätzter Dichte und Konnektivität des Graphen .
Eine spezielle Form des unüberwachten Lernens, das sogenannte selbstüberwachte Lernen, beinhaltet das Trainieren eines Modells durch die Generierung des Überwachungssignals aus den Daten selbst. [ 51 ] [ 52 ]
Dimensionsreduktion
Dimensionsreduktion ist ein Verfahren zur Verringerung der Anzahl der betrachteten Zufallsvariablen durch die Ermittlung einer Menge von Hauptvariablen. [ 53 ] Anders ausgedrückt: Es handelt sich um die Reduzierung der Dimension des Merkmalsatzes , auch „Anzahl der Merkmale“ genannt. Die meisten Dimensionsreduktionsverfahren lassen sich entweder der Merkmalseliminierung oder der Merkmalsextraktion zuordnen . Eine der gängigen Methoden ist die Hauptkomponentenanalyse (PCA). Die PCA transformiert höherdimensionale Daten (z. B. 3D) in einen kleineren Raum (z. B. 2D). Die Mannigfaltigkeitshypothese besagt, dass hochdimensionale Datensätze auf niedrigdimensionalen Mannigfaltigkeiten liegen . Viele Dimensionsreduktionsverfahren basieren auf dieser Annahme und führen zu den Bereichen Mannigfaltigkeitslernen und Mannigfaltigkeitsregularisierung .
Halbüberwachtes Lernen
Semi-überwachtes Lernen liegt zwischen unüberwachtem Lernen (ohne gelabelte Trainingsdaten) und überwachtem Lernen (mit vollständig gelabelten Trainingsdaten). Bei einigen Trainingsbeispielen fehlen die Trainingslabels. Dennoch haben viele Forscher im Bereich des maschinellen Lernens festgestellt, dass ungelabelte Daten, in Kombination mit einer kleinen Menge gelabelter Daten, die Lerngenauigkeit deutlich verbessern können.
Beim schwach überwachten Lernen sind die Trainingslabels verrauscht, begrenzt oder ungenau; allerdings sind diese Labels oft kostengünstiger zu beschaffen, was zu größeren effektiven Trainingsdatensätzen führt. [ 54 ]
Verstärkungslernen
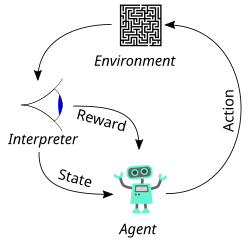
Reinforcement Learning ist ein Teilgebiet des maschinellen Lernens, das sich damit befasst, wie Softwareagenten in einer Umgebung agieren sollten, um eine bestimmte kumulative Belohnung zu maximieren. Aufgrund seiner Allgemeingültigkeit wird es in vielen anderen Disziplinen untersucht, darunter Spieltheorie , Kontrolltheorie , Operations Research , Informationstheorie , simulationsbasierte Optimierung , Multiagentensysteme , Schwarmintelligenz , Statistik und genetische Algorithmen . Im Reinforcement Learning wird die Umgebung typischerweise als Markov-Entscheidungsprozess (MDP) dargestellt. Viele Reinforcement-Learning-Algorithmen nutzen dynamische Programmierungstechniken . [ 55 ] Reinforcement-Learning-Algorithmen setzen kein exaktes mathematisches Modell des MDP voraus und kommen zum Einsatz, wenn exakte Modelle nicht realisierbar sind. Sie werden beispielsweise in autonomen Fahrzeugen oder beim Erlernen von Spielstrategien gegen menschliche Gegner eingesetzt.
Andere Arten
Es wurden weitere Ansätze entwickelt, die sich nicht eindeutig in diese dreifache Kategorisierung einordnen lassen, und manchmal werden von ein und demselben maschinellen Lernsystem mehrere Ansätze verwendet. Beispiele hierfür sind Topic Modeling und Meta-Learning . [ 56 ]
Selbstlernen
Selbstlernen als Paradigma des maschinellen Lernens wurde 1982 zusammen mit einem selbstlernfähigen neuronalen Netzwerk namens Crossbar Adaptive Array (CAA) eingeführt. [ 57 ] [ 58 ] Es bietet eine Lösung für das Problem des Lernens ohne externe Belohnung, indem es Emotionen als interne Belohnung einführt. Emotionen dienen der Zustandsbewertung eines selbstlernenden Agenten. Der CAA-Selbstlernalgorithmus berechnet in Form eines Crossbar-Netzwerks sowohl Entscheidungen über Handlungen als auch Emotionen (Gefühle) bezüglich deren Konsequenzen. Das System wird durch die Interaktion zwischen Kognition und Emotion gesteuert. [ 59 ] Der Selbstlernalgorithmus aktualisiert eine Speichermatrix W = ||w(a,s)||, sodass in jeder Iteration die folgende Routine des maschinellen Lernens ausgeführt wird:
- in Situation s handle a
- eine Konsequenzsituation erhalten s '
- Emotion berechnen, die mit dem Befinden in der Konsequenzsituation einhergeht (v(s'))
- Aktualisierung des Crossbar-Speichers w'(a,s) = w(a,s) + v(s')
Es handelt sich um ein System mit nur einem Input (Situation) und nur einem Output (Aktion bzw. Verhalten). Es gibt weder einen separaten Verstärkungs- noch einen Beratungs-Input aus der Umgebung. Der rückpropagierte Wert (sekundäre Verstärkung) ist die Emotion gegenüber der Konsequenzsituation. Das CAA existiert in zwei Umgebungen: der Verhaltensumgebung, in der es sich verhält, und der genetischen Umgebung, aus der es anfänglich und einmalig die initialen Emotionen bezüglich Situationen empfängt, denen es in der Verhaltensumgebung begegnen wird. Nach dem Empfang des Genomvektors (Artenvektors) aus der genetischen Umgebung lernt das CAA ein zielgerichtetes Verhalten in einer Umgebung, die sowohl erwünschte als auch unerwünschte Situationen enthält. [ 60 ]
Feature-Lernen
Verschiedene Lernalgorithmen zielen darauf ab, bessere Repräsentationen der während des Trainings bereitgestellten Eingabedaten zu finden. [ 61 ] Klassische Beispiele hierfür sind die Hauptkomponentenanalyse und die Clusteranalyse. Merkmalslernalgorithmen, auch Repräsentationslernalgorithmen genannt, versuchen häufig, die Informationen ihrer Eingabedaten zu erhalten und sie gleichzeitig so zu transformieren, dass sie nutzbar werden. Dies geschieht oft als Vorverarbeitungsschritt vor der Klassifizierung oder Vorhersage. Diese Technik ermöglicht die Rekonstruktion der Eingabedaten aus der unbekannten Datenverteilung, ohne dabei Konfigurationen, die unter dieser Verteilung unplausibel sind, notwendigerweise genau abzubilden. Dadurch wird die manuelle Merkmalsentwicklung ersetzt und es einer Maschine ermöglicht, Merkmale zu lernen und sie zur Ausführung einer spezifischen Aufgabe zu nutzen.
Merkmalslernen kann überwacht oder unüberwacht erfolgen. Beim überwachten Merkmalslernen werden Merkmale anhand von gelabelten Eingabedaten gelernt. Beispiele hierfür sind künstliche neuronale Netze , mehrschichtige Perzeptronen und überwachtes Wörterbuchlernen . Beim unüberwachten Merkmalslernen werden Merkmale mit ungelabelten Eingabedaten gelernt. Beispiele hierfür sind Wörterbuchlernen, unabhängige Komponentenanalyse , Autoencoder , Matrixfaktorisierung [ 62 ] und verschiedene Formen des Clusterings . [ 63 ] [ 64 ] [ 65 ]
Manifold learning algorithms attempt to do so under the constraint that the learned representation is low-dimensional. Sparse coding algorithms attempt to do so under the constraint that the learned representation is sparse, meaning that the mathematical model has many zeros. Multilinear subspace learning algorithms aim to learn low-dimensional representations directly from tensor representations for multidimensional data, without reshaping them into higher-dimensional vectors.[66]Deep learning algorithms discover multiple levels of representation, or a hierarchy of features, with higher-level, more abstract features defined in terms of (or generating) lower-level features. It has been argued that an intelligent machine learns a representation that disentangles the underlying factors of variation that explain the observed data.[67]
Feature learning is motivated by the fact that machine learning tasks such as classification often require input that is mathematically and computationally convenient to process. However, real-world data such as images, video, and sensory data have not yielded attempts to algorithmically define specific features. An alternative is to discover such features or representations through examination, without relying on explicit algorithms.
Sparse dictionary learning
Sparse dictionary learning is a feature learning method where a training example is represented as a linear combination of basis functions and assumed to be a sparse matrix. The method is strongly NP-hard and difficult to solve approximately.[68] A popular heuristic method for sparse dictionary learning is the k-SVD algorithm. Sparse dictionary learning has been applied in several contexts. In classification, the problem is to determine the class to which a previously unseen training example belongs. For a dictionary where each class has already been built, a new training example is associated with the class that is best sparsely represented by the corresponding dictionary. Sparse dictionary learning has also been applied in image denoising. The key idea is that a clean image patch can be sparsely represented by an image dictionary, but the noise cannot.[69]
Anomaly detection
Im Data-Mining bezeichnet Anomalieerkennung, auch Ausreißererkennung genannt, die Identifizierung seltener Elemente, Ereignisse oder Beobachtungen, die aufgrund ihrer signifikanten Abweichung von der Mehrheit der Daten Verdacht erregen. [ 70 ] Typischerweise repräsentieren diese Anomalien ein Problem wie Bankbetrug , einen strukturellen Defekt, medizinische Probleme oder Fehler in einem Text. Anomalien werden auch als Ausreißer , Neuheiten, Rauschen, Abweichungen und Ausnahmen bezeichnet . [ 71 ]
Insbesondere im Kontext von Missbrauchs- und Netzwerkangriffserkennung sind die interessanten Objekte oft nicht selten, sondern unerwartete Phasen der Inaktivität. Dieses Muster entspricht nicht der gängigen statistischen Definition eines Ausreißers als seltenes Objekt. Viele Ausreißererkennungsmethoden (insbesondere unüberwachte Algorithmen) versagen bei solchen Daten, sofern diese nicht entsprechend aggregiert werden. Ein Clusteranalyse-Algorithmus hingegen kann möglicherweise die durch diese Muster gebildeten Mikrocluster erkennen. [ 72 ]
Es gibt drei Hauptkategorien von Anomalieerkennungsverfahren. [ 73 ] Unüberwachte Anomalieerkennungsverfahren erkennen Anomalien in einem unbeschrifteten Testdatensatz unter der Annahme, dass die Mehrheit der Instanzen im Datensatz normal ist. Sie suchen nach Instanzen, die am wenigsten zum restlichen Datensatz passen. Überwachte Anomalieerkennungsverfahren benötigen einen als „normal“ und „abnormal“ gekennzeichneten Datensatz und beinhalten das Training eines Klassifikators (der Hauptunterschied zu vielen anderen statistischen Klassifizierungsproblemen liegt in der inhärenten Unausgewogenheit der Ausreißererkennung). Semi-überwachte Anomalieerkennungsverfahren erstellen ein Modell, das normales Verhalten repräsentiert, anhand eines gegebenen normalen Trainingsdatensatzes und testen dann die Wahrscheinlichkeit, mit der eine Testinstanz vom Modell generiert wird.
Roboterlernen
Das Roboterlernen ist von einer Vielzahl von Methoden des maschinellen Lernens inspiriert, angefangen beim überwachten Lernen, dem bestärkenden Lernen [ 74 ] [ 75 ] bis hin zum Meta-Lernen (z. B. MAML).
Vereinsregeln
Assoziationsregellernen ist eine regelbasierte Methode des maschinellen Lernens zur Ermittlung von Beziehungen zwischen Variablen in großen Datenbanken. Ziel ist es, anhand eines Maßes für „Interessantheit“ starke Regeln in Datenbanken zu identifizieren. [ 76 ]
Regelbasiertes maschinelles Lernen ist ein Oberbegriff für alle Methoden des maschinellen Lernens, die „Regeln“ identifizieren, lernen oder weiterentwickeln, um Wissen zu speichern, zu verarbeiten oder anzuwenden. Das definierende Merkmal eines regelbasierten Algorithmus ist die Identifizierung und Nutzung einer Menge relationaler Regeln, die gemeinsam das vom System erfasste Wissen repräsentieren. Dies steht im Gegensatz zu anderen Algorithmen des maschinellen Lernens, die üblicherweise ein einzelnes Modell identifizieren, das universell auf jede Instanz angewendet werden kann, um eine Vorhersage zu treffen. [ 77 ] Zu den Ansätzen des regelbasierten maschinellen Lernens gehören lernende Klassifikatorsysteme , das Lernen von Assoziationsregeln und künstliche Immunsysteme .
Aufbauend auf dem Konzept starker Regeln führten Rakesh Agrawal , Tomasz Imieliński und Arun Swami Assoziationsregeln ein, um Regelmäßigkeiten zwischen Produkten in umfangreichen Transaktionsdaten von Kassensystemen in Supermärkten zu erkennen. [ 78 ] Beispielsweise würde eine in den Verkaufsdaten eines Supermarkts gefundene Regel darauf hindeuten, dass ein Kunde, der Zwiebeln und Kartoffeln zusammen kauft, wahrscheinlich auch Hackfleisch kauft. Solche Informationen können als Grundlage für Entscheidungen über Marketingaktivitäten wie Aktionspreise oder Produktplatzierungen dienen . Neben der Warenkorbanalyse werden Assoziationsregeln heute in Anwendungsbereichen wie Web-Nutzungsanalyse , Angriffserkennung , kontinuierlicher Produktion und Bioinformatik eingesetzt . Im Gegensatz zur Sequenzanalyse berücksichtigt das Lernen von Assoziationsregeln typischerweise nicht die Reihenfolge der Artikel, weder innerhalb einer Transaktion noch transaktionsübergreifend.

Lernende Klassifikatorsysteme (LCS) sind eine Familie regelbasierter Algorithmen des maschinellen Lernens, die eine Entdeckungskomponente, typischerweise einen genetischen Algorithmus , mit einer Lernkomponente kombinieren, die entweder überwachtes , bestärkendes oder unüberwachtes Lernen durchführt . Sie zielen darauf ab, eine Menge kontextabhängiger Regeln zu identifizieren, die gemeinsam Wissen stückweise speichern und anwenden, um Vorhersagen zu treffen. [ 79 ]
Induktive logische Programmierung (ILP) ist ein Ansatz zum Regellernen, der logische Programmierung als einheitliche Repräsentation für Eingabebeispiele, Hintergrundwissen und Hypothesen nutzt. Ausgehend von einer Kodierung des bekannten Hintergrundwissens und einer Menge von Beispielen, die als logische Faktendatenbank dargestellt sind, leitet ein ILP-System ein hypothetisches logisches Programm ab, das ausschließlich positive und keine negativen Beispiele enthält . Induktive Programmierung ist ein verwandtes Gebiet, das beliebige Programmiersprachen zur Repräsentation von Hypothesen (und nicht nur logische Programmierung) betrachtet, beispielsweise funktionale Programme .
Induktive logische Programmierung ist besonders nützlich in der Bioinformatik und der Verarbeitung natürlicher Sprache . Gordon Plotkin und Ehud Shapiro legten die theoretischen Grundlagen für induktives maschinelles Lernen im logischen Kontext. [ 80 ] [ 81 ] [ 82 ] Shapiro entwickelte 1981 ihre erste Implementierung (Model Inference System): ein Prolog- Programm, das logische Programme induktiv aus positiven und negativen Beispielen ableitete. [ 83 ] Der Begriff „induktiv “ bezieht sich hier auf die philosophische Induktion, die eine Theorie zur Erklärung beobachteter Fakten nahelegt, und nicht auf die mathematische Induktion , die eine Eigenschaft für alle Elemente einer geordneten Menge beweist.
Modelle
AEin Modell des maschinellen Lernens ist einmathematisches Modell, das, sobald es anhand eines gegebenen Datensatzes trainiert wurde, zur Vorhersage oder Klassifizierung neuer Daten verwendet werden kann. Während des Trainings passt ein Lernalgorithmus iterativ die internen Parameter des Modells an, um Fehler in den Vorhersagen zu minimieren. [ 84 ] Im weiteren Sinne kann der Begriff „Modell“ verschiedene Spezifizierungsstufen bezeichnen, von einer allgemeinen Klasse von Modellen und den zugehörigen Lernalgorithmen bis hin zu einem vollständig trainierten Modell mit allen optimierten internen Parametern. [ 85 ]
Für Systeme des maschinellen Lernens wurden verschiedene Modelltypen verwendet und erforscht; die Auswahl des besten Modells für eine Aufgabe wird als Modellauswahl bezeichnet .
Künstliche neuronale Netze

Künstliche neuronale Netze (KNN) oder konnektionistische Systeme sind Rechensysteme, die lose von den biologischen neuronalen Netzen im Gehirn von Tieren inspiriert sind . Solche Systeme „lernen“ Aufgaben anhand von Beispielen, in der Regel ohne mit aufgabenspezifischen Regeln programmiert zu werden.
Ein künstliches neuronales Netz (KNN) ist ein Modell, das auf einer Sammlung verbundener Einheiten oder Knoten, sogenannten „ künstlichen Neuronen “, basiert und die Neuronen eines biologischen Gehirns nachbildet . Jede Verbindung kann, ähnlich den Synapsen im Gehirn, Informationen, ein „Signal“, von einem künstlichen Neuron zum nächsten übertragen. Ein künstliches Neuron, das ein Signal empfängt, kann es verarbeiten und anschließend weitere, mit ihm verbundene künstliche Neuronen signalisieren. In gängigen KNN-Implementierungen ist das Signal an einer Verbindung zwischen künstlichen Neuronen eine reelle Zahl , und die Ausgabe jedes künstlichen Neurons wird durch eine nichtlineare Funktion der Summe seiner Eingaben berechnet. Die Verbindungen zwischen künstlichen Neuronen werden als „Kanten“ bezeichnet. Künstliche Neuronen und Kanten besitzen typischerweise ein Gewicht , das sich im Laufe des Lernprozesses anpasst. Das Gewicht erhöht oder verringert die Signalstärke an einer Verbindung. Künstliche Neuronen können einen Schwellenwert haben, sodass das Signal nur dann gesendet wird, wenn das Gesamtsignal diesen Schwellenwert überschreitet. Typischerweise sind künstliche Neuronen in Schichten zusammengefasst. Verschiedene Schichten können unterschiedliche Transformationen ihrer Eingaben durchführen. Die Signale durchlaufen die Schichten von der ersten Schicht (der Eingabeschicht) bis zur letzten Schicht (der Ausgabeschicht), gegebenenfalls nachdem sie die Schichten mehrmals durchlaufen haben.
Das ursprüngliche Ziel des ANN-Ansatzes war die Problemlösung nach dem Vorbild des menschlichen Gehirns . Im Laufe der Zeit verlagerte sich der Fokus jedoch auf die Ausführung spezifischer Aufgaben, was zu Abweichungen von biologischen Modellen führte . Künstliche neuronale Netze werden für eine Vielzahl von Aufgaben eingesetzt, darunter Computer Vision , Spracherkennung , maschinelle Übersetzung , Filterung sozialer Netzwerke , Brett- und Videospiele sowie medizinische Diagnostik .
Deep Learning besteht aus mehreren verborgenen Schichten in einem künstlichen neuronalen Netzwerk. Dieser Ansatz versucht, die Art und Weise zu modellieren, wie das menschliche Gehirn Licht und Schall zu Sehen und Hören verarbeitet. Zu den erfolgreichen Anwendungen von Deep Learning gehören Computer Vision und Spracherkennung. [ 86 ]
Entscheidungsbäume

Das Lernen mit Entscheidungsbäumen nutzt einen Entscheidungsbaum als Vorhersagemodell , um von Beobachtungen zu einem Objekt (dargestellt in den Zweigen) zu Schlussfolgerungen über dessen Zielwert (dargestellt in den Blättern) zu gelangen. Es ist einer der prädiktiven Modellierungsansätze, die in Statistik, Data Mining und maschinellem Lernen Anwendung finden. Baummodelle, bei denen die Zielvariable diskrete Werte annehmen kann, werden als Klassifikationsbäume bezeichnet. In diesen Baumstrukturen repräsentieren die Blätter Klassenbezeichnungen und die Zweige Merkmalskombinationen , die zu diesen Klassenbezeichnungen führen. Entscheidungsbäume, bei denen die Zielvariable kontinuierliche Werte (typischerweise reelle Zahlen ) annehmen kann, werden als Regressionsbäume bezeichnet. In der Entscheidungsanalyse kann ein Entscheidungsbaum verwendet werden, um Entscheidungen und Entscheidungsprozesse visuell und explizit darzustellen . Im Data Mining beschreibt ein Entscheidungsbaum Daten, der resultierende Klassifikationsbaum kann jedoch als Grundlage für Entscheidungen dienen.
Random-Forest-Regression
Random Forest Regression (RFR) gehört zur Gruppe der entscheidungsbaumbasierten Modelle . RFR ist ein Ensemble-Lernverfahren, das mehrere Entscheidungsbäume erstellt und deren Vorhersagen mittelt, um die Genauigkeit zu verbessern und Überanpassung zu vermeiden. Zum Erstellen der Entscheidungsbäume verwendet RFR Bootstrapping; das heißt, jeder Entscheidungsbaum wird mit zufälligen Daten aus dem Trainingsdatensatz trainiert. Diese zufällige Auswahl der Trainingsdaten ermöglicht es dem Modell, verzerrte Vorhersagen zu reduzieren und eine höhere Genauigkeit zu erzielen. RFR generiert unabhängige Entscheidungsbäume und kann sowohl mit Daten mit einem einzelnen Ausgabewert als auch mit Aufgaben mit mehreren Regressoren arbeiten. Dadurch ist RFR für verschiedene Anwendungen geeignet. [ 87 ] [ 88 ]
Support-Vektor-Maschinen
Support-Vektor-Maschinen (SVMs), auch Support-Vektor-Netzwerke genannt, sind eine Gruppe verwandter überwachter Lernverfahren zur Klassifizierung und Regression. Ausgehend von einer Menge Trainingsbeispielen, die jeweils einer von zwei Kategorien zugeordnet sind, erstellt ein SVM-Trainingsalgorithmus ein Modell, das vorhersagt, ob ein neues Beispiel in eine der Kategorien fällt. [ 89 ] Ein SVM-Trainingsalgorithmus ist ein nicht- probabilistischer , binärer , linearer Klassifikator , obwohl Methoden wie die Platt-Skalierung existieren, um SVMs in einem probabilistischen Klassifizierungsszenario einzusetzen. Neben der linearen Klassifizierung können SVMs mithilfe des sogenannten Kernel-Tricks effizient eine nicht-lineare Klassifizierung durchführen , indem sie ihre Eingaben implizit in hochdimensionale Merkmalsräume abbilden.
Regressionsanalyse

Die Regressionsanalyse umfasst eine Vielzahl statistischer Methoden zur Schätzung des Zusammenhangs zwischen Eingangsvariablen und ihren zugehörigen Merkmalen. Die gebräuchlichste Form ist die lineare Regression , bei der eine Gerade so berechnet wird, dass sie die gegebenen Daten nach einem mathematischen Kriterium wie der Methode der kleinsten Quadrate optimal annähert . Letztere wird häufig durch Regularisierungsverfahren wie die Ridge-Regression erweitert , um Überanpassung und Verzerrungen zu reduzieren . Bei nichtlinearen Problemen kommen gängige Modelle wie die Polynomregression (z. B. zur Trendlinienanpassung in Microsoft Excel [ 90 ] ), die logistische Regression (häufig in der statistischen Klassifizierung verwendet ) oder auch die Kernelregression zum Einsatz. Letztere führt Nichtlinearität ein, indem sie den Kernel-Trick nutzt , um Eingangsvariablen implizit in einen höherdimensionalen Raum abzubilden.
Die multivariate lineare Regression erweitert das Konzept der linearen Regression, um mehrere abhängige Variablen gleichzeitig zu berücksichtigen. Dieser Ansatz schätzt die Beziehungen zwischen einer Reihe von Eingangsvariablen und mehreren Ausgangsvariablen durch die Anpassung eines mehrdimensionalen linearen Modells. Er ist besonders nützlich in Szenarien, in denen die Ergebnisse voneinander abhängen oder gemeinsame zugrunde liegende Muster aufweisen, wie beispielsweise bei der Vorhersage mehrerer Wirtschaftsindikatoren oder der Bildrekonstruktion [ 91 ] , die naturgemäß mehrdimensional sind.
Bayes'sche Netze

Ein Bayes'sches Netz, auch Glaubensnetz oder gerichtetes azyklisches Graphmodell genannt, ist ein probabilistisches grafisches Modell , das eine Menge von Zufallsvariablen und deren bedingte Unabhängigkeit mithilfe eines gerichteten azyklischen Graphen (DAG) darstellt. Beispielsweise kann ein Bayes'sches Netz die Wahrscheinlichkeitsbeziehungen zwischen Krankheiten und Symptomen abbilden. Ausgehend von den Symptomen kann das Netz die Wahrscheinlichkeiten für das Auftreten verschiedener Krankheiten berechnen. Es existieren effiziente Algorithmen für Inferenz und Lernen. Bayes'sche Netze, die Sequenzen von Variablen wie Sprachsignale oder Proteinsequenzen modellieren, werden als dynamische Bayes'sche Netze bezeichnet . Verallgemeinerungen von Bayes'schen Netzen, die Entscheidungsprobleme unter Unsicherheit darstellen und lösen können, werden als Einflussdiagramme bezeichnet .
Gaußsche Prozesse

Ein Gaußscher Prozess ist ein stochastischer Prozess , bei dem jede endliche Menge der Zufallsvariablen im Prozess eine multivariate Normalverteilung besitzt und auf einer vordefinierten Kovarianzfunktion oder einem Kernel basiert, der modelliert, wie Paare von Punkten in Abhängigkeit von ihren Positionen miteinander in Beziehung stehen.
Ausgehend von einer Menge beobachteter Punkte oder Eingabe-Ausgabe-Beispielen kann die Verteilung der (nicht beobachteten) Ausgabe eines neuen Punktes als Funktion seiner Eingabedaten direkt berechnet werden, indem man die beobachteten Punkte und die Kovarianzen zwischen diesen Punkten und dem neuen, nicht beobachteten Punkt betrachtet.
Gaußprozesse sind beliebte Ersatzmodelle in der Bayes'schen Optimierung, die zur Hyperparameteroptimierung eingesetzt werden .
Genetische Algorithmen
Ein genetischer Algorithmus (GA) ist ein Suchalgorithmus und eine heuristische Technik, die den Prozess der natürlichen Selektion nachahmt . Er nutzt Methoden wie Mutation und Rekombination , um neue Genotypen zu generieren und so gute Lösungen für ein gegebenes Problem zu finden. Im maschinellen Lernen wurden genetische Algorithmen in den 1980er und 1990er Jahren eingesetzt. [ 93 ] [ 94 ] Umgekehrt wurden Techniken des maschinellen Lernens verwendet, um die Leistung genetischer und evolutionärer Algorithmen zu verbessern . [ 95 ]
Glaubensfunktionen
Die Theorie der Glaubensfunktionen, auch Evidenztheorie oder Dempster-Shafer-Theorie genannt, ist ein allgemeines Rahmenwerk für das Schließen unter Unsicherheit und weist Verbindungen zu anderen Rahmenwerken wie der Wahrscheinlichkeitstheorie , der Möglichkeitstheorie und der Theorie ungenauer Wahrscheinlichkeit auf . Diese theoretischen Rahmenwerke können als eine Art Lernalgorithmus betrachtet werden und weisen analoge Eigenschaften hinsichtlich der Kombination von Evidenz auf (z. B. Dempsters Kombinationsregel), ähnlich wie in einem auf Wahrscheinlichkeitsfunktionen basierenden Bayes'schen Ansatz Wahrscheinlichkeiten kombiniert werden. [ 96 ] Im Vergleich zu Bayes'schen Ansätzen zur Berücksichtigung von Unwissenheit und Unsicherheitsquantifizierung bestehen jedoch einige Einschränkungen dieser Glaubensfunktionen . Die im Bereich des maschinellen Lernens implementierten Ansätze nutzen typischerweise einen Fusionsansatz verschiedener Ensemble-Methoden , um die Entscheidungsgrenze des Lernalgorithmus , geringe Stichproben und Probleme mit mehrdeutigen Klassen besser zu bewältigen, mit denen Standardansätze des maschinellen Lernens oft Schwierigkeiten haben. [ 97 ] [ 6 ] Die Rechenkomplexität dieser Algorithmen hängt jedoch von der Anzahl der Aussagen (Klassen) ab und kann im Vergleich zu anderen Ansätzen des maschinellen Lernens zu einer wesentlich längeren Rechenzeit führen.
Regelbasierte Modelle
Regelbasiertes maschinelles Lernen (RBML) ist ein Teilgebiet des maschinellen Lernens, das automatisch Regeln aus Daten erkennt und lernt. Es liefert interpretierbare Modelle und ist daher nützlich für Entscheidungsprozesse in Bereichen wie dem Gesundheitswesen, der Betrugserkennung und der Cybersicherheit. Zu den wichtigsten RBML-Techniken gehören lernende Klassifikatorsysteme [ 98 ] , das Lernen von Assoziationsregeln [ 99 ] , künstliche Immunsysteme [ 100 ] und ähnliche Modelle. Diese Methoden extrahieren Muster aus Daten und entwickeln Regeln im Laufe der Zeit weiter .
Trainingsmodelle
Typischerweise benötigen Modelle des maschinellen Lernens eine große Menge zuverlässiger Daten, um präzise Vorhersagen treffen zu können. Beim Training eines solchen Modells müssen Entwickler daher eine große und repräsentative Stichprobe von Daten sammeln. Die Trainingsdaten können vielfältig sein, beispielsweise Textkorpora , Bildersammlungen, Sensordaten oder Daten einzelner Nutzer eines Dienstes. Beim Training eines Modells ist Überanpassung (Overfitting) unbedingt zu beachten. Modelle, die auf verzerrten oder nicht validierten Daten basieren, können zu fehlerhaften oder unerwünschten Vorhersagen führen. Verzerrte Modelle können schädliche Folgen haben und somit negative Auswirkungen auf Gesellschaft oder Ziele verstärken. Algorithmische Verzerrungen können entstehen, wenn die Daten nicht optimal für das Training aufbereitet wurden. Die Ethik des maschinellen Lernens entwickelt sich zu einem eigenständigen Forschungsgebiet und wird zunehmend in die Arbeit von Entwicklerteams integriert.
Föderiertes Lernen
Föderiertes Lernen ist eine angepasste Form der verteilten künstlichen Intelligenz, um Modelle des maschinellen Lernens zu trainieren. Durch die Dezentralisierung des Trainingsprozesses bleibt die Privatsphäre der Nutzer gewahrt, da ihre Daten nicht an einen zentralen Server gesendet werden müssen. Dies erhöht zudem die Effizienz, indem der Trainingsprozess auf viele Geräte verteilt wird. Beispielsweise nutzt Gboard föderiertes maschinelles Lernen, um Vorhersagemodelle für Suchanfragen auf den Mobiltelefonen der Nutzer zu trainieren, ohne einzelne Suchanfragen an Google zurücksenden zu müssen . [ 101 ]
Anwendungen
Maschinelles Lernen hat viele Anwendungsgebiete, darunter:
- Landwirtschaft
- Anatomie
- Adaptive Website
- Affektives Computing
- Astronomie
- Automatisierte Entscheidungsfindung
- Bankwesen
- Behaviorismus
- Bioinformatik
- Gehirn-Maschine-Schnittstellen
- Chemoinformatik
- Bürgerwissenschaft
- Klimawissenschaft
- Computernetzwerke
- Computer Vision
- Erkennung von Kreditkartenbetrug
- Datenqualität
- DNA- Sequenzklassifizierung
- Wirtschaft
- Finanzdatenanalyse [ 102 ]
- Allgemeines Spiel
- Handschrifterkennung
- Gesundheitspflege
- Informationsabruf
- Versicherung
- Internetbetrugserkennung
- Investmentmanagement [ 103 ]
- Wissensgraph-Einbettung
- Linguistik
- Steuerung durch maschinelles Lernen
- Maschinelle Wahrnehmung
- Maschinelle Übersetzung
- Materialtechnik
- Marketing
- Medizinische Diagnose
- Verarbeitung natürlicher Sprache
- Natürliches Sprachverständnis
- Online-Werbung
- Optimierung
- Empfehlungssysteme
- Roboterfortbewegung
- Suchmaschinen
- Stimmungsanalyse
- Sequenzanalyse
- Softwareentwicklung
- Spracherkennung
- Strukturelle Zustandsüberwachung
- Syntaktische Mustererkennung
- Telekommunikation
- Satzbeweis
- Zeitreihenprognose
- Tomographische Rekonstruktion [ 104 ]
- Nutzerverhaltensanalyse
Im Jahr 2006 veranstaltete der Mediendienstleister Netflix den ersten „ Netflix Prize “, um ein Programm zu finden, das Nutzerpräferenzen besser vorhersagen und die Genauigkeit des bestehenden Cinematch-Filmempfehlungsalgorithmus um mindestens 10 % verbessern sollte. Ein gemeinsames Team von Forschern der AT&T Labs – Research in Zusammenarbeit mit den Teams von Big Chaos und Pragmatic Theory entwickelte ein Ensemble-Modell und gewann damit 2009 den Hauptpreis in Höhe von einer Million US-Dollar. [ 105 ] Kurz nach der Preisverleihung erkannte Netflix, dass die Bewertungen der Zuschauer nicht die besten Indikatoren für deren Sehgewohnheiten waren („alles ist eine Empfehlung“) und passte seinen Empfehlungsalgorithmus entsprechend an. [ 106 ] Im Jahr 2010 berichtete das Wall Street Journal über den Einsatz von maschinellem Lernen durch Rebellion Research zur Vorhersage der Finanzkrise von 2008 . [ 107 ] Im Jahr 2012 prognostizierte Vinod Khosla , Mitbegründer von Sun Microsystems , dass 80 % der Arztstellen in den nächsten zwei Jahrzehnten durch automatisierte, maschinelle Lernverfahren für medizinische Diagnosen verloren gehen würden. [ 108 ] 2014 wurde berichtet, dass ein Algorithmus für maschinelles Lernen in der Kunstgeschichte zur Untersuchung von Gemälden eingesetzt wurde und dabei möglicherweise bisher unbekannte Einflüsse auf Künstler aufgedeckt hat. [ 109 ] 2019 veröffentlichte Springer Nature das erste Forschungsbuch, das mithilfe von maschinellem Lernen erstellt wurde. [ 110 ] Im Jahr 2020 wurde maschinelles Lernen zur Unterstützung von Diagnosen und Forschern bei der Entwicklung eines Heilmittels gegen COVID-19 eingesetzt. [ 111 ] Kürzlich wurde maschinelles Lernen angewendet, um das umweltfreundliche Verhalten von Reisenden vorherzusagen. [ 112 ] Kürzlich wurde maschinelles Lernen auch eingesetzt, um die Leistung und das thermische Verhalten von Smartphones basierend auf der Interaktion des Nutzers mit dem Gerät zu optimieren. [ 113 ] [ 114 ] [ 115 ] Bei korrekter Anwendung können Algorithmen des maschinellen Lernens (MLAs) eine Vielzahl von Unternehmensmerkmalen nutzen, um Aktienrenditen ohne Überanpassung vorherzusagen . Durch effektives Feature Engineering und die Kombination von Prognosen können MLAs Ergebnisse erzielen, die die von einfachen linearen Verfahren wie der OLS- Regression deutlich übertreffen . [ 116 ]
Jüngste Fortschritte im Bereich des maschinellen Lernens haben sich auch auf die Quantenchemie ausgeweitet, wo neuartige Algorithmen nun die Vorhersage von Lösungsmitteleffekten auf chemische Reaktionen ermöglichen und Chemikern damit neue Werkzeuge zur Verfügung stellen, um experimentelle Bedingungen für optimale Ergebnisse anzupassen. [ 117 ]
Maschinelles Lernen entwickelt sich zu einem nützlichen Werkzeug, um Evakuierungsentscheidungen bei großen und kleinen Katastrophen zu untersuchen und vorherzusagen. Verschiedene Lösungen wurden getestet, um vorherzusagen, ob und wann sich Bewohner während Waldbränden und Hurrikanen zur Evakuierung entscheiden. [ 118 ] [ 119 ] [ 120 ] Andere Anwendungen konzentrieren sich auf Entscheidungen vor einer Evakuierung bei Gebäudebränden. [ 121 ] [ 122 ]
Einschränkungen
Obwohl maschinelles Lernen in einigen Bereichen zu grundlegenden Veränderungen geführt hat, liefern Programme für maschinelles Lernen häufig nicht die erwarteten Ergebnisse. [ 123 ] [ 124 ] [ 125 ] Die Gründe hierfür sind vielfältig: fehlende (geeignete) Daten, fehlender Datenzugriff, Datenverzerrungen, Datenschutzprobleme, ungeeignete Aufgaben und Algorithmen, ungeeignete Werkzeuge und Personen, Ressourcenmangel sowie Evaluierungsprobleme. [ 126 ]
Die „ Black-Box-Theorie “ stellt eine weitere, bedeutende Herausforderung dar. Der Begriff „Black Box“ bezeichnet eine Situation, in der der Algorithmus, der ein Ergebnis erzeugt, vollständig undurchsichtig ist. Das bedeutet, dass selbst die Entwickler einer Anwendung das vom System aus den Daten extrahierte Muster nicht nachvollziehen können. [ 127 ] Der Sonderausschuss des House of Lords erklärte, dass ein solches „intelligentes System“, das „erhebliche Auswirkungen auf das Leben eines Einzelnen“ haben könnte, nur dann akzeptabel sei, wenn es „eine vollständige und zufriedenstellende Erklärung für seine Entscheidungen“ liefere. [ 127 ]
Im Jahr 2018 erkannte ein autonomes Fahrzeug von Uber einen Fußgänger nicht, der bei einem Zusammenstoß ums Leben kam. [ 128 ] Versuche, maschinelles Lernen im Gesundheitswesen mit dem IBM Watson- System einzusetzen, blieben trotz jahrelanger Entwicklung und Milliardeninvestitionen erfolglos. [ 129 ] [ 130 ] Berichten zufolge reagierte der Bing Chat -Bot von Microsoft mit feindseligen und beleidigenden Antworten gegenüber seinen Nutzern. [ 131 ]
Maschinelles Lernen wurde als Strategie eingesetzt, um die Evidenz im Zusammenhang mit systematischen Reviews zu aktualisieren und die erhöhte Belastung der Reviewer angesichts der wachsenden Menge biomedizinischer Literatur zu bewältigen. Obwohl es sich mithilfe von Trainingsdatensätzen verbessert hat, ist es noch nicht ausreichend entwickelt, um die Arbeitsbelastung zu reduzieren, ohne die für die Forschung notwendige Sensitivität einzuschränken. [ 132 ]
Erklärbarkeit
Erklärbare KI (XAI), auch interpretierbare KI oder erklärbares maschinelles Lernen (XML) genannt, ist künstliche Intelligenz (KI), deren Entscheidungen und Vorhersagen für Menschen nachvollziehbar sind. [ 133 ] Sie steht im Gegensatz zum „Black-Box“-Konzept des maschinellen Lernens, bei dem selbst die Entwickler nicht erklären können, warum eine KI zu einer bestimmten Entscheidung gelangt ist. [ 134 ] Indem XAI die mentalen Modelle der Nutzer KI-gestützter Systeme verfeinert und deren Fehlvorstellungen abbaut, verspricht sie, deren Effektivität zu steigern. XAI könnte somit eine Umsetzung des gesellschaftlichen Rechts auf Erklärung darstellen.
Überanpassung

Die Festlegung auf eine ungeeignete, übermäßig komplexe Theorie, die so angepasst wurde , dass sie alle bisherigen Trainingsdaten abdeckt, wird als Überanpassung bezeichnet. Viele Systeme versuchen, Überanpassung zu reduzieren, indem sie eine Theorie entsprechend ihrer Anpassungsgüte an die Daten belohnen, sie aber entsprechend ihrer Komplexität bestrafen. [ 135 ]
Modellzusammenbruch
Der Modellkollaps , auch bekannt unter Bezeichnungen wie „KI -Inzucht “ [ 136 ] [ 137 ] , „KI- Kannibalismus “ [ 138 ] [ 139 ] , „ Habsburg -KI“ [ 140 ] und „Modell -Autophagie- Störung“ oder „MAD“ [ 141 ] [ 142 ] [ 143 ], ist ein Phänomen in der Forschung zur künstlichen Intelligenz . Dabei verschlechtert sich die Leistungsfähigkeit von Modellen des maschinellen Lernens allmählich aufgrund von Fehlern in unkontrollierten synthetischen Daten oder weil sie mit den Ausgaben anderer Modelle, beispielsweise früheren Versionen ihrer selbst, trainiert werden. Es ist unklar, inwieweit dieses Phänomen die langfristige Entwicklung solcher Modelle gefährdet, und es wurden bereits einige Techniken vorgeschlagen, um den Effekt abzuschwächen.
Halluzinationen

Im Bereich der künstlichen Intelligenz (KI) bezeichnet man als Halluzination oder künstliche Halluzination (auch als Bullshitting [ 144 ] [ 145 ] , Konfabulation [ 146 ] oder Wahnvorstellung [ 147 ] bezeichnet ) eine von KI generierte Antwort, die falsche oder irreführende Informationen als Fakten präsentiert . [ 148 ] Der Begriff stellt eine lose Analogie zur menschlichen Psychologie her, wo eine Halluzination typischerweise falsche Wahrnehmungen beinhaltet .
Ein Chatbot , der beispielsweise auf großen Sprachmodellen (LLMs) wie ChatGPT basiert , kann plausibel klingende, zufällige Falschinformationen in seine generierten Inhalte einbetten. Das Erkennen und Beheben von Fehlern und Halluzinationen stellt eine erhebliche Herausforderung für den praktischen Einsatz und die Zuverlässigkeit von LLMs in kritischen Anwendungsbereichen wie Chipdesign, Lieferkettenlogistik und medizinischer Diagnostik dar. [ 149 ] [ 150 ] [ 151 ] Einige Softwareentwickler und Statistiker kritisieren den Begriff „KI-Halluzination“, da er Computer unangemessen vermenschlicht . [ 152 ] [ 153 ] Symbolische Modelle der künstlichen Intelligenz erzeugen im Gegensatz zu großen Sprachmodellen in der Regel keine Halluzinationen. [ 154 ]
Weitere Einschränkungen und Schwachstellen
Lernende können auch enttäuscht sein, wenn sie „die falsche Lektion lernen“. Ein einfaches Beispiel: Ein Bildklassifikator, der nur mit Bildern von braunen Pferden und schwarzen Katzen trainiert wurde, könnte fälschlicherweise annehmen, dass alle braunen Flecken wahrscheinlich Pferde darstellen. [ 155 ] In der Praxis treffen Bildklassifikatoren – anders als Menschen – ihre Entscheidungen oft nicht primär auf Grundlage der räumlichen Beziehungen zwischen Bildkomponenten. Sie lernen vielmehr Beziehungen zwischen Pixeln, die dem Menschen verborgen bleiben, aber dennoch mit Bildern bestimmter realer Objekte korrelieren. Die Veränderung dieser Muster in einem legitimen Bild kann zu „adversariellen“ Bildern führen, die das System falsch klassifiziert. [ 156 ] [ 157 ]
Adversarial Vulnerabilitys können auch in nichtlinearen Systemen oder durch nicht-musterhafte Störungen entstehen. Bei manchen Systemen lässt sich die Ausgabe verändern, indem man lediglich ein einziges, adversariell ausgewähltes Pixel ändert. [ 158 ] Modelle des maschinellen Lernens sind häufig anfällig für Manipulation oder Umgehung durch adversarial machine learning . [ 159 ]
Forscher haben gezeigt, wie Hintertüren unbemerkt in Klassifizierungsmodelle des maschinellen Lernens (z. B. für die Kategorien „Spam“ und „Kein Spam“ von Beiträgen) integriert werden können, die häufig von Dritten entwickelt oder trainiert werden. Diese Dritten können die Klassifizierung beliebiger Eingaben ändern, selbst wenn eine gewisse Daten-/Softwaretransparenz besteht, möglicherweise einschließlich eines White-Box-Zugriffs . [ 160 ] [ 161 ] [ 162 ]
Modellbewertungen
Die Klassifizierung von Modellen des maschinellen Lernens kann durch Genauigkeitsschätzungsverfahren wie die Holdout -Methode validiert werden. Dabei werden die Daten in einen Trainings- und einen Testdatensatz aufgeteilt (üblicherweise 2/3 Trainingsdatensatz und 1/3 Testdatensatz) und die Leistung des trainierten Modells anhand des Testdatensatzes bewertet. Im Vergleich dazu partitioniert die K-fache Kreuzvalidierung die Daten zufällig in K Teilmengen. Anschließend werden K Experimente durchgeführt, wobei jeweils eine Teilmenge zur Evaluierung und die verbleibenden K-1 Teilmengen zum Trainieren des Modells verwendet werden. Zusätzlich zu den Holdout- und Kreuzvalidierungsverfahren kann auch das Bootstrap -Verfahren , das n Instanzen mit Zurücklegen aus dem Datensatz zieht, zur Bewertung der Modellgenauigkeit eingesetzt werden. [ 163 ]
Neben der Gesamtgenauigkeit berichten Forscher häufig über Sensitivität und Spezifität , d. h. die Rate richtig positiver (TPR) bzw. richtig negativer (TNR) Ergebnisse. Ebenso werden mitunter die Rate falsch positiver (FPR) und falsch negativer (FNR) Ergebnisse angegeben. Diese Raten sind jedoch Verhältnisse, die Zähler und Nenner nicht offenlegen. Die Receiver Operating Characteristic (ROC) und die zugehörige Fläche unter der ROC-Kurve (AUC) bieten zusätzliche Instrumente zur Bewertung von Klassifikationsmodellen. Ein höherer AUC-Wert korreliert mit einem leistungsfähigeren Modell. [ 164 ]
Ethik
Die Ethik der künstlichen Intelligenz umfasst ein breites Spektrum an Themen innerhalb der KI, denen besondere ethische Implikationen zugeschrieben werden. [ 165 ] Dazu gehören algorithmische Verzerrungen , Fairness , Verantwortlichkeit , Transparenz, Datenschutz und Regulierung , insbesondere wenn Systeme menschliche Entscheidungsfindung beeinflussen oder automatisieren. Sie umfasst auch verschiedene aktuelle oder potenzielle zukünftige Herausforderungen wie Maschinenethik (wie man Maschinen entwickelt, die sich ethisch verhalten), letale autonome Waffensysteme , die Dynamik des Wettrüstens , KI-Sicherheit und -Ausrichtung , technologische Arbeitslosigkeit , KI-gestützte Desinformation , [ 166 ] den Umgang mit bestimmten KI-Systemen, wenn ihnen ein moralischer Status zukommt (KI-Wohlbefinden und -Rechte), künstliche Superintelligenz und existenzielle Risiken . [ 165 ]
In einigen Anwendungsbereichen können auch besonders wichtige ethische Implikationen bestehen, wie beispielsweise im Gesundheitswesen , im Bildungswesen, im Strafrecht oder im Militär.
Voreingenommenheit
Verschiedene Ansätze des maschinellen Lernens können unter unterschiedlichen Datenverzerrungen leiden. Ein speziell auf Basis aktueller Kundendaten trainiertes System kann möglicherweise die Bedürfnisse neuer Kundengruppen, die in den Trainingsdaten nicht repräsentiert sind, nicht vorhersagen. Beim Training mit von Menschen erstellten Daten übernimmt das maschinelle Lernen mit hoher Wahrscheinlichkeit die in der Gesellschaft bereits vorhandenen, sowohl systembedingten als auch unbewussten Vorurteile. [ 167 ]
Systeme, die mit verzerrten Datensätzen trainiert werden, können diese Verzerrungen bei der Anwendung selbst aufweisen (algorithmische Verzerrung) und somit kulturelle Vorurteile digitalisieren. [ 168 ] Beispielsweise stellte die britische Kommission für Rassengleichheit 1988 fest, dass die St. George’s Medical School ein Computerprogramm verwendete, das mit Daten früherer Zulassungsmitarbeiter trainiert worden war. Dieses Programm hatte fast 60 Bewerber abgelehnt, die entweder Frauen waren oder nicht-europäisch klingende Namen hatten. [ 167 ] Die Verwendung von Daten zur Personalauswahl eines Unternehmens mit rassistischen Einstellungspraktiken kann dazu führen, dass ein System für maschinelles Lernen diese Verzerrung reproduziert, indem es Bewerber anhand ihrer Ähnlichkeit mit früheren erfolgreichen Bewerbern bewertet. [ 169 ] [ 170 ] Ein weiteres Beispiel ist der Vorhersagealgorithmus des Unternehmens Geolitica , der nach dem Training mit historischen Kriminalitätsdaten zu „unverhältnismäßig hoher Polizeipräsenz in einkommensschwachen und Minderheitengemeinschaften“ führte. [ 171 ]
Während die verantwortungsvolle Datenerfassung und Dokumentation der von einem System verwendeten algorithmischen Regeln als kritischer Bestandteil des maschinellen Lernens gilt, machen einige Forscher die mangelnde Beteiligung und Repräsentation von Minderheiten im Bereich der KI für die Anfälligkeit des maschinellen Lernens für Verzerrungen verantwortlich. [ 172 ] Tatsächlich machen Frauen laut einer Studie der Computing Research Association aus dem Jahr 2021 nur 16,1 % aller KI-spezialisierten Dozenten an verschiedenen Universitäten weltweit aus. [ 173 ] Darüber hinaus gaben unter den US-amerikanischen Doktoranden im Bereich KI 45 % an, weiß zu sein, 22,4 % asiatisch, 3,2 % hispanisch und 2,4 % afroamerikanisch, was den Mangel an Diversität im Bereich der KI weiter verdeutlicht. [ 173 ]
Es hat sich gezeigt, dass aus Daten trainierte Sprachmodelle menschenähnliche Verzerrungen aufweisen. [ 174 ] [ 175 ] Da menschliche Sprachen Verzerrungen enthalten, werden Maschinen, die mit Sprachkorpora trainiert werden, diese zwangsläufig ebenfalls erlernen. [ 176 ] [ 177 ] Im Jahr 2016 testete Microsoft Tay , einen Chatbot , der von Twitter lernte, und dieser eignete sich schnell rassistische und sexistische Ausdrücke an. [ 178 ]
In einem Experiment der investigativen Journalismusorganisation ProPublica stufte ein Algorithmus für maschinelles Lernen, der die Rückfallquoten von Gefangenen analysierte, schwarze Angeklagte fälschlicherweise doppelt so häufig als Hochrisikofälle ein wie weiße Angeklagte. [ 171 ] Im Jahr 2015 kennzeichnete Google Fotos zwei schwarze Personen fälschlicherweise als Gorillas, was für Kontroversen sorgte. Die Kennzeichnung als Gorilla wurde daraufhin entfernt, und auch 2023 konnte das System Gorillas noch nicht erkennen. [ 179 ] Ähnliche Probleme bei der Erkennung nicht-weißer Personen wurden in vielen anderen Systemen festgestellt. [ 180 ]
Aufgrund dieser Herausforderungen könnte die effektive Nutzung von maschinellem Lernen in anderen Bereichen länger dauern. [ 181 ] Die Sorge um Fairness im maschinellen Lernen, also die Reduzierung von Verzerrungen und die Förderung seines Einsatzes zum Wohle der Menschheit, wird zunehmend von KI-Wissenschaftlern geäußert, darunter auch von Fei-Fei Li , die sagte: „KI ist nicht künstlich. Sie ist von Menschen inspiriert, von Menschen geschaffen und – was am wichtigsten ist – sie beeinflusst Menschen. Sie ist ein mächtiges Werkzeug, das wir erst allmählich verstehen, und das ist eine große Verantwortung.“ [ 182 ]
Finanzielle Anreize
Unter Gesundheitsexperten bestehen Bedenken, dass diese Systeme nicht im öffentlichen Interesse, sondern als Gewinnmaschinen konzipiert sein könnten. Dies gilt insbesondere für die Vereinigten Staaten, wo seit Langem ein ethisches Dilemma zwischen der Verbesserung der Gesundheitsversorgung und der gleichzeitigen Gewinnmaximierung besteht. Beispielsweise könnten die Algorithmen so gestaltet sein, dass Patienten unnötige Untersuchungen oder Medikamente erhalten, an denen die Eigentümer der Algorithmen Anteile besitzen. Maschinelles Lernen im Gesundheitswesen birgt das Potenzial, Fachkräften ein zusätzliches Werkzeug für Diagnose, Medikation und Therapieplanung an die Hand zu geben. Dies erfordert jedoch, dass diese potenziellen Verzerrungen minimiert werden. [ 183 ]
Hardware
Seit den 2010er Jahren haben Fortschritte sowohl bei Algorithmen des maschinellen Lernens als auch bei Computerhardware zu effizienteren Methoden für das Training tiefer neuronaler Netze (einem speziellen Teilgebiet des maschinellen Lernens) geführt, die viele Schichten nichtlinearer verborgener Einheiten enthalten. [ 184 ] Bis 2019 hatten Grafikprozessoren ( GPUs ), oft mit KI-spezifischen Erweiterungen, CPUs als dominierende Methode für das Training groß angelegter kommerzieller Cloud-KI abgelöst. [ 185 ] OpenAI schätzte den Hardware-Rechenaufwand der größten Deep-Learning-Projekte von AlexNet (2012) bis AlphaZero (2017) und stellte eine 300.000-fache Steigerung des Rechenbedarfs mit einer Verdopplungszeit von 3,4 Monaten fest. [ 186 ] [ 187 ]
Tensor Processing Units (TPUs)
Tensor Processing Units (TPUs) sind spezialisierte Hardwarebeschleuniger, die von Google speziell für Machine-Learning-Anwendungen entwickelt wurden. Im Gegensatz zu herkömmlichen GPUs und FPGAs sind TPUs für Tensorberechnungen optimiert und daher besonders effizient für Deep-Learning-Aufgaben wie Training und Inferenz. Sie werden häufig in Google Cloud AI-Diensten und großen Machine-Learning-Modellen wie Googles DeepMind AlphaFold und umfangreichen Sprachmodellen eingesetzt. TPUs nutzen Matrixmultiplikationseinheiten und Speicher mit hoher Bandbreite, um Berechnungen zu beschleunigen und gleichzeitig die Energieeffizienz zu erhalten. [ 188 ] Seit ihrer Einführung im Jahr 2016 haben sich TPUs zu einer Schlüsselkomponente der KI-Infrastruktur entwickelt, insbesondere in Cloud-Umgebungen.
Neuromorphes Rechnen
Neuromorphes Rechnen bezeichnet eine Klasse von Computersystemen, die die Struktur und Funktionalität biologischer neuronaler Netze nachbilden sollen. Diese Systeme können durch softwarebasierte Simulationen auf herkömmlicher Hardware oder durch spezialisierte Hardwarearchitekturen implementiert werden. [ 189 ]
Physikalische neuronale Netzwerke
Ein physikalisches neuronales Netzwerk ist eine spezielle Art neuromorpher Hardware, die elektrisch einstellbare Materialien wie Memristoren nutzt, um die Funktion neuronaler Synapsen nachzubilden . Der Begriff „physikalisches neuronales Netzwerk“ unterstreicht die Verwendung physischer Hardware für die Datenverarbeitung im Gegensatz zu softwarebasierten Implementierungen. Er bezeichnet allgemein künstliche neuronale Netzwerke, die Materialien mit einstellbarem Widerstand verwenden, um neuronale Synapsen zu replizieren. [ 190 ] [ 191 ]
Eingebettetes maschinelles Lernen
Eingebettetes maschinelles Lernen ist ein Teilgebiet des maschinellen Lernens, bei dem Modelle auf eingebetteten Systemen mit begrenzten Rechenressourcen, wie z. B. Wearables , Edge-Geräten und Mikrocontrollern , eingesetzt werden . [ 192 ] [ 193 ] [ 194 ] [ 195 ] Die direkte Ausführung von Modellen auf diesen Geräten eliminiert die Notwendigkeit, Daten zur Weiterverarbeitung auf Cloud-Server zu übertragen und zu speichern. Dadurch wird das Risiko von Datenschutzverletzungen, Datenlecks und dem Diebstahl von geistigem Eigentum, personenbezogenen Daten und Geschäftsgeheimnissen reduziert. Eingebettetes maschinelles Lernen kann durch verschiedene Techniken realisiert werden, darunter Hardwarebeschleunigung [ 196 ] [ 197 ] , approximatives Rechnen [ 198 ] und Modelloptimierung. [ 199 ] [ 200 ] Gängige Optimierungstechniken umfassen Pruning , Quantisierung , Wissensdestillation , Niedrigrangfaktorisierung, Netzwerkarchitektursuche und Parameterteilung.
Software
Freie und Open-Source-Software
- Mahout
- Apache OpenNLP
- Apache SINGA
- Spark MLlib
- Apache SystemDS
- Café
- CatBoost
- Deeplearning4j
- DeepSpeed
- Dlib
- ELKI
- Flux.jl
- Gensim
- Google JAX
- H₂O
- Infer.NET
- JASP
- Jubatus
- Keras
- Kubeflow
- LIBSVM
- LightGBM
- Hammer
- Microsoft Cognitive Toolkit
- MindSpore
- ML.NET
- mlpack
- MXNet
- OpenNN
- Orange
- ROOT (TMVA mit ROOT)
- scikit-learn
- Shogun
- TensorFlow
- Theano
- Torch / PyTorch / PyTorch Lightning
- Vowpal Wabbit
- Weka / MOA
- XGBoost
- Yooreeka
Proprietäre Software mit kostenlosen und Open-Source-Versionen
Proprietäre Software
- Amazon Machine Learning
- Angoss KnowledgeSTUDIO
- Azure Machine Learning
- IBM Watson Studio
- Google Cloud Vertex AI
- Google Prediction API
- IBM SPSS Modeller
- KXEN-Modellierer
- LIONsolver
- Mathematica
- MATLAB
- Neural Designer
- NeuroSolutions
- Oracle Data Mining
- Oracle AI Platform Cloud Service
- PolyAnalyst
- RCASE
- SAS Enterprise Miner
- SequenzL
- Splunk
- STATISTICA Data Miner
Zeitschriften
- Zeitschrift für maschinelles Lernen
- Maschinelles Lernen
- Natürliche maschinelle Intelligenz
- Neuronale Berechnung
- IEEE Transactions on Pattern Analysis and Machine Intelligence
Konferenzen
- AAAI-Konferenz über Künstliche Intelligenz
- Vereinigung für Computerlinguistik ( ACL )
- Europäische Konferenz über Maschinelles Lernen und Prinzipien und Praxis der Wissensentdeckung in Datenbanken ( ECML PKDD )
- Internationale Konferenz über Methoden der Computerintelligenz für Bioinformatik und Biostatistik ( CIBB )
- Internationale Konferenz für Maschinelles Lernen ( ICML )
- Internationale Konferenz über Lernrepräsentationen ( ICLR )
- Internationale Konferenz über intelligente Roboter und Systeme ( IROS )
- Konferenz über Wissensentdeckung und Data Mining ( KDD )
- Konferenz über neuronale Informationsverarbeitungssysteme ( NeurIPS )
Siehe auch
- Automatisiertes maschinelles Lernen – Prozess der Automatisierung der Anwendung von maschinellem Lernen
- Big Data – Extrem große oder komplexe Datensätze
- Deep Learning – ein Teilgebiet des maschinellen Lernens, das sich mit künstlichen neuronalen Netzen befasst.
- Differenzierbare Programmierung – Programmierparadigma
- Google Colab – eine sofort einsatzbereite Online-IDE für maschinelles Lernen in Python und Julia
- Liste von Datensätzen für die Forschung im Bereich maschinelles Lernen
- Liste der Algorithmen für maschinelles Lernen und Liste der Algorithmen für maschinelles Lernen und statistische Klassifizierung
- M-Theorie (Lernrahmen) – Rahmenwerk im maschinellen Lernen
- Maschinelles Verlernen – Forschungsgebiet der künstlichen Intelligenz
- Überblick über maschinelles Lernen
- Solomonoffs Theorie des induktiven Schließens – Mathematische Theorie
- TinyML – Maschinelles Lernen auf energieeffizienten eingebetteten Systemen
Referenzen
- Die Definition „ohne explizite Programmierung“ wird häufig Arthur Samuel zugeschrieben , der 1959 den Begriff „maschinelles Lernen“ prägte. Der Ausdruck findet sich jedoch nicht wörtlich in dieser Publikation und könnte eine spätere Paraphrase sein . Siehe dazu: „Paraphrasiert nach Arthur Samuel (1959): Die Frage ist: Wie können Computer lernen, Probleme zu lösen, ohne explizit programmiert zu werden?“ in Koza , John R.; Bennett, Forrest H.; Andre, David; Keane, Martin A. (1996). „Automatisierter Entwurf von Topologie und Dimensionierung analoger elektrischer Schaltungen mittels genetischer Programmierung“. Künstliche Intelligenz im Design '96 . Dordrecht, Niederlande: Springer Netherlands. S. 151–170 . doi : 10.1007/978-94-009-0279-4_9 . ISBN 978-94-010-6610-5Die
- ^ a b c Bishop, CM (2006), Mustererkennung und maschinelles Lernen , Springer, ISBN 978-0-387-31073-2
- ^ Maschinelles Lernen und Mustererkennung „können als zwei Seiten derselben Medaille betrachtet werden“. [ 2 ] : vii
- ^ a b Friedman, Jerome H. (1998). "Data Mining and Statistics: What's the connection?". Computing Science and Statistics . 29 (1): 3– 9.
- ^ Samuel, Arthur (1959). „Einige Studien zum maschinellen Lernen anhand des Damespiels“. IBM Journal of Research and Development . 3 (3): 210–229 . CiteSeerX 10.1.1.368.2254 . doi : 10.1147/rd.33.0210 . S2CID 2126705 .
- ^ a b R. Kohavi und F. Provost, „Glossary of terms“, Machine Learning, Bd. 30, Nr. 2–3, S. 271–274, 1998.
- ^ Gerovitch, Slava (9. April 2015). „Wie der Computer sich an der Sowjetunion rächte“ . Nautilus . Archiviert vom Original am 22. September 2021. Abgerufen am 19. September 2021 .
- ^ Lindsay, Richard P. (September 1964). „The Impact of Automation On Public Administration“. Western Political Quarterly . 17 (3): 78–81 . doi : 10.1177/106591296401700364 .
- ^ a b c „Geschichte und Entwicklung des maschinellen Lernens: Eine Zeitleiste“ . WhatIs . Archiviert vom Original am 8. Dezember 2023. Abgerufen am 8. Dezember 2023 .
- ^ Milner, Peter M. (1993). „The Mind and Donald O. Hebb“ ( PDF) . Scientific American . 268 (1): 124–129 . Bibcode : 1993SciAm.268a.124M . doi : 10.1038/scientificamerican0193-124 . ISSN 0036-8733 . JSTOR 24941344. PMID 8418480 .
- ^ „Wissenschaft: Der Fehlerknopf“, Time , 18. August 1961.
- ^ Nilsson, Nils J. (1965). Learning Machines . McGraw-Hill.
- ^ Duda, Richard O.; Hart, Peter E. (1973). Mustererkennung und Szenenanalyse . Wiley Interscience.
- ^ S. Bozinovski, „Teaching space: A representation concept for adaptive pattern classification“, COINS Technical Report Nr. 81-28, Fachbereich Informatik, Universität von Massachusetts in Amherst, MA, 1981. https://web.cs.umass.edu/publication/docs/1981/UM-CS-1981-028.pdf (Archiviert am 25. Februar 2021 im Internet Archive).
- ^ a b Mitchell, T. (1997). Maschinelles Lernen . McGraw Hill. S. 2. ISBN 978-0-07-042807-2Die
- ^ Turing, Alan (Oktober 1950). „Computing Machinery and Intelligence“ (PDF) . Mind . 59 (236).
- ^ Harnad, Stevan (2008), „Das Annotationsspiel: Zu Turing (1950) über Rechnen, Maschinen und Intelligenz“ , in: Epstein, Robert; Peters, Grace (Hrsg.), Das Turing-Test-Quellenbuch: Philosophische und methodologische Fragen auf der Suche nach dem denkenden Computer , Kluwer, S. 23–66 , ISBN 978-1-4020-6708-2archiviert vom Original am 9. März 2012 , abgerufen am 11. Dezember 2012
- ^ Goodfellow, Ian; Pouget-Abadie, Jean; Mirza, Mehdi (2014). Generative adversarial nets (PDF) . Advances in Neural Information Processing Systems 27 (2014).
- ^ Silver, David; Huang, Aja; Maddison, Christopher J. (2016). „Das Go-Spiel mit tiefen neuronalen Netzen und Baumsuche meistern“. Nature . 529 (7587): 484–489 . Bibcode : 2016Natur.529..484S . doi : 10.1038/nature16961 . PMID 26819042 .
- ^ Sindhu V, Nivedha S, Prakash M (Februar 2020). „Eine empirische wissenschaftliche Untersuchung zur Bioinformatik im maschinellen Lernen“ . Journal of Mechanics of Continua and Mathematical Sciences (7). doi : 10.26782/jmcms.spl.7/2020.02.00006 .
- ^ Sarle, Warren S. (1994). „Neuronale Netze und statistische Modelle“. SUGI 19: Proceedings der neunzehnten jährlichen internationalen Konferenz der SAS-Anwendergruppe . SAS Institute. S. 1538–50 . ISBN 978-1-55544-611-6OCLC 35546178 .
- Russell , Stuart ; Norvig , Peter ( 2003) [1995]. Künstliche Intelligenz : Ein moderner Ansatz (2. Aufl.). Prentice Hall. ISBN 978-0137903955Die
- ^ a b Langley, Pat (2011). „Die sich wandelnde Wissenschaft des maschinellen Lernens“ . Machine Learning . 82 (3): 275–9 . doi : 10.1007/s10994-011-5242-y .
- ^ Mahoney, Matt. „Begründung für einen Benchmark zur Komprimierung großer Texte“ . Florida Institute of Technology. Archiviert vom Original am 18. August 2006. Abgerufen am 5. März 2013 .
- ^ Shmilovici A.; Kahiri Y.; Ben-Gal I.; Hauser S. (2009). „ Measuring the Efficiency of the Intraday Forex Market with a Universal Data Compression Algorithm“ ( PDF) . Computational Economics . 33 (2): 131–154 . CiteSeerX 10.1.1.627.3751 . doi : 10.1007/s10614-008-9153-3 . S2CID 17234503. Archiviert (PDF) vom Original am 9. Juli 2009.
- ^ Ben-Gal, I. (2008). „On the Use of Data Compression Measures to Analyze Robust Designs“ (PDF) . IEEE Transactions on Reliability . 54 (3): 381–388 . doi : 10.1109/TR.2005.853280 . S2CID 9376086. Archiviert vom Original (PDF) am 26. September 2020. Abgerufen am 6. April 2016 .
- ^ D. Scully; Carla E. Brodley (2006). „Komprimierung und maschinelles Lernen: Eine neue Perspektive auf Merkmalsraumvektoren“. Data Compression Conference (DCC’06) . S. 332. doi : 10.1109/DCC.2006.13 . ISBN 0-7695-2545-8. S2CID 12311412 .
- ^ Gary Adcock (5. Januar 2023). „Was ist KI-Videokomprimierung?“ . massive.io . Archiviert vom Original am 6. April 2023. Abgerufen am 6. April 2023 .
- ^ Mentzer, Fabian; Toderici, George; Tschannen, Michael; Agustsson, Eirikur (2020). „Generative Bildkomprimierung mit hoher Wiedergabetreue“. arXiv : 2006.09965 [ eess.IV ].
- ^ „Was ist unüberwachtes Lernen? | IBM“ . www.ibm.com . 23. September 2021. Archiviert vom Original am 5. Februar 2024. Abgerufen am 5. Februar 2024 .
- ^ „Differentially private clustering for large-scale datasets“ . blog.research.google . 25. Mai 2023. Archiviert vom Original am 16. März 2024. Abgerufen am 16. März 2024 .
- ^ Edwards, Benj (28. September 2023). „KI-Sprachmodelle können PNG und FLAC bei verlustfreier Komprimierung übertreffen, so eine Studie“ . Ars Technica . Archiviert vom Original am 7. März 2024. Abgerufen am 7. März 2024 .
- ^ Delétang, Grégoire; Ruoss, Anian; Duquenne, Paul-Ambroise; Catt, Elliot; Genewein, Tim; Mattern, Christopher; Grau-Moya, Jordi; Li Kevin Wenliang; Aitchison, Matthew; Orseau, Laurent; Hutter, Marcus; Veness, Joel (2023). „Sprachmodellierung ist Komprimierung“. arXiv : 2309.10668 [ cs.LG ].
- ^ Le Roux, Nicolas; Bengio, Yoshua; Fitzgibbon, Andrew (2012). „Verbesserung von Methoden erster und zweiter Ordnung durch Modellierung von Unsicherheit“ . In: Sra, Suvrit; Nowozin, Sebastian; Wright, Stephen J. (Hrsg.). Optimierung für maschinelles Lernen . MIT Press. S. 404. ISBN 978-0-262-01646-9Archiviert vom Original am 17. Januar 2023. Abgerufen am 12. November 2020 .
- ^ Bzdok, Danilo; Altman, Naomi ; Krzywinski , Martin (2018). „Statistik versus Maschinelles Lernen“ . Nature Methods . 15 (4): 233–234 . doi : 10.1038/nmeth.4642 . PMC 6082636. PMID 30100822 .
- ^ Hung et al. Algorithmen zur Messung der Leistung von Chirurgen und zur Vorhersage klinischer Ergebnisse in der Roboterchirurgie. JAMA Surg. 2018
- ^ Cornell University Library (August 2001). „Breiman: Statistische Modellierung: Die zwei Kulturen (mit Kommentaren und einer Erwiderung des Autors)“ . Statistical Science . 16 (3). doi : 10.1214/ss/1009213726 . S2CID 62729017. Archiviert vom Original am 26. Juni 2017. Abgerufen am 8. August 2015 .
- ^ Gareth James; Daniela Witten; Trevor Hastie; Robert Tibshirani (2013). Einführung in das statistische Lernen . Springer. S. vii. Archiviert vom Original am 23. Juni 2019. Abgerufen am 25. Oktober 2014 .
- ^ Ramezanpour, A.; Beam, AL; Chen, JH; Mashaghi, A. (17. November 2020). „Statistische Physik für die medizinische Diagnostik: Lern-, Inferenz- und Optimierungsalgorithmen“ . Diagnostics . 10 ( 11): 972. doi : 10.3390/diagnostics10110972 . PMC 7699346. PMID 33228143 .
- ^ Mashaghi, A.; Ramezanpour, A. (16. März 2018). „Statistische Physik der medizinischen Diagnostik: Untersuchung eines probabilistischen Modells“. Physical Review E. 97 ( 3–1 ) 032118. arXiv : 1803.10019 . Bibcode : 2018PhRvE..97c2118M . doi : 10.1103/PhysRevE.97.032118 . PMID 29776109. S2CID 4955393 .
- ^ Mohri, Mehryar ; Rostamizadeh, Afshin; Talwalkar, Ameet (2012). Grundlagen des maschinellen Lernens . USA, Massachusetts: MIT Press. ISBN 9780262018258Die
- ^ Alpaydin, Ethem (2010). Einführung in maschinelles Lernen . London: The MIT Press. ISBN 978-0-262-01243-0Abgerufen am 4. Februar 2017 .
- ^ Jordan, MI; Mitchell, TM (17. Juli 2015). „Maschinelles Lernen: Trends, Perspektiven und Aussichten“. Science . 349 ( 6245): 255–260 . Bibcode : 2015Sci...349..255J . doi : 10.1126/science.aaa8415 . PMID 26185243. S2CID 677218 .
- ^ El Naqa, Issam; Murphy, Martin J. (2015). „Was ist maschinelles Lernen?“. Maschinelles Lernen in der Strahlentherapie . S. 3–11 . doi : 10.1007/978-3-319-18305-3_1 . ISBN 978-3-319-18304-6. S2CID 178586107 .
- Okolie , Jude A.; Savage, Shauna; Ogbaga, Chukwuma C.; Gunes, Burcu (Juni 2022). „Bewertung des Potenzials von Methoden des maschinellen Lernens zur Untersuchung der Entfernung von Arzneimitteln aus Abwasser mittels Biokohle oder Aktivkohle“ . Total Environment Research Themes . 1–2 100001. Bibcode : 2022TERT....100001O . doi : 10.1016/j.totert.2022.100001 . S2CID 249022386 .
- Russell , Stuart J.; Norvig, Peter (2010). Künstliche Intelligenz: Ein moderner Ansatz (3. Aufl.). Prentice Hall. ISBN 978-0-13-604259-4Die
- ^ Mohri, Mehryar; Rostamizadeh, Afshin; Talwalkar, Ameet (2012). Grundlagen des maschinellen Lernens . The MIT Press. ISBN 978-0-262-01825-8Die
- ^ Alpaydin, Ethem (2010). Einführung in maschinelles Lernen . MIT Press. S. 9. ISBN 978-0-262-01243-0Archiviert vom Original am 17. Januar 2023. Abgerufen am 25. November 2018 .
- ^ De Sa, Christopher (Frühjahr 2022). „Vorlesungsskript 2: Überwachtes Lernen“ . Cornell: Computer Science . Abgerufen am 1. Juli 2024 .
- ^ Jordan, Michael I.; Bishop, Christopher M. (2004). „Neuronale Netze“. In: Allen B. Tucker (Hrsg.). Computer Science Handbook, Zweite Auflage (Abschnitt VII: Intelligente Systeme) . Boca Raton, Florida: Chapman & Hall/CRC Press LLC. ISBN 978-1-58488-360-9Die
- ^ Misra, Ishan; Maaten, Laurens van der (2020). Selbstüberwachtes Lernen von prätextinvarianten Repräsentationen . 2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition. Seattle, WA, USA: IEEE . S. 6707–6717 . arXiv : 1912.01991 . doi : 10.1109/CVPR42600.2020.00674 .
- ^ Jaiswal, Ashish; Babu, Ashwin Ramesh; Zadeh, Mohammad Zaki; Banerjee, Debapriya; Makedon, Fillia (März 2021). „Eine Übersicht über kontrastives selbstüberwachtes Lernen“ . Technologies . 9 (1): 2. arXiv : 2011.00362 . doi : 10.3390/technologies9010002 . ISSN 2227-7080 .
- Roweis , Sam T.; Saul, Lawrence K. (22. Dezember 2000). „Nichtlineare Dimensionsreduktion durch lokal lineare Einbettung“. Science . 290 (5500): 2323–2326 . Bibcode : 2000Sci...290.2323R . doi : 10.1126/science.290.5500.2323 . PMID 11125150 .
- ^ Alex Ratner; Stephen Bach; Paroma Varma; Chris. „Weak Supervision: The New Programming Paradigm for Machine Learning“ . hazyresearch.github.io . Unter Bezugnahme auf Arbeiten zahlreicher weiterer Mitglieder von Hazy Research. Archiviert vom Original am 6. Juni 2019. Abgerufen am 6. Juni 2019 .
- ^ van Otterlo, M.; Wiering, M. (2012). „Reinforcement Learning and Markov Decision Processes“. Reinforcement Learning . Adaptation, Learning, and Optimization. Vol. 12. S. 3–42 . doi : 10.1007/978-3-642-27645-3_1 . ISBN 978-3-642-27644-6Die
- ^ Pavel Brazdil; Christophe Giraud Carrier; Carlos Soares; Ricardo Vilalta (2009). Metalearning: Applications to Data Mining (4. Aufl.). Springer Science+Business Media . S. 10–14 , passim . ISBN 978-3-540-73262-4Die
- ^ Bozinovski, S. (1982). „Ein selbstlernendes System mit sekundärer Verstärkung“. In: Trappl, Robert (Hrsg.). Kybernetik und Systemforschung: Tagungsband der sechsten europäischen Konferenz über Kybernetik und Systemforschung . North-Holland. S. 397–402 . ISBN 978-0-444-86488-8Die
- ^ Bozinovski, S. (1999). „Crossbar Adaptive Array: Das erste konnektionistische Netzwerk, das das Problem des verzögerten Reinforcement Learnings löste“. Artificial Neural Nets and Genetic Algorithms . S. 320–325 . doi : 10.1007/978-3-7091-6384-9_54 . ISBN 978-3-211-83364-3Die
- ^ Bozinovski, Stevo (2014). „Modellierung von Mechanismen der Kognition-Emotion-Interaktion in künstlichen neuronalen Netzen seit 1981“ . Procedia Computer Science . 41 : 255–263 . doi : 10.1016/j.procs.2014.11.111 .
- ^ Bozinovski, Stevo; Bozinovska, Liljana (2001). „Selbstlernende Agenten: Eine konnektionistische Theorie der Emotion basierend auf Crossbar-Werturteilen“. Cybernetics and Systems . 32 (6): 637–669 . doi : 10.1080/01969720118145 .
- ^ Y. Bengio ; A. Courville; P. Vincent (2013). „Representation Learning: A Review and New Perspectives“. IEEE Transactions on Pattern Analysis and Machine Intelligence . 35 ( 8): 1798–1828 . arXiv : 1206.5538 . Bibcode : 2013ITPAM..35.1798B . doi : 10.1109/tpami.2013.50 . PMID 23787338. S2CID 393948 .
- ^ Nathan Silber; Jason DM Rennie; Tommi S. Jaakkola (2004). Maximum-Margin-Matrix-Faktorisierung . NIPS .
- Coates , Adam; Lee, Honglak; Ng, Andrew Y. (2011). Eine Analyse einschichtiger Netzwerke beim unüberwachten Merkmalslernen (PDF) . Internationale Konferenz für KI und Statistik (AISTATS). Archiviert vom Original (PDF) am 13. August 2017. Abgerufen am 25. November 2018 .
- ^ Csurka, Gabriella; Dance, Christopher C.; Fan, Lixin; Willamowski, Jutta; Bray, Cédric (2004). Visuelle Kategorisierung mit Bags of Keypoints (PDF) . ECCV Workshop on Statistical Learning in Computer Vision. Archiviert (PDF) vom Original am 13. Juli 2019. Abgerufen am 29. August 2019 .
- ^ Daniel Jurafsky; James H. Martin (2009). Sprachverarbeitung . Pearson Education International. S. 145–146 .
- ^ Lu , Haiping; Plataniotis, KN; Venetsanopoulos, AN (2011). „A Survey of Multilinear Subspace Learning for Tensor Data“ (PDF) . Pattern Recognition . 44 (7): 1540–1551 . Bibcode : 2011PatRe..44.1540L . doi : 10.1016/j.patcog.2011.01.004 . Archiviert (PDF) vom Original am 10. Juli 2019. Abgerufen am 4. September 2015 .
- ^ Yoshua Bengio (2009). Lernen tiefer Architekturen für KI . Now Publishers Inc., S. 1–3 . ISBN 978-1-60198-294-0Archiviert vom Original am 17. Januar 2023. Abgerufen am 15. Februar 2016 .
- ^ Tillmann, AM (2015). „Zur rechnerischen Unlösbarkeit des exakten und approximativen Wörterbuchlernens“. IEEE Signal Processing Letters . 22 (1): 45–49 . arXiv : 1405.6664 . Bibcode : 2015ISPL...22...45T . doi : 10.1109/LSP.2014.2345761 . S2CID 13342762 .
- ^ Aharon, M. , M. Elad und A. Bruckstein. 2006. „ K-SVD: Ein Algorithmus zum Entwurf übervollständiger Wörterbücher für die spärliche Repräsentation. Archiviert am 23.11.2018 in der Wayback Machine .“ IEEE Transactions on Signal Processing 54 (11): 4311–4322
- ^ Zimek, Arthur; Schubert, Erich (2017), „Outlier Detection“, Encyclopedia of Database Systems , Springer New York, S. 1–5 , doi : 10.1007/978-1-4899-7993-3_80719-1 , ISBN 978-1-4899-7993-3
- ^ Hodge, VJ; Austin, J. (2004). „A Survey of Outlier Detection Methodologies“ ( PDF) . Artificial Intelligence Review . 22 (2): 85–126 . CiteSeerX 10.1.1.318.4023 . doi : 10.1007/s10462-004-4304-y . S2CID 59941878. Archiviert (PDF) vom Original am 22. Juni 2015. Abgerufen am 25. November 2018 .
- ^ Dokas, Paul; Ertoz, Levent; Kumar, Vipin; Lazarevic, Aleksandar; Srivastava, Jaideep; Tan, Pang-Ning (2002). „Data Mining zur Erkennung von Netzwerkangriffen“ (PDF) . Proceedings NSF Workshop on Next Generation Data Mining . Archiviert (PDF) vom Original am 23. September 2015. Abgerufen am 26. März 2023 .
- ^ Chandola, V.; Banerjee, A.; Kumar, V. (2009). „Anomalieerkennung: Ein Überblick“. ACM Computing Surveys . 41 (3): 1–58 . doi : 10.1145/1541880.1541882 . S2CID 207172599 .
- Fleer , S.; Moringen, A.; Klatzky, R. L.; Ritter, H. (2020). „Effizientes Lernen der haptischen Formerkundung mit einem starren taktilen Sensorarray“, S. Fleer, A. Moringen, R. Klatzky, H. Ritter . PLOS ONE . 15 (1) e0226880. arXiv : 1902.07501 . doi : 10.1371/journal.pone.0226880 . PMC 6940144. PMID 31896135 .
- ^ Moringen, Alexandra; Fleer, Sascha; Walck, Guillaume; Ritter, Helge (2020), Nisky, Ilana; Hartcher-O'Brien, Jess; Wiertlewski, Michael; Smeets, Jeroen (Hrsg.), „Attention-Based Robot Learning of Haptic Interaction“, Haptics: Science, Technology, Applications , Lecture Notes in Computer Science, vol. 12272, Cham: Springer International Publishing, S. 462–470 , doi : 10.1007/978-3-030-58147-3_51 , ISBN 978-3-030-58146-6, S2CID 220069113
{{citation}}: CS1 Wartung: Arbeitsparameter mit ISBN ( Link ) - ^ Piatetsky-Shapiro, Gregory (1991), Discovery, analysis, and presentation of strong rules , in Piatetsky-Shapiro, Gregory; and Frawley, William J.; eds, Knowledge Discovery in Databases , AAAI/MIT Press, Cambridge, MA.
- Bassel , George W.; Glaab, Enrico; Marquez, Julietta; Holdsworth, Michael J.; Bacardit, Jaume (1. September 2011). „Konstruktion funktionaler Netzwerke in Arabidopsis mittels regelbasierter maschineller Lernverfahren auf Basis großer Datensätze“ . The Plant Cell . 23 (9): 3101–3116 . Bibcode : 2011PlanC..23.3101B . doi : 10.1105 / tpc.111.088153 . ISSN 1532-298X . PMC 3203449. PMID 21896882 .
- ^ Agrawal, R.; Imieliński, T.; Swami, A. (1993). „Mining association rules between sets of items in large databases“. Proceedings of the 1993 ACM SIGMOD international conference on Management of data - SIGMOD '93 . p. 207. CiteSeerX 10.1.1.40.6984 . doi : 10.1145/170035.170072 . ISBN 978-0-89791-592-2. S2CID 490415 .
- ^ Urbanowicz, Ryan J.; Moore, Jason H. (22. September 2009). „Lernende Klassifikatorsysteme: Eine vollständige Einführung, Übersicht und Roadmap“ . Journal of Artificial Evolution and Applications . 2009 : 1–25 . doi : 10.1155/2009/736398 . ISSN 1687-6229 .
- ^ Plotkin GD Automatische Methoden des induktiven Schließens Archiviert am 22. Dezember 2017 bei der Wayback Machine , Dissertation, Universität Edinburgh, 1970.
- ^ Shapiro, Ehud Y. Induktives Schließen von Theorien aus Fakten. Archiviert am 21. August 2021 in der Wayback Machine . Forschungsbericht 192, Yale University, Department of Computer Science, 1981. Nachgedruckt in: J.-L. Lassez, G. Plotkin (Hrsg.), Computational Logic, The MIT Press, Cambridge, MA, 1991, S. 199–254.
- ^ Shapiro, Ehud Y. (1983). Algorithmisches Programm-Debugging . Cambridge, Mass.: MIT Press. ISBN 0-262-19218-7
- ^ Shapiro, Ehud Y. „ Das Modellinferenzsystem. Archiviert am 06.04.2023 in der Wayback Machine .“ Proceedings der 7. internationalen gemeinsamen Konferenz über Künstliche Intelligenz – Band 2. Morgan Kaufmann Publishers Inc., 1981.
- ^ Burkov, Andriy (2019). Das hundertseitige Buch über maschinelles Lernen . Polen: Andriy Burkov. ISBN 978-1-9995795-0-0Die
- Russell , Stuart J.; Norvig, Peter (2021). Künstliche Intelligenz: Ein moderner Ansatz . Pearson-Reihe zur künstlichen Intelligenz (4. Aufl.). Hoboken: Pearson. ISBN 978-0-13-461099-3Die
- ^ Honglak Lee, Roger Grosse, Rajesh Ranganath, Andrew Y. Ng. " Convolutional Deep Belief Networks for Scalable Unsupervised Learning of Hierarchical Representations Archived 2017-10-18 at the Wayback Machine " Proceedings of the 26th Annual International Conference on Machine Learning, 2009.
- ^ "RandomForestRegressor" . scikit-learn . Abgerufen am 12. Februar 2025 .
- ^ „Was ist Random Forest? | IBM“ . www.ibm.com . 20. Oktober 2021. Abgerufen am 12. Februar 2025 .
- ^ Cortes, Corinna ; Vapnik, Vladimir N. (1995). „Support-Vektor-Netzwerke“ . Machine Learning . 20 (3): 273–297 . doi : 10.1007/BF00994018 .
- ^ Stevenson, Christopher. „Tutorial: Polynomregression in Excel“ . facultystaff.richmond.edu . Archiviert vom Original am 2. Juni 2013. Abgerufen am 22. Januar 2017 .
- ^ Wanta, Damian; Smolik, Aleksander; Smolik, Waldemar T.; Midura, Mateusz; Wróblewski, Przemysław (2025). „Bildrekonstruktion mittels maschinell erlernter Pseudoinversität in der elektrischen Kapazitätstomographie“ . Technische Anwendungen künstlicher Intelligenz . 142 109888. doi : 10.1016/j.engappai.2024.109888 .
- ^ Die Dokumentation für scikit-learn enthält ebenfalls ähnliche Beispiele. Archiviert am 2. November 2022 in der Wayback Machine .
- ^ Goldberg, David E.; Holland, John H. (1988). „Genetische Algorithmen und maschinelles Lernen“ ( PDF) . Machine Learning . 3 (2): 95–99 . doi : 10.1007/bf00113892 . S2CID 35506513. Archiviert (PDF) vom Original am 16. Mai 2011. Abgerufen am 3. September 2019 .
- ^ Michie, D.; Spiegelhalter, DJ; Taylor, CC (1994). „Maschinelles Lernen, neuronale und statistische Klassifizierung“. Ellis Horwood Series in Artificial Intelligence . Bibcode : 1994mlns.book.....M .
- ^ Zhang, Jun; Zhan, Zhi-hui; Lin, Ying; Chen, Ni; Gong, Yue-jiao; Zhong, Jing-hui; Chung, Henry SH; Li, Yun; Shi, Yu-hui (2011). „Evolutionäre Berechnung trifft auf maschinelles Lernen: Eine Umfrage“. IEEE Computational Intelligence Magazine . 6 (4): 68– 75. Bibcode : 2011ICIM....6d..68Z . doi : 10.1109/mci.2011.942584 . S2CID 6760276 .
- ^ Verbert, K.; Babuška, R.; De Schutter, B. (April 2017). „Bayesian and Dempster–Shafer reasoning for knowledge-based fault diagnosis–A comparative study“ . Engineering Applications of Artificial Intelligence . 60 : 136–150 . doi : 10.1016/j.engappai.2017.01.011 .
- ^ Yoosefzadeh-Najafabadi, Mohsen; Hugh, Earl; Tulpan, Dan; Sulik, John; Eskandari, Milad (2021). „Anwendung von Algorithmen des maschinellen Lernens in der Pflanzenzüchtung: Ertragsvorhersage anhand hyperspektraler Reflexionsdaten bei Sojabohnen?“ Front . Plant Sci . 11 624273. Bibcode : 2021FrPS...1124273Y . doi : 10.3389/fpls.2020.624273 . PMC 7835636. PMID 33510761 .
- ^ Urbanowicz, Ryan J.; Moore, Jason H. (22. September 2009). „Lernende Klassifikatorsysteme: Eine vollständige Einführung, Übersicht und Roadmap“ . Journal of Artificial Evolution and Applications . 2009 : 1–25 . doi : 10.1155/2009/736398 . ISSN 1687-6229 .
- ^ Zhang, C. und Zhang, S., 2002. Assoziationsregel-Mining: Modelle und Algorithmen . Springer-Verlag.
- ^ De Castro, Leandro Nunes und Jonathan Timmis. Künstliche Immunsysteme: Ein neuer Ansatz der künstlichen Intelligenz . Springer Science & Business Media, 2002.
- ^ „Federated Learning: Collaborative Machine Learning without Centralized Training Data“ . Google AI Blog . 6. April 2017. Archiviert vom Original am 7. Juni 2019. Abgerufen am 8. Juni 2019 .
- ^ Maschinelles Lernen ist Bestandteil des CFA-Lehrplans ; siehe: [1] {{Webarchive|url= https://www.cfainstitute.org/
- ^ Marcos M. López de Prado (2010). Maschinelles Lernen für Vermögensverwalter . Cambridge University Press . ISBN 9781108883658
- ^ Ivanenko, Michail; Smolik, Waldemar T.; Wanta, Damian; Midura, Mateusz; Wróblewski, Przemysław; Hou, Xiaohan; Yan, Xiaoheng (2023). „Bildrekonstruktion mittels überwachtem Lernen in der tragbaren elektrischen Impedanztomographie des Thorax“ . Sensoren . 23 (18): 7774. Bibcode : 2023Senso..23.7774I . doi : 10.3390/s23187774 . PMC 10538128 . PMID 37765831 .
- ^ „BelKor Homepage“ research.att.com
- ^ „Der Netflix Tech Blog: Netflix-Empfehlungen: Mehr als 5 Sterne (Teil 1)“ . 6. April 2012. Archiviert vom Original am 31. Mai 2016. Abgerufen am 8. August 2015 .
- ^ Scott Patterson (13. Juli 2010). „Die Maschinen entscheiden lassen“ . The Wall Street Journal . Archiviert vom Original am 24. Juni 2018. Abgerufen am 24. Juni 2018 .
- ^ Vinod Khosla (10. Januar 2012). „Brauchen wir Ärzte oder Algorithmen?“ . Tech Crunch. Archiviert vom Original am 18. Juni 2018. Abgerufen am 20. Oktober 2016 .
- ^ Als ein Algorithmus für maschinelles Lernen Gemälde der bildenden Kunst untersuchte, entdeckte er Dinge, die Kunsthistorikern nie aufgefallen waren. (Archiviert am 4. Juni 2016 in der Wayback Machine , Blog „The Physics at ArXiv“ ).
- ^ Vincent, James (10. April 2019). „Das erste KI-generierte Lehrbuch zeigt, was Roboterautoren wirklich können . “ The Verge . Archiviert vom Original am 5. Mai 2019. Abgerufen am 5. Mai 2019 .
- ^ Vaishya, Raju; Javaid, Mohd; Khan, Ibrahim Haleem; Haleem, Abid (1. Juli 2020). „Anwendungen künstlicher Intelligenz (KI) für die COVID-19-Pandemie“ . Diabetes und metabolisches Syndrom: Klinische Forschung und Rezensionen . 14 (4): 337–339 . doi : 10.1016/j.dsx.2020.04.012 . PMC 7195043 . PMID 32305024 .
- ^ Rezapouraghdam, Hamed; Akhshik, Arash; Ramkissoon, Haywantee (10. März 2021). „Anwendung von maschinellem Lernen zur Vorhersage des umweltbewussten Verhaltens von Besuchern in Meeresschutzgebieten: Erkenntnisse aus Zypern“ . Journal of Sustainable Tourism . 31 (11): 2479–2505 . doi : 10.1080/09669582.2021.1887878 . hdl : 10037/24073 .
- ^ Dey, Somdip; Singh, Amit Kumar; Wang, Xiaohang; McDonald-Maier, Klaus (15. Juni 2020). „User Interaction Aware Reinforcement Learning for Power and Thermal Efficiency of CPU-GPU Mobile MPSoCs“ . 2020 Design, Automation & Test in Europe Conference & Exhibition (DATE) (PDF) . S. 1728–1733 . doi : 10.23919/DATE48585.2020.9116294 . ISBN 978-3-9819263-4-7S2CID 219858480. Archiviert vom Original am 13. Dezember 2021. Abgerufen am 20. Januar 2022 .
- ^ Quested, Tony. „Smartphones werden dank Innovationen aus Essex intelligenter“ . Business Weekly . Archiviert vom Original am 24. Juni 2021. Abgerufen am 17. Juni 2021 .
- ^ Williams, Rhiannon (21. Juli 2020). „Zukünftige Smartphones werden ihre Akkulaufzeit verlängern, indem sie das Verhalten ihrer Besitzer überwachen.“" . i . Archiviert vom Original am 24. Juni 2021 . Abgerufen am 17. Juni 2021 .
- ^ Rasekhschaffe, Keywan Christian; Jones, Robert C. (Juli 2019). „Maschinelles Lernen zur Aktienauswahl“. Financial Analysts Journal . 75 (3): 70–88 . doi : 10.1080/0015198X.2019.1596678 .
- ^ Chung, Yunsie; Green, William H. (2024). „Maschinelles Lernen aus der Quantenchemie zur Vorhersage experimenteller Lösungsmitteleffekte auf Reaktionsgeschwindigkeiten“ . Chemical Science . 15 (7): 2410–2424 . doi : 10.1039/D3SC05353A . ISSN 2041-6520 . PMC 10866337. PMID 38362410 .
- ^ Sun, Yuran; Huang, Shih-Kai; Zhao, Xilei (1. Februar 2024). „Vorhersage von Evakuierungsentscheidungen bei Hurrikanen mithilfe interpretierbarer Methoden des maschinellen Lernens“ . International Journal of Disaster Risk Science . 15 (1): 134–148 . arXiv : 2303.06557 . Bibcode : 2024IJDRS..15..134S . doi : 10.1007/s13753-024-00541-1 . ISSN 2192-6395 .
- ^ Sun, Yuran; Zhao, Xilei; Lovreglio, Ruggiero; Kuligowski, Erica (2024). „KI für die großflächige Evakuierungsmodellierung: Chancen und Herausforderungen“. Interpretierbares maschinelles Lernen für die Analyse, den Entwurf, die Bewertung und die fundierte Entscheidungsfindung für zivile Infrastruktur . S. 185–204 . doi : 10.1016/B978-0-12-824073-1.00014-9 . ISBN 978-0-12-824073-1Die
- Xu , Ningzhe; Lovreglio, Ruggiero; Kuligowski, Erica D.; Cova, Thomas J.; Nilsson, Daniel; Zhao, Xilei (1. März 2023). „Vorhersage und Bewertung von Evakuierungsentscheidungen bei Waldbränden mithilfe von maschinellem Lernen: Ergebnisse des Kincade-Feuers 2019“. Fire Technology . 59 (2): 793–825 . doi : 10.1007/s10694-023-01363-1 . ISSN 1572-8099 .
- ^ Wang, Ke; Shi, Xiupeng; Goh, Algena Pei Xuan; Qian, Shunzhi (Juni 2019). „Eine maschinelle Lernstudie zur Bewegungsdynamik von Fußgängern bei Notfallevakuierungen“. Fire Safety Journal . 106 : 163–176 . Bibcode : 2019FirSJ.106..163W . doi : 10.1016/j.firesaf.2019.04.008 . hdl : 10356/143390 .
- ^ Zhao, Xilei; Lovreglio, Ruggiero; Nilsson, Daniel (Mai 2020). „Modellierung und Interpretation von Entscheidungen vor einer Evakuierung mithilfe von maschinellem Lernen“. Automation in Construction . 113 103140. doi : 10.1016/j.autcon.2020.103140 . hdl : 10179/17315 .
- ^ „Warum Modelle des maschinellen Lernens oft scheitern: QuickTake Q&A“ . Bloomberg.com . 10. November 2016. Archiviert vom Original am 20. März 2017. Abgerufen am 10. April 2017 .
- ^ „Die erste Welle der KI in Unternehmen ist zum Scheitern verurteilt“ . Harvard Business Review . 18. April 2017. Archiviert vom Original am 21. August 2018. Abgerufen am 20. August 2018 .
- ^ „Warum die KI-Euphorie zum Scheitern verurteilt ist“ . VentureBeat . 18. September 2016. Archiviert vom Original am 19. August 2018. Abgerufen am 20. August 2018 .
- ^ „9 Gründe, warum Ihr Machine-Learning-Projekt scheitern wird“ . www.kdnuggets.com . Archiviert vom Original am 21. August 2018. Abgerufen am 20. August 2018 .
- ^ a b Babuta, Alexander; Oswald, Marion; Rinik, Christine (2018). Transparenz und Verständlichkeit (Bericht). Royal United Services Institute (RUSI). S. 17–22 . Archiviert vom Original am 9. Dezember 2023. Abgerufen am 9. Dezember 2023 .
- ^ „Warum ein selbstfahrendes Auto von Uber einen Fußgänger tötete“ . The Economist . Archiviert vom Original am 21. August 2018. Abgerufen am 20. August 2018 .
- ^ „IBM-Experte Watson empfahl ‚unsichere und falsche‘ Krebsbehandlungen – STAT“ . STAT . 25. Juli 2018. Archiviert vom Original am 21. August 2018. Abgerufen am 21. August 2018 .
- ^ Hernandez, Daniela; Greenwald, Ted (11. August 2018). „IBM Has a Watson Dilemma“ . The Wall Street Journal . ISSN 0099-9660 . Archiviert vom Original am 21. August 2018. Abgerufen am 21. August 2018 .
- ^ Allyn, Bobby (27. Februar 2023). „Wie Microsofts Experiment mit künstlicher Intelligenz nach hinten losging“ . National Public Radio . Archiviert vom Original am 8. Dezember 2023. Abgerufen am 8. Dezember 2023 .
- Reddy , Shivani M.; Patel, Sheila; Weyrich, Meghan; Fenton, Joshua; Viswanathan, Meera (2020). „ Vergleich eines traditionellen systematischen Review-Ansatzes mit Review-of-Reviews und Halbautomatisierung als Strategien zur Aktualisierung der Evidenz“ . Systematic Reviews . 9 (1): 243. doi : 10.1186/s13643-020-01450-2 . ISSN 2046-4053 . PMC 7574591. PMID 33076975 .
- ^ Rudin, Cynthia (2019). „Hören Sie auf, Black-Box-Modelle des maschinellen Lernens für wichtige Entscheidungen zu erklären und verwenden Sie stattdessen interpretierbare Modelle“ . Nature Machine Intelligence . 1 (5): 206–215 . doi : 10.1038/s42256-019-0048-x . PMC 9122117. PMID 35603010 .
- Hu , Tongxi; Zhang, Xuesong; Bohrer, Gil; Liu, Yanlan; Zhou, Yuyu; Martin, Jay; Li, Yang; Zhao, Kaiguang (2023). „Ertragsprognose mittels erklärbarer KI und interpretierbarem maschinellem Lernen: Gefahren von Black-Box-Modellen zur Bewertung der Auswirkungen des Klimawandels auf den Ernteertrag“ . Agricultural and Forest Meteorology . 336 109458. Bibcode : 2023AgFM..33609458H . doi : 10.1016/j.agrformet.2023.109458 . S2CID 258552400 .
- ^ Domingos 2015 , Kapitel 6, Kapitel 7.
- ^ "„Generative Inzucht und ihre Gefahr für die menschliche Kultur“ . 26. August 2023.
- ^ „KI könnte an ihren eigenen Abgasen ersticken, während sie das Web füllt .“ 28. August 2023.
- ^ „KI-Kannibalismus und das Recht – Colorado Technology Law Journal“ .
- ^ „Der kuriose Fall des KI-Kannibalismus und mögliche Lösungen“ . 26. Juli 2023.,
- ^ „Inzucht, Kauderwelsch oder einfach nur Wahnsinn? Warnungen vor KI-Modellen mehren sich“ . France 24. 5. August 2024. Abgerufen am 31. Dezember 2024 .
- ^ "Modell der Autophagiestörung – die Livescu-Initiative zu Neuro, Narrative und KI" .
- ^ „Generative KI wird verrückt, wenn sie über fünfmal mit KI-generierten Daten trainiert wird“ . 12. Juli 2023.
- ^ Alemohammad, Sina; Casco-Rodriguez, Josue; Luzi, Lorenzo; Ahmed Imtiaz Humayun; Babaei, Hossein; LeJeune, Daniel; Siahkoohi, Ali; Baraniuk, Richard G. (2023). „Self-Consuming Generative Models Go MAD“. arXiv : 2307.01850 [ cs.LG ].
- ^ Hicks, Michael Townsen; Humphries, James; Slater, Joe (Juni 2024). „ChatGPT ist Bullshit“ (PDF) . Ethics and Information Technology . 26 (2) 38. doi : 10.1007/s10676-024-09775-5 . Archiviert (PDF) vom Original am 13. Mai 2025. Abgerufen am 23. Mai 2025 .
- ^ Liang, Kaiqu; Hu, Haimin; Zhao, Xuandong; Song, Dawn; Griffiths, Thomas L.; Fernández Fisac, Jaime (2025). „Maschineller Unsinn: Charakterisierung der entstehenden Missachtung der Wahrheit in großen Sprachmodellen“. arXiv : 2507.07484 [ cs.CL ].
- ^ Edwards, Benj (6. April 2023). „Warum ChatGPT und Bing Chat so gut darin sind, sich Dinge auszudenken“ . Ars Technica . Archiviert vom Original am 11. Juni 2023. Abgerufen am 11. Juni 2023 .
- ^ Ortega, Pedro A.; Kunesch, Markus; Delétang, Grégoire; Genewein, Tim; Grau-Moya, Jordi; Veness, Joel; Buchli, Jonas; Degrave, Jonas; Piot, Bilal; Perolat, Julien; Everitt, Tom; Tallec, Corentin; Parisotto, Emilio; Erez, Tom; Chen, Yutian; Reed, Scott; Hutter, Marcus; Nando de Freitas; Legg, Shane (2021). Die Grundlagen erschüttern: Wahnvorstellungen in Sequenzmodellen für Interaktion und Kontrolle (Preprint). arXiv : 2110.10819 .
- ^ Maynez, Joshua; Narayan, Shashi; Bohnet, Bernd; McDonald, Ryan (2020). „On Faithfulness and Factuality in Abstractive Summarization“. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics . S. 1906–1919 . doi : 10.18653/v1/2020.acl-main.173 .
- ^ Metz, Cade (6. November 2023). „Chatbots halluzinieren möglicherweise häufiger, als viele annehmen“ . The New York Times . Archiviert vom Original am 7. Dezember 2023. Abgerufen am 6. November 2023 .
- ^ de Wynter, Adrian; Wang, Xun; Sokolov, Alex; Gu, Qilong; Chen, Si-Qing (September 2023). „Eine Evaluierung großer Sprachmodellausgaben: Diskurs und Memorisierung“ . Natural Language Processing Journal . 4 100024. arXiv : 2304.08637 . doi : 10.1016/j.nlp.2023.100024 .
- ^ Leswing, Kif (14. Februar 2023). „Microsofts Bing-KI machte in der Launch-Demo der letzten Woche mehrere sachliche Fehler“ . CNBC . Archiviert vom Original am 16. Februar 2023. Abgerufen am 16. Februar 2023 .
- ^ Kang, Eunsuk; Shaw, Mary (2024). „tl;dr: Chill, y'all: AI Will Not Devour SE“. Proceedings of the 2024 ACM SIGPLAN International Symposium on New Ideas, New Paradigms, and Reflections on Programming and Software . S. 303–315 . arXiv : 2409.00764 . doi : 10.1145/3689492.3689816 . ISBN 979-8-4007-1215-9Die
- ^ Desai, Rajiv (13. Oktober 2023). „Ist künstliche Intelligenz (KI) eine existenzielle Bedrohung? – Dr. Rajiv Desai“ . Archiviert vom Original am 11. Januar 2026. Abgerufen am 25. November 2025 .
- ^ Garcez, Artur (30. Mai 2025). Vass, Steven (Hrsg.). „Neurosymbolische KI ist die Antwort auf die Unfähigkeit großer Sprachmodelle, Halluzinationen zu unterdrücken“. The Conversation . doi : 10.64628/AB.5gpku36ct .
- ^ Domingos 2015 , S. 286.
- ^ „Einzige Pixeländerung täuscht KI-Programme“ . BBC News . 3. November 2017. Archiviert vom Original am 22. März 2018. Abgerufen am 12. März 2018 .
- ^ „KI hat ein Halluzinationsproblem, das sich als schwer zu beheben erweist“ . WIRED . 2018. Archiviert vom Original am 12. März 2018. Abgerufen am 12. März 2018 .
- ^ Madry, A.; Makelov, A.; Schmidt, L.; Tsipras, D.; Vladu, A. (4. September 2019). „Towards deep learning models resistant to adversarial attacks“. arXiv : 1706.06083 [ stat.ML ].
- ^ „Adversarial Machine Learning – CLTC UC Berkeley Center for Long-Term Cybersecurity“ . CLTC . Archiviert vom Original am 17. Mai 2022. Abgerufen am 25. Mai 2022 .
- ^ „Maschinelles Lernen: Modelle anfällig für unentdeckbare Hintertüren“ . The Register . Archiviert vom Original am 13. Mai 2022. Abgerufen am 13. Mai 2022 .
- ^ „Unentdeckbare Hintertüren, die in jeden Algorithmus des maschinellen Lernens eingebaut werden können“ . IEEE Spectrum . 10. Mai 2022. Archiviert vom Original am 11. Mai 2022. Abgerufen am 13. Mai 2022 .
- ^ Goldwasser, Shafi; Kim, Michael P.; Vaikuntanathan, Vinod; Zamir, Or (14. April 2022). „Einbau unentdeckbarer Hintertüren in Modelle des maschinellen Lernens“. arXiv : 2204.06974 [ cs.LG ].
- ^ Kohavi, Ron (1995). „Eine Studie zur Kreuzvalidierung und zum Bootstrap-Verfahren für die Genauigkeitsschätzung und Modellauswahl“ (PDF) . Internationale Gemeinsame Konferenz für Künstliche Intelligenz . Archiviert (PDF) vom Original am 12. Juli 2018. Abgerufen am 26. März 2023 .
- ^ Catal, Cagatay (2012). „Performance Evaluation Metrics for Software Fault Prediction Studies“ (PDF) . Acta Polytechnica Hungarica . 9 (4) . Abgerufen am 2. Oktober 2016 .
- ^ a b Müller, Vincent C. (30. April 2020). „Ethik der künstlichen Intelligenz und Robotik“ . Stanford Encyclopedia of Philosophy . Archiviert vom Original am 10. Oktober 2020.
- ^ „Bewertung potenzieller zukünftiger Risiken, Vorteile und politischer Erfordernisse der künstlichen Intelligenz“ . OECD . 14. November 2024. Abgerufen am 4. August 2025 .
- ^ a b Garcia, Megan (2016). „Racist in the Machine“. World Policy Journal . 33 (4): 111–117 . doi : 10.1215/07402775-3813015 . ISSN 0740-2775 . S2CID 151595343 .
- ^ Bostrom, Nick (2011). „Die Ethik der künstlichen Intelligenz“ (PDF) . Archiviert vom Original (PDF) am 4. März 2016. Abgerufen am 11. April 2016 .
- ^ Edionwe, Tolulope. „Der Kampf gegen rassistische Algorithmen“ . The Outline . Archiviert vom Original am 17. November 2017. Abgerufen am 17. November 2017 .
- ^ Jeffries, Adrianne. „Maschinelles Lernen ist rassistisch, weil das Internet rassistisch ist . “ The Outline . Archiviert vom Original am 17. November 2017. Abgerufen am 17. November 2017 .
- ^ a b Silva, Selena; Kenney, Martin (2018). „Algorithmen, Plattformen und ethnische Voreingenommenheit: Ein integrativer Essay“. Phylon . 55 (1 & 2): 9– 37. JSTOR 26545017 .
- ^ Wong, Carissa (30. März 2023). „KI-Fairnessforschung durch mangelnde Diversität gebremst“. Nature . doi : 10.1038/d41586-023-00935-z . PMID 36997714 .
- ^ a b Zhang, Jack Clark. „Artificial Intelligence Index Report 2021“ (PDF) . Stanford Institute for Human-Centered Artificial Intelligence . Archiviert vom Original (PDF) am 19. Mai 2024. Abgerufen am 9. Dezember 2023 .
- ^ Caliskan, Aylin; Bryson, Joanna J.; Narayanan, Arvind (14. April 2017). „Automatisch aus Sprachkorpora abgeleitete Semantiken enthalten menschenähnliche Verzerrungen“. Science . 356 ( 6334): 183–186 . arXiv : 1608.07187 . Bibcode : 2017Sci...356..183C . doi : 10.1126/science.aal4230 . ISSN 0036-8075 . PMID 28408601. S2CID 23163324 .
- ^ Wang, Xinan; Dasgupta, Sanjoy (2016), Lee, DD; Sugiyama, M.; Luxburg, UV; Guyon, I. (Hrsg.), „An algorithm for L1 nearest neighbor search via monotonic embedding“ (PDF) , Advances in Neural Information Processing Systems 29 , Curran Associates, Inc., S. 983–991 , archiviert (PDF) vom Original am 7. April 2017 , abgerufen am 20. August 2018
- ^ MOR Prates; PHC Avelar; LC Lamb (11. März 2019). „Assessing Gender Bias in Machine Translation – A Case Study with Google Translate“. arXiv : 1809.02208 [ cs.CY ].
- ^ Narayanan, Arvind (24. August 2016). „Sprache enthält notwendigerweise menschliche Vorurteile, und das gilt auch für Maschinen, die mit Sprachkorpora trainiert wurden . “ Freedom to Tinker . Archiviert vom Original am 25. Juni 2018. Abgerufen am 19. November 2016 .
- ^ Metz, Rachel (24. März 2016). „Warum Microsoft versehentlich einen neonazistischen Sexroboter freigesetzt hat“ . MIT Technology Review . Archiviert vom Original am 9. November 2018. Abgerufen am 20. August 2018 .
- ^ Vincent, James (12. Januar 2018). „Google ‚korrigierte‘ seinen rassistischen Algorithmus, indem Gorillas aus seiner Bildkennzeichnungstechnologie entfernt wurden“ . The Verge . Archiviert vom Original am 21. August 2018. Abgerufen am 20. August 2018 .
- ^ Crawford, Kate (25. Juni 2016). „Meinung | Das Problem der weißen Männer in der künstlichen Intelligenz“ . New York Times . Archiviert vom Original am 14. Januar 2021. Abgerufen am 20. August 2018 .
- ^ Simonite, Tom (30. März 2017). „Microsoft: KI ist noch nicht anpassungsfähig genug, um Unternehmen zu helfen“ . MIT Technology Review . Archiviert vom Original am 9. November 2018. Abgerufen am 20. August 2018 .
- ^ Hempel, Jessi (13. November 2018). „Fei-Fei Lis Bestreben, Maschinen für die Menschheit zu verbessern“ . Wired . ISSN 1059-1028 . Archiviert vom Original am 14. Dezember 2020. Abgerufen am 17. Februar 2019 .
- ^ Char, DS; Shah, NH; Magnus, D. (2018). „Implementierung von maschinellem Lernen im Gesundheitswesen – Ethische Herausforderungen“ . New England Journal of Medicine . 378 (11): 981–983 . doi : 10.1056/nejmp1714229 . PMC 5962261. PMID 29539284 .
- ^ AI Research (23. Oktober 2015). „Deep Neural Networks for Acoustic Modeling in Speech Recognition“ . airesearch.com . Archiviert vom Original am 1. Februar 2016. Abgerufen am 23. Oktober 2015 .
- ^ „GPUs dominieren den Markt für KI-Beschleuniger weiterhin“ . InformationWeek . Dezember 2019. Archiviert vom Original am 10. Juni 2020. Abgerufen am 11. Juni 2020 .
- ^ Ray, Tiernan (2019). „KI verändert die gesamte Natur des Rechnens“ . ZDNet . Archiviert vom Original am 25. Mai 2020. Abgerufen am 11. Juni 2020 .
- ^ „KI und Rechnen“ . OpenAI . 16. Mai 2018. Archiviert vom Original am 17. Juni 2020. Abgerufen am 11. Juni 2020 .
- ^ Jouppi, Norman P.; Young, Cliff; Patil, Nishant; Patterson, David; Agrawal, Gaurav; Bajwa, Raminder; Bates, Sarah; Bhatia, Suresh; Boden, Nan; Borchers, Al; Boyle, Rick; Cantin, Pierre-luc; Chao, Clifford; Clark, Chris; Coriell, Jeremy (24. Juni 2017). „In-Datacenter Performance Analysis of a Tensor Processing Unit“. Proceedings of the 44th Annual International Symposium on Computer Architecture . ISCA '17. New York, NY, USA: Association for Computing Machinery. S. 1–12 . arXiv : 1704.04760 . doi : 10.1145/3079856.3080246 . ISBN 978-1-4503-4892-8Die
- ^ Best, Jo (8. Dezember 2020). „Was ist neuromorphes Computing? Alles, was Sie darüber wissen müssen, wie es die Zukunft des Computings verändert“ . ZDNET . Abgerufen am 21. November 2024 .
- ^ Hecate He (27. Mai 2021). Michael Sarazen; Chain Zhang (Hrsg.). „Cornell & NTT’s Physical Neural Networks: A "Radical Alternative for Implementing Deep Neural Networks" That Enables Arbitrary Physical Systems Training" . Synchronisiert . Archiviert vom Original am 27. Oktober 2021. Abgerufen am 12. Oktober 2021 .
- ^ Clark, Lindsay (5. Oktober 2021). „Nano-Spaghetti zur Lösung des Problems des Stromverbrauchs neuronaler Netze“ . The Register . Archiviert vom Original am 6. Oktober 2021. Abgerufen am 12. Oktober 2021 .
- ^ Fafoutis, Xenofon; Marchegiani, Letizia; Elsts, Atis; Pope, James; Piechocki, Robert; Craddock, Ian (7. Mai 2018). „Verlängerung der Batterielebensdauer tragbarer Sensoren durch eingebettetes maschinelles Lernen“ . 2018 IEEE 4th World Forum on Internet of Things (WF-IoT) . S. 269–274 . doi : 10.1109/WF-IoT.2018.8355116 . hdl : 1983/b8fdb58b-7114-45c6-82e4-4ab239c1327f . ISBN 978-1-4673-9944-9S2CID 19192912. Archiviert vom Original am 18. Januar 2022. Abgerufen am 17. Januar 2022 .
- ^ „Einführung in maschinelles Lernen für eingebettete Systeme“ . Analytics India Magazine . 2. Juni 2021. Archiviert vom Original am 18. Januar 2022. Abgerufen am 17. Januar 2022 .
- ^ Synced (12. Januar 2022). „Google, Purdue & Harvard U's Open-Source-Framework für TinyML erzielt bis zu 75-fache Geschwindigkeitssteigerungen auf FPGAs | Synced“ . syncedreview.com . Archiviert vom Original am 18. Januar 2022. Abgerufen am 17. Januar 2022 .
- ^ AlSelek, Mohammad; Alcaraz-Calero, Jose M.; Wang, Qi (2024). „Dynamische KI-IoT: Ermöglichung aktualisierbarer KI-Modelle in stromsparenden 5G-IoT-Geräten“ . IEEE Internet of Things Journal . 11 (8): 14192–14205 . Bibcode : 2024IITJ...1114192A . doi : 10.1109/JIOT.2023.3340858 .
- ^ Giri, Davide; Chiu, Kuan-Lin; Di Guglielmo, Giuseppe; Mantovani, Paolo; Carloni, Luca P. (15. Juni 2020). „ESP4ML: Plattformbasierter Entwurf von Systems-on-Chip für eingebettetes maschinelles Lernen“ . 2020 Design, Automation & Test in Europe Conference & Exhibition (DATE) . S. 1049–1054 . arXiv : 2004.03640 . doi : 10.23919 /DATE48585.2020.9116317 . ISBN 978-3-9819263-4-7S2CID 210928161. Archiviert vom Original am 18. Januar 2022. Abgerufen am 17. Januar 2022 .
- ^ Louis, Marcia Sahaya; Azad, Zahra; Delshadtehrani, Leila; Gupta, Suyog; Warden, Pete; Reddi, Vijay Janapa; Joshi, Ajay (2019). „Towards Deep Learning using TensorFlow Lite on RISC-V“ . Harvard University . Archiviert vom Original am 17. Januar 2022. Abgerufen am 17. Januar 2022 .
- ^ Ibrahim, Ali; Osta, Mario; Alameh, Mohamad; Saleh, Moustafa; Chible, Hussein; Valle, Maurizio (21. Januar 2019). „Approximative Rechenmethoden für eingebettetes maschinelles Lernen“. 25. IEEE Internationale Konferenz für Elektronik, Schaltungen und Systeme (ICECS) 2018. S. 845–848 . doi : 10.1109/ICECS.2018.8617877 . ISBN 978-1-5386-9562-3. S2CID 58670712 .
- ^ „dblp: TensorFlow Eager: Eine mehrstufige, in Python eingebettete DSL für maschinelles Lernen“ . dblp.org . Archiviert vom Original am 18. Januar 2022. Abgerufen am 17. Januar 2022 .
- ^ Branco, Sérgio; Ferreira, André G.; Cabral, Jorge (5. November 2019). „Maschinelles Lernen in ressourcenknappen eingebetteten Systemen, FPGAs und Endgeräten: Eine Umfrage“ . Elektronik . 8 (11): 1289. doi : 10.3390/electronics8111289 . HDL : 1822/62521 . ISSN 2079-9292 .
Quellen
- Domingos, Pedro (22. September 2015). Der Master-Algorithmus: Wie die Suche nach der ultimativen Lernmaschine unsere Welt verändern wird . Basic Books. ISBN 978-0-465-06570-7Die
- Nilsson, Nils (1998). Künstliche Intelligenz: Eine neue Synthese . Morgan Kaufmann. ISBN 978-1-55860-467-4Archiviert vom Original am 26. Juli 2020. Abgerufen am 18. November 2019 .
- Poole, David; Mackworth, Alan ; Goebel, Randy (1998). Computational Intelligence: A Logical Approach . New York: Oxford University Press. ISBN 978-0-19-510270-3Archiviert vom Original am 26. Juli 2020. Abgerufen am 22. August 2020 .
- Russell, Stuart J.; Norvig , Peter (2003), Künstliche Intelligenz: Ein moderner Ansatz (2. Aufl.), Upper Saddle River, New Jersey: Prentice Hall, ISBN 0-13-790395-2Die
Weiterführende Literatur
- Alpaydin, Ethem (2020). Einführung in maschinelles Lernen (4. Auflage). MIT Press, ISBN 9780262043793Die
- Bishop, Christopher (1995). Neuronale Netze zur Mustererkennung , Oxford University Press. ISBN 0-19-853864-2Die
- Bishop, Christopher (2006) Mustererkennung und maschinelles Lernen , Springer. ISBN 978-0-387-31073-2
- Domingos, Pedro (September 2015), The Master Algorithm , Basic Books, ISBN 978-0-465-06570-7
- Duda, Richard O .; Hart, Peter E .; Stork, David G. (2001) Musterklassifizierung (2. Auflage), Wiley, New York, ISBN 0-471-05669-3Die
- Hastie, Trevor ; Tibshirani, Robert & Friedman, Jerome H. (2009) The Elements of Statistical Learning , Springer. doi : 10.1007/978-0-387-84858-7 ISBN 0-387-95284-5Die
- MacKay, David JC: Informationstheorie, Inferenz und Lernalgorithmen. Cambridge: Cambridge University Press, 2003. ISBN 0-521-64298-1
- Murphy, Kevin P. (2022). Probabilistisches maschinelles Lernen: Eine Einführung . MIT Press. ISBN 978-0-262-04682-4Die
- Nilsson, Nils J. (2015) Einführung in maschinelles Lernen. Archiviert am 16. August 2019 in der Wayback Machine .
- Russell, Stuart & Norvig, Peter (2020). Künstliche Intelligenz – Ein moderner Ansatz . (4. Auflage) Pearson, ISBN 978-0134610993Die
- Solomonoff, Ray , (1956) Eine Maschine für induktives Schließen. Archiviert am 26. April 2011 bei der Wayback Machine. Ein privat verbreiteter Bericht von der Dartmouth Summer Research Conference on AI aus dem Jahr 1956 .
- Witten, Ian H.; Frank, Eibe; Hall, Mark A. (2011). Data Mining: Praktische Werkzeuge und Techniken des maschinellen Lernens . doi : 10.1016/C2009-0-19715-5 . ISBN 978-0-12-374856-0Die
Externe Links
- Internationale Gesellschaft für Maschinelles Lernen
- MLOSS-Seite bei JMLR – einer akademischen Datenbank für Open-Source-Software für maschinelles Lernen.