Unicode (auch bekannt als Unicode-Standard und TUS [ 1 ] [ 2 ] ) ist ein vom Unicode-Konsortium gepflegter Zeichensatz, der die Verwendung digitalisierbarer Texte in allen Schriftsystemen der Welt unterstützt. Version 17.0 [ A ] definiert 159.801 Zeichen und 172 Schriftsysteme [ 3 ], die in verschiedenen alltäglichen, literarischen, akademischen und technischen Kontexten verwendet werden.
Unicode hat die zuvor weit verbreitete Vielzahl inkompatibler Zeichensätze, die in verschiedenen Regionen und auf unterschiedlichen Computerarchitekturen verwendet wurden, weitgehend abgelöst. Der gesamte Zeichensatz dieser Zeichensätze sowie viele zusätzliche Zeichen wurden in den einzigen Unicode-Zeichensatz integriert. Unicode wird zur Kodierung des Großteils des Internettextes, einschließlich der meisten Webseiten , verwendet , und die entsprechende Unicode-Unterstützung ist zu einem Standardkriterium in der modernen Softwareentwicklung geworden. Unicode kann letztendlich mehr als 1,1 Millionen Zeichen kodieren.
Der Unicode -Zeichensatz ist mit ISO/IEC 10646 synchronisiert ; beide sind code-für-code identisch. Der Unicode-Standard ist jedoch mehr als nur ein Zeichensatz. Um Entwickler und Designer zu unterstützen, bietet der Standard auch Tabellen und Referenzdaten sowie Anhänge, die Konzepte verschiedener Schriftsysteme erläutern und Anleitungen für deren Implementierung geben. Zu den in diesen Anhängen behandelten Themen gehören Zeichennormalisierung , Zeichenzusammensetzung und -zerlegung, Sortierung und Richtung . [ 4 ]
Unicode kodiert 3.790 Emojis , deren Weiterentwicklung vom Konsortium im Rahmen des Standards vorangetrieben wird. [ 5 ] Die weite Verbreitung von Unicode trug maßgeblich zur anfänglichen Popularisierung von Emojis außerhalb Japans bei.
Unicode-Text wird als Binärdaten mithilfe einer von mehreren Kodierungen verarbeitet und gespeichert. Diese Kodierungen definieren , wie die abstrahierten Zeichencodes des Standards in Bytefolgen übersetzt werden. Der Unicode-Standard selbst definiert drei Kodierungen: UTF-8 , UTF -16 und UTF -32 . Es existieren jedoch noch einige weitere. UTF-8 ist mit Abstand die am weitesten verbreitete Kodierung, unter anderem aufgrund ihrer Abwärtskompatibilität mit ASCII .
Ursprung und Entwicklung
Unicode wurde ursprünglich mit dem Ziel entwickelt, die Beschränkungen aller bis dahin existierenden Textkodierungen zu überwinden: Jede Kodierung war für ihren jeweiligen Kontext ausgelegt, ohne dass Kompatibilität mit anderen Kodierungen erwartet wurde. Tatsächlich waren zwei kombinierte Kodierungen oft völlig unbrauchbar, da in der einen kodierter Text von der anderen als fehlerhafte Zeichen interpretiert wurde . Die meisten Kodierungen waren lediglich für die Interoperabilität zwischen wenigen Schriftsystemen konzipiert – oft primär zwischen einem bestimmten Schriftsystem und lateinischen Zeichen –, nicht aber für die Interoperabilität zwischen einer Vielzahl von Schriftsystemen und nicht unter einheitlicher Behandlung aller unterstützten Schriftsysteme.
Die Philosophie von Unicode zielt darauf ab, die zugrundeliegenden Zeichen – Grapheme und graphemähnliche Einheiten – zu kodieren, anstatt grafische Unterschiede lediglich als Varianten von Glyphen zu betrachten , die am besten durch die Schriftart , mithilfe von Auszeichnungssprachen oder auf andere Weise dargestellt werden. In besonders komplexen Fällen, wie der Behandlung orthografischer Varianten in Han-Zeichen , herrscht erhebliche Uneinigkeit darüber, welche Unterschiede eine eigene Kodierung rechtfertigen und welche lediglich grafische Varianten anderer Zeichen darstellen.
Auf der abstraktesten Ebene ordnet Unicode jedem Zeichen eine eindeutige Nummer, den sogenannten Codepunkt , zu. Viele Aspekte der visuellen Darstellung – darunter Größe, Form und Stil – sollen der jeweiligen Software, die den Text darstellt, wie beispielsweise einem Webbrowser oder einem Textverarbeitungsprogramm, überlassen bleiben . Um jedoch eine schnelle Verbreitung zu fördern, wurde das ursprüngliche, einfache Modell im Laufe der Zeit etwas komplexer gestaltet, und im Zuge der Standardentwicklung wurden verschiedene pragmatische Zugeständnisse gemacht.
Die ersten 256 Codepunkte entsprechen dem ISO/IEC-8859-1 -Standard, um die Konvertierung von Texten in westeuropäischen Schriftsystemen zu vereinfachen. Um die Unterschiede zwischen verschiedenen älteren Kodierungen zu erhalten und somit eine verlustfreie Konvertierung zwischen ihnen und Unicode zu ermöglichen, erhielten viele Zeichen, die sich in Aussehen und Funktion kaum ähneln , eigene Codepunkte. Beispielsweise umfasst der Block „Halbbreite und Vollbreite Formen“ eine vollständige semantische Kopie des lateinischen Alphabets, da ältere CJK-Kodierungen sowohl „Vollbreite“-Zeichen (entsprechend der Breite von CJK-Zeichen) als auch „Halbbreite“-Zeichen (entsprechend der Breite gewöhnlicher lateinischer Schriften) enthielten.
Geschichte
Die Ursprünge von Unicode lassen sich bis in die 1980er-Jahre zurückverfolgen, zu einer Gruppe von Personen mit Verbindungen zum Xerox Character Code Standard (XCCS). [ 6 ] 1987 begannen Xerox-Mitarbeiter Joe Becker und die Apple- Mitarbeiter Lee Collins und Mark Davis , die Machbarkeit eines universellen Zeichensatzes zu untersuchen. [ 7 ] Mit zusätzlicher Unterstützung von Peter Fenwick und Dave Opstad [ 6 ] veröffentlichte Becker im August 1988 einen Entwurf für ein „internationales/mehrsprachiges Textzeichenkodierungssystem, vorläufig Unicode genannt“. Er erklärte, dass „der Name ‚Unicode‘ eine einzigartige, einheitliche und universelle Kodierung suggerieren soll“. [ 6 ]
In diesem Dokument mit dem Titel Unicode 88 entwarf Becker ein Schema, das 16-Bit -Zeichen verwendet: [ 6 ]
Unicode soll den Bedarf an einer praktikablen und zuverlässigen weltweiten Textkodierung decken. Man könnte Unicode grob als „erweitertes ASCII “ beschreiben, das auf 16 Bit erweitert wurde, um die Zeichen aller lebenden Sprachen der Welt abzudecken. Bei einer gut durchdachten Konzeption sind 16 Bit pro Zeichen für diesen Zweck mehr als ausreichend.
Diese Designentscheidung beruhte auf der Annahme, dass nur Schriften und Zeichen im "modernen" Gebrauch eine Kodierung erfordern würden: [ 6 ]
Unicode legt mehr Wert auf zukünftige Nutzbarkeit als auf die Bewahrung historischer Zeichen. Unicode konzentriert sich in erster Linie auf die Zeichen, die in modernen Texten verwendet werden (z. B. in der Gesamtheit aller 1988 weltweit gedruckten Zeitungen und Zeitschriften), deren Anzahl zweifellos weit unter 2<sup> 14</sup> = 16.384 liegt. Alle anderen Zeichen, die über diese modernen Zeichen hinausgehen, gelten als veraltet oder selten; sie eignen sich besser für die private Nutzung als für die Aufnahme in die öffentliche Liste allgemein nützlicher Unicode-Zeichen.
Anfang 1989 erweiterte sich die Unicode-Arbeitsgruppe um Ken Whistler und Mike Kernaghan von Metaphor, Karen Smith-Yoshimura und Joan Aliprand von der Research Libraries Group sowie Glenn Wright von Sun Microsystems . Die Research Libraries Group verfügte bereits über eine Lösung für ostasiatische Zeichensätze, die als Grundlage für den Unicode-Zeichensatz diente. [ 7 ] 1990 traten Michel Suignard und Asmus Freytag von Microsoft sowie Rick McGowan von NeXT der Gruppe bei. Ende 1990 waren die meisten Arbeiten zur Neuzuordnung bestehender Standards abgeschlossen, und ein finaler Entwurf von Unicode lag vor.
Das Unicode-Konsortium wurde am 3. Januar 1991 in Kalifornien gegründet [ 8 ] , und der erste Band des Unicode-Standards erschien im Oktober desselben Jahres. Der zweite Band, der nun auch Han-Ideogramme enthielt, wurde im Juni 1992 veröffentlicht.
1996 wurde in Unicode 2.0 ein Mechanismus für Ersatzzeichen implementiert, wodurch Unicode nicht mehr auf 16 Bit beschränkt war. Dies erweiterte den Unicode-Zeichenraum auf über eine Million Codepunkte und ermöglichte die Kodierung vieler historischer Schriften, wie beispielsweise ägyptischer Hieroglyphen , sowie Tausender selten verwendeter oder veralteter Zeichen, deren Aufnahme in den Standard ursprünglich nicht vorgesehen war. Zu diesen Zeichen gehören verschiedene selten verwendete CJK-Zeichen – viele davon werden hauptsächlich in Eigennamen verwendet, wodurch sie für eine universelle Kodierung weitaus notwendiger sind, als es die ursprüngliche Unicode-Architektur vorsah. [ 9 ]
Unicode-Konsortium
Das Unicode-Konsortium ist eine gemeinnützige Organisation, die die Entwicklung von Unicode koordiniert. Zu den Vollmitgliedern gehören die meisten der führenden Software- und Hardwareunternehmen (und einige wenige andere), die ein Interesse an Textverarbeitungsstandards haben, darunter Adobe , Apple , Google , IBM , Meta (ehemals Facebook), Microsoft , Netflix und SAP . [ 10 ]
Im Laufe der Jahre waren mehrere Länder oder Regierungsbehörden Mitglieder des Unicode-Konsortiums. [ 10 ]
Das Konsortium verfolgt das ehrgeizige Ziel, die bestehenden Zeichenkodierungssysteme schließlich durch Unicode und dessen Standard-Unicode-Transformationsformat (UTF) zu ersetzen, da viele der bestehenden Systeme in Größe und Umfang begrenzt und mit mehrsprachigen Umgebungen inkompatibel sind.
Der Unicode Bulldog Award wird an Personen verliehen, die als einflussreich für die Entwicklung von Unicode gelten. Zu den Preisträgern gehören Tatsuo Kobayashi , Thomas Milo, Roozbeh Pournader, Ken Lunde und Michael Everson . [ 11 ]
Abgedeckte Drehbücher

Stand September 2025 umfasst Unicode insgesamt 172 [ 12 ] Schriftsysteme ( Alphabete , Abugidas und Silbenschriften ) und deckt damit die meisten heute gebräuchlichen Schriftsysteme ab. [ 13 ] [ 14 ] Es gibt jedoch weiterhin Schriftsysteme, die noch nicht kodiert sind, insbesondere solche, die hauptsächlich in historischen, liturgischen und akademischen Kontexten verwendet werden. Auch die bereits kodierten Schriftsysteme werden um weitere Zeichen sowie Symbole , insbesondere für Mathematik und Musik, erweitert.
Vorschläge zum Hinzufügen von Skripten
Das Unicode-Roadmap-Komitee ( Michael Everson , Rick McGowan, Ken Whistler, VS Umamaheswaran) [ 15 ] pflegt die Liste der Schriften, die Kandidaten oder potenzielle Kandidaten für eine Kodierung sind, sowie deren vorläufige Codeblockzuordnungen auf der Unicode-Roadmap- Seite [ 16 ] der Unicode-Konsortium- Website. Für einige Schriften der Roadmap, wie Jurchen und Khitan Large Script , wurden Kodierungsvorschläge eingereicht, die sich derzeit im Genehmigungsprozess befinden. Für andere Schriften, wie Numidisch und Rongorongo , liegt noch kein Vorschlag vor; hier wird auf die Einigung der beteiligten Nutzergemeinschaften über das Zeichenrepertoire und weitere Details gewartet.
Einige moderne erfundene Schriftsysteme, die noch nicht in Unicode aufgenommen wurden (z. B. Tengwar ) oder die aufgrund mangelnder praktischer Anwendung nicht für die Aufnahme in Unicode in Frage kommen (z. B. Klingonisch ), sind in der ConScript Unicode Registry zusammen mit inoffiziellen, aber weit verbreiteten privaten Bereichskennzeichen aufgeführt .
Es gibt außerdem eine Initiative für mittelalterliche Unicode-Schriftarten, die sich auf spezielle lateinische mittelalterliche Zeichen konzentriert. Ein Teil dieser Vorschläge wurde bereits in Unicode aufgenommen.
Die Script Encoding Initiative (SEI) [ 17 ] , ein Projekt von Deborah Anderson an der University of California, Berkeley , wurde 2002 mit dem Ziel gegründet, Vorschläge für Schriftsysteme zu fördern, die noch nicht im Standard kodiert sind. Unter der Leitung von Anushah Hossain hat sich die SEI in den letzten Jahren zu einer wichtigen Quelle für Vorschläge zur Standarderweiterung entwickelt. [ 18 ] Obwohl die SEI mit dem Unicode-Konsortium und dem ISO/IEC-10646-Standardisierungsprozess zusammenarbeitet, agiert sie unabhängig und unterstützt die technische, linguistische und historische Forschung, die für die Erstellung formaler Vorschläge erforderlich ist. Die SEI unterhält auf ihrer Website eine Datenbank mit Schriftsystemen, die noch nicht im Unicode-Standard kodiert sind. [ 19 ]
Versionen
Das Unicode-Konsortium und die ISO haben nach der Erstveröffentlichung des Unicode-Standards ein gemeinsames Repertoire entwickelt: Unicode und der universelle Zeichensatz (UCS) der ISO verwenden identische Zeichennamen und Codepunkte. Die Unicode-Versionen unterscheiden sich jedoch in zwei wesentlichen Punkten von ihren ISO-Äquivalenten.
Während das UCS eine einfache Zeichentabelle darstellt, spezifiziert Unicode die Regeln, Algorithmen und Eigenschaften, die für die Interoperabilität zwischen verschiedenen Plattformen und Sprachen notwendig sind. Der Unicode-Standard enthält daher mehr Informationen und behandelt detaillierte Themen wie Bitcodierung, Sortierung und Darstellung. Er bietet außerdem einen umfassenden Katalog von Zeicheneigenschaften, einschließlich derer, die für bidirektionalen Text benötigt werden , sowie visuelle Tabellen und Referenzdatensätze zur Unterstützung der Implementierung. Früher wurde der Unicode-Standard als gedrucktes Buch mit der vollständigen Kernspezifikation, Standardanhängen [ Anmerkung 1 ] und Codetabellen verkauft. Version 5.0, veröffentlicht im Jahr 2006, war jedoch die letzte gedruckte Version. Ab Version 5.2 ist nur noch die Kernspezifikation als Print-on-Demand-Taschenbuch erhältlich. [ 20 ] Der vollständige Text hingegen ist als kostenloses PDF auf der Unicode-Website verfügbar.
Ein praktischer Grund für diese Veröffentlichungsmethode verdeutlicht den zweiten wesentlichen Unterschied zwischen dem Unicode Consortium (UCS) und Unicode: die Häufigkeit, mit der aktualisierte Versionen veröffentlicht und neue Zeichen hinzugefügt werden. Der Unicode-Standard veröffentlicht regelmäßig jährlich erweiterte Versionen, gelegentlich auch mehrere Versionen pro Kalenderjahr, und in seltenen Fällen musste die geplante Veröffentlichung verschoben werden. So gab das Unicode Consortium beispielsweise im April 2020, einen Monat nach der Veröffentlichung von Version 13.0, bekannt, dass es den geplanten Veröffentlichungstermin für Version 14.0 aufgrund der COVID-19-Pandemie um sechs Monate auf September 2021 verschoben hatte .
Bisher wurden die folgenden Versionen des Unicode-Standards veröffentlicht. Aktualisierungsversionen, die keine Änderungen am Zeichensatz enthalten, werden durch die dritte Zahl gekennzeichnet (z. B. „Version 4.0.1“) und sind in der folgenden Tabelle nicht aufgeführt. [ 21 ]
| Version | Datum | Veröffentlichung (Buch, Text) | UCS- Edition | Gesamt | Details | |
|---|---|---|---|---|---|---|
| Skripte | Zeichen [ b ] | |||||
| 1.0.0 [ 22 ] | Oktober 1991 | ISBN 0-201-56788-1(Band 1) | N / A | 24 | 7129 | Folgende Schriftsysteme wurden ursprünglich unterstützt: Arabisch , Armenisch , Bengali , Bopomofo , Kyrillisch , Devanagari , Georgisch , Griechisch und Koptisch , Gujarati , Gurmukhi , Hangul , Hebräisch , Hiragana , Kannada , Katakana , Laotisch , Latein , Malayalam , Odia , Tamil , Telugu , Thailändisch und Tibetisch. |
| 1.0.1 [ 23 ] | Juni 1992 | ISBN 0-201-60845-6(Band 2) | 25 | 28 327+21 204-6 | Die ersten 20.902 CJK-Einheitsideogramme | |
| 1.1 [ 24 ] | Juni 1993 | N / A | ISO/IEC 10646 -1:1993 | 24 | 34 168+5963−9 | 33 Zeichen wurden als Kontrollzeichen neu klassifiziert. 4.306 Hangul- Silben, tibetische Silben entfernt. |
| 2.0 [ 25 ] | Juli 1996 | ISBN 0-201-48345-9 | 25 | 38 885+11 373−6656 | Der ursprüngliche Satz von Hangul-Silben wurde entfernt, ein neuer Satz von 11.172 Hangul-Silben wurde an einer neuen Stelle hinzugefügt, Tibetisch wurde an einer neuen Stelle und mit einem anderen Zeichenrepertoire wieder hinzugefügt, ein Mechanismus für Ersatzzeichen wurde definiert, die Bereiche Plane 15 und Plane 16 wurden für die private Nutzung freigegeben | |
| 2.1 [ 26 ] | Mai 1998 | N / A | 38 887+2 | U+20AC € EURO-ZEICHEN , U+FFFC  OBJEKTERSATZZEICHEN [ 26 ] | ||
| 3.0 [ 27 ] | September 1999 | ISBN 0-201-61633-5 | ISO/IEC 10646-1:2000 | 38 | 49 194+10 307 | Cherokee , Geʽez , Khmer , Mongolisch , Burmesisch , Ogham , Runen , Singhalesisch , Syrisch , Thaana , kanadische indigene Silbenschriften und Yi-Silben , Braille- Muster |
| 3.1 [ 28 ] | März 2001 | N / A | ISO/IEC 10646-1:2000 [ d ] ISO/IEC 10646-2:2001 | 41 | 94 140+44 946 | Deseret , Gotisch und Altitalisch , Symbolsysteme für westliche und byzantinische Musik , 42.711 zusätzliche CJK-Vereinheitlichte Ideogramme |
| 3.2 [ 29 ] | März 2002 | 45 | 95 156+1016 | Philippinische Schriften ( Buhid , Hanunoo , Tagalog und Tagbanwa ), mathematische Symbole | ||
| 4.0 [ 30 ] | April 2003 | ISBN 0-321-18578-1 | ISO/IEC 10646:2003 | 52 | 96 382+1226 | Zypriotische Silbenschrift , Limbu , Linear B , Osmanya , Shavianisch , Tai Le und Ugaritisch , Hexagrammsymbole |
| 4.1 [ 31 ] | März 2005 | N / A | 59 | 97 655+1273 | Buginesisch , Glagolitisch , Kharosthi , Neu-Tai Lue , Altpersisch , Sylheti Nagri und Tifinagh , Koptisch , vom Griechischen getrennt, altgriechische Zahlen und musikalische Symbole , erste benannte Zeichenfolgen wurden eingeführt. [ 32 ] | |
| 5.0 [ 33 ] | Juli 2006 | ISBN 0-321-48091-0 | 64 | 99 024+1369 | Balinesisch , Keilschrift , N'Ko , ʼPhags-pa , Phönizisch [ 34 ] | |
| 5.1 [ 35 ] | April 2008 | N / A | 75 | 100 648+1624 | Karisch , Cham , Kayah Li , Lepcha , Lykisch , Lydisch , Ol Chiki , Rejang , Saurashtra , Sundanesisch und Vai , Symbolsätze für den Diskus von Phaistos , Mahjong- Steine, Dominosteine , Ergänzungen zum Burmesischen, Schreiberabkürzungen , U+1E9E ẞ LATEINISCHER GROSSBUCHSTABE SHARP | |
| 5.2 [ 36 ] | Oktober 2009 | ISBN 978-1-936213-00-9 | 90 | 107 296+6648 | Avestisch , Bamum , Gardiners Zeichenliste ägyptischer Hieroglyphen , Kaiserliches Aramäisch , Inschriften-Pahlavi , Inschriften-Parthisch , Javanisch , Kaithi , Lisu , Meetei Mayek , Altsüdarabisch , Alttürkisch , Samaritanisch , Tai Tham und Tai Viet , zusätzliche CJK Unified Ideographs, Jamo für Alt-Hangul, Vedisches Sanskrit | |
| 6.0 [ 37 ] | Oktober 2010 | ISBN 978-1-936213-01-6 | ISO/IEC 10646:2010 | 93 | 109 384+2088 | Batak , Brahmi , Mandaic , Spielkartensymbole , Transport- und Kartensymbole, alchemistische Symbole , Emoticons und Emojis, [ 38 ] zusätzliche CJK Unified Ideographs |
| 6.1 [ 39 ] | Januar 2012 | ISBN 978-1-936213-02-3 | ISO/IEC 10646:2012 | 100 | 110 116+732 | Chakma , meroitische Schreibschrift , meroitische Hieroglyphen , Miao , Sharada , Sora Sompeng und Takri |
| 6.2 [ 40 ] | September 2012 | ISBN 978-1-936213-07-8 | 110 117+1 | U+20BA ₺ Türkische Lira Zeichen | ||
| 6.3 [ 41 ] | September 2013 | ISBN 978-1-936213-08-5 | 110 122+5 | 5 bidirektionale Formatierungszeichen | ||
| 7.0 [ 42 ] | Juni 2014 | ISBN 978-1-936213-09-2 | 123 | 112 956+2834 | Bassa Vah , Kaukasisches Albanisch , Duployan , Elbasan , Grantha , Khojki , Khudawadi , Linear A , Mahajani , Manichäisch , Mende Kikakui , Modi , Mro , Nabatäisch , Altnordarabisch , Altpermisch , Pahawh Hmong , Palmyren , Pau Cin Hau , Psalter Pahlavi , Siddham , Tirhuta , Warang Citi und Dingbats | |
| 8.0 [ 43 ] | Juni 2015 | ISBN 978-1-936213-10-8 | ISO/IEC 10646:2014 | 129 | 120 672+7716 | Ahom , anatolische Hieroglyphen , Hatran , Multani , Altungarisch , Schilderschrift , zusätzliche CJK-Einheitliche Ideogramme, Kleinbuchstaben für Cherokee, 5 Emoji- Hauttonmodifikatoren |
| 9.0 [ 46 ] | Juni 2016 | ISBN 978-1-936213-13-9 | 135 | 128 172+7500 | Adlam , Bhaiksuki , Marchen , Newa , Osage , Tangut , 72 Emoji [ 47 ] | |
| 10.0 [ 48 ] | Juni 2017 | ISBN 978-1-936213-16-0 | ISO/IEC 10646:2017 | 139 | 136 690+8518 | Zanabazar-Platz , Soyombo , Masaram Gondi , Nüshu , Hentaigana , 7494 CJK-Zeichen, 56 Emojis, U+20BF ₿ Bitcoin-Zeichen |
| 11.0 [ 49 ] | Juni 2018 | ISBN 978-1-936213-19-1 | 146 | 137 374+684 | Dogra , georgische Mtavruli- Großbuchstaben, Gunjala Gondi , Hanifi Rohingya , indische Siyaq-Zahlen , Makassar , Medeafidrin , Alt-Sogdisch und Sogdisch , Maya-Zahlen , 5 CJK-Einheitliche Ideogramme, Symbole für Xiangqi und Sternebewertungen , 145 Emojis | |
| 12.0 [ 50 ] | März 2019 | ISBN 978-1-936213-22-1 | 150 | 137 928+554 | Elymaisch , Nandinagari , Nyiakeng Puachue Hmong , Wancho , Miao-Schrift , Hiragana- und Katakana-Kleinbuchstaben, historische tamilische Brüche und Symbole, laotische Buchstaben für Pali , lateinische Buchstaben für ägyptologische und ugaritische Transliteration, Hieroglyphen-Formatsteuerung, 61 Emojis | |
| 12.1 [ 51 ] | Mai 2019 | ISBN 978-1-936213-25-2 | 137 929+1 | U+32FF ㋿ SQUARE ERA NAME REIWA | ||
| 13.0 [ 52 ] | März 2020 | ISBN 978-1-936213-26-9 | ISO/IEC 10646:2020 | 154 | 143 859+5930 | Chorasmisch , Dhives Akuru , Khitan-Kleinschrift , Jesiditisch , 4.969 CJK-Ideogramme, arabische Schriftzusätze für Hausa , Wolof und andere afrikanische Sprachen, Zusätze für Hindko und Punjabi in Pakistan, Bopomofo-Zusätze für Kantonesisch, Creative-Commons-Lizenzsymbole, grafische Zeichen für die Kompatibilität mit Videotext und Heimcomputersystemen, 55 Emojis |
| 14.0 [ 54 ] | September 2021 | ISBN 978-1-936213-29-0 | 159 | 144 697+838 | Toto , Cypro-Minoanisch , Vithkuqi , Altuigurisch , Tangsa , erweitertes IPA, arabische Schriftzusätze zur Verwendung in Sprachen in ganz Afrika und im Iran, Pakistan, Malaysia, Indonesien, Java und Bosnien, Zusätze für Ehrungen und Korangebrauch, Zusätze zur Unterstützung von Sprachen in Nordamerika, den Philippinen, Indien und der Mongolei, U+20C0 ⃀ SOM SIGN , Znamenny -Musiknotation, 37 Emoji | |
| 15.0 [ 55 ] | September 2022 | ISBN 978-1-936213-32-0 | 161 | 149 186+4489 | Kawi und Mundari , 20 Emojis, 4.192 CJK-Ideogramme, Steuerzeichen für ägyptische Hieroglyphen | |
| 15.1 [ 56 ] | September 2023 | ISBN 978-1-936213-33-7 | 149 813+627 | Zusätzliche CJK-Ideogramme | ||
| 16.0 [ 57 ] | September 2024 | ISBN 978-1-936213-34-4 | 168 | 154 998+5185 | Garay , Gurung Khema , Kirat Rai , Ol Onal , Sunuwar , Todhri , Tulu-Tigalari , 7 Emoji, 3.995 ägyptische Hieroglyphen | |
| 17.0 [ 58 ] | September 2025 | ISBN 978-1-936213-35-1 | 172 | 159 801+4803 | Beria Erfe , Tai Yo , Sidetic , Tolong Siki , U+20C1 SAUDI-RIYAL-ZEICHEN , 7 Emoji, 4.316 einheitliche CJK-Ideogramme | |
- ^ In vielen Dokumentationen für Windows wird der Begriff "Unicode" fälschlicherweise nur für die UTF-16-Kodierung verwendet.
- ^ Die Gesamtzahl der Grafik- und Formatzeichen, ausgenommen Zeichen für den privaten Gebrauch , Steuerzeichen , Nichtzeichen und Ersatzcodepunkte .
- ^
- 2.0 fügte die Änderungen 5, 6 und 7 hinzu.
- 2.1 fügte zwei Zeichen aus dem 18. Zusatzartikel hinzu.
- ^ 3.2 fügte Änderung 1 hinzu.
- ^
- 4.1 Änderungsantrag 1 hinzugefügt
- Version 5.0 fügte den zweiten Änderungsantrag sowie vier Charaktere aus dem dritten Änderungsantrag hinzu.
- 5.1 wurde die Änderung 4 hinzugefügt.
- 5.2 fügte die Änderungen 5 und 6 hinzu.
- ^ Plus das indische Rupienzeichen
- ^
- 6.2 fügte das Zeichen der türkischen Lira hinzu.
- 6.3 fügte fünf zusätzliche Zeichen hinzu
- 7.0 fügte die Änderungen 1 und 2 sowie das Rubelzeichen hinzu.
- ^ Hinzu kamen Änderungsantrag 1 sowie das Lari-Zeichen , neun einheitliche CJK-Ideogramme und 41 Emojis; [ 44 ] Version 9.0 fügte Änderungsantrag 2 sowie Adlam, Newa, japanische Fernsehsymbole und 74 Emojis und Symbole hinzu. [ 45 ]
- ^
- Plus 56 Emojis, 285 Hentai- Zeichen und 3 Zanabazar-Platz-Zeichen
- Version 11.0 fügte 46 georgische Großbuchstaben (Mtavruli), 5 einheitliche CJK-Ideogramme und 66 Emojis hinzu.
- Version 12.0 fügte 62 zusätzliche Zeichen hinzu.
Architektur und Terminologie
Codespace und Codepunkte
Der Unicode-Standard definiert einen Coderaum : [ 59 ] eine Folge von ganzen Zahlen, die als Codepunkte [ 60 ] im Bereich von 0 bis1 114 111 , gemäß dem Standard als U+0000 – U+10FFFF notiert . [ 61 ] Der Coderaum ist eine systematische, architekturunabhängige Darstellung des Unicode-Standards ; der eigentliche Text wird als Binärdaten über eine von mehreren Unicode-Kodierungen, wie z. B. UTF-8 , verarbeitet .
In dieser normativen Notation steht vor jedem geschriebenen Codepunkt ein zweistelliges Präfix U+, und die Codepunkte selbst werden als Hexadezimalzahlen geschrieben . [ Anmerkung 2 ] Es werden immer mindestens vier Hexadezimalziffern geschrieben, gegebenenfalls mit vorangestellten Nullen . Beispielsweise wird der Codepunkt U+00F7 ÷ DIVISION SIGN mit zwei vorangestellten Nullen aufgefüllt, U+13254 𓉔 EGYPTIAN HIEROGLYPH O004 ( ) hingegen nicht. [ 63 ]
Es gibt insgesamt1.112.064 gültige Codepunkte im Coderaum. [ 64 ] Diese Zahl ergibt sich aus den Beschränkungen der UTF-16- Zeichenkodierung , die die 2 <sup>16 </sup> Codepunkte im Bereich U+0000 bis U+FFFF kodieren kann, mit Ausnahme der 2 <sup> 11 </sup> Codepunkte im Bereich U+D800 bis U+DFFF , die als Ersatzpaare verwendet werden, um die 2 <sup>20 </sup> Codepunkte im Bereich U+10000 bis U+10FFFF zu kodieren .
Code-Ebenen und Blöcke
Der Unicode-Zeichenraum ist in 17 Ebenen unterteilt , nummeriert von 0 bis 16. Ebene 0 ist die Basisebene für mehrsprachige Zeichen ( Basic Multilingual Plane , BMP) und enthält die am häufigsten verwendeten Zeichen. Alle Codepunkte der BMP werden in UTF-16-Kodierung als eine einzige Codeeinheit adressiert und können in UTF-8 mit ein, zwei oder drei Bytes kodiert werden. Codepunkte in den Ebenen 1 bis 16 (den ergänzenden Ebenen ) werden in UTF-16 als Ersatzzeichenpaare adressiert und in UTF-8 mit vier Bytes kodiert .
Innerhalb jeder Ebene werden Zeichen in benannten Blöcken zusammengehöriger Zeichen abgelegt . Die Blockgröße ist stets ein Vielfaches von 16 und häufig auch ein Vielfaches von 128, ansonsten jedoch beliebig. Die für ein bestimmtes Skript benötigten Zeichen können sich über mehrere verschiedene, unter Umständen voneinander unabhängige Blöcke innerhalb des Coderaums verteilen.
Allgemeine Kategorie: Immobilien
Jedem Codepunkt wird eine Klassifizierung zugewiesen, die als allgemeine Kategorie des Codepunkts aufgeführt wird . Auf der obersten Ebene werden Codepunkte in die Kategorien Buchstabe, Zeichen, Zahl, Satzzeichen, Symbol, Trennzeichen oder Sonstiges eingeteilt. Innerhalb jeder Kategorie wird jeder Codepunkt weiter unterteilt. In den meisten Fällen müssen weitere Eigenschaften verwendet werden, um alle Merkmale eines Codepunkts adäquat zu beschreiben.
| Allgemeine Kategorie (Unicode- Zeicheneigenschaft ) [ a ] | |||||
|---|---|---|---|---|---|
| Wert | Kategorie Hauptfach, Nebenfach | Grundtyp [ b ] | Zeichen zugewiesen [ b ] | Anzahl [ c ] (Stand 17.0) | Anmerkungen |
| L , Buchstabe; LC , Großbuchstabe (nur Lu, Ll und Lt) [ d ] | |||||
| Lu | Buchstabe, Großbuchstabe | Grafik | Charakter | 1.886 | |
| Ll | Buchstabe, Kleinbuchstabe | Grafik | Charakter | 2.283 | |
| Lt | Brief, Titelschrift | Grafik | Charakter | 31 | Digraphen, die aus einem Großbuchstaben gefolgt von einem Kleinbuchstaben bestehen (z. B. Dž , Lj , Nj , und Dz ) |
| Lm | Buchstabe, Modifikator | Grafik | Charakter | 410 | Ein Modifikatorbuchstabe |
| Lo | Brief, andere | Grafik | Charakter | 141.062 | Ein Ideogramm oder ein Buchstabe in einem Unicase-Alphabet |
| M , Mark | |||||
| Mn | Mark, ohne Leerzeichen | Grafik | Charakter | 2.059 | |
| Mc | Mark, Abstandskombination | Grafik | Charakter | 471 | |
| Mich | Mark, beigefügt | Grafik | Charakter | 13 | |
| N , Anzahl | |||||
| Nd | Zahl, Dezimalziffer | Grafik | Charakter | 770 | Alle diese, und nur diese, haben den numerischen Typ = De [ e ] |
| Nl | Zahl, Buchstabe | Grafik | Charakter | 239 | Zahlen, die aus Buchstaben oder buchstabenähnlichen Symbolen zusammengesetzt sind (z. B. römische Zahlen ). |
| NEIN | Nummer, andere | Grafik | Charakter | 915 | z. B. gewöhnliche Brüche , hoch- und tiefgestellte Ziffern, Vigesimalziffern |
| P , Interpunktion | |||||
| PC | Zeichensetzung, Konnektor | Grafik | Charakter | 10 | Beinhaltet Unterstrichzeichen wie "_" und andere Trennzeichen . Im Gegensatz zu anderen Satzzeichen können diese von Bibliotheken für reguläre Ausdrücke als "Wortzeichen" klassifiziert werden . [ f ] |
| Pd | Satzzeichen, Gedankenstrich | Grafik | Charakter | 27 | Enthält mehrere Bindestrichzeichen |
| Ps | Interpunktion, offen | Grafik | Charakter | 79 | Öffnende Klammerzeichen |
| Pe | Zeichensetzung, schließen | Grafik | Charakter | 77 | Schließende Klammerzeichen |
| Pi | Zeichensetzung, Anführungszeichen | Grafik | Charakter | 12 | Öffnendes Anführungszeichen . Schließt das ASCII-„neutrale“ Anführungszeichen nicht ein. Kann sich je nach Verwendung wie Ps oder Pe verhalten. |
| Pf | Zeichensetzung, letztes Zitat | Grafik | Charakter | 10 | Schließendes Anführungszeichen. Kann sich je nach Verwendung wie Ps oder Pe verhalten. |
| Po | Zeichensetzung, andere | Grafik | Charakter | 641 | |
| S , Symbol | |||||
| Sm | Symbol, Mathematik | Grafik | Charakter | 960 | Mathematische Symbole (z. B. + , − , = , × , ÷ , √ , ∊ , ≠ ). Ausgenommen sind Klammern und eckige Klammern, die zu den Kategorien Ps und Pe gehören. Ebenfalls ausgenommen sind ! , * , - und / , die trotz ihrer häufigen Verwendung als mathematische Operatoren primär als „Interpunktion“ gelten. |
| Sc | Symbol, Währung | Grafik | Charakter | 64 | Währungssymbole |
| Sk | Symbol, Modifikator | Grafik | Charakter | 125 | |
| Also | Symbol, andere | Grafik | Charakter | 7.468 | |
| Z , Trennzeichen | |||||
| Zs | Trennzeichen, Leerzeichen | Grafik | Charakter | 17 | Beinhaltet das Leerzeichen, aber nicht TAB , CR oder LF , die Cc sind. |
| Zl | Trennlinie | Format | Charakter | 1 | Nur U+2028 Linientrenner (LSEP) |
| Zp | Trennzeichen, Absatz | Format | Charakter | 1 | Nur U+2029 Absatztrennzeichen (PSEP) |
| C , Sonstige | |||||
| Cc | Andere, Kontrolle | Kontrolle | Charakter | 65 (wird sich nie ändern) [ e ] | Kein Name, [ g ] <control> |
| Vgl. | Anderes, Format | Format | Charakter | 170 | Beinhaltet den weichen Bindestrich , Verbindungszeichen ( ZWNJ und ZWJ ), Steuerzeichen zur Unterstützung bidirektionalen Textes und Sprachkennzeichen . |
| Cs | Andere, Stellvertreter | Surrogat | Nicht (wird nur in UTF-16 verwendet ) | 2.048 (wird sich nie ändern) [ e ] | Kein Name, [ g ] <Ersatzname> |
| Co | Sonstige, private Nutzung | Privatnutzung | Charakter (aber keine Interpretation angegeben) | 137.468 insgesamt (wird sich nie ändern) [ e ] ( 6.400 in BMP , 131.068 in Planes 15–16 ) | Kein Name, [ g ] <private-use> |
| Cn | Sonstige, nicht zugeordnet | Nicht-Charakter | Nicht | 66 (ändert sich nur, wenn der Bereich der Unicode-Codepunkte erweitert wird) [ e ] | Kein Name, [ g ] <Nichtzeichen> |
| Reserviert | Nicht | 814.664 | Kein Name, [ g ] <reserviert> | ||
| |||||
Der1024 Punkte im Bereich U+D800 – U+DBFF werden als High-Surrogate- Codepunkte bezeichnet , und Codepunkte im Bereich U+DC00 – U+DFFF (Codepunkte mit 1024 Zeichen werden als Low-Surrogate -Codepunkte bezeichnet. Ein High-Surrogate-Codepunkt, gefolgt von einem Low-Surrogate-Codepunkt, bildet in UTF-16 ein Surrogate-Paar, um Codepunkte größer als U+FFFF darzustellen . Prinzipiell können diese Codepunkte nicht anderweitig verwendet werden, in der Praxis wird diese Regel jedoch häufig ignoriert, insbesondere bei der Verwendung anderer als UTF-16-kodierter Systeme.
Eine kleine Menge von Codepunkten wird garantiert niemals Zeichen zugewiesen, obwohl Dritte sie nach eigenem Ermessen unabhängig verwenden können. Es gibt 66 dieser Nicht -Zeichen : U+FDD0 bis U+FDEF und die letzten beiden Codepunkte in jeder der 17 Ebenen (z. B. U+FFFE , U+FFFF , U+1FFFE , U+ 1FFFF , ..., U+10FFFE , U+10FFFF ). Die Menge der Nicht-Zeichen ist stabil, und es werden keine neuen Nicht-Zeichen definiert. [ 65 ] Ähnlich wie bei Surrogaten wird die Regel, dass diese nicht verwendet werden dürfen, oft ignoriert, obwohl die Funktionsweise der Byte Order Mark (BOM) voraussetzt, dass U+FFFE niemals der erste Codepunkt in einem Text ist. Der Ausschluss von Surrogaten und Nicht-Zeichen führt zu einer begrenzten Anzahl von Nicht-Zeichen.1.111.998 Codepunkte stehen zur Verfügung.
Codepunkte für den privaten Gebrauch gelten als zugewiesen, ihre Interpretation ist jedoch im Unicode-Standard [ 66 ] absichtlich nicht festgelegt , sodass jeder Austausch solcher Codepunkte eine separate Vereinbarung zwischen Sender und Empfänger hinsichtlich ihrer Interpretation erfordert. Es gibt drei Bereiche für den privaten Gebrauch im Unicode-Coderaum:
- Privater Nutzungsbereich: U+E000 – U+F8FF (6400 Zeichen),
- Ergänzender privater Nutzungsbereich-A: U+F0000 – U+FFFFD (65.534 Zeichen ),
- Ergänzender privater Nutzungsbereich-B: U+100000 – U+10FFFD (65.534 Zeichen ).
Grafische Zeichen sind solche, die im Unicode-Standard definiert sind und eine bestimmte Semantik besitzen; sie haben entweder eine sichtbare Glyphenform oder stellen einen sichtbaren Raum dar. Seit Unicode 17.0 gibt es159.629 grafische Zeichen.
Formatzeichen sind Zeichen, die keine sichtbare Darstellung haben, aber das Aussehen oder Verhalten benachbarter Zeichen beeinflussen können. Beispielsweise können U+200C ZERO WIDTH NON-JOINER und U+200D ZERO WIDTH JOINER verwendet werden, um das Standardverhalten benachbarter Zeichen zu ändern (z. B. um Ligaturen zu verhindern oder deren Bildung zu erzwingen). Unicode 17.0 enthält 172 Formatzeichen.
65 Codepunkte, die Bereiche U+0000 – U+001F und U+007F – U+009F , sind als Steuercodes reserviert und entsprechen den in ISO/IEC 6429 definierten Steuercodes C0 und C1 . U+0009 (Tabulator) , U+000A (Zeilenvorschub) und U+000D (Wagenrücklauf) werden häufig in Unicode-Texten verwendet. Bei einem Phänomen namens Mojibake werden die C1-Codepunkte gemäß der Windows-1252 -Codepage, die früher in Westeuropa weit verbreitet war, fehlerhaft dekodiert.
Grafische Zeichen, Formatzeichen, Steuerzeichen und Zeichen für den privaten Gebrauch werden zusammenfassend als zugewiesene Zeichen bezeichnet . Reservierte Codepunkte sind solche Codepunkte, die gültig und verwendbar sind, aber noch nicht zugewiesen wurden. Ab Unicode 17.0 gibt es814 664 reservierte Codepunkte.
Abstrakte Zeichen
Die von Unicode definierten grafischen und Formatzeichen entsprechen nicht direkt dem Repertoire der in Unicode darstellbaren abstrakten Zeichen . Unicode kodiert Zeichen, indem es einem bestimmten Codepunkt ein abstraktes Zeichen zuordnet. [ 67 ] Allerdings werden nicht alle abstrakten Zeichen als einzelnes Unicode-Zeichen kodiert; manche abstrakte Zeichen können in Unicode durch eine Folge von zwei oder mehr Zeichen dargestellt werden. Beispielsweise wird der lateinische Kleinbuchstabe „i“ mit Ogonek , Punkt darüber und Akut , der im Litauischen benötigt wird , durch die Zeichenfolge U+012F ; U+0307 ; U+0301 dargestellt . Unicode führt eine Liste eindeutig benannter Zeichenfolgen für abstrakte Zeichen, die nicht direkt in Unicode kodiert sind. [ 68 ]
Alle zugewiesenen Zeichen besitzen einen eindeutigen und unveränderlichen Namen, durch den sie identifiziert werden. Diese Unveränderlichkeit ist seit Version 2.0 des Unicode-Standards durch dessen Richtlinie zur Namensstabilität gewährleistet. [ 65 ] In Fällen, in denen ein Name schwerwiegend fehlerhaft und irreführend ist oder einen schwerwiegenden Tippfehler enthält, kann ein formaler Alias definiert werden, dessen Verwendung Anwendungen anstelle des offiziellen Zeichennamens empfohlen wird. Beispielsweise hat U+A015 ꀕ YI SYLLABLE WU den formalen Alias YI SYLLABLE ITERATION MARK und U+FE18 ︘ PRESENTATION FORM FOR VERTICAL RIGHT WHITE LENTICULAR BRAKCET ( sic ) den formalen Alias PRESENTATION FORM FOR VERTICAL RIGHT WHITE LENTICULAR BRA CK ET . [ 69 ]
Vorkomponiert gegenüber zusammengesetzten Zeichen
Unicode beinhaltet einen Mechanismus zur Modifizierung von Zeichen, der das unterstützte Glyphenrepertoire erheblich erweitert. Dies umfasst die Verwendung von kombinierenden diakritischen Zeichen , die vom Benutzer nach dem Basiszeichen hinzugefügt werden können. Mehrere kombinierende diakritische Zeichen können gleichzeitig auf dasselbe Zeichen angewendet werden. Unicode enthält außerdem vordefinierte Versionen der meisten Buchstaben-/Diakritika-Kombinationen im normalen Gebrauch. Diese vereinfachen die Konvertierung zwischen älteren Kodierungen und ermöglichen es Anwendungen, Unicode als internes Textformat zu verwenden, ohne kombinierende Zeichen implementieren zu müssen. Beispielsweise ékann das Zeichen in Unicode als U+0065 e LATIN SMALL LETTER E gefolgt von U+0301 ◌́ COMBINING ACUTE ACCENT und äquivalent als das vordefinierte Zeichen U+00E9 é LATIN SMALL LETTER E WITH ACUTE dargestellt werden . Daher stehen Benutzern oft mehrere gleichwertige Möglichkeiten zur Kodierung desselben Zeichens zur Verfügung. Der Mechanismus der kanonischen Äquivalenz innerhalb des Unicode-Standards gewährleistet die praktische Austauschbarkeit dieser äquivalenten Kodierungen.
Ein Beispiel hierfür ist das koreanische Alphabet Hangul : Unicode bietet einen Mechanismus zur Zusammensetzung von Hangul-Silben aus ihren einzelnen Hangul-Jamo- Unterkomponenten. Es bietet jedoch auch11 172 Kombinationen von vorgefertigten Silben, die aus dem häufigsten Jamo gebildet werden.
CJK-Zeichen verfügen derzeit nur über Codes für nicht kombinierbare Radikale und vordefinierte Formen. Die meisten Han-Zeichen wurden entweder absichtlich aus einfacheren orthografischen Elementen, den Radikalen , zusammengesetzt oder als deren Zusammensetzung rekonstruiert. Prinzipiell hätte Unicode daher deren Komposition ermöglichen können, wie es bei Hangul der Fall ist. Dies hätte zwar die Anzahl der benötigten Codepunkte erheblich reduzieren und die algorithmische Synthese vieler beliebiger neuer Zeichen ermöglichen können, doch die Komplexität der Zeichenetymologien und die nachträgliche Entwicklung der Radikalsysteme machen den Vorschlag immens komplizierter. Tatsächlich stießen Versuche, CJK-Kodierungen auf Basis der Komposition von Radikalen zu entwerfen, auf Schwierigkeiten, da sich chinesische Zeichen nicht so einfach und regelmäßig zerlegen lassen wie Hangul.
Der Block „CJK Radicals Supplement“ ist dem Bereich U+2E80 – U+2EFF zugeordnet , die Kangxi-Radikale dem Bereich U+2F00 – U+2FDF . Der Block „Ideographic Description Sequences“ umfasst den Bereich U+2FF0 – U+2FFB , jedoch warnt der Unicode-Standard davor, seine Zeichen als alternative Darstellung für anderswo kodierte Zeichen zu verwenden.
Dieser Prozess unterscheidet sich von einer formalen Kodierung eines Ideogramms. Es gibt keine kanonische Beschreibung nicht kodierter Ideogramme; beschriebenen Ideogrammen wird keine Semantik zugeordnet; es ist keine Äquivalenz für beschriebene Ideogramme definiert. Konzeptionell ähneln ideografische Beschreibungen eher dem englischen Ausdruck „ein ‚e‘ mit einem Akut“ als der Zeichenfolge <U+0065, U+0301>.
Ligaturen
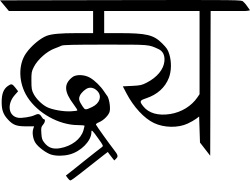

Viele Schriftsysteme, darunter Arabisch und Devanagari , besitzen spezielle orthografische Regeln, die die Bildung spezieller Ligaturen durch bestimmte Buchstabenkombinationen vorschreiben . Die Regeln der Ligaturbildung können recht komplex sein und erfordern spezielle Technologien zur Schriftgestaltung wie ACE (Arabic Calligraphic Engine von DecoType aus den 1980er Jahren, mit der alle arabischen Beispiele in den gedruckten Ausgaben des Unicode-Standards generiert wurden). ACE diente als Grundlage für OpenType (von Adobe und Microsoft), Graphite (von SIL International ) und AAT (von Apple).
In Schriftarten sind auch Anweisungen eingebettet, die dem Betriebssystem mitteilen, wie verschiedene Zeichenfolgen korrekt ausgegeben werden. Eine einfache Lösung für die Platzierung von Kombinationszeichen oder diakritischen Zeichen besteht darin, den Zeichen eine Breite von Null zuzuweisen und das Glyphe selbst links oder rechts vom linken Seitenabstand zu platzieren (abhängig von der Schreibrichtung des verwendeten Schriftsystems). Ein so behandeltes Zeichen erscheint über dem vorhergehenden Zeichen, passt seine Position jedoch nicht an die Breite oder Höhe des Basisglyphen an; dies kann optisch unharmonisch wirken und zu Überlappungen mit anderen Glyphen führen. Eine vollständige Stapelung ist nicht möglich, kann aber in bestimmten Fällen angenähert werden (beispielsweise können thailändische Vokale und Tonzeichen von vornherein unterschiedliche Höhen haben). Im Allgemeinen ist dieser Ansatz nur bei nichtproportionalen Schriftarten effektiv, kann aber als Ausweichmethode verwendet werden, wenn komplexere Verfahren versagen.
Standardisierte Teilmengen
Mehrere Unicode-Teilmengen sind standardisiert: Microsoft Windows unterstützt seit Windows NT 4.0 WGL-4 mit 657 Zeichen, womit alle modernen europäischen Sprachen mit lateinischer, griechischer oder kyrillischer Schrift abgedeckt werden. Weitere standardisierte Unicode-Teilmengen sind die mehrsprachigen europäischen Teilmengen: [ 71 ] MES-1 (nur lateinische Schriften; 335 Zeichen), MES-2 (lateinisch, griechisch und kyrillisch; 1062 Zeichen) [ 72 ] sowie MES-3A und MES-3B (zwei größere Teilmengen, hier nicht dargestellt). MES-2 umfasst alle Zeichen von MES-1 und WGL-4.
Die Norm DIN 91379 [ 73 ] definiert eine Teilmenge von Unicode-Buchstaben, Sonderzeichen und Buchstabenfolgen mit diakritischen Zeichen, um die korrekte Darstellung von Namen zu ermöglichen und den Datenaustausch in Europa zu vereinfachen. Diese Norm unterstützt alle Amtssprachen der EU-Mitgliedstaaten sowie die deutschen Minderheitensprachen und die Amtssprachen von Island, Liechtenstein, Norwegen und der Schweiz. Um die Transliteration von Namen aus anderen Schriftsystemen ins lateinische Alphabet gemäß den entsprechenden ISO-Normen zu ermöglichen, werden alle notwendigen Kombinationen von Grundbuchstaben und diakritischen Zeichen bereitgestellt.
| Reihe | Zellen | Bereich(e) |
|---|---|---|
| 00 | 20–7E | Lateinische Grundkenntnisse (00–7F) |
| A0–FF | Latin-1 Supplement (80–FF) | |
| 01 | 00–13, 14–15, 16–2B, 2C–2D, 2E–4D, 4E–4F, 50–7E, 7F | Lateinisch Extended-A (00–7F) |
| 8F, 92, B7, DE-EF, FA–FF | Lateinisch Extended-B (80–FF ... ) | |
| 02 | 18–1B, 1E–1F | Lateinisch Extended-B ( ... 00–4F) |
| 59, 7C, 92 | IPA-Erweiterungen (50–AF) | |
| BB–BD, C6, C7, C9, D6, D8–DB, DC, DD, DF, EE | Abstandsmodifikatorbuchstaben (B0–FF) | |
| 03 | 74–75, 7A, 7E, 84–8A, 8C, 8E–A1, A3–CE, D7, DA–E1 | Griechisch (70–FF) |
| 04 | 00–5F, 90–91, 92–C4, C7–C8, CB–CC, D0–EB, EE–F5, F8–F9 | Kyrillisch (00–FF) |
| 1E | 02–03, 0A–0B, 1E–1F, 40–41, 56–57, 60–61, 6A–6B, 80–85, 9B, F2–F3 | Lateinisch Erweiterte Zusatzbezeichnungen (00–FF) |
| 1F | 00–15, 18–1D, 20–45, 48–4D, 50–57, 59, 5B, 5D, 5F–7D, 80–B4, B6–C4, C6–D3, D6–DB, DD–EF, F2–F4, F6–FE | Griechisch erweitert (00–FF) |
| 20 | 13–14, 15, 17, 18–19, 1A–1B, 1C–1D, 1E, 20–22, 26, 30, 32–33, 39–3A, 3C, 3E, 44, 4A | Allgemeine Zeichensetzung (00–6F) |
| 7F , 82 | Hoch- und Tiefstellungen (70–9F) | |
| A3–A4, A7, AC, AF | Währungssymbole (A0–CF) | |
| 21 | 05, 13, 16, 22, 26, 2E | Buchstabenähnliche Symbole (00–4F) |
| 5B–5E | Zahlenformen (50–8F) | |
| 90–93, 94–95, A8 | Pfeile (90–FF) | |
| 22 | 00, 02, 03, 06, 08–09, 0F, 11–12, 15, 19–1A, 1E–1F, 27–28, 29 , 2A, 2B, 48, 59, 60–61, 64–65, 82–83, 95, 97 | Mathematische Operatoren (00–FF) |
| 23 | 02, 0A, 20–21, 29–2A | Sonstige technische Informationen (00–FF) |
| 25 | 00, 02, 0C, 10, 14, 18, 1C, 24, 2C, 34, 3C, 50–6C | Schachtzeichnung (00–7F) |
| 80, 84, 88, 8C, 90–93 | Blockelemente (80–9F) | |
| A0–A1, AA–AC, B2, BA, BC, C4, CA–CB, CF, D8–D9, E6 | Geometrische Formen (A0–FF) | |
| 26 | 3A–3C, 40, 42, 60, 63, 65–66, 6A, 6B | Verschiedene Symbole (00–FF) |
| F0 | (01–02) | Privater Nutzungsbereich (00–FF ...) |
| FB | 01–02 | Alphabetische Präsentationsformen (00–4F) |
| FF | FD | Sonderangebote |
Rendering-Software, die ein Unicode-Zeichen nicht korrekt verarbeiten kann, zeigt es oft als offenes Rechteck oder als U+FFFD an , um die Position des nicht erkannten Zeichens zu kennzeichnen. Einige Systeme versuchen, mehr Informationen über solche Zeichen bereitzustellen. Apples Schriftart „Last Resort“ zeigt ein Ersatzzeichen an, das den Unicode-Bereich des Zeichens angibt, und die Unicode-Fallback-Schriftart von SIL International zeigt ein Kästchen mit dem hexadezimalen Skalarwert des Zeichens an.
Zuordnung und Kodierungen
Es wurden verschiedene Mechanismen zur Speicherung einer Reihe von Codepunkten als Bytefolge spezifiziert.
Unicode definiert zwei Abbildungsmethoden: die Unicode Transformation Format (UTF)-Kodierungen und die Universal Coded Character Set (UCS)-Kodierungen. Eine Kodierung ordnet (gegebenenfalls eine Teilmenge) des Bereichs der Unicode -Codepunkte Sequenzen von Werten in einem Bereich fester Größe zu, die als Codeeinheiten bezeichnet werden . Alle UTF-Kodierungen ordnen Codepunkte einer eindeutigen Bytefolge zu. [ 74 ] Die Zahlen in den Namen der Kodierungen geben die Anzahl der Bits pro Codeeinheit (bei UTF-Kodierungen) bzw. die Anzahl der Bytes pro Codeeinheit (bei UCS-Kodierungen und UTF-1 ) an. UTF-8 und UTF-16 sind die gebräuchlichsten Kodierungen. UCS-2 ist eine veraltete Teilmenge von UTF-16; UCS-4 und UTF-32 sind funktional äquivalent.
Zu den UTF-Kodierungen gehören:
- UTF-8 verwendet ein bis vier 8-Bit-Einheiten pro Codepunkt [ Anmerkung 3 ] und ist maximal kompatibel mit ASCII.
- UTF-16 verwendet eine 16-Bit-Einheit pro Codepunkt unterhalb von U+010000 und ein Ersatzpaar aus zwei 16-Bit-Einheiten pro Codepunkt im Bereich von U+010000 bis U+10FFFF.
- UTF-32 , das pro Codepunkt eine 32-Bit-Einheit verwendet.
- UTF-EBCDIC , das nicht als Teil des Unicode-Standards spezifiziert ist und ein bis fünf 8-Bit-Einheiten pro Codepunkt verwendet, soll die Kompatibilität mit EBCDIC maximieren.
UTF-8 verwendet ein bis vier 8-Bit-Einheiten ( Bytes ) pro Codepunkt und ist aufgrund seiner Kompaktheit für lateinische Schriftsysteme und ASCII-Kompatibilität der De-facto-Standard für den Austausch von Unicode-Texten. Es wird von FreeBSD und den meisten neueren Linux-Distributionen als direkter Ersatz für ältere Kodierungen bei der allgemeinen Textverarbeitung eingesetzt.
Die Kodierungen UCS-2 und UTF-16 spezifizieren die Unicode- Byte-Order-Markierung (BOM) für den Anfang von Textdateien, die zur Erkennung der Byte-Reihenfolge (oder Byte-Endianness ) verwendet werden kann. Die als U+FEFF ZERO WIDTH NO-BREAK SPACE kodierte BOM ist unabhängig von der verwendeten Unicode-Kodierung eindeutig bei Byte-Umordnung; U+FFFE (das Ergebnis des Byte-Tauschs von U+FEFF ) entspricht keinem gültigen Zeichen, und U+FEFF an anderen Stellen als am Textanfang kennzeichnet ein Nullbreiten-Leerzeichen.
Dasselbe Zeichen wird in UTF-8 zu einer Bytefolge EF BB BF. Der Unicode-Standard erlaubt, dass die Byte Order Mark (BOM) „als Signatur für UTF-8-kodierten Text dienen kann, wenn der Zeichensatz nicht markiert ist“ [ 75 ] . Einige Softwareentwickler haben sie für andere Kodierungen, einschließlich UTF-8, übernommen, um UTF-8 von lokalen 8-Bit- Codepages zu unterscheiden. RFC 3629 , der UTF-8-Standard, empfiehlt jedoch , Byte Order Marks in Protokollen, die UTF-8 verwenden, zu verbieten, diskutiert aber Fälle, in denen dies nicht möglich ist. Darüber hinaus bedeutet die starke Einschränkung möglicher Muster in UTF-8 (beispielsweise darf es keine einzelnen Bytes mit gesetztem High-Bit geben), dass es möglich sein sollte, UTF-8 von anderen Zeichenkodierungen zu unterscheiden, ohne auf die BOM angewiesen zu sein.
In UTF-32 und UCS-4 dient eine 32-Bit -Codeeinheit als nahezu direkte Darstellung des Codepunkts eines beliebigen Zeichens (wobei die Byte-Reihenfolge, die je nach Plattform variiert, die Darstellung der Codeeinheit als Bytefolge beeinflusst). In den anderen Kodierungen kann jeder Codepunkt durch eine variable Anzahl von Codeeinheiten dargestellt werden. UTF-32 wird häufig als interne Textdarstellung in Programmen verwendet (im Gegensatz zu gespeichertem oder übertragenem Text), da jedes Unix-Betriebssystem, das GCC -Compiler zur Softwaregenerierung nutzt, UTF-32 als Standardkodierung für „ breite Zeichen “ verwendet. Neuere Versionen der Programmiersprache Python (ab Version 2.2) können ebenfalls so konfiguriert werden, dass sie UTF-32 als Darstellung für Unicode-Zeichenketten verwenden, wodurch diese Kodierung effektiv in höherer Programmiersprache verbreitet wird.
Punycode , eine weitere Kodierungsform, ermöglicht die Kodierung von Unicode-Zeichenketten in den begrenzten Zeichensatz des ASCII- basierten Domain Name Systems (DNS). Diese Kodierung wird im Rahmen von IDNA verwendet , einem System, das die Verwendung internationalisierter Domainnamen in allen von Unicode unterstützten Schriftsystemen ermöglicht. Frühere und mittlerweile historische Vorschläge umfassen UTF-5 und UTF-6 .
GB18030 ist eine weitere Kodierungsform für Unicode, herausgegeben von der chinesischen Standardisierungsbehörde . Es ist der offizielle Zeichensatz der Volksrepublik China. BOCU-1 und SCSU sind Unicode-Komprimierungsverfahren. Der am 1. April 2005 veröffentlichte RFC spezifizierte zwei parodistische UTF-Kodierungen, UTF-9 und UTF-18 .
Annahme
Unicode, in Form von UTF-8 , ist seit 2008 die gängigste Kodierung für das World Wide Web. [ 76 ] Sie ist nahezu universell verbreitet, und ein Großteil der Inhalte, die nicht in UTF-8 kodiert sind, findet sich in anderen Unicode-Kodierungen, z. B. UTF-16 . Im Jahr 2024 entfielen durchschnittlich 98,3 % aller Webseiten auf UTF-8 (darunter 983 der 1000 meistbesuchten Webseiten). [ 77 ] Obwohl viele Seiten zur Darstellung von Inhalten ausschließlich ASCII- Zeichen verwenden, wurde UTF-8 mit 8-Bit-ASCII als Teilmenge entwickelt, und heutzutage gibt kaum noch eine Webseite an, ausschließlich ASCII anstatt UTF-8 zu verwenden. [ 78 ] Über ein Drittel der erfassten Sprachen nutzen UTF-8 vollständig.
Alle von der Internet Engineering Task Force ( IETF ) verwalteten Internetprotokolle , z. B. das File Transfer Protocol (FTP) [ 79 ] , erfordern seit der Veröffentlichung von RFC 2277 im Jahr 1998 die Unterstützung von UTF-8. In RFC 2277 wurde festgelegt, dass alle IETF-Protokolle „den UTF-8-Zeichensatz verwenden können MÜSSEN“. [ 80 ]
Betriebssysteme
Unicode hat sich als dominierendes Schema für die interne Verarbeitung und Speicherung von Text etabliert. Obwohl noch immer viele Texte in älteren Kodierungen gespeichert werden, wird Unicode fast ausschließlich für die Entwicklung neuer Informationsverarbeitungssysteme verwendet. Frühe Anwender nutzten UCS-2 (den veralteten, zwei Byte langen Vorläufer von UTF-16) und wechselten später zu UTF-16 (dem aktuellen Standard mit variabler Länge), da dies die unkomplizierteste Methode war, Unterstützung für Nicht-BMP-Zeichen hinzuzufügen. Das bekannteste System dieser Art ist Windows NT (und seine Nachfolger 2000 , XP , Vista , 7 , 8 , 10 und 11 ), das UTF-16 als einzige interne Zeichenkodierung verwendet. Auch die Bytecode-Umgebungen von Java und .NET , macOS und KDE nutzen UTF-16 für die interne Darstellung. Unter Windows 9x kann über die Microsoft-Unicode-Schicht eine teilweise Unicode-Unterstützung installiert werden .
UTF-8 (ursprünglich für Plan 9 entwickelt ) [ 81 ] hat sich auf den meisten Unix-ähnlichen Betriebssystemen als Hauptspeicherkodierung etabliert (obwohl einige Bibliotheken auch andere Kodierungen verwenden), da sie einen relativ einfachen Ersatz für die traditionellen erweiterten ASCII- Zeichensätze darstellt. UTF-8 ist zudem die am häufigsten verwendete Unicode-Kodierung in HTML- Dokumenten im World Wide Web .
Zu den mehrsprachigen Textwiedergabe-Engines, die Unicode verwenden, gehören Uniscribe und DirectWrite für Microsoft Windows, ATSUI und Core Text für macOS sowie Pango für GTK+ und den GNOME- Desktop.
Eingabemethoden
Da Tastaturlayouts nicht für alle Zeichen einfache Tastenkombinationen vorsehen können, bieten verschiedene Betriebssysteme alternative Eingabemethoden an, die den Zugriff auf das gesamte Repertoire ermöglichen.
ISO/IEC 14755 [ 82 ] standardisiert die Eingabemethoden für Unicode-Zeichen anhand ihrer Codepunkte und beschreibt mehrere Verfahren. Das Basisverfahren besteht darin , einer Anfangssequenz die hexadezimale Darstellung des Codepunkts und die Endsequenz zuzuordnen . Außerdem wird ein Verfahren zur Eingabe über eine Bildschirmauswahl beschrieben, bei dem die Zeichen in einer Tabelle auf dem Bildschirm angezeigt werden, beispielsweise mithilfe eines Zeichentabellenprogramms.
Online-Tools zur Ermittlung des Codepunkts eines bekannten Zeichens sind beispielsweise Unicode Lookup [ 83 ] von Jonathan Hedley und Shapecatcher [ 84 ] von Benjamin Milde. In Unicode Lookup gibt man einen Suchbegriff ein (z. B. „Brüche“) und erhält eine Liste der entsprechenden Zeichen mit ihren Codepunkten. Shapecatcher hingegen, basierend auf dem Shape-Kontext , zeichnet das Zeichen in ein Rechteck und liefert eine Liste von Zeichen, die der Zeichnung möglichst nahekommen, inklusive ihrer Codepunkte.
MIME definiert zwei verschiedene Mechanismen zur Kodierung von Nicht-ASCII-Zeichen in E-Mails, je nachdem, ob sich die Zeichen in den E-Mail-Headern (z. B. „Betreff:“) oder im Nachrichtentext befinden. In beiden Fällen werden der ursprüngliche Zeichensatz sowie eine Übertragungskodierung angegeben. Für die E-Mail-Übertragung von Unicode werden der UTF-8- Zeichensatz und die Base64- oder Quoted-Printable- Übertragungskodierung empfohlen, je nachdem, ob ein Großteil der Nachricht aus ASCII- Zeichen besteht. Die Details der beiden Mechanismen sind in den MIME-Standards spezifiziert und werden Benutzern von E-Mail-Software in der Regel nicht angezeigt.
Die IETF hat [ 85 ] [ 86 ] ein Framework für internationalisierte E-Mails unter Verwendung von UTF-8 definiert und [ 87 ] [ 88 ] [ 89 ] [ 90 ] mehrere Protokolle entsprechend diesem Framework aktualisiert .
Die Einführung von Unicode in E-Mails verlief sehr schleppend. Einige ostasiatische Texte werden immer noch in Kodierungen wie ISO-2022 kodiert , und manche Geräte, beispielsweise Mobiltelefone, können Unicode-Daten noch nicht korrekt verarbeiten. Die Unterstützung hat sich jedoch verbessert. Viele große kostenlose E-Mail-Anbieter wie Yahoo! Mail , Gmail und Outlook.com unterstützen Unicode bereits.
Web
Seit HTML 4.0 verwenden alle W3C- Empfehlungen Unicode als Zeichensatz für Dokumente . Webbrowser unterstützen Unicode, insbesondere UTF-8, seit vielen Jahren. Früher gab es Darstellungsprobleme, die hauptsächlich auf Schriftartprobleme zurückzuführen waren ; beispielsweise konnte der Microsoft Internet Explorer in Version 6 und älter viele Codepunkte nur dann korrekt darstellen, wenn explizit eine Schriftart mit diesen Codepunkten angegeben wurde. [ 91 ]
Obwohl Syntaxregeln die Reihenfolge beeinflussen können, in der Zeichen erscheinen dürfen, umfassen XML- Dokumente (einschließlich XHTML- Dokumente) definitionsgemäß [ 92 ] Zeichen aus den meisten Unicode-Codepunkten, mit Ausnahme von:
- FFFE oder FFFF.
- die meisten C0-Steuercodes ,
- die dauerhaft nicht zugewiesenen Codepunkte D800–DFFF,
HTML-Zeichen werden entweder direkt als Bytes gemäß der Dokumentkodierung dargestellt, sofern diese dies unterstützt, oder Benutzer können sie als numerische Zeichenreferenzen basierend auf dem Unicode-Codepunkt des Zeichens schreiben. Beispielsweise sollten die Referenzen Δ, Й, , ק, م, ๗, あ, 叶, 葉und 말(oder dieselben numerischen Werte in Hexadezimaldarstellung mit Þm Präfix ) in allen Browsern als Δ, Й, ק, م, ๗, あ, 叶, 葉 und 말 angezeigt werden.
Bei der Angabe von URIs , beispielsweise als URLs in HTTP- Anfragen, müssen Nicht-ASCII-Zeichen prozentcodiert werden .
Schriftarten
Unicode befasst sich prinzipiell nicht mit Schriftarten an sich , sondern betrachtet sie als Implementierungsoptionen. [ 93 ] Jedes Zeichen kann zahlreiche Allogramme haben , von den gebräuchlicheren Formen wie Fettdruck, Kursivschrift und Grundbuchstaben bis hin zu komplexen dekorativen Stilen. Eine Schriftart ist „Unicode-konform“, wenn die Glyphen der Schriftart über die im Unicode-Standard definierten Codepunkte angesprochen werden können . [ 94 ] Der Standard legt keine Mindestanzahl an Zeichen fest, die in der Schriftart enthalten sein müssen; manche Schriftarten verfügen über ein recht kleines Repertoire.
Kostenlose und kommerzielle Schriftarten auf Unicode-Basis sind weit verbreitet, da TrueType und OpenType Unicode unterstützen (und das Web Open Font Format (WOFF und WOFF2 ) darauf basiert). Diese Schriftformate ordnen Unicode-Codepunkte Glyphen zu, jedoch sind OpenType- und TrueType-Schriftdateien auf 65.535 Glyphen beschränkt. Sammlungsdateien bieten einen „Gap-Mode“-Mechanismus, um diese Beschränkung in einer einzelnen Schriftdatei zu umgehen. (Jede Schriftart innerhalb der Sammlung unterliegt jedoch weiterhin der Beschränkung auf 65.535 Glyphen.) Eine TrueType-Sammlungsdatei hat typischerweise die Dateiendung „.ttc“.
Tausende von Schriftarten sind auf dem Markt erhältlich, doch nur wenige – oft als „Pan-Unicode“-Schriften bezeichnet – versuchen, den Großteil des Unicode-Zeichensatzes zu unterstützen. Unicode-basierte Schriftarten konzentrieren sich stattdessen typischerweise auf die Unterstützung von ASCII-Zeichen und bestimmten Schriftsystemen oder Zeichensätzen. Mehrere Gründe rechtfertigen diesen Ansatz: Anwendungen und Dokumente müssen selten Zeichen aus mehr als ein oder zwei Schriftsystemen darstellen; Schriftarten beanspruchen in Computerumgebungen Ressourcen; und Betriebssysteme und Anwendungen werden immer intelligenter darin, Glypheninformationen bei Bedarf aus separaten Schriftartdateien zu beziehen ( Schriftartsubstitution) . Darüber hinaus ist die Entwicklung eines konsistenten Satzes von Darstellungsanweisungen für Zehntausende von Glyphen eine immense Aufgabe; ein solches Unterfangen ist für die meisten Schriftarten nicht mehr rentabel .
Zeilenumbrüche
Unicode löst das Problem der Zeilenumbrüche , das beim Lesen von Textdateien auf verschiedenen Plattformen auftritt, teilweise. Unicode definiert eine große Anzahl von Zeichen , die kompatible Anwendungen als Zeilenumbrüche erkennen sollten.
Bezüglich Zeilenumbrüchen führte Unicode die Zeichen U+2028 LINE SEPARATOR und U+2029 PARAGRAPH SEPARATOR ein . Dies war der Versuch, eine Unicode-Lösung für die semantische Kodierung von Absätzen und Zeilen bereitzustellen und potenziell alle plattformspezifischen Lösungen zu ersetzen. Dadurch bietet Unicode eine Möglichkeit, die bisherigen plattformabhängigen Lösungen zu umgehen. Dennoch haben nur wenige Unicode-Lösungen diese Unicode-Zeilen- und Absatztrennzeichen als alleinige kanonische Zeilenumbruchzeichen übernommen. Ein gängiger Ansatz zur Lösung dieses Problems ist die Zeilenumbruchnormalisierung. Dies wird im Cocoa-Textsystem von macOS sowie in den W3C-Empfehlungen für XML und HTML erreicht. Bei diesem Ansatz wird jedes mögliche Zeilenumbruchzeichen intern in einen gemeinsamen Zeilenumbruch umgewandelt (welcher, ist irrelevant, da es sich um eine interne Operation nur für die Darstellung handelt). Anders ausgedrückt: Das Textsystem kann das Zeichen unabhängig von der tatsächlichen Kodierung der Eingabe korrekt als Zeilenumbruch behandeln.
Probleme
Charaktervereinheitlichung
Han-Vereinigung
Die Ideographic Research Group (IRG) berät das Konsortium und die ISO hinsichtlich der Han-Vereinheitlichung (Unihan), insbesondere der weiteren Ergänzung des Repertoires um vereinheitlichte CJK- und Kompatibilitäts-Ideogramme. Die IRG setzt sich aus Experten aus allen Regionen zusammen, die historisch chinesische Schriftzeichen verwendet haben . Trotz der Diskussionen innerhalb des Komitees zählt die Han-Vereinheitlichung seit Beginn des Projekts zu den umstrittensten Aspekten des Unicode-Standards . [ 95 ]
Bestehende Zeichensatzstandards wie der japanische JIS X 0208 (kodiert durch Shift JIS ) definierten Vereinheitlichungskriterien. Diese Regeln legten fest, wann eine chinesische Variante als Unterschied in Handschrift oder Schriftart (und somit vereinheitlicht) und wann als Unterschied in der Schreibweise (und damit separat zu kodieren) zu betrachten war. Das Unicode-Zeichenmodell für CJK-Zeichen basierte auf den Vereinheitlichungskriterien des JIS X 0208 sowie auf den Kriterien der Association for a Common Chinese Code in China. [ 96 ]
Aufgrund des Prinzips, semantische statt stilistische Varianten zu kodieren, wurde Unicode dafür kritisiert, dass bestimmten seltenen und archaischen Kanji- Varianten keine Codepunkte zugewiesen wurden, was die Verarbeitung alter und ungewöhnlicher japanischer Namen erschweren kann. Da die Han-Vereinheitlichung besonderes Augenmerk auf die vielen gemeinsamen Schriftzeichen von Chinesisch, Japanisch und Koreanisch legt, wird sie mitunter auch als Gleichsetzung dieser drei Sprachen wahrgenommen. [ 97 ] Regionale Unterschiede in den erwarteten Schriftzeichenformen, sowohl hinsichtlich typografischer Konventionen als auch des Schriftunterrichts, verlaufen nicht immer entlang von Sprachgrenzen: Obwohl in Hongkong und Taiwan beide traditionelle chinesische Schriftzeichen verwendet werden , unterscheiden sich die bevorzugten Schriftzeichenformen in einigen Fällen. [ 98 ]
Es existieren weniger gebräuchliche alternative Kodierungen, die oft älter sind als Unicode. Ihre Zeichenmodelle unterscheiden sich von diesem Paradigma und zielen darauf ab, die verschiedenen stilistischen Unterschiede zwischen regionalen und/oder nicht standardisierten Zeichenformen zu bewahren. Ein Beispiel ist der TRON-Code, der von einigen Nutzern für die Verarbeitung historischer japanischer Texte bevorzugt wird, sich aber in der japanischen Öffentlichkeit nicht weit verbreitet hat. Ein weiteres Beispiel ist die CCCII- Kodierung, die von Bibliothekssystemen in Hongkong , Taiwan und den Vereinigten Staaten verwendet wird . Diese Kodierungen weisen im allgemeinen Gebrauch eigene Nachteile auf, was dazu führte, dass die Big5 -Kodierung (eingeführt 1984, vier Jahre nach CCCII) außerhalb von Bibliothekssystemen verbreiteter wurde als CCCII. [ 99 ] Obwohl die Arbeit bei Apple auf dem CJK-Thesaurus der Research Libraries Group basierte , der zur Pflege der EACC-Variante von CCCII verwendet wurde und einer der direkten Vorläufer des Unihan- Zeichensatzes von Unicode war, übernahm Unicode das JIS-ähnliche Vereinheitlichungsmodell. [ 96 ]
Die früheste Version von Unicode umfasste weniger als 21.000 chinesische Schriftzeichen, die sich größtenteils auf die im modernen Sprachgebrauch gebräuchlichen beschränkten. Mittlerweile, Version 17.0, kodiert der Standard über 101.000 chinesische Schriftzeichen, und es wird kontinuierlich daran gearbeitet, Tausende weitere hinzuzufügen – vorwiegend historische und dialektale Varianten, die im gesamten chinesischen Sprachraum verwendet werden .
Moderne Schriftarten bieten eine Möglichkeit, einige praktische Probleme bei der Darstellung einheitlicher Han-Zeichen mit verschiedenen regionalen grafischen Repräsentationen zu lösen. Die OpenType- Tabelle „locl“ ermöglicht es einem Renderer, basierend auf dem Textgebietsschema für jeden Codepunkt ein anderes Glyphenzeichen auszuwählen. [ 100 ] Die Unicode-Variantensequenzen können zudem Textanmerkungen für die gewünschte Glyphenauswahl bereitstellen; dies erfordert die Registrierung der jeweiligen Variante in der Ideographic Variation Database .
Kursive oder kursive Zeichen in Kyrillisch

Wenn sich die entsprechenden Glyphen für Zeichen desselben Schriftsystems nur in der Kursivschrift unterscheiden, hat Unicode sie im Allgemeinen vereinheitlicht. Dies zeigt sich im Vergleich der kursiven Glyphen von sieben Zeichen, wie sie typischerweise in russischen, traditionellen bulgarischen, mazedonischen und serbischen Texten vorkommen (siehe rechts). Die Unterschiede werden also durch intelligente Schriftartentechnologie oder durch manuelles Ändern der Schriftarten dargestellt. Dabei kommt dieselbe OpenType-Technik „locl“ zum Einsatz. [ 101 ]
Lokalisierte Fallpaare
Für die Verwendung im türkischen und aserbaidschanischen Alphabet enthält Unicode ein separates punktloses kleines i (ı) und ein punktiertes großes i ( İ ). Für das punktierte kleine i und das punktlose große i werden jedoch die üblichen ASCII-Zeichen verwendet , entsprechend der Vorgehensweise im früheren ISO 8859-9 . Daher müssen für diese Sprachen bei nicht-case-sensitiven Vergleichen andere Regeln gelten als für andere Sprachen mit lateinischer Schrift. [ 102 ] [ 103 ] Dies kann Sicherheitsrisiken bergen, wenn beispielsweise Bereinigungscode oder Zugriffskontrollen auf nicht-case-sensitiven Vergleichen basieren. [ 103 ]
Im Gegensatz dazu werden das isländische Eth (ð) , das D mit Strich (đ) und das retroflexe D (ɖ) , die in Großbuchstaben üblicherweise gleich aussehen (Đ), anders behandelt und in beiden Schreibweisen separat kodiert (im Gegensatz zum früheren ISO 6937 , der die Großbuchstaben vereinheitlicht). Obwohl dieser Ansatz einen Vergleich unabhängig von Groß- und Kleinschreibung ermöglicht, ohne die Sprache des Textes kennen zu müssen, birgt er auch Probleme und erfordert Sicherheitsmaßnahmen gegen Homoglyphenangriffe . [ 104 ]
Diakritische Zeichen auf dem Kleinbuchstaben I

Ob der Kleinbuchstabe I seine Bezeichnung behält, wenn ein diakritisches Zeichen verwendet wird, hängt auch von den lokalen Konventionen ab.
Sicherheit
Unicode enthält eine große Anzahl von Homoglyphen , von denen viele ASCII-Zeichen sehr ähnlich sehen oder mit ihnen identisch sind. Durch deren Ersetzung kann eine Kennung oder URL entstehen, die zwar korrekt aussieht, aber auf ein anderes Ziel verweist als erwartet. [ 105 ] Darüber hinaus können Homoglyphen auch zur Manipulation der Ausgabe von Systemen zur Verarbeitung natürlicher Sprache (NLP) verwendet werden . [ 106 ] Um dem entgegenzuwirken, müssen diese Zeichen entweder verboten, anders dargestellt oder so aufgelöst werden, dass sie zur selben Kennung führen. [ 107 ] All dies gestaltet sich aufgrund des riesigen und sich ständig ändernden Zeichensatzes kompliziert. [ 108 ] [ 109 ]
Im Jahr 2021 veröffentlichten zwei Forscher, einer von der Universität Cambridge und einer von der Universität Edinburgh , eine Sicherheitswarnung, in der sie darauf hinwiesen, dass BiDi-Markierungen dazu missbraucht werden können, große Codeabschnitte anders auszuführen, als es den Anschein hat. Das Problem wurde als „ Trojan Source “ bezeichnet. [ 110 ] Daraufhin begannen Code-Editoren, Markierungen hervorzuheben, um erzwungene Änderungen der Textrichtung anzuzeigen. [ 111 ]
Die UTF-8- und UTF-16- Kodierungen akzeptieren nicht alle möglichen Sequenzen von Codeeinheiten. Die Implementierungen unterscheiden sich darin, wie sie mit einer ungültigen Sequenz umgehen, was zu Sicherheitslücken geführt hat. [ 112 ] [ 113 ]
Zuordnung zu älteren Zeichensätzen
Unicode wurde entwickelt, um eine Codepunkt-für-Codepunkt- Formatkonvertierung zwischen bestehenden Zeichenkodierungen zu ermöglichen. So können Textdateien älterer Zeichensätze in Unicode konvertiert und anschließend wieder in Unicode zurückkonvertiert werden, ohne dass eine kontextabhängige Interpretation erforderlich ist. Dies hat zur Folge, dass inkonsistente ältere Architekturen, wie die Kombination von diakritischen Zeichen und vorgefertigten Zeichen , in Unicode weiterhin existieren und somit mehrere Möglichkeiten zur Darstellung desselben Textes bieten. Besonders deutlich wird dies bei den drei verschiedenen Kodierungsformen für das koreanische Hangul . Seit Version 3.0 können keine vorgefertigten Zeichen mehr in den Standard aufgenommen werden, die durch eine Kombination bereits existierender Zeichen dargestellt werden können, um die Interoperabilität zwischen Software mit unterschiedlichen Unicode-Versionen zu gewährleisten.
Um die Konvertierung nach Unicode zu erleichtern und die Interoperabilität mit älterer Software zu gewährleisten, müssen injektive Zuordnungen zwischen Zeichen in bestehenden älteren Zeichensätzen und Unicode-Zeichen bereitgestellt werden. Die mangelnde Konsistenz verschiedener Zuordnungen zwischen älteren japanischen Kodierungen wie Shift-JIS oder EUC-JP und Unicode führte zu Inkonsistenzen bei der Formatkonvertierung , insbesondere bei der Zuordnung des Zeichens JIS X 0208 '~' (1-33, Wellenstrich), das in älteren Datenbankdaten häufig verwendet wird, entweder zu U+FF5E~Vollbreite Tilde (in Microsoft Windows ) oder zu U+301C〜Wellenstrich (andere Hersteller). [ 114 ]
Einige japanische Programmierer lehnten Unicode ab, da es die getrennte Verwendung von U+005C \ (umgekehrter Schrägstrich ) und U+00A5 ¥ (Yen-Zeichen) erforderte , welches in JIS X 0201 auf 0x5C abgebildet war. Zahlreiche ältere Programme verwenden diese getrennte Verwendung. [ 115 ] (Diese Kodierung ersetzt außerdem die Tilde '~' 0x7E durch das Makron '¯', jetzt 0xAF.) Die Trennung dieser Zeichen existierte bereits in ISO 8859-1 , lange vor Unicode.
Indische Schriften
Indische Schriften wie Tamil und Devanagari verfügen jeweils nur über 128 Codepunkte, entsprechend dem ISCII- Standard. Die korrekte Darstellung indischer Unicode-Texte erfordert die Umwandlung der gespeicherten Zeichen in eine visuelle Reihenfolge und die Bildung von Ligaturen (auch Konjunktionen genannt) aus den einzelnen Komponenten. Einige indische Gelehrte plädierten für die Zuweisung von Unicode-Codepunkten zu diesen Ligaturen, entgegen der Praxis anderer Schriftsysteme. Unicode enthält jedoch aus Gründen der Abwärtskompatibilität einige arabische und andere Ligaturen. [ 116 ] [ 117 ] [ 118 ] Die Kodierung neuer Ligaturen in Unicode wird unter anderem deshalb nicht erfolgen, weil der Ligaturensatz schriftartabhängig ist, Unicode aber eine schriftartunabhängige Kodierung darstellt. Ein ähnliches Problem trat 2003 bei der tibetischen Schrift auf, als die chinesische Standardisierungsbehörde die Kodierung von 956 vorgefertigten tibetischen Silben vorschlug [ 119 ] , diese jedoch vom zuständigen ISO-Komitee ( ISO/IEC JTC 1/SC 2 ) abgelehnt wurden. [ 120 ]
Die Unterstützung des thailändischen Alphabets wurde aufgrund der Anordnung der thailändischen Schriftzeichen kritisiert. Die Vokale เ, แ, โ, ใ, ไ, die links vom vorhergehenden Konsonanten geschrieben werden, folgen einer visuellen und nicht einer phonetischen Reihenfolge, anders als bei den Unicode-Darstellungen anderer indischer Schriften. Diese Komplikation rührt daher, dass Unicode den thailändischen Industriestandard 620 übernommen hat , der auf dieselbe Weise funktionierte und die traditionelle Schreibweise von Thailändisch auf Tastaturen war. Dieses Problem der Zeichenanordnung erschwert die Unicode-Sortierung, da Tabellenzugriffe erforderlich sind, um die thailändischen Zeichen für die Sortierung neu anzuordnen. [ 97 ] Selbst wenn Unicode die Kodierung gemäß der gesprochenen Reihenfolge übernommen hätte, wäre die Sortierung von Wörtern in Wörterbuchreihenfolge weiterhin problematisch. Zum Beispiel beginnt das Wort แสดง[sa dɛːŋ] "perform" mit einem Konsonantencluster "สด" (mit einem inhärenten Vokal für den Konsonanten "ส"), der Vokal แ-, würde in gesprochener Reihenfolge nach dem ด kommen, aber in einem Wörterbuch wird das Wort so eingeordnet, wie es geschrieben ist, wobei der Vokal auf das ส folgt.
Kombination von Charakteren
Zeichen mit diakritischen Zeichen können im Allgemeinen entweder als einzelnes vorgefertigtes Zeichen oder als zerlegte Sequenz aus einem Basisbuchstaben und einem oder mehreren nicht-leerstellenden Zeichen dargestellt werden. Beispielsweise sollten ḗ (vorgefertigtes e mit Makron und Akut darüber) und ḗ (e gefolgt von Makron und Akut darüber) identisch dargestellt werden, also beide als e mit Makron (◌̄) und Akut (◌́). In der Praxis kann ihre Darstellung jedoch je nach verwendeter Rendering-Engine und Schriftart variieren. Auch Unterpunkte , wie sie für die Romanisierung indischer Sprachen benötigt werden , werden oft falsch platziert. Unicode-Zeichen, die vorgefertigten Glyphen zugeordnet sind, können in vielen Fällen verwendet werden, wodurch das Problem vermieden wird. Wenn jedoch kein vorgefertigtes Zeichen kodiert wurde, lässt sich das Problem oft durch die Verwendung einer speziellen Unicode-Schriftart wie Charis SIL lösen, die Graphite- , OpenType- ('gsub') oder AAT- Technologien für erweiterte Rendering-Funktionen nutzt .
Anomalien
Der Unicode-Standard enthält Regeln, die die Stabilität gewährleisten sollen. [ 121 ] Je nach Strenge einer Regel kann eine Änderung verboten oder erlaubt sein. Beispielsweise kann und wird sich der Name eines Codepunkts nicht ändern. Die Skript-Eigenschaft ist jedoch gemäß den Unicode-Regeln flexibler. In Version 2.0 änderte Unicode viele Codepunkt-Namen gegenüber Version 1. Gleichzeitig legte Unicode fest, dass sich ein Codepunkt-Name fortan nicht mehr ändern würde. Dies bedeutet, dass veröffentlichte Fehler nicht korrigiert werden können, selbst wenn sie trivial sind (wie im Fall der Schreibweise BRAKCET statt BRACKET in einem Zeichennamen). 2006 wurde erstmals eine Liste von Anomalien in Zeichennamen veröffentlicht, und im Juni 2021 gab es 104 Zeichen mit identifizierten Problemen, [ 122 ] zum Beispiel:
- U+034F ͏ COMBINING GRAPHEME JOINER : Verbindet keine Grapheme. [ 122 ]
- U+2118 ℘ SCRIPT CAPITAL P : Dies ist ein Kleinbuchstabe. Der Großbuchstabe ist U+1D4AB 𝒫 MATHEMATICAL SCRIPT CAPITAL P . [ 123 ]
- U+A015 ꀕ YI SYLLABLE WU : Dies ist keine Yi-Silbe, sondern ein Yi-Iterationszeichen.
- U+FE18 ︘ PRÄSENTATIONSFORMULAR FÜR VERTIKALE RECHTE WEISSE LENTIKULÄRE KLEMME : Die Klammer ist falsch geschrieben. [ 124 ] (Rechtschreibfehler werden durch die Verwendung von Unicode-Aliasnamen behoben .)
Unicode definiert zwar den Schriftnamen als „ Phags_Pa “, jedoch wird in den Zeichennamen dieser Schrift ein Bindestrich eingefügt: U+A840 ꡀ PHAGS-PA LETTER KA . [ 125 ] [ 126 ] Dies ist jedoch keine Ausnahme, sondern die Regel: Bindestriche werden in Schriftnamen durch Unterstriche ersetzt. [ 125 ]
Siehe auch
- Vergleich der Unicode-Kodierungen
- Internationale Komponenten für Unicode (ICU), jetzt als ICU- TC ein Teil von Unicode
- Liste der Binärcodes
- Liste der Unicode-Zeichen
- Liste der XML- und HTML-Zeichenentitätsreferenzen
- Lotus Multi-Byte Character Set (LMBCS), eine Parallelentwicklung mit ähnlichen Zielen
- Open-Source-Unicode-Schriftarten
- Religiöse und politische Symbole in Unicode
- Standards im Zusammenhang mit Unicode
- Unicode-Symbol
- Universeller codierter Zeichensatz
Anmerkungen
- ^ „Ein Unicode Standard Annex (UAX) ist integraler Bestandteil des Unicode-Standards , wird aber als separates Dokument veröffentlicht.“ [1]
- ^ Das zweistellige Präfix
U+wurde als ASCII-Approximation von U+228E ⊎ MULTISET UNION gewählt . [ 62 ] - ^ Ein Codepunkt ist eine abstrakte Darstellung eines UCS-Zeichens durch eine ganze Zahl zwischen 0 und 1.114.111 (1.114.112 = 2 20 + 2 16 oder 17 × 2 16 = 0x110000 Codepunkte)
- ^ Selten wird das isländische Großbuchstabe eth stattdessen in einem insularen Stil (Ꝺ) geschrieben,wobei der Querstrich auf dem Stamm positioniert ist, insbesondere wenn es vom Großbuchstaben D mit Retroflex unterschieden werden muss (siehe Afrikanisches Referenzalphabet ).
Referenzen
- ^ Der Unicode-Standard, Version 17.0.0 . South San Francisco, Kalifornien: Unicode-Konsortium. 9. September 2025. ISBN 978-1-936213-35-1Die
- ^ „Unicode Technical Report #28: Unicode 3.2“ . Unicode Consortium . 27.03.2002 . Abgerufen am 23.06.2022 .
- ^ Jenkins, John H. (26.08.2021). „Unicode Standard Annex #45: U-source Ideographs“ . Unicode Consortium . §2.2 Das Quellfeld . Abgerufen am 23.06.2022 .
- ^
- "Unicode-Zeichenanzahl V17.0" . Das Unicode-Konsortium. 10.09.2025.
- „Unicode 17.0 Versioned Charts Index“ . Das Unicode-Konsortium. 10.09.2025.
- „Unterstützte Schriftsysteme“ . Das Unicode-Konsortium. 10.09.2025 . Abgerufen am 10.09.2025 .
- ^ „Der Unicode-Standard: Eine technische Einführung“ . 22.08.2019 . Abgerufen am 11.09.2024 .
- ^ „Emoji Counts, v16.0“ . Das Unicode-Konsortium . Abgerufen am 10.09.2024 .
- ^ a b c d e Becker, Joseph D. (10.09.1998) [29.08.1988]. „Unicode 88“ (PDF) . Unicode Consortium . Archiviert (PDF) vom Original am 25.11.2016 . Abgerufen am 25.10.2016 .
1978 machte
Bob Belleville
bei
Xerox PARC
den ersten Vorschlag für einen Satz „Universeller Zeichen“ . Viele Personen trugen Ideen zur Entwicklung eines neuen Kodierungsdesigns bei. Ab 1980 entwickelten sich diese Bemühungen zum
Xerox Character Code Standard
(XCCS), einer mehrsprachigen Kodierung, die seit 1982 von Xerox als interner Unternehmensstandard gepflegt wird. Dies ist dem Engagement von Ed Smura, Ron Pellar und anderen zu verdanken.
Unicode entstand aus acht Jahren praktischer Erfahrung mit XCCS. Die grundlegenden Unterschiede zu XCCS wurden von Peter Fenwick und Dave Opstad (reine 16-Bit-Codes) sowie von
Lee Collins
(Vereinheitlichung ideografischer Zeichen) vorgeschlagen. Unicode behält viele Merkmale von XCCS bei, deren Nutzen sich über Jahre in einer internationalen Reihe mehrsprachiger Kommunikationssysteme bewährt hat.
- ^ a b „Zusammenfassende Erzählung“ . Unicode . 31.08.2006 . Abgerufen am 15.03.2010 .
- ^ „Geschichte der Unicode-Veröffentlichungstermine“ . Unicode . Abgerufen am 20.03.2023 .
- ^ Searle, Stephen J. „Unicode Revisited“ . Abgerufen am 18.01.2013 .
- ^ a b „Die Mitglieder des Unicode-Konsortiums“ . Abgerufen am 12.02.2024 .
- ^ „Unicode Bulldog Award“ . Unicode . Archiviert vom Original am 11.11.2023.
- ^ „Unterstützte Schriftsysteme“ . Unicode . Abgerufen am 09.09.2025 .
- ^ Otung, Ifiok (28.01.2021). Communication Engineering Principles . John Wiley & Sons. S. 12. ISBN 978-1-119-27407-0Die
- ^ „Unicode FAQ“ . Abgerufen am 2. April 2020 .
- ^ „Roadmap zum BMP“ . Unicode-Konsortium . Abgerufen am 30.07.2018 .
- ^ „Roadmaps to Unicode“ . Unicode . Archiviert vom Original am 08.12.2023.
- ^ „Script Encoding Initiative“ . Script Encoding Initiative . Archiviert vom Original am 25.03.2023.
- ^ „Über die Script Encoding Initiative“ . Das Unicode-Konsortium . Abgerufen am 4. Juni 2012 .
- ^ "Zu kodierende Skripte" .
- ^ „Unicode 6.1 Taschenbuch erhältlich“ . announcements_at_unicode.org . Abgerufen am 30.05.2012 .
- ^ „Aufgezählte Versionen des Unicode-Standards“ . Abgerufen am 12.09.2025 .
- ^
- Der Unicode-Standard, Version 1.0.0 . Mountain View, Kalifornien: Das Unicode-Konsortium. Oktober 1991.
- "1.0.0/UnicodeData.txt (rekonstruiert)" . 2004. Abgerufen am 16.03.2010 .
- ^
- Der Unicode-Standard, Version 1.0.1 . Mountain View, Kalifornien: Das Unicode-Konsortium. Juni 1992.
- "Unicode Data 1.0.1" . Abgerufen am 16.03.2010 .
- ^
- Der Unicode-Standard, Version 1.1.5 . Mountain View, Kalifornien: Das Unicode-Konsortium. Juli 1995.
- „Unicode-Daten 1995“ . Abgerufen am 16.03.2010 .
- ^
- Der Unicode-Standard, Version 2.0.0 . Mountain View, Kalifornien: Das Unicode-Konsortium. Juli 1996.
- "Unicode Data-2.0.14" . Abgerufen am 16.03.2010 .
- ^ a b
- Der Unicode-Standard, Version 2.1.2 . Mountain View, Kalifornien: Das Unicode-Konsortium. Mai 1998.
- "Unicode Data-2.1.2" . Abgerufen am 16.03.2010 .
- ^
- Der Unicode-Standard, Version 3.0.0 . Mountain View, Kalifornien: Das Unicode-Konsortium. September 1999.
- "Unicode Data-3.0.0" . Abgerufen am 02.10.2023 .
- ^
- Der Unicode-Standard, Version 3.1.0 . Mountain View, Kalifornien: Das Unicode-Konsortium. März 2001.
- "Unicode Data-3.1.0" . Abgerufen am 2023-10-02 .
- ^
- Der Unicode-Standard, Version 3.2.0 . Mountain View, Kalifornien: Das Unicode-Konsortium. März 2002.
- "Unicode Data-3.2.0" . Abgerufen am 2023-10-02 .
- ^
- Der Unicode-Standard, Version 4.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. April 2003. ISBN 0-321-18578-1Die
- "Unicode Data-4.0.0" . Abgerufen am 2023-10-02 .
- ^
- Der Unicode-Standard, Version 4.1.0 . Mountain View, Kalifornien: Unicode-Konsortium. März 2004. ISBN 0-321-18578-1Die
- "Unicode Data-4.1.0" . Abgerufen am 16.03.2010 .
- ^ „Benannte Sequenzen-4.1.0“ . Unicode . 2005. Abgerufen am 16.03.2010 .
- ^ Der Unicode-Standard, Version 5.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 14.07.2006. ISBN 0-321-48091-0Die
- ^ „Unicode Data 5.0.0“ . Abgerufen am 17.03.2010 .
- ^
- Der Unicode-Standard, Version 5.1.0 . Mountain View, Kalifornien: Unicode-Konsortium. 4. April 2008. ISBN 0-321-48091-0Die
- "Unicode Data 5.1.0" . Abgerufen am 17.03.2010 .
- ^
- Der Unicode-Standard, Version 5.2.0 . Mountain View, Kalifornien: Unicode-Konsortium. 1. Oktober 2009. ISBN 978-1-936213-00-9Die
- "Unicode Data 5.2.0" . Abgerufen am 17.03.2010 .
- ^
- Der Unicode-Standard, Version 6.1.0 . Mountain View, Kalifornien: Unicode-Konsortium. 31.01.2012. ISBN 978-1-936213-02-3Die
- "Unicode Data 6.0.0" . Abgerufen am 11.10.2010 .
- ^ „Unicode 6.0 Emoji-Liste“ . emojipedia.org . Abgerufen am 21.09.2022 .
- ^
- Der Unicode-Standard, Version 6.1.0 . Mountain View, Kalifornien: Unicode-Konsortium. 31.01.2012. ISBN 978-1-936213-02-3Die
- "Unicode Data 6.1.0" . Abgerufen am 31.01.2012 .
- ^
- Der Unicode-Standard, Version 6.2.0 . Mountain View, Kalifornien: Unicode-Konsortium. 26.09.2012. ISBN 978-1-936213-07-8Die
- "Unicode Data 6.2.0" . Abgerufen am 26.09.2012 .
- ^
- Der Unicode-Standard, Version 6.3.0 . Mountain View, Kalifornien: Unicode-Konsortium. 30.09.2013. ISBN 978-1-936213-08-5Die
- „Unicode-Daten 6.3.0“ . Abgerufen am 30.09.2013 .
- ^
- Der Unicode-Standard, Version 7.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 16.06.2014. ISBN 978-1-936213-09-2Die
- "Unicode Data 7.0.0" . Abgerufen am 15.06.2014 .
- ^
- Der Unicode-Standard, Version 8.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 17.06.2015. ISBN 978-1-936213-10-8Die
- "Unicode Data 8.0.0" . Abgerufen am 17.06.2015 .
- ^ Der Unicode-Standard, Version 8.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 17.06.2015. ISBN 978-1-936213-10-8Die
- ^ Der Unicode-Standard, Version 9.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 21.06.2016. ISBN 978-1-936213-13-9Die
- ^
- Der Unicode-Standard, Version 9.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 21.06.2016. ISBN 978-1-936213-13-9Die
- „Unicode-Daten 9.0.0“ . Abgerufen am 21.06.2016 .
- ^ Lobao, Martim (07.06.2016). „Das sind die beiden Emojis, die nicht für Unicode 9 genehmigt wurden, aber von Google trotzdem zu Android hinzugefügt wurden“ . Android Police . Abgerufen am 04.09.2016 .
- ^ Der Unicode-Standard, Version 10.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 20.06.2017. ISBN 978-1-936213-16-0Die
- ^ Der Unicode-Standard, Version 11.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 05.06.2018. ISBN 978-1-936213-19-1Die
- ^ Der Unicode-Standard, Version 12.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 05.03.2019. ISBN 978-1-936213-22-1Die
- ^ „Unicode Version 12.1 wurde zur Unterstützung der Reiwa-Ära veröffentlicht“ . Der Unicode-Blog . Abgerufen am 7. Mai 2019 .
- ^
- Der Unicode-Standard, Version 13.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 10. März 2020. ISBN 978-1-936213-26-9Die
- „Ankündigung des Unicode-Standards, Version 13.0“ . Der Unicode-Blog . Abgerufen am 11. März 2020 .
- ^ „Der Unicode-Standard, Version 13.0 – Kernspezifikation Anhang C“ (PDF) . Unicode-Konsortium . Abgerufen am 11.03.2020 .
- ^
- Der Unicode-Standard, Version 14.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 14.09.2021. ISBN 978-1-936213-29-0Die
- „Ankündigung des Unicode-Standards, Version 14.0“ .
- ^ Der Unicode-Standard, Version 15.0.0 . Mountain View, Kalifornien: Unicode-Konsortium. 13.09.2022. ISBN 978-1-936213-32-0Die
- ^
- Der Unicode-Standard, Version 15.1.0 . South San Francisco, Kalifornien: Unicode-Konsortium. 12.09.2023. ISBN 978-1-936213-33-7Die
- ^ Der Unicode-Standard, Version 16.0.0 . South San Francisco, Kalifornien: Unicode-Konsortium. 10.09.2024. ISBN 978-1-936213-34-4Die
- ^ Der Unicode-Standard, Version 17.0.0 . South San Francisco, Kalifornien: Unicode-Konsortium. 9. September 2025. ISBN 978-1-936213-35-1Die
- ^ „Glossar der Unicode-Begriffe“ . Abgerufen am 16.03.2010 .
- ^ „2.4 Codepunkte und Zeichen“. Der Unicode-Standard Version 16.0 – Kernspezifikation . 2024.
- ^ „3.4 Zeichen und Kodierung“. Der Unicode-Standard, Version 16.0 . 2024.
- ^ „Re: Ursprung der U+nnnn-Notation“ . Unicode Mail List Archive (Mailingliste). 08.11.2005.
- ^ „Anhang A: Notationskonventionen“ . Der Unicode-Standard . Unicode-Konsortium. September 2024.
- ^ „Konformität“ . Der Unicode-Standard (6.0). Mountain View, Kalifornien, USA: Unicode-Konsortium . 3.9 Unicode-Kodierungsformen. ISBN 978-1-936213-01-6
Jede Kodierungsform ordnet die Unicode-Codepunkte U+0000..U+D7FF und U+E000..U+10FFFF zu
. - ^ a b „Unicode Character Encoding Stability Policy“ . Abgerufen am 16.03.2010 .
- ^ „Eigenschaften“ . Abgerufen am 21.09.2025 .
- ^ „Unicode-Zeichenkodierungsmodell“ . Abgerufen am 12.09.2023 .
- ^ „Unicode Named Sequences“ . Abgerufen am 21.09.2025 .
- ^ „Unicode-Namensaliase“ . Abgerufen am 21.09.2025 .
- ^ "JanaSanskritSans" . Archiviert vom Original am 16.07.2011.
- ^ CWA 13873:2000 – Mehrsprachige europäische Teilmengen in ISO/IEC 10646-1 CEN Workshop Agreement 13873
- ^ Kuhn, Markus (1998). „Mehrsprachiger europäischer Zeichensatz 2 (MES-2) – Begründung“ . Universität Cambridge . Abgerufen am 20.03.2023 .
- ^ „DIN 91379:2022-08: Zeichen und definierte Zeichenfolgen in Unicode für die elektronische Verarbeitung von Namen und den Datenaustausch in Europa, mit CD-ROM“ . Beuth Verlag . Abgerufen am 21.08.2022 .
- ^ „UTF-8, UTF-16, UTF-32 & BOM“ . Unicode.org FAQ . Abgerufen am 12.12.2016 .
- ^ Der Unicode-Standard, Version 6.2 . Das Unicode-Konsortium. 2013. S. 561. ISBN 978-1-936213-08-5Die
- ^ Davis, Mark (05.05.2008). „Umstellung auf Unicode 5.1“ . Offizieller Google-Blog . Archiviert vom Original am 01.04.2025 . Abgerufen am 12.04.2025 .
- ^ „Nutzungsumfrage zu Zeichenkodierungen, aufgeschlüsselt nach Rangfolge“ . W3Techs . Abgerufen am 12.04.2025 .
- ^ „Nutzungsstatistik von US-ASCII für Websites“ . W3Techs . Abgerufen am 1. November 2020 .
- ^ B. Curtin (Juli 1999). Internationalisierung des File Transfer Protocol . IETF . doi : 10.17487/RFC2640 . RFC 2640. Abgerufen am 12. April 2025 .
- ^ H. Alvestrand (Januar 1998). IETF Policy on Character Sets and Languages . IETF . doi : 10.17487 /RFC2277 . BCP 18. RFC 2277. Archiviert vom Original am 23.01.2023 . Abgerufen am 12.04.2025 .
- ^ Pike, Rob (30.04.2003). „UTF-8 Geschichte“ .
- ^ „ISO/IEC JTC1/SC 18/WG 9 N“ (PDF) . Archiviert (PDF) vom Original am 22.01.2025 . Abgerufen am 12.04.2025 .
- ^ Hedley, Jonathan (2009). „Unicode Lookup“ . Archiviert vom Original am 30.03.2025 . Abgerufen am 12.04.2025 .
- ^ Milde, Benjamin (2025). „Unicode-Zeichenerkennung“ . Archiviert vom Original am 02.04.2025.
- ^ J. Klensin; Y. Ko (Juli 2007). Überblick und Rahmen für internationalisierte E-Mails . IETF . doi : 10.17487/RFC4952 . RFC 4952 . Abgerufen am 17.08.2022 .
- ^ J. Klensin; Y. Ko (Februar 2012). Überblick und Rahmen für internationalisierte E-Mails . IETF . doi : 10.17487/RFC6530 . RFC 6530 . Abgerufen am 17.08.2022 .
- ^ J. Yao; W. Mao (Februar 2012). SMTP-Erweiterung für internationalisierte E-Mails . IETF . doi : 10.17487/RFC6531 . RFC 6531. Abgerufen am 17.08.2022 .
- ^ A. Yang; S. Steele; N. Freed (Februar 2012). Internationalisierte E-Mail-Header . IETF . doi : 10.17487/RFC6532 . RFC 6532. Abgerufen am 17.08.2022 .
- ^ C. Newman; A. Gulbrandsen; A. Melnikov (Juni 2008). Internet Message Access Protocol Internationalization . IETF . doi : 10.17487/RFC5255 . RFC 5255. Abgerufen am 17.08.2022 .
- ^ R. Gellens; C. Newman (Februar 2010). POP3-Unterstützung für UTF-8 . IETF . doi : 10.17487/RFC5721 . RFC 5721. Abgerufen am 17.08.2022 .
- ^ Wood, Alan (13.09.2005). „Einrichten von Windows Internet Explorer 5, 5.5 und 6 für die Unterstützung von mehreren Sprachen und Unicode: Optionen zum Aktivieren von Unicode in Internet Explorer 5, 5.5 und 6: Schriftarten (IE 5, 5.5 und 6) “ . Alan Wood. Archiviert vom Original am 20.01.2025 . Abgerufen am 12.04.2025 .
- ^ „Extensible Markup Language (XML) 1.1 (Zweite Ausgabe)“ . World Wide Web Consortium . 29.09.2006. Archiviert vom Original am 05.04.2025 . Abgerufen am 12.04.2025 .
- ^ Bigelow, Charles; Holmes, Kris (September 1993). „The design of a Unicode font“ (PDF) . Electronic Publishing . 6 (3): 292. ISSN 0894-3982 . Archiviert (PDF) vom Original am 16.02.2025 . Abgerufen am 12.04.2025 .
- ^ „FAQs: Schriftarten und Tastaturen: Schriftarten und Unicode “ . Unicode-Konsortium . Archiviert vom Original am 06.03.2025 . Abgerufen am 12.04.2025 .
- ^ Eine kurze Geschichte der Zeichencodes , Steven J. Searle, ursprünglich verfasst 1999 , zuletzt aktualisiert 2004
- ^ a b „Anhang E: Han-Vereinigungsgeschichte“ . Der Unicode-Standard Version 16.0 – Kernspezifikation . Unicode-Konsortium . 2024.
- ^ a b Topping, Suzanne (25.06.2013). „Das geheime Leben von Unicode“ . IBM . Archiviert vom Original am 25.06.2013 . Abgerufen am 20.03.2023 .
- ^ Lu, Qin (08.06.2015). „Der vorgeschlagene Zeichensatz für Hongkong“ (PDF) . ISO/IEC JTC1 / SC2 /WG2/ IRG N2074.
- Wittern , Christian (1995-05-01). „Chinesische Zeichencodes: ein Update“ . Internationales Forschungsinstitut für Zen-Buddhismus / Hanazono-Universität . Archiviert vom Original am 12.10.2004.
- ^ "Noto CJK-Schriftarten" . Noto Fonts. 18.02.2023.
Wählen Sie dieses Bereitstellungsformat, wenn Ihr System variable Schriftarten unterstützt und Sie bevorzugt nur eine Sprache verwenden möchten, aber auch die vollständige Zeichenabdeckung oder die Möglichkeit wünschen, Text mit Sprachkennzeichnungen zu versehen, um Glyphen zu verwenden, die für die anderen Sprachen geeignet sind (dies erfordert eine Anwendung, die Sprachkennzeichnung und die OpenType-Funktion 'locl' GSUB unterstützt).
- ^ Preuss, Ingo. „OpenType-Funktion: locl – Lokalisierte Formulare“ . preusstype.com .
- ^ „Eigenschaften der Groß-/Kleinschreibung“ . Unicode-Zeichendatenbank . Unicode-Konsortium . 30.07.2025.
- ^ a b „Optionen für reguläre Ausdrücke § Vergleich mit der invarianten Kultur“ . .NET -Grundlagendokumentation . Microsoft . 12.05.2023.
- ^ "confusablesSummary.txt" . Unicode-Sicherheitsmechanismen für UTS #39 . Unicode-Konsortium . 11.08.2023.
- ^ „UTR #36: Unicode-Sicherheitsüberlegungen“ . Unicode .
- ^ Boucher, Nicholas; Shumailov, Ilia; Anderson, Ross; Papernot, Nicolas (2022). „Bad Characters: Imperceptible NLP Attacks“. 2022 IEEE Symposium on Security and Privacy (SP) . San Francisco, CA, USA: IEEE. S. 1987–2004 . arXiv : 2106.09898 . doi : 10.1109 /SP46214.2022.9833641 . ISBN 978-1-66541-316-9. S2CID 235485405 .
- ^ Engineering, Spotify (18.06.2013). „Kreative Benutzernamen und Spotify-Kontoübernahme“ . Spotify Engineering . Abgerufen am 15.04.2023 .
- ^ Wheeler, David A. (2020). Erste Analyse von manipuliertem Quellcode (Technischer Bericht). S. 4–1–4–10. JSTOR resrep25332.7 .
- ^ „UTR #36: Unicode-Sicherheitsüberlegungen“ . Unicode . Abgerufen am 27.06.2022 .
- ^ Boucher, Nicholas; Anderson, Ross. „Trojan Source: Invisible Vulnerabilities“ (PDF) . Abgerufen am 2. November 2021 .
- ^ „Visual Studio Code Oktober 2021“ . code.visualstudio.com . Abgerufen am 11.11.2021 .
- ^ Dittert, Dominique (06.09.2024). „Von Unicode zur Sicherheitslücke: Die Sicherheitsrisiken überlanger UTF-8-Kodierungen“ . Abgerufen am 26.12.2024 .
- ^ Boone, Kevin. „UTF-8 und das Problem überlanger Zeichen“ . Abgerufen am 26.12.2024 .
- ^ AFII-Beitrag über WAVE DASH , „Eine herstellerspezifische Unicode-Zeichentabelle für Japanisch“ . 22.04.2011. Archiviert vom Original am 22.04.2011 . Abgerufen am 20.05.2019 .
- ^ ISO 646-* Problem archiviert am 23.04.2019 in der Wayback Machine , Abschnitt 4.4.3.5 von „ Introduction to I18n“ , Tomohiro Kubota, 2001
- ^ „Arabische Präsentationsformen-A“ (PDF) . Abgerufen am 20.03.2010 .
- ^ „Arabische Präsentationsformen-B“ (PDF) . Abgerufen am 20.03.2010 .
- ^ „Alphabetische Präsentationsformulare“ (PDF) . Abgerufen am 20.03.2010 .
- ^ "Vorschlag zur Kodierung tibetischer BrdaRten-Zeichen für ISO/IEC 10646 in BMP" (PDF) . 2002-12-02.
- ^ Umamaheswaran, VS (07.11.2003). „Resolutionen der WG 2 Sitzung 44“ (PDF) . Resolution M44.20.
- ^ „Stabilität der Zeichenkodierung“ . Unicode . Archiviert vom Original am 1. Januar 2024.
- ^ a b „Unicode Technical Note #27: Known Anomalies in Unicode Character Names“ . Unicode . 14.06.2021.
- ^"Unicode chart: "actually this has the form of a lowercase calligraphic p, despite its name""(PDF).
- ^"Misspelling of BRACKET in character name is a known defect"(PDF).
- ^ ab"Unicode Standard Annex #24: Unicode Script Property". The Unicode Consortium. 2021. 2.2 Relation to ISO 15924 Codes. Retrieved 2022-04-29.
- ^"Scripts.txt". The Unicode Consortium. 2025. Retrieved 2025-09-21.
Further reading
- Julie D. Allen. The Unicode Standard, Version 6.0, The Unicode Consortium, Mountain View, 2011, ISBN 9781936213016, (Unicode 6.0.0).
- The Complete Manual of Typography, James Felici, Adobe Press; 1st edition, 2002. ISBN 0-321-12730-7
- The Unicode Standard, Version 3.0, The Unicode Consortium, Addison-Wesley Longman, Inc., April 2000. ISBN 0-201-61633-5
- The Unicode Standard, Version 4.0, The Unicode Consortium, Addison-Wesley Professional, 27 August 2003. ISBN 0-321-18578-1
- The Unicode Standard, Version 5.0, Fifth Edition, The Unicode Consortium, Addison-Wesley Professional, 27 October 2006. ISBN 0-321-48091-0
- Unicode Demystified: A Practical Programmer's Guide to the Encoding Standard, Richard Gillam, Addison-Wesley Professional; 1st edition, 2002. ISBN 0-201-70052-2
- Unicode Explained, Jukka K. Korpela, O'Reilly; 1st edition, 2006. ISBN 0-596-10121-X
- Unicode: A Primer, Tony Graham, M&T books, 2000. ISBN 0-7645-4625-2.
- Haralambous, Yannis; Martin Dürst (2019). "Unicode from a Linguistic Point of View". In Haralambous, Yannis (ed.). Proceedings of Graphemics in the 21st Century, Brest 2018. Brest: Fluxus Editions. pp. 167–183. doi:10.36824/2018-graf-hara1. ISBN 978-2-9570549-1-6.
External links
- Unicode, Inc.
- Alan Wood's Unicode Resources – contains lists of word processors with Unicode capability; fonts and characters are grouped by type; characters are presented in lists, not grids.
- Unicode BMP Fallback Font – zeigt den Unicode 6.1-Wert eines beliebigen Zeichens in einem Dokument an, auch im Bereich für die private Nutzung, anstatt des Glyphen selbst.
- Die Schriftsysteme der Welt , alle 293 bekannten Schriftsysteme mit ihrem Unicode-Status (128 sind Stand Juni 2024 noch nicht kodiert)