In den 2020er Jahren warf der rasante Fortschritt von auf Deep Learning basierenden generativen KI- Modellen Fragen zum Urheberrechtsstatus KI-generierter Werke auf und insbesondere dazu, ob bei deren Training oder Verwendung Urheberrechtsverletzungen vorliegen. Dies betrifft unter anderem Text-zu-Bild-Modelle wie Stable Diffusion und große Sprachmodelle wie ChatGPT . Moderne große Sprachmodelle werden mit allen aus dem Internet verfügbaren Daten trainiert , wobei häufig urheberrechtlich geschütztes Material zum Einsatz kommt. [ 1 ] Im Jahr 2023 waren in den USA mehrere Klagen anhängig, die die Verwendung urheberrechtlich geschützter Daten zum Training von KI-Modellen in Frage stellten. Die Beklagten argumentierten, dies falle unter die Fair-Use-Regelung . [ 2 ]
Urheberrechtsstatus von KI-generierten Werken

Da die meisten Rechtsordnungen das Urheberrecht nur für Originalwerke menschlicher Urheber gewähren, ist die Definition von Originalität von zentraler Bedeutung für den urheberrechtlichen Status von KI-generierten Werken. [ 3 ]
Vereinigte Staaten
Die Urheberrechtsklausel besagt:
Der Kongress hat die Befugnis, ... den Fortschritt der nützlichen Künste zu fördern, indem er den Autoren für eine begrenzte Zeit das ausschließliche Recht an ihren jeweiligen Werken sichert.
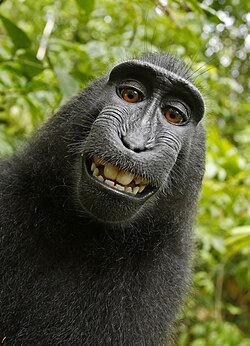
Der US-Kongress und die Bundesgerichte haben diese Klausel so ausgelegt, dass sie sich auf Werke beschränkt, die „von einem Menschen geschaffen wurden“ [ 4 ], und lehnen es ab, Werken, die ohne menschliches Zutun entstanden sind, Urheberrechte zu gewähren. [ 5 ] Einige Juristen vermuten, dass der Fall Naruto v. Slater (2018), in dem das 9. US-Berufungsgericht entschied, dass Nicht-Menschen keine Urheberrechte an künstlerischen Werken besitzen können , ein potenzieller Präzedenzfall für Urheberrechtsstreitigkeiten über Werke sein könnte, die durch generative KI geschaffen wurden. [ 6 ] Es wurde auch die Ansicht vertreten, dass bestimmte KI-Generationen in den USA und ähnlichen Rechtsordnungen urheberrechtlich geschützt sein könnten, wenn nachgewiesen werden kann, dass der Mensch, der das KI-Programm ausgeführt hat, bei der Auswahl der Eingaben für die KI oder bei der Bearbeitung der KI-Ausgabe ausreichend Originalität bewiesen hat. [ 5 ] [ 4 ]
Befürworter dieser Ansicht argumentieren, dass ein KI-Modell lediglich als Werkzeug (ähnlich einem Stift oder einer Kamera) betrachtet werden kann, das der menschliche Anwender nutzt, um seine kreative Vision auszudrücken. [ 4 ] [ 7 ] Beispielsweise führen sie an, dass, wenn der Standard der Originalität durch das Drücken des Auslösers einer Kamera erfüllt werden kann, Künstler, die generative KI verwenden, möglicherweise eine ähnliche Anerkennung verdienen, insbesondere wenn sie mehrere Überarbeitungsrunden durchlaufen, um ihre Vorgaben an die KI zu verfeinern. [ 8 ] Andere Befürworter argumentieren, dass das Urheberrechtsamt keinen technologieneutralen Ansatz hinsichtlich der Verwendung von KI oder algorithmischen Werkzeugen verfolgt. Bei anderen kreativen Ausdrucksformen (Musik, Fotografie, Literatur) besteht der Test im Wesentlichen darin, ob es sich um eine minimale , also begrenzte menschliche Kreativität handelt. Für Werke, die KI-Werkzeuge verwenden, hat das Urheberrechtsamt einen anderen Test angewendet, nämlich ob der technologische Eingriff nicht über ein Minimum hinausgeht . [ 9 ]

Dieser unterschiedliche Ansatz zeigt sich in der jüngsten Entscheidung bezüglich eines Registrierungsantrags von Jason Matthew Allen für sein Werk „ Théâtre D'opéra Spatial“, das mit Midjourney und einem Upscaling-Tool erstellt wurde. Das Copyright Office erklärte:
Der Vorstand stellt fest, dass das Werk mehr als nur geringfügige, von künstlicher Intelligenz („KI“) generierte Inhalte enthält, und dass diese Inhalte daher in einem Registrierungsantrag offengelegt werden müssen. Da Herr Allen nicht bereit ist, auf das KI-generierte Material hinzuweisen, kann das Werk in der eingereichten Form nicht registriert werden. [ 10 ]
Da KI zunehmend zur Erstellung von Literatur, Musik und anderen Kunstformen eingesetzt wird, hat das US-amerikanische Urheberrechtsamt neue Richtlinien veröffentlicht, die die Frage klären, ob Werke, einschließlich von künstlicher Intelligenz generierter Materialien, als „mechanische Reproduktionen“ einzustufen sind oder die „Manifestation der eigenen schöpferischen Vorstellung des Urhebers“ darstellen. [ 11 ] Das US-amerikanische Urheberrechtsamt veröffentlichte im März 2023 eine Regelung zu verschiedenen Fragen im Zusammenhang mit der Nutzung von KI, in der es Folgendes feststellte:
Da das Amt jedes Jahr etwa eine halbe Million Registrierungsanträge erhält, erkennt es neue Trends in der Registrierungstätigkeit, die eine Änderung oder Erweiterung der in einem Antrag anzugebenden Informationen erforderlich machen können.
Eine dieser jüngsten Entwicklungen ist der Einsatz hochentwickelter Technologien der künstlichen Intelligenz (KI), die ausdrucksstarke Inhalte erzeugen können. Diese Technologien werden anhand großer Mengen bereits existierender, von Menschen verfasster Werke trainiert und nutzen die daraus gewonnenen Erkenntnisse, um neue Inhalte zu generieren. Einige Systeme reagieren auf textuelle Anweisungen des Nutzers, sogenannte „Prompts“.
Das Ergebnis kann textuell, visuell oder auditiv sein und wird von der KI anhand ihrer Architektur und des Trainingsmaterials bestimmt. Diese Technologien, oft als „generative KI“ bezeichnet, werfen Fragen auf, ob das von ihnen erzeugte Material urheberrechtlich geschützt ist, ob Werke, die sowohl von Menschen erstelltes als auch von KI generiertes Material enthalten, registriert werden können und welche Informationen Anmelder dem Amt übermitteln müssen, um sie registrieren zu lassen. [ 12 ]
Das Copyright Office stellte im Januar 2025 klar, dass KI-gestützte Werke, in denen der kreative Ausdruck des Menschen erkennbar bleibt, urheberrechtlich geschützt werden können. Dies umfasst die kreative Anpassung von Vorgaben für KI-Generatoren oder die Nutzung von KI zur Unterstützung des Entstehungsprozesses eines Werkes, beispielsweise beim Filmemachen . [ 13 ] Werke, „deren Ausdruckselemente von einer Maschine bestimmt werden“, sind weiterhin nicht urheberrechtlich geschützt. [ 14 ] In Anlehnung an diese Richtlinie registrierte das Copyright Office im Januar 2025 „A Single Piece of American Cheese“, das erste visuelle Kunstwerk, das ausschließlich aus KI-generierten Ergebnissen besteht, als Kompositionswerk. [ 15 ] Die Begründung für den Urheberrechtsschutz lag in der Argumentation, dass die vom Menschen im kreativen Prozess eines einzelnen Werkes vorgenommene Auswahl, Anordnung und Koordination eine ausreichende menschliche Urheberschaft darstellt, um den Urheberrechtsschutz zu begründen.
Sowohl das Bundesgericht als auch das Berufungsgericht im District of Columbia bestätigten die Weigerung des Copyright Office, Urheberrechte für ausschließlich maschinell erzeugte Werke zu registrieren, und stellten fest, dass das Eigentum an Maschinen mit den im Copyright Act von 1975 verankerten Erbrechten kollidieren würde. [ 16 ] Stand März 2026 lehnte der Oberste Gerichtshof der Vereinigten Staaten die Anhörung von Klagen gegen die Entscheidung des Copyright Office ab. [ 17 ]
Das US-Patent- und Markenamt (USPTO) kodifizierte im Februar 2024 ähnliche Beschränkungen für die Patentierbarkeit von Patenten, die ausschließlich KI-Autoren zugeschrieben werden, nach einem Urteil im Fall Thaler gegen Perlmutter vom August 2023. In diesem Fall verweigerte das Patentamt die Erteilung von Patenten, die durch Stephen Thalers KI-Programm DABUS entstanden waren, da in der Liste der Erfinder keine natürliche Person aufgeführt war. Das US-Berufungsgericht für den Bundesbezirk bestätigte diese Entscheidung. [ 18 ] [ 19 ] In der nachfolgenden Regelung erlaubt das USPTO menschlichen Erfindern die Einbeziehung der Ergebnisse künstlicher Intelligenz, sofern diese Methode in der Patentanmeldung entsprechend dokumentiert ist. [ 20 ] Dies kann jedoch praktisch unmöglich werden, wenn die Funktionsweise und die Anwendung von KI in erfinderischen Prozessen nicht ausreichend verstanden oder weitgehend unbekannt sind. [ 19 ]
Der Abgeordnete Adam Schiff brachte im April 2024 den „Generative AI Copyright Disclosure Act“ ein . Sollte der Gesetzentwurf verabschiedet werden, wären KI-Unternehmen verpflichtet, urheberrechtlich geschützte Werke beim Urheberrechtsregister einzureichen , bevor sie neue generative KI-Systeme veröffentlichen. Diese Unternehmen müssten die Dokumente 30 Tage vor der öffentlichen Präsentation ihrer KI-Tools einreichen. [ 21 ]
Vereinigtes Königreich
Andere Rechtsordnungen enthalten explizite gesetzliche Bestimmungen in Bezug auf computergenerierte Werke, darunter das britische Urheberrechtsgesetz (Copyright, Designs and Patents Act 1988) , in dem Folgendes festgelegt ist:
Bei einem computergenerierten literarischen, dramatischen, musikalischen oder künstlerischen Werk gilt als Urheber die Person, die die für die Erstellung des Werkes notwendigen Vorkehrungen trifft. [ 7 ]
Das britische Recht für computergenerierte Werke bezieht sich jedoch auf autonome Schöpfungen von Computerprogrammen. Personen, die KI-Werkzeuge verwenden, sind in der Regel die Urheber der Werke, sofern sie die Mindestanforderungen für ein urheberrechtlich geschütztes Werk erfüllen. Die für computergenerierte Werke verwendete Formulierung bezieht sich im Hinblick auf KI auf die Möglichkeit der menschlichen Programmierer, das Urheberrecht an den autonomen Produktionen der KI-Werkzeuge zu besitzen (d. h. wenn kein direkter menschlicher Eingriff erfolgt).
Da jedes einzelne Bild ein computergeneriertes Werk ist, wurden die für die Erstellung des Werkes notwendigen Vorkehrungen von Herrn Jones getroffen, da er das Erscheinungsbild der verschiedenen Spielelemente sowie die Regeln und die Logik der Bildgenerierung entworfen und das entsprechende Computerprogramm geschrieben hat. Unter diesen Umständen bin ich davon überzeugt, dass Herr Jones die Person ist, die die für die Erstellung der Werke notwendigen Vorkehrungen getroffen hat, und daher gemäß § 9 Abs. 3 als Urheber gilt [ 22 ].
Die britische Regierung hat die Nutzung generativer Werkzeuge und KI im Hinblick auf geistiges Eigentum konsultiert und einen speziellen Verhaltenskodex vorgeschlagen: [ 23 ] „um KI-Unternehmen den Zugang zu urheberrechtlich geschützten Werken als Input für ihre Modelle zu erleichtern und gleichzeitig den Schutz der generierten Ergebnisse zum Schutz der Rechteinhaber zu gewährleisten.“ [ 24 ] Im Oktober 2023 veröffentlichte das US-amerikanische Copyright Office im Anschluss an seine Registrierungsrichtlinien für 2023 eine Bekanntmachung mit einer Anfrage und einer Bitte um Stellungnahme. [ 25 ]
China
Am 27. November 2023 fällte das Pekinger Internetgericht in einem Rechtsstreit ein Urteil, das das Urheberrecht an KI-generierten Bildern anerkannte. [ 26 ]
Wie ein Anwalt und KI-Kunstschaffender feststellte, besteht die Herausforderung für Urheberrechtsbehörden, Gesetzgeber und Gerichte darin, menschliche Kreativität technologieneutral zu schützen und gleichzeitig die Risiken automatisierter KI-Produktionsstätten zu berücksichtigen. KI-Tools können autonom eine Vielzahl von Materialien erstellen, die potenziell dem Urheberrecht (Musik, Blogs, Gedichte, Bilder und Fachartikel) oder anderen Rechten des geistigen Eigentums (Patente und Designrechte) unterliegen. [ 9 ]
KI mit urheberrechtlich geschützten Daten trainieren
Deep-Learning-Modelle beziehen große Datensätze aus dem Internet, wie beispielsweise öffentlich verfügbare Bilder und Webseitentexte. Text und Bilder werden anschließend in numerische Formate umgewandelt , die die KI analysieren kann. Ein Deep-Learning-Modell identifiziert Muster, die die kodierten Text- und Bilddaten verknüpfen, und lernt, welche Textkonzepte Elementen in Bildern entsprechen. Durch wiederholtes Testen verbessert das Modell seine Genauigkeit, indem es Bilder Textbeschreibungen zuordnet. Das trainierte Modell wird validiert, um seine Fähigkeit zu bewerten, neue Bilder ausschließlich anhand der nach dem Trainingsprozess bereitgestellten Textvorgaben zu generieren oder zu bearbeiten. [ 27 ] Wenn die Zusammenstellung dieser Trainingsdatensätze das Kopieren urheberrechtlich geschützter Werke beinhaltet, stellt sich die Frage, ob dieser Prozess das ausschließliche Recht des Urheberrechtsinhabers auf Vervielfältigung seiner Werke verletzt oder ob er unter die Bestimmungen des Fair Use fällt . [ 28 ] [ 29 ]
Vereinigte Staaten
US-amerikanische Entwickler von maschinellem Lernen gingen traditionell davon aus, dass dies unter die Fair-Use-Regelung falle, da die Nutzung urheberrechtlich geschützter Werke transformativ und begrenzt sei. [ 5 ] Die Situation wurde mit dem Scannen urheberrechtlich geschützter Bücher durch Google Books im Fall Authors Guild, Inc. gegen Google, Inc. verglichen , das letztendlich als Fair Use eingestuft wurde, da die gescannten Inhalte nicht öffentlich zugänglich gemacht wurden und die Nutzung nicht-expressiv war. [ 30 ]
Timothy B. Lee argumentiert in Ars Technica , dass ein Erfolg der Kläger das Machtverhältnis zugunsten großer Konzerne wie Google, Microsoft und Meta verschieben könnte, die es sich leisten können, große Mengen an Trainingsdaten von Urheberrechtsinhabern zu lizenzieren und ihre eigenen Datensätze nutzergenerierter Daten zu nutzen. [ 30 ] Die IP- Experten Bryan Casey und Mark Lemley argumentieren in der Texas Law Review, dass die Datensätze so groß seien, dass es „keine plausible Option gibt, einfach alle [Daten...] zu lizenzieren. Daher käme die Zulassung von Urheberrechtsansprüchen [für generatives Training] einer Aussage gleich, dass die Nutzung überhaupt nicht erlaubt sein wird, nicht dass die Urheberrechtsinhaber bezahlt werden.“ [ 31 ] Andere Wissenschaftler widersprechen; einige prognostizieren ein ähnliches Ergebnis wie bei den US-amerikanischen Musiklizenzierungsverfahren . [ 5 ]
Einer der ersten Fälle, in denen die Frage der zulässigen Nutzung für das Training von KI in Frage gestellt wurde, war eine Klage von Thomson Reuters gegen Ross Intelligence aus dem Jahr 2020. Thomson Reuters argumentierte, Ross Intelligence habe ihre Westlaw -Headnotes – kurze Zusammenfassungen von Gerichtsentscheidungen – zum Training ihrer KI-Engine verwendet, die mit Westlaw konkurrieren sollte. Richter Stephanos Bibas vom Dritten Bundesberufungsgericht wies die Klage von Thomson Reuters zunächst mit der Begründung ab, Headnotes seien möglicherweise nicht urheberrechtlich geschützt. Im Februar 2025 revidierte Bibas seine Entscheidung jedoch und fällte ein Urteil zugunsten von Thomson Reuters. Er erklärte Headnotes für urheberrechtlich geschützt und urteilte, Ross Intelligence, das 2021 seinen Betrieb eingestellt hatte, habe das Material unrechtmäßig verwendet. Im Fall der KI von Ross war die Engine nicht generativ und erzeugte Ergebnisse, die sich aus Teilen von Westlaw-Material zusammensetzten, was Thomson Reuters' Behauptung der Wiederverwendung stützte. Daher ist unklar, inwieweit der Fall auf generative KI wie OpenAI anwendbar ist. [ 32 ]
In einem Sammelverfahren mehrerer Autoren gegen Meta und OpenAI äußerte Bundesrichter Vince Chhabria Zweifel daran, ob die Verwendung nicht lizenzierten urheberrechtlich geschützten Materials für das Training von KI unter die Fair-Use-Regelung fallen würde. Während der Gerichtsverhandlung gegenüber Metas Anwälten erklärte er: „Unternehmen verwenden urheberrechtlich geschütztes Material, um ein Produkt zu entwickeln, das unzählige Konkurrenzprodukte hervorbringen kann. Sie verändern, man könnte sogar sagen, Sie zerstören den Markt für die Arbeit dieser Person dramatisch und behaupten, dafür nicht einmal eine Lizenzgebühr zahlen zu müssen. Ich verstehe einfach nicht, wie das eine Fair-Use-Regelung sein kann.“ [ 33 ] Chhabria erließ im Juni 2025 ein summarisches Urteil zugunsten von Meta, allerdings lediglich aufgrund des fehlenden Nachweises eines ausreichenden Schadens durch die Ergebnisse, die Metas LLM-Training hervorbringen könnte. Daher befand er, dass Metas Verwendung der Werke der Autoren unter die Fair-Use-Regelung falle. Chhabria betonte jedoch, dass sein Urteil nicht bedeute, dass jegliche Verwendung urheberrechtlich geschützten Materials durch Meta unter die Fair-Use-Regelung falle. [ 34 ]
In einem ähnlichen Fall verklagten mehrere Autoren, darunter Andrea Bartz , Charles Graeber und Kirk Wallace Johnson , Anthropic im August 2024 wegen der Verwendung ihrer Werke zum Trainieren ihres KI-Modells. Einige dieser Werke waren Teil der „Pile“ , einer Sammlung von Open-Source- und gemeinfreien Werken, die zeitweise auch urheberrechtlich geschützte Werke enthielt, diese aber inzwischen entfernt hatte. Anthropic bestätigte die Nutzung der „Pile“, erwarb aber auch legal Bücher und digitalisierte diese anschließend für Trainingszwecke. [ 35 ] Richter William Alsup gab einem summarischen Urteil zugunsten von Anthropic statt und bestätigte, dass die Verwendung der erworbenen Bücher für das Training unter die Fair-Use-Regelung fiel. Die Verwendung der „Pile“ mit nicht lizenzierten Werken hingegen nicht, weshalb ein separates Verfahren zur Feststellung des Schadensersatzes angesetzt wurde. [ 36 ] Anthropic bot im August 2025 einen Vergleich in dieser Angelegenheit an und war bereit, den Autoren 1,5 Milliarden US-Dollar zu zahlen, was etwa 3.000 US-Dollar pro betroffenem Autor (ca. 500.000) entsprach. Dies wäre die höchste jemals in den Vereinigten Staaten gezahlte Entschädigung im Zusammenhang mit Urheberrechtsverletzungen gewesen. [ 37 ] [ 38 ] Alsup lehnte die Einigung wegen Mängeln in den Einigungsdetails ab, die den Autoren „aufgezwungen“ werden sollten. [ 39 ]
Das US-amerikanische Urheberrechtsamt veröffentlichte einen Bericht, der unter anderem öffentliche Stellungnahmen zu KI-Themen auswertete. Der Bericht befasste sich unter anderem mit Bedenken hinsichtlich der zulässigen Nutzung von Trainingsmaterialien und wies auf zwei Faktoren hin, die für die zulässige Nutzung relevant sein könnten. Zum einen betraf der Bericht Zweck und Art des erstellten Werkes. Das Amt verwies dabei auf die Entscheidung des Obersten Gerichtshofs im Fall Andy Warhol Foundation for the Visual Arts, Inc. gegen Goldsmith, wonach Werke trotz erfolgter Transformation letztlich als abgeleitete Werke des ursprünglichen Urheberrechts gelten. Zum anderen betraf der Bericht die Auswirkungen auf den kommerziellen Markt. Das Amt gab an, dass KI-Modelle, die mit urheberrechtlich geschützten Daten trainiert werden, um Werke in einem bestimmten Stil zu erzeugen, negative Auswirkungen auf den Markt haben und somit die Rechtfertigung für die zulässige Nutzung schwächen könnten. [ 40 ]
EU
In der EU sind solche Ausnahmen für Text- und Data-Mining (TDM) Bestandteil der Richtlinie 2019 über das Urheberrecht im digitalen Binnenmarkt . [ 41 ] Sie werden im EU- KI-Gesetz (in Kraft getreten 2024) explizit erwähnt, was weithin als klares Indiz dafür gewertet wird, dass die Ausnahme auch die Datenerhebung im Zusammenhang mit KI umfasst. Diese Auffassung wurde auch in einem Urteil eines deutschen Gerichts aus dem Jahr 2024 bestätigt. [ 42 ] Anders als die TDM-Ausnahme für wissenschaftliche Forschung gilt die allgemeinere Ausnahme für kommerzielle KI nur, wenn der Urheberrechtsinhaber nicht widersprochen hat. [ 42 ] Um den Widerspruch gegen die TDM-Ausnahme zu erleichtern, verpflichtet das EU-KI-Gesetz von 2024 Anbieter von KI-Modellen für allgemeine Zwecke, eine Richtlinie zur Einhaltung des EU-Rechts (einschließlich des Widerspruchs gegen die TDM-Ausnahme) zu implementieren und eine detaillierte Zusammenfassung der Trainingsinhalte gemäß einer vom KI-Amt bereitgestellten Vorlage zu veröffentlichen. Diese Bestimmungen treten im August 2025 in Kraft. Weitere Klarstellungen darüber, was genau von Anbietern allgemeiner KI-Modelle verlangt wird, werden voraussichtlich in einem Verhaltenskodex enthalten sein, der im Vorfeld veröffentlicht wird. [ 43 ]
Vereinigtes Königreich
Im Gegensatz zur EU verbietet das Vereinigte Königreich Data-Mining zu kommerziellen Zwecken, hat aber vorgeschlagen, dies zu ändern, um die Entwicklung von KI zu fördern: „Für Text- und Data-Mining planen wir die Einführung einer neuen Ausnahmeregelung für Urheberrecht und Datenbanken, die TDM für jeden Zweck erlaubt. Rechteinhaber werden weiterhin Schutzmaßnahmen für ihre Inhalte haben, einschließlich der Anforderung eines rechtmäßigen Zugriffs.“ [ 24 ]
Indien
Das indische Urheberrecht sieht Ausnahmen für die faire Nutzung im Rahmen der wissenschaftlichen Forschung vor, enthält jedoch keine spezifischen Bestimmungen für kommerzielle KI-Trainingsmodelle. Anders als die EU und Großbritannien hat Indien keine TDM-Vorschriften (Technical Data Management) eingeführt, die kommerzielle KI-Systeme explizit regeln. Diese regulatorische Unsicherheit wurde 2024 deutlich, als Asian News International (ANI) OpenAI wegen der unbefugten Nutzung ihrer Inhalte zum Trainieren von KI-Modellen verklagte. Obwohl OpenAI eine Opt-out-Option anbot, die ANI im Oktober 2024 nutzte, um KI- Scraper zu blockieren , argumentierte ANI, diese Maßnahme sei wirkungslos, da ihre Inhalte weiterhin über Content-Syndication verfügbar seien . Der Fall verdeutlichte auch die Herausforderungen der Zuständigkeit, da OpenAI argumentierte, nicht dem indischen Recht zu unterliegen, weil sich ihre Server und Trainingsanlagen außerhalb des Landes befänden. [ 44 ] [ 45 ]
Urheberrechtsverletzende KI-Ergebnisse


Anne Graham Lotz. Die Forschungsarbeit, aus der dieses Beispiel stammt, konnte ähnliche Replikationen für 0,03 % der Trainingsbilder erzeugen. [ 30 ]
an astronaut riding a horse, by Picasso and Juan GrisIn einigen Fällen können Deep-Learning-Modelle bei der Generierung von Ausgaben Elemente aus ihrem Trainingsdatensatz duplizieren. Dieses Verhalten wird von KI-Entwicklern im Allgemeinen als unerwünschtes Overfitting eines Modells betrachtet und galt in früheren KI-Generationen als beherrschbares Problem. [ 46 ] Memorisierung ist das neuartige Phänomen, mit dem LLMs lange Sequenzen von Trainingsdaten wiederholen, und steht nicht mehr im Zusammenhang mit Overfitting. [ 47 ] Evaluierungen kontrollierter LLM-Ausgaben messen den Anteil der aus den Trainingsdaten gespeicherten Elemente (mit Fokus auf Modelle der GPT-2 -Serie) mit über 1 % für exakte Duplikate [ 48 ] oder bis zu etwa 7 %. [ 49 ] Dies stellt potenziell ein Sicherheits- und Urheberrechtsrisiko für Nutzer und Anbieter dar. [ 50 ] Stand August 2023 haben große Anbieter von Consumer-LLMs versucht, diese Probleme zu mindern, dennoch ist es Forschern gelungen, die Verbreitung urheberrechtlich geschützten Materials zu provozieren. [ 51 ]
Nach US-amerikanischem Recht muss ein Kläger, um nachzuweisen, dass ein KI-Ergebnis ein Urheberrecht verletzt, darlegen, dass das urheberrechtlich geschützte Werk „tatsächlich kopiert“ wurde, d. h., dass die KI ein Ergebnis erzeugt, das dem Werk des Klägers „ im Wesentlichen ähnlich “ ist, und dass die KI Zugriff auf dessen Werk hatte. [ 4 ]
Im Zuge des Lernens, die Trainingsdaten statistisch zu modellieren, können tiefe generative KI-Modelle den charakteristischen Stil bestimmter Autoren im Trainingsdatensatz imitieren. Da fiktive Charaktere in den USA und anderen Ländern urheberrechtlich geschützt sind , kann eine KI auch urheberrechtsverletzende Inhalte in Form von Romanen erzeugen, die fiktive Charaktere enthalten . [ 4 ] [ 30 ]
Ein generatives Bildmodell wie Stable Diffusion kann die stilistischen Merkmale eines Künstlers wie Pablo Picasso modellieren (einschließlich seiner spezifischen Pinselstriche, Farbgebung, Perspektive usw.). Ein Nutzer kann beispielsweise eine Eingabeaufforderung wie „Ein Astronaut reitet auf einem Pferd, von Picasso“ formulieren, woraufhin das Modell ein neues Bild generiert, das den Stil des Künstlers auf ein beliebiges Motiv anwendet. Der Gesamtstil eines Künstlers ist jedoch im Allgemeinen nicht urheberrechtlich geschützt. [ 4 ] Weitere Fragen zur Urheberrechtsfähigkeit von Stilen und den Ergebnissen von KI-Modellen kamen im März 2025 nach einem Update des ChatGPT-Modells auf, das Bilder erzeugen konnte, die stark an die Werke des Studio-Ghibli -Künstlers Hayao Miyazaki erinnerten . Während Nutzer das Modell zunächst für die „Ghiblifizierung“ beliebter Meme-Bilder verwendeten, stieß dies angesichts Miyazakis negativer Haltung gegenüber KI auf Ablehnung. Daraufhin schränkte ChatGPT die Möglichkeiten der Nutzer ein, Bilder im Stil lebender Künstler zu erstellen. [ 52 ] [ 53 ]
Rechtsstreitigkeiten
Doe gegen GitHub, Inc.
- In einer im November 2022 eingereichten Sammelklage gegen Microsoft , GitHub und OpenAI wurde behauptet, dass GitHub Copilot , ein KI-gestütztes Code-Bearbeitungstool, das mit öffentlichen GitHub-Repositories trainiert wurde, das Urheberrecht der Autoren der Repositories verletzt habe. Es wurde angemerkt, dass das Tool in der Lage war, Quellcode zu generieren, der wortgetreu mit seinen Trainingsdaten übereinstimmte, ohne die Urheber zu nennen. [ 54 ]
Anderson gegen Stabilitäts-KI
- Im Januar 2023 reichten drei US-amerikanische Künstlerinnen – Sarah Andersen , Kelly McKernan und Karla Ortiz – eine Sammelklage wegen Urheberrechtsverletzung gegen Stability AI , Midjourney und DeviantArt ein . Sie warfen den Unternehmen vor, die Rechte von Millionen von Künstlern verletzt zu haben, indem sie KI-Tools mit fünf Milliarden Bildern trainierten, die ohne Zustimmung der Urheber aus dem Internet gesammelt wurden. [ 55 ] Die Klage wurde wegen technischer Ungenauigkeiten kritisiert, beispielsweise der falschen Behauptung, dass „ein trainiertes Diffusionsmodell eine Kopie jedes seiner Trainingsbilder erstellen kann“, und der Beschreibung von Stability Diffusion als „lediglich ein komplexes Collage-Tool“. [ 56 ] Neben der Urheberrechtsverletzung werfen die Klägerinnen den Unternehmen unlauteren Wettbewerb und die Verletzung ihres Persönlichkeitsrechts vor, da die KI-Tools massenhaft Werke im Stil der Klägerinnen erstellen können . [ 56 ] Im Juli 2023 neigte der US-Bezirksrichter William Orrick dazu, den Großteil der von Andersen, McKernan und Ortiz eingereichten Klage abzuweisen, gestattete ihnen jedoch die Einreichung einer neuen Klage. [ 57 ] Im Oktober 2023 wies Richter Orrick schließlich alle Ansprüche bis auf einen ab, nämlich den wegen Urheberrechtsverletzung gegenüber Stability AI. [ 58 ] Nachdem Andersen und McKernan einige der zuvor abgewiesenen Ansprüche erneut eingereicht hatten, stimmte Orrick im August 2024 zu, einige dieser zusätzlichen Ansprüche gegen die KI-Unternehmen, die sowohl Urheber- als auch Markenrechtsverletzungen umfassten, wieder aufzunehmen. [ 59 ]
Getty Images gegen Stability AI
- Im Januar 2023 wurde Stability AI in London von Getty Images verklagt , weil das Unternehmen Bilder von Getty Images ohne Lizenz in seinen Trainingsdaten verwendet hatte. [ 60 ] [ 61 ]
- Getty reichte im Februar 2023 eine weitere Klage gegen Stability AI vor einem US-Bezirksgericht in Delaware ein. In der Klage wird erneut eine Urheberrechtsverletzung aufgrund der Verwendung von Getty-Bildern beim Training von Stable Diffusion geltend gemacht. Darüber hinaus wird argumentiert, dass das Modell Gettys Markenrechte verletzt , indem es Bilder mit Gettys Wasserzeichen generiert . [ 62 ]
Tremblay gegen OpenAI, Inc.
- Im Juli 2023 reichten die Autoren Paul Tremblay und Mona Awad vor einem Gericht in San Francisco Klage gegen OpenAI ein. Sie warfen dem Unternehmen vor, das Sprachmodell ChatGPT ohne ihre Erlaubnis mit ihren urheberrechtlich geschützten Büchern trainiert zu haben, und führten die „sehr genauen“ Zusammenfassungen ihrer Werke durch ChatGPT als Beweis an. [ 63 ] [ 64 ] Parallel dazu reichten die Autoren Sarah Silverman , Christopher Golden und Richard Kadrey zwei separate Klagen gegen Meta und OpenAI ein. Sie argumentierten, dass neben der Urheberrechtsverletzung durch das Training der KI-Systeme mit ihren Werken auch die von den KI-Systemen erstellten Produkte abgeleitete Werke und somit ebenfalls Urheberrechtsverletzungen darstellten. [ 65 ] Die beiden Klagen gegen OpenAI wurden zusammengeführt (wobei Awad aus dem Verfahren ausschied), und im Februar 2024 wies Richterin Araceli Martínez-Olguín vom Bundesbezirksgericht für den nördlichen Bezirk von Kalifornien alle bis auf eine Klagepunkte ab, die sich auf die Verwendung der urheberrechtlich geschützten Werke der Autoren als Teil der Trainingsdaten für das KI-Modell bezogen. [ 66 ]
Authors Guild et al. gegen OpenAI, Inc.
- Die Authors Guild reichte im Namen von 17 Autoren, darunter George R. R. Martin , im September 2023 eine Urheberrechtsverletzungsklage gegen OpenAI ein und behauptete, das Unternehmen habe bei der Entwicklung von ChatGPT „die urheberrechtlich geschützten Werke von Autoren illegal kopiert“. [ 67 ]
New York Times Co. gegen Microsoft Corp.
- Im Dezember 2023 verklagte die New York Times Microsoft und OpenAI . Die New York Times ist ein globales Medienunternehmen, das Inhalte in gedruckter und digitaler Form veröffentlicht und Einnahmen aus Abonnements, Werbung und Lizenzen generiert. [ 68 ] Die Times behauptete, dass die KI-Modelle von ChatGPT und Bing mit Artikeln der Times trainiert wurden und Endnutzern auf Basis dieser Artikel Antworten lieferten. [ 69 ] Dies wertete die Times als Urheberrechtsverletzung. Die Times argumentierte weiterhin, dass die von den KI-Unternehmen geltend gemachten Ansprüche auf faire Nutzung ungültig seien, da die generierten Informationen zu Nachrichtenartikeln in direkter Konkurrenz zur Times stünden und deren kommerzielle Möglichkeiten beeinträchtigten. [ 70 ] Darüber hinaus machten die Kläger geltend, dass die von den KI-Modellen erzeugten Halluzinationen dem Ruf der Times schadeten . [ 69 ]
- Im März 2025 wies der Bundesbezirksrichter den Antrag von Microsoft und OpenAI auf Abweisung der Klage zurück und beschränkte die Ansprüche der Times auf solche, die sich auf Urheberrechtsverletzungen beim Training der OpenAI-Modelle beziehen. [ 71 ]
- Das Gericht entschied, dass Microsoft und OpenAI für direkte und indirekte Urheberrechtsverletzungen sowie für Ansprüche wegen Verwässerung von Markenrechten nach Landes- und Bundesrecht haftbar gemacht werden können. Ansprüche aufgrund unlauteren Wettbewerbs nach Common Law seien jedoch nicht plausibel, weshalb Microsoft und OpenAI nicht haftbar gemacht werden könnten. [ 72 ]
Daily News LP gegen Microsoft Corp.
- Acht US-amerikanische Tageszeitungen des Verlags Tribune Publishing verklagten Microsoft und OpenAI im April 2024 wegen Urheberrechtsverletzung im Zusammenhang mit der Verwendung ihrer Nachrichtenartikel als Trainingsdaten sowie für Ergebnisse, die falsche und irreführende Aussagen erzeugen, welche den Zeitungen zugeschrieben werden. [ 73 ]
UMG Recordings, Inc. et al gegen Suno, Inc. et al
- Die Recording Industry Association of America (RIAA) und mehrere große Musiklabels verklagten im Juni 2024 in separaten Klagen die Entwickler von Suno AI und Udio , KI-Modellen, die aus Texteingaben Lieder mit Text und Begleitmusik erstellen können. Sie warfen den Labels vor, die KI-Modelle ohne deren Zustimmung mit Musik trainiert zu haben. [ 74 ] [ 75 ]
Robert Kneschke gegen LAION
- Im September 2024 wies das Landgericht Hamburg die Klage eines deutschen Fotografen gegen die gemeinnützige Organisation LAION wegen unerlaubter Vervielfältigung seines urheberrechtlich geschützten Werkes bei der Erstellung eines Datensatzes für das KI-Training ab. [ 41 ] Die Entscheidung wurde als „Meilensteinurteil zu Ausnahmen vom TDM für KI-Trainingsdaten“ in Deutschland und der EU allgemein bezeichnet. [ 41 ] Der Kläger legte Berufung gegen das Urteil ein.
ANI gegen OpenAI, Inc.
- Die indische Nachrichtenagentur ANI hat OpenAI vor dem Obersten Gerichtshof von Delhi verklagt . In der Klage wird behauptet, dass OpenAIs ChatGPT urheberrechtlich geschützte Nachrichteninhalte von ANI ohne Genehmigung reproduziert, was eine Urheberrechtsverletzung und unerlaubte Nutzung von geschütztem journalistischem Material darstellt. [ 76 ]
Torstar Corp. et al gegen OpenAI, Inc. et al
- Mehrere kanadische Nachrichtenagenturen, die dem Verband News Media Canada angehören , verklagten OpenAI im November 2024 wegen Urheberrechtsverletzungen im Zusammenhang mit der Verwendung ihrer Nachrichtenartikel zum Training von ChatGPT. Sie fordern Schadensersatz in Höhe von bis zu 20.000 kanadischen Dollar pro verwendetem Nachrichtenartikel. [ 77 ]
GEMA gegen OpenAI, Inc.
- Die deutsche Verwertungsgesellschaft GEMA hat OpenAI im November 2024 wegen Urheberrechtsverletzung durch die Vervielfältigung urheberrechtlich geschützter Liedtexte verklagt. [ 78 ] Dieselbe Gesellschaft hat im Januar 2025 Suno Inc. wegen der Vervielfältigung urheberrechtlich geschützter Werke verklagt. [ 79 ] Beide Klagen wurden in München eingereicht.
- Im November 2025 gewann GEMA den Rechtsstreit, nachdem nachgewiesen werden konnte, dass die zum Training von ChatGPT verwendeten Liedtexte bei Anfragen an die KI nahezu identische Ergebnisse lieferten. OpenAI hatte argumentiert, die Texte seien neu generiert worden. OpenAI wurde angewiesen, die Speicherung dieser Liedtexte einzustellen und sie nicht mehr in seinen KI-Diensten anzubieten. Darüber hinaus wurde OpenAI zur Zahlung von Schadensersatz und zur Offenlegung der Nutzungsdaten der betreffenden Liedtexte sowie der damit erzielten Einnahmen verpflichtet. [ 80 ]
Disney Enterprises, Inc. et al. gegen Midjourney, Inc.
- Im Juni 2025 wurde Midjourney von Disney und NBCUniversal verklagt. Die Kläger warfen dem Unternehmen vor, seine KI-Engine, die in der Klage als „bodenlose Quelle des Plagiats“ bezeichnet wurde, [ 81 ] mit urheberrechtlich geschützten Werken beider Firmen trainiert zu haben, ohne deren Zustimmung zu erteilen. Dies schloss auch Darstellungen ihrer Charaktere ein. [ 82 ] Warner Bros. reichte im September 2025 eine ähnliche Klage gegen Midjourney ein. [ 83 ]
Disney Enterprises, Inc. et al. gegen Minimax et al.
- Im September 2025 reichten Disney, NBCUniversal und Warner Bros. Discovery eine ähnliche Klage gegen den KI-Bild- und Videogenerierungsdienst Hailuo AI (betrieben vom chinesischen Technologieunternehmen MiniMax) ein und warfen ihm vor, von der unlizenzierten Nutzung „ikonischer urheberrechtlich geschützter Figuren “ zu profitieren . [ 84 ]
Hendrix et al. gegen Apple, Inc.
- Im September 2025 wurde Apple Inc. von den Autoren Grady Hendrix und Jennifer Roberson verklagt , die behaupteten, Apple habe ihr Apple Intelligence- Modell mit einem Teil des Pile-Datensatzes trainiert, der unlizenzierte Kopien ihrer Arbeit enthielt. [ 85 ]
Encyclopaedia Britannica, Inc. et al. gegen Perplexity AI, Inc.
- Die Encyclopædia Britannica, Inc. verklagte im September 2025 die KI-Suchmaschine Perplexity . Sie warf ihr vor, ohne Erlaubnis und ohne Entschädigung Material von ihrer Enzyklopädie- und Merriam-Webster -Wörterbuch-Website abzurufen und so den Zugriff von Nutzern zu verweigern. Zudem habe die Suchmaschine aufgrund der verwendeten KI falsche Ergebnisse generiert, die dann ihren Websites zugeschrieben wurden. [ 86 ] Im März 2026 verklagte sie OpenAI unter ähnlichen Vorwürfen. [ 87 ]
Referenzen
- ^ Levine, Joshua; Belton, John. „Primer: Training AI Models with Copyrighted Work“ . AAF . Abgerufen am 19. März 2024 .
- ^ Ahmad, Ariba A.; Gross, Andrew M. „Generative AI Systems Tee Up Fair Use Fight“ . www.natlawreview.com . Archiviert vom Original am 19. März 2024. Abgerufen am 19. März 2024 .
- ^ „Wie ist der urheberrechtliche Status von KI-generierten Werken?“ . www.linkedin.com . Abgerufen am 19. März 2024 .
- ^ a b c d e f Zirpoli, Christopher T. (24. Februar 2023). „Generative Künstliche Intelligenz und Urheberrecht“ . Congressional Research Service. Archiviert vom Original am 22. März 2024. Abgerufen am 3. April 2023 .
- ^ a b c d Vincent, James (15. November 2022). „Die beängstigende Wahrheit über das Urheberrecht an KI ist, dass niemand weiß, was als Nächstes passieren wird . “ The Verge . Archiviert vom Original am 19. Juni 2023. Abgerufen am 20. März 2024 .
- ^ „Die Rechtsstreitigkeiten, die die Zukunft von KI und Urheberrecht prägen könnten“ . The Wall Street Journal . News Corp. 15. April 2024. Abgerufen am 11. Februar 2025 .
- ^ a b Guadamuz, Andres (Oktober 2017). „Künstliche Intelligenz und Urheberrecht“ . WIPO Magazin . Archiviert vom Original am 24. Mai 2022. Abgerufen am 3. April 2023 .
- ^ „Populäre KI-Dienste zur Bildgenerierung stellen ein rechtliches Minenfeld für Künstler dar, die für ihre Arbeit bezahlt werden wollen . “ Fortune . 2023. Archiviert vom Original am 21. Juni 2023. Abgerufen am 21. Juni 2023 .
- ^ a b Peter Pink-Howitt, Copyright, AI And Generative Art Archived December 4, 2023, at the Wayback Machine , Ramparts , 2023.
- ^ Zweiter Antrag auf Überprüfung der Ablehnung der Registrierung von Théâtre D'opéra Spatial ( SR # 1-11743923581; Korrespondenz-ID: 1-5T5320R Archiviert am 13. November 2023 in der Wayback Machine , 2023).
- ^ „Federal Register :: Zugriff beantragen“ . unblock.federalregister.gov . Archiviert vom Original am 5. Juni 2023. Abgerufen am 20. März 2024 .
- ^ Leitfaden zur Urheberrechtsregistrierung: Werke, die Material enthalten, das durch künstliche Intelligenz generiert wurde. Archiviert am 14. März 2024 in der Wayback Machine , US Copyright Office 2023.
- ^ Maddaus, Gene (29. Januar 2025). „Copyright Office Offers Assurances on AI Filmmaking Tools“ . Variety . Abgerufen am 1. März 2025 .
- ^ „KI-gestützte Werke können urheberrechtlich geschützt werden, wenn genügend menschliche Kreativität vorhanden ist, so das US-Urheberrechtsamt . “ AP News . 29. Januar 2025. Abgerufen am 1. März 2025 .
- ^ „Dieses Unternehmen hat das Urheberrecht an einem vollständig mit KI erstellten Bild erhalten. So hat es funktioniert . “ CNET . Abgerufen am 9. April 2025 .
- ^ „Ablehnung des Urheberrechts an KI-‚Autor‘ durch DC Circuit bestätigt (3)“ . Bloomberg Law . 18. März 2025. Abgerufen am 19. März 2025 .
- ^ „US Supreme Court lehnt es ab, Streit über Urheberrechte an KI-generiertem Material anzuhören“ . Reuters . Abgerufen am 8. März 2026 .
- ^ "„Thaler gegen Perlmutter“: KI-Ergebnisse sind nicht urheberrechtlich geschützt . New York Law Journal . Abgerufen am 1. Dezember 2023 .
- ^ a b Valinasab, Omid (2023). „Big Data Analytics to Automate Disclosure of Artificial Intelligence's Inventions“ (PDF) . University of San Francisco Intellectual Property and Technology Law Journal . 27 (2): 133–140 – via USF LJ.
- ^ „USPTO sagt, dass KI-Modelle keine Patente halten können“ . 14. Februar 2024.
- ^ Robins-Early, Nick (9. April 2024). „Neuer Gesetzentwurf würde KI-Unternehmen zur Offenlegung der Verwendung urheberrechtlich geschützter Kunst zwingen“ . amp.theguardian.com . Abgerufen am 13. April 2024 .
- ^ Nova Production gegen MazoomaGames [2006] EWHC 24 (Ch) . Archiviert am 31. Oktober 2023 im Internet Archive .
- ^ Der Verhaltenskodex der britischen Regierung zu Urheberrecht und KI. Archiviert am 31. Oktober 2023 in der Wayback Machine . © Britische Regierung 2023.
- ^ a b „Künstliche Intelligenz und geistiges Eigentum: Urheberrecht und Patente: Stellungnahme der Regierung zur Konsultation“ . GOV.UK. Archiviert vom Original am 29. Oktober 2023. Abgerufen am 20. März 2024 .
- ^ „Künstliche Intelligenz und Urheberrecht, Aktenzeichen 2023–6“ (PDF) . Archiviert (PDF) vom Original am 6. April 2024. Abgerufen am 9. Oktober 2023 .
- ^ Aaron Wininger (29. November 2023). „Pekinger Internetgericht erkennt Urheberrecht an KI-generierten Bildern an“ . The National Law Review .
- ^ Takyar, Akash (7. November 2023). „Modellvalidierungstechniken im maschinellen Lernen“ . LeewayHertz – KI-Entwicklungsunternehmen . Archiviert vom Original am 20. März 2024. Abgerufen am 20. März 2024 .
- ^ Murray, Michael (2023). „Generative AI Art: Copyright Infringement and Fair Use“. SMU Science and Technology Law Review . 26 (2): 259. doi : 10.25172/smustlr.26.2.4 .
- ^ Henderson, Peter; Li, Xuechen; Jurafsky, Dan; Hashimoto, Tatsunori; Lemley, Mark A.; Liang, Percy (2023). „Foundation Models and Fair Use“ . Journal of Machine Learning Research . 24 (400): 1–79 . arXiv : 2303.15715 . Abgerufen am 14. September 2024 .
- ^ a b c d Lee, Timothy B. (3. April 2023). „Urheberrechtsklagen im Zusammenhang mit Stable Diffusion könnten ein juristisches Erdbeben für KI auslösen“ . Ars Technica . Archiviert vom Original am 3. April 2023. Abgerufen am 3. April 2023 .
- ^ Lemley, Mark A.; Casey, Bryan (2020). „Fair Learning“ . SSRN Electronic Journal . doi : 10.2139/ssrn.3528447 . ISSN 1556-5068 .
- ^ Lawler, Richard (11. Februar 2025). „Thomson Reuters gewinnt einen frühen Rechtsstreit um KI, Urheberrecht und Fair Use“ . The Verge . Abgerufen am 11. Februar 2025 .
- ^ Britton, Blake (1. Mai 2025). „Richter im Meta-Fall warnt, KI könnte den Markt für Originalwerke ‚auslöschen‘“ . Reuters . Abgerufen am 2. Mai 2025 .
- ^ Peters, Jay (25. Juni 2025). „Metas KI-Urheberrechtssieg geht mit einer Warnung bezüglich der fairen Nutzung einher“ . The Verge . Archiviert vom Original am 26. Juni 2025. Abgerufen am 25. Juni 2025 .
- ^ Roth, Emma (20. August 2024). „Autoren verklagen Anthropic wegen des Trainings von KI mit raubkopierten Büchern“ . The Verge . Abgerufen am 25. Juni 2025 .
- ^ Roth, Emma (24. Juni 2025). „Anthropic erzielt wichtigen Sieg im Bereich des Fair Use für KI – aber es droht weiterhin Ärger wegen Bücherdiebstahls“ . The Verge . Abgerufen am 25. Juni 2025 .
- ^ „Anthropic erzielt Einigung im Sammelklageverfahren der Autoren wegen Urheberrechtsverletzungen“ . 26. August 2025.
- ^ Metz, Cade (5. September 2025). „Anthropic zahlt 1,5 Milliarden Dollar zur Beilegung eines Rechtsstreits mit Buchautoren“ . The New York Times . Abgerufen am 5. September 2025 .
- ^ Moon, Mariella (8. September 2025). „Richter lehnt rekordverdächtigen Vergleich von 1,5 Milliarden US-Dollar für Anthropics KI-Urheberrechtsstreit ab“ . Engadget . Abgerufen am 9. September 2025 .
- ^ „Copyright Office Weighs in on AI and Fair Use Amid Major Leadership Shakeup“ . 12. Mai 2025. Archiviert vom Original am 13. Mai 2025. Abgerufen am 13. Mai 2025 .
- ^ a b c Goldstein, Paul ; Stützle, Christiane; Bischoff, Susan (13. November 2024). „Kneschke vs. LAION – Wegweisendes Urteil zu TDM-Ausnahmen für KI-Trainingsdaten – Teil 1“ . Kluwer Copyright Blog . Archiviert vom Original am 27. November 2024. Abgerufen am 25. November 2024 .
- ^ a b Goldstein, Paul ; Stützle, Christiane; Bischoff, Susan (14. November 2024). „Kneschke vs. LAION – Wegweisendes Urteil zu TDM-Ausnahmen für KI-Trainingsdaten – Teil 2“ . Kluwer Copyright Blog . Archiviert vom Original am 25. November 2024. Abgerufen am 25. November 2024 .
- ^ Buick, Adam (März 2025). „Urheberrecht und KI-Trainingsdaten – Transparenz als Lösung?“ . Journal of Intellectual Property Law & Practice . 20 (3): 182–192 . doi : 10.1093/jiplp/jpae102 . Archiviert vom Original am 4. April 2025 . Abgerufen am 27. April 2025 .
- ^ Panday, Jyoti; Jain, Saumya (11. Dezember 2024). „Die Bedeutung von ANI versus OpenAI“ . Der Hindu . Abgerufen am 20. Dezember 2024 .
{{cite news}}CS1-Wartung: Veralteter Archivierungsdienst ( Link ) - ^ Mittal, Vaishali (5. Dezember 2024). „ANI gegen OpenAI: Ein Streit um Urheberrecht, KI-Schulung und falsche Namensnennung“ . law.asia . Abgerufen am 20. Dezember 2024 .
{{cite web}}CS1-Wartung: Veralteter Archivierungsdienst ( Link ) - Siehe beispielsweise den Kommentar von OpenAI im Jahr derVeröffentlichung von GPT-2 : OpenAI (2019). Kommentar zur Aufforderung zur Stellungnahme zum Schutz geistigen Eigentums für Innovationen im Bereich der künstlichen Intelligenz (PDF) (Bericht). Patent- und Markenamt der Vereinigten Staaten. S. 9. PTO–C–2019–0038. Archiviert (PDF) vom Original am 16. Oktober 2021. Abgerufen am 14. September 2024.
Gut konstruierte KI-Systeme erzeugen im Allgemeinen keine unveränderten Daten aus einem bestimmten Werk in ihrem Trainingskorpus, und zwar nicht in nennenswertem Umfang
. - ^ Hans et al. 2024 , §2.3
- ^ Peng, Zhencan; Wang, Zhizhi; Deng, Dong (13. Juni 2023). „Near-Duplicate Sequence Search at Scale for Large Language Model Memorization Evaluation“ ( PDF) . Proceedings of the ACM on Management of Data . 1 (2): 1–18 . doi : 10.1145/3589324 . S2CID 259213212. Archiviert (PDF) vom Original am 27. August 2024. Abgerufen am 20. Januar 2024 . Unter Bezugnahme auf Lee et al. 2022.
- ^ Peng, Wang & Deng 2023 , S. 8.
- ^ Hans, Abhimanyu; Wen, Yuxin; Jain, Neel; Kirchenbauer, John; Kazemi, Hamid; Singhania, Prajwal; Singh, Siddharth; Somepalli, Gowthami; Geiping, Jonas; Bhatele, Abhinav; Goldstein, Tom (14. Juni 2024). „Seien Sie wie ein Goldfisch, merken Sie sich nicht! Das Auswendiglernen in generativen LLMs mildern“ . arXiv : 2406.10209 [ cs.CL ],§1.
- ^ Hays, Kali (15. August 2023). „ByteDance-KI-Forscher sagen, OpenAI versuche nun zu verbergen, dass ChatGPT mit J.K. Rowlings urheberrechtlich geschützten Harry-Potter-Büchern trainiert wurde . “ Business Insider . Abgerufen am 15. September 2024 .unter Berufung auf Liu, Yang; Yao, Yuanshun; Ton, Jean-François; Zhang, Xiaoying; Guo, Ruocheng; Cheng, Hao; Klotschkow, Jegor; Taufiq, Muhammad Faaiz; Li, Hang (10. August 2023). „Vertrauenswürdige LLMs: eine Umfrage und Richtlinie zur Bewertung der Ausrichtung großer Sprachmodelle“. arXiv : 2308.05374v2 [ cs.AI ].
- ^ O'Brien, Matt; Parvini, Sarah (28. März 2025). „ChatGPTs virale Bilder im Studio-Ghibli-Stil rücken Bedenken hinsichtlich des Urheberrechts von KI in den Fokus“ . Associated Press News . Abgerufen am 29. März 2025 .
- ^ Holland, Oscar (27. März 2025). „Virale KI-Bilder im Studio-Ghibli-Stil demonstrieren Leistungsfähigkeit – und Urheberrechtsbedenken – des ChatGPT-Updates“ . CNN . Archiviert vom Original am 28. März 2025. Abgerufen am 29. März 2025 .
- ^ Vincent, James (8. November 2022). „Die Klage, die die Regeln des Urheberrechts für KI neu schreiben könnte“ . The Verge . Archiviert vom Original am 3. April 2023. Abgerufen am 7. Dezember 2022.
22-cv-06823-JST
- ^ „James Vincent: KI-Kunstwerkzeuge Stable Diffusion und Midjourney im Visier einer Urheberrechtsklage“, The Verge, 16. Januar 2023“ . Archiviert vom Original am 9. März 2023. Abgerufen am 3. April 2023 .
- ^ a b Edwards, Benj (16. Januar 2023). „Künstler reichen Sammelklage gegen KI-Bildgenerator-Unternehmen ein“ . Ars Technica . Archiviert vom Original am 3. April 2023. Abgerufen am 3. April 2023 .
- ^ Brittain, Blake (19. Juli 2023). „US-Richter findet Mängel in der Klage von Künstlern gegen KI-Unternehmen“ . Reuters . Archiviert vom Original am 6. September 2023. Abgerufen am 6. August 2023 .
- ^ Cho, Winston (30. Oktober 2023). „Künstler verlieren erste Runde im Urheberrechtsstreit gegen KI-Kunstgeneratoren“ . Hollywood Reporter . Archiviert vom Original am 31. Oktober 2023. Abgerufen am 30. April 2024 .
- ^ Robertson, Adi (13. August 2024). „Klage von Künstlern gegen Stability AI und Midjourney gewinnt an Schärfe“ . The Verge . Archiviert vom Original am 13. August 2024. Abgerufen am 13. August 2024 .
- ^ Korn, Jennifer (17. Januar 2023). „Getty Images verklagt die Hersteller eines beliebten KI-Kunsttools wegen angeblichen Fotodiebstahls“ . CNN . Archiviert vom Original am 1. März 2023. Abgerufen am 22. Januar 2023 .
- ^ „Getty Images Statement“ . newsroom.gettyimages.com/ . 17. Januar 2023. Archiviert vom Original am 24. Januar 2023. Abgerufen am 24. Januar 2023 .
- ^ Belanger, Ashley (6. Februar 2023). „Getty verklagt Stability AI wegen des Kopierens von 12 Millionen Fotos und der Nachahmung eines bekannten Wasserzeichens“ . Ars Technica . Archiviert vom Original am 4. April 2023. Abgerufen am 4. April 2023 .
- ^ Ngila, Faustine (6. Juli 2023). „Die Urheberrechtsstreitigkeiten gegen OpenAI haben begonnen“ . Quartz . Abgerufen am 25. November 2024 .
- ^ Kris, Jimmy (6. Juli 2023). „OpenAI sieht sich einer Urheberrechtsklage der Autoren Mona Awad und Paul Tremblay gegenüber“ . DailyAi . Archiviert vom Original am 18. Juli 2023. Abgerufen am 10. Juli 2023 .
- ^ Davis, Wes (9. Juli 2023). „Sarah Silverman verklagt OpenAI und Meta wegen Urheberrechtsverletzung“ . The Verge . Archiviert vom Original am 18. November 2023. Abgerufen am 30. April 2024 .
- ^ David, Emilla (13. Februar 2024). „Sarah Silvermans Klage gegen OpenAI teilweise abgewiesen“ . The Verge . Archiviert vom Original am 15. Mai 2024. Abgerufen am 30. April 2024 .
- ^ Spangler, Todd (21. September 2023). „George R. R. Martin gehört zu den 17 Top-Autoren, die OpenAI verklagen und ChatGPT vorwerfen, ihre Werke zu stehlen: ‚Wir sind hier, um zu kämpfen‘“" . Variety . Archiviert vom Original am 16. Mai 2024 . Abgerufen am 15. Mai 2024 .
- ^ „Unsere Strategie“ . The New York Times Company . 24. März 2022. Abgerufen am 30. März 2026 .
- ^ a b „New York Times gegen Microsoft Corp. | Loeb & Loeb LLP“ . www.loeb.com . Abgerufen am 30. März 2026 .
- ^ O'Brien, Matt (9. Januar 2024). „ChatGPT-Entwickler bereitet sich auf Streit mit der New York Times und Autoren über die ‚angemessene Nutzung‘ urheberrechtlich geschützter Werke vor“ . AP News . Abgerufen am 30. März 2026 .
- ^ Allyn, Bobby (26. März 2025). „Richter lässt Urheberrechtsklage der ‚New York Times‘ gegen OpenAI zu“ . NPR . Abgerufen am 30. März 2026 .
- ^ „The New York Times Company gegen Microsoft Corporation et al., Nr. 1:2023cv11195 – Dokument 514 (SDNY 2025)“ . Justia Law . Abgerufen am 30. März 2026 .
- ^ Allyn, Bobby (30. April 2024). „Acht Zeitungen verklagen OpenAI und Microsoft wegen Urheberrechtsverletzung“ . NPR . Archiviert vom Original am 30. April 2024. Abgerufen am 30. April 2024 .
- ^ Sato, Mia (24. Juni 2024). „Große Plattenfirmen verklagen KI-Firma hinter ‚BBL Drizzy‘“" . The Verge . Archiviert vom Original am 16. September 2024 . Abgerufen am 24. Juni 2024 .
- ^ „UMG Recordings, Inc. gegen Suno, Inc., 1:24-cv-11611 – CourtListener.com“ . CourtListener . Abgerufen am 30. März 2026 .
- ^ One Law Street (19. Februar 2025). „ANI gegen OpenAI – Zeitplan der Anhörung“ . One Law Street . Abgerufen am 14. März 2025 .
- ^ Cecco, Leyland (29. November 2024). „Kanadische Medienunternehmen verklagen OpenAI in einem Fall mit einem potenziellen Streitwert von Milliarden“ . The Guardian . Abgerufen am 29. November 2024 .
- ^ „GEMA erhebt Musterklage zur Klärung der Vergütungspflicht von KI-Anbietern in Europa“ . gema.de (auf Deutsch). 13. November 2024 . Abgerufen am 9. August 2025 .
- ^ „Faire Vergütung gefordert: GEMA klagt gegen Suno Inc“ . gema.de (auf Deutsch). 21. Januar 2025 . Abgerufen am 9. August 2025 .
- ^ „GEMA vs. OpenAI: Niederlage für ChatGPT vor Münchner Gericht“ . Die Tageszeitung . 11. November 2025 . Abgerufen am 11. November 2025 .
- ^ Chmielewski, Dawn (11. Juni 2025). „Disney und Universal verklagen den Bildproduzenten Midjourney wegen Urheberrechtsverletzung“ . Reuters . Abgerufen am 11. Juni 2025 .
- ^ „Disney und Universal verklagen das KI-Bildbearbeitungsunternehmen Midjourney wegen unlizenzierter Nutzung von Star Wars, den Simpsons und mehr“ . CNBC . 11. Juni 2025. Archiviert vom Original am 11. Juni 2025. Abgerufen am 11. Juni 2025 .
- ^ Maddaus, Gene (4. September 2025). „Warner Bros. schließt sich dem Urheberrechtsstreit der Studios um KI gegen Midjourney an“ . Variety . Abgerufen am 4. September 2025 .
- ^ Cho, Winston (16. September 2025). „Disney, Warner Bros. und Universal Pictures verklagen chinesisches KI-Unternehmen in Eskalation des Urheberrechtsstreits“ . The Hollywood Reporter . Abgerufen am 19. September 2025 .
- ^ Scarcella, Mike (6. September 2025). „Apple von Autoren wegen Verwendung von Büchern im KI-Training verklagt“ . Reuters . Abgerufen am 6. September 2025 .
- ^ Washenko, Anna (11. September 2025). „Perplexitys Definition von Urheberrecht führt zu einer Klage des Wörterbuchs“ . Engadget . Abgerufen am 11. September 2025 .
- ^ Brittain, Blake (16. März 2026). „Encyclopedia Britannica verklagt OpenAI wegen KI-Training“ . Reuters .
Externe Links
- Pamela Samuelson : Wird das Urheberrecht generative KI-Technologien zum Scheitern bringen? (Präsentation auf einem Workshop des Simons Institute zum Thema „Ausrichtung, Vertrauen, Wasserzeichen und Urheberrechtsfragen in LLM-Studiengängen“, 17. Oktober 2024) – Überblick über 32 laufende Gerichtsverfahren in den USA zu diesem Zeitpunkt
- Das Innovationsökosystem für KI fit machen: Ein Instrumentarium für die IP-Politik – WIPO 2024

