Hi-C ist eine Hochdurchsatz- Technik zur Erfassung der Chromatin-Konformation (3C) in der Genomik und Epigenomik . [ 1 ] Im Allgemeinen gilt Hi-C als Weiterentwicklung verschiedener Technologien zur Erfassung der Chromosomen-Konformation , darunter 3C (Chromosome Conformation Capture), 4C (Chromosome Conformation Capture-on-Chip/Circular Chromosome Conformation Capture) und 5C (Chromosome Conformation Capture Carbon Copy). [ 1 ] [ 2 ] [ 3 ] [ 4 ] Hi-C erfasst umfassend genomweite Chromatin-Interaktionen im Zellkern durch die Kombination von 3C und Next-Generation-Sequencing (NGS) und gilt als qualitativer Sprung in der Entwicklung der C-Technologie (Chromosome Conformation Capture-basierte Technologien) und als Beginn der 3D-Genomik. [ 2 ] [ 3 ] [ 4 ]
Ähnlich der klassischen 3C-Technik misst Hi-C die Häufigkeit (als Mittelwert über eine Zellpopulation), mit der zwei DNA-Fragmente im dreidimensionalen Raum interagieren und so die Chromosomenstruktur direkt mit der genomischen Sequenz verknüpfen. [ 4 ] Das allgemeine Verfahren von Hi-C beinhaltet zunächst die Vernetzung von Chromatinmaterial mit Formaldehyd . [ 3 ] [ 4 ] Anschließend wird das Chromatin solubilisiert und fragmentiert, und interagierende Loci werden wieder miteinander verknüpft, um eine genomische Bibliothek chimärer DNA- Moleküle zu erzeugen. [ 4 ] Die relative Häufigkeit dieser Chimären bzw. Ligationsprodukte korreliert mit der Wahrscheinlichkeit, dass die jeweiligen Chromatinfragmente in der Zellpopulation im dreidimensionalen Raum interagieren. [ 4 ] Während sich 3C auf die Analyse einer Reihe vorbestimmter genomischer Loci konzentriert, um Untersuchungen zur Konformation der relevanten Chromosomenregionen im „Eins-gegen-Einige“-Verfahren durchzuführen, ermöglicht Hi-C die „Alle-gegen-Alle“-Interaktionsprofilierung durch Markierung des gesamten fragmentierten Chromatins mit einem biotinylierten Nukleotid vor der Ligation. [ 3 ] [ 4 ] Dadurch lassen sich biotinmarkierte Ligationsstellen effizienter mit Streptavidin -beschichteten Magnetpartikeln aufreinigen , und Chromatin-Interaktionsdaten können durch direkte Sequenzierung der Hi-C-Bibliothek gewonnen werden. [ 3 ] [ 4 ]
Analysen von Hi-C-Daten enthüllen nicht nur die Gesamtstruktur des Genoms , sondern liefern auch Einblicke in die biophysikalischen Eigenschaften des Chromatins sowie in spezifischere, weitreichende Kontakte zwischen entfernten genomischen Elementen (z. B. zwischen Genen und regulatorischen Elementen ) [ 4 ] [ 5 ] [ 6 ] , einschließlich deren zeitlicher Veränderung als Reaktion auf Stimuli [ 7 ] . In den letzten Jahren hat Hi-C in einer Vielzahl biologischer Bereiche Anwendung gefunden, darunter Zellwachstum und -teilung , Transkriptionsregulation , Schicksalsbestimmung , Entwicklung, Autoimmunerkrankungen und Genom-Evolution [ 7 ] [ 5 ] [ 6 ] . Durch die Kombination von Hi-C-Daten mit anderen Datensätzen, wie z. B. genomweiten Karten von Chromatinmodifikationen und Genexpressionsprofilen , lassen sich auch die funktionellen Rollen der Chromatinkonformation in der Genomregulation und -stabilität aufklären [ 4 ] .
Geschichte
Hi-C war zu Beginn eine Technologie mit niedriger Auflösung und hohem Rauschen, die lediglich Chromatin-Interaktionsregionen innerhalb einer Bin-Größe von 1 Million Basenpaaren (Mb) beschreiben konnte. [ 1 ] Die Erstellung der Hi-C-Bibliothek erforderte zudem mehrere Tage [ 4 , 8 ] , und die Datensätze selbst wiesen geringe Ausbeute und Reproduzierbarkeit auf . [ 9 ] Dennoch lieferten Hi-C-Daten neue Erkenntnisse zur Chromatin-Konformation sowie zur nukleären und genomischen Architektur, und diese Perspektiven motivierten Wissenschaftler in den letzten zehn Jahren zu Anstrengungen, die Technik zu modifizieren.
Zwischen 2012 und 2015 wurden mehrere Modifikationen des Hi-C-Protokolls vorgenommen, darunter die Verdauung mit vier Restriktionsenzymen [ 10 ] oder eine höhere Sequenziertiefe zur Erzielung einer besseren Auflösung [ 8 ] [ 9 ] [ 11 ] . Auch der Einsatz von Restriktionsendonukleasen mit höherer Schnittfrequenz sowie von DNase I und Micrococcal-Nukleasen verbesserte die Auflösung der Methode signifikant [ 12 ] . Kürzlich (2017) beschrieben Belaghzal et al. ein Hi-C 2.0-Protokoll, das eine Auflösung im Kilobasenbereich (kb) ermöglicht [ 12 ] . Die wichtigste Anpassung des Basisprotokolls war der Wegfall des SDS -Solubilisierungsschritts nach der Verdauung. Dadurch wird die Kernstruktur erhalten und eine zufällige Ligation fragmentierten Chromatins verhindert. Die Ligation erfolgt innerhalb der intakten Zellkerne und bildet die Grundlage für die in-situ-Hi-C-Methode. [ 12 ] Im Jahr 2021 wurde Hi-C 3.0 von Lafontaine et al. beschrieben. Durch die verbesserte Vernetzung mit Formaldehyd und anschließend Disuccinimidylglutarat (DSG) wurde eine höhere Auflösung erzielt. [ 13 ] Während Formaldehyd die Amino- und Iminogruppen von Proteinen und DNA bindet, reagieren die NHS-Ester im DSG mit primären Aminen von Proteinen und können Amin-Amin-Wechselwirkungen erfassen. [ 13 ] Diese Verbesserungen des Basisprotokolls ermöglichten es den Wissenschaftlern, detailliertere Konformationsstrukturen wie Chromosomenkompartimente und topologisch assoziierende Domänen (TADs) sowie hochauflösende Konformationsmerkmale wie DNA-Schleifen zu untersuchen . [ 12 ] [ 13 ]
Bis heute sind bereits verschiedene Derivate von Hi-C entstanden, darunter in situ Hi-C, low Hi-C, SAFE Hi-C und Micro-C, die sich durch besondere Merkmale in Bezug auf verschiedene Aspekte des Standard-Hi-C auszeichnen, das Grundprinzip ist jedoch dasselbe geblieben.
Traditionelles Hi-C
Der klassische Hi-C-Workflow lässt sich wie folgt beschreiben: Zellen werden mit Formaldehyd vernetzt; das Chromatin wird mit einem Restriktionsenzym verdaut, wodurch ein 5'-Überhang entsteht ; dieser 5'-Überhang wird mit biotinylierten Basen aufgefüllt und die resultierende DNA mit glatten Enden wird ligiert. [ 1 ] Die Ligationsprodukte mit Biotin an der Verbindungsstelle werden mittels Streptavidin selektiert und weiterverarbeitet, um eine Bibliothek für die nachfolgende Sequenzierung zu erstellen. [ 1 ]
Die paarweisen Interaktionen, die Hi-C im gesamten Genom erfassen kann, sind immens. Daher ist es wichtig, eine ausreichend große Stichprobe zu analysieren, um einzigartige Interaktionen zu erfassen, die möglicherweise nur bei einer Minderheit der Allgemeinbevölkerung beobachtet werden. [ 4 ] Um eine hochkomplexe Bibliothek von Ligationsprodukten zu erhalten, die eine hohe Auflösung und Datentiefe gewährleistet, werden für Hi-C 20–25 Millionen Zellen benötigt. [ 3 ] [ 4 ] Primäre humane Proben, die möglicherweise nur in geringeren Zellzahlen verfügbar sind, könnten für die Standard-Hi-C-Bibliothekspräparation mit nur 1–5 Millionen Zellen verwendet werden. [ 4 ] Die Verwendung einer so geringen Zellmenge kann jedoch mit einer geringen Bibliothekskomplexität einhergehen, was zu einem hohen Anteil an Duplikaten während der Bibliothekspräparation führt. [ 4 ]
Standard Hi-C liefert Daten zu paarweisen Interaktionen mit einer Auflösung von 1 bis 10 Mb, erfordert eine hohe Sequenziertiefe und das Protokoll dauert etwa 7 Tage. [ 3 ] [ 4 ] [ 14 ]
Formaldehydvernetzung

Zell- und Kernmembranen sind hochgradig permeabel für Formaldehyd. [ 4 ] [ 15 ] [ 16 ] Die Formaldehyd-Vernetzung wird häufig zur Detektion und Quantifizierung von DNA-Protein- und Protein-Protein-Interaktionen eingesetzt. [ 15 ] Von Interesse im Kontext von Hi-C und allen 3C-basierten Methoden ist die Fähigkeit von Formaldehyd, cis-chromosomale Interaktionen zwischen distalen Chromatinsegmenten zu erfassen. [ 1 ] [ 4 ] [ 15 ] [ 16 ] Dies geschieht durch die Bildung kovalenter Bindungen zwischen räumlich benachbarten Chromatinsegmenten. Formaldehyd kann in zwei Schritten mit Makromolekülen reagieren : Zunächst reagiert es mit einer nukleophilen Gruppe, beispielsweise einer DNA-Base, und bildet ein Methylol-Addukt, das anschließend in eine Schiffsche Base umgewandelt wird . [ 15 ] Im zweiten Schritt bildet die Schiffsche Base, die sich schnell zersetzen kann, eine Methylenbrücke mit einer anderen funktionellen Gruppe eines anderen Moleküls. [ 15 ] Es kann diese Methylenbrücke auch mit einem kleinen Molekül in Lösung, wie z. B. Glycin , bilden, das im Überschuss verwendet wird, um Formaldehyd in Hi-C zu neutralisieren. [ 1 ] [ 4 ] [ 15 ] [ 16 ] Quencher können typischerweise von außerhalb der Zelle auf Formaldehyd einwirken. [ 15 ] Ein wesentliches Merkmal dieser zweistufigen Formaldehyd-Vernetzungsreaktion ist die Reversibilität aller Reaktionen, die für die Chromatin-Anreicherung unerlässlich ist. [ 1 ] [ 4 ] [ 15 ] [ 16 ]
Die Vernetzung ist ein entscheidender Schritt im Chromatin-Capture-Workflow, da die funktionelle Messgröße der Technik die Häufigkeit der Vernetzung zweier genomischer Regionen ist. [ 4 ] Daher ist die Standardisierung dieses Schrittes wichtig, und hierfür müssen potenzielle Variationsquellen berücksichtigt werden. [ 4 ] Serum, das eine hohe Proteinkonzentration enthält, kann im Kulturmedium die effektive Formaldehydkonzentration für die Chromatinvernetzung verringern, indem es das Formaldehyd im Medium bindet. [ 4 ] Wird Serum in der Kultur verwendet, sollte es daher für den Vernetzungsschritt entfernt werden. [ 4 ] Auch die Zellart (Suspensions- oder Adhäsionszellen) ist für den Vernetzungsschritt relevant. [ 4 ] Adhärente Zellen binden mithilfe molekularer Mechanismen des Zytoskeletts an Oberflächen . [ 4 ] Es wurde gezeigt, dass ein Zusammenhang zwischen der durch das Zytoskelett aufrechterhaltenen Kern- und Zellmorphologie besteht, dessen Veränderung die globale Kernorganisation negativ beeinflussen kann. [ 4 ] Daher sollten adhärente Zellen vernetzt werden, solange sie noch an ihrer Kulturoberfläche haften. [ 4 ]
Lyse, Restriktionsverdau und Biotinylierung
Die Zellen werden auf Eis mit kaltem hypotonischem Puffer lysiert, der Natriumchlorid , Tris-HCl (pH 8,0) und das nichtionische Detergens IGEPAL CA-630 enthält und mit Proteaseinhibitoren versetzt ist . [ 4 ] [ 16 ] Die Proteaseinhibitoren und die Inkubation auf Eis tragen dazu bei, die Integrität der vernetzten Chromatinkomplexe vor endogenen Proteasen zu schützen. [ 4 ] [ 16 ] Durch die Lyse wird das Nukleinsäurematerial aus den Zellen freigesetzt. [ 1 ] [ 4 ] [ 16 ]
Nach der Zelllyse wird das Chromatin mit verdünntem SDS solubilisiert, um nicht-vernetzte Proteine zu entfernen und das Chromatin zu öffnen, wodurch es für die nachfolgende Restriktionsendonuklease-vermittelte Verdauung besser zugänglich wird. [ 4 ] Wird die empfohlene Inkubationszeit von 10 Minuten mit SDS überschritten, können die Formaldehyd-Vernetzungen reversibel sein. Daher muss die SDS-Inkubation unmittelbar durch eine Inkubation auf Eis ergänzt werden. [ 4 ] Um die Enzymdenaturierung im nächsten Schritt zu verhindern, wird das nichtionische Detergens Triton X-100 verwendet, um das SDS zu neutralisieren. [ 4 ]
Jedes Restriktionsenzym, das einen 5'-Überhang erzeugt, wie z. B. HindIII, kann verwendet werden, um das nun zugängliche Chromatin über Nacht zu verdauen. [ 4 ] [ 16 ] Dieser 5'-Überhang dient als Matrize für das Klenow-Fragment der DNA-Polymerase I, um biotinyliertes CTP oder ATP an die verdauten Chromatinenden anzufügen. [ 4 ] [ 16 ] Dieser Schritt ermöglicht die Selektion von Hi-C-Ligationsprodukten für die Bibliothekspräparation. [ 4 ] [ 16 ]
Proximity-Ligatur
Eine Verdünnungsligation wird an DNA-Fragmenten durchgeführt, die noch miteinander vernetzt sind, um die intramolekulare Ligation von Fragmenten innerhalb desselben Chromatinkomplexes gegenüber Ligationsereignissen zwischen Fragmenten aus verschiedenen Komplexen zu begünstigen. [ 4 ] [ 16 ] Da dieser Ligationsschritt zwischen DNA-Fragmenten mit glatten Enden erfolgt (da die klebrigen Enden mit biotinmarkierten Basen aufgefüllt wurden), wird die Reaktion bis zu 4 Stunden lang durchgeführt, um ihre inhärente Ineffizienz auszugleichen. [ 16 ] Infolge der Proximity-Ligation gehen die terminalen HindIII-Schnittstellen verloren und eine NheI-Schnittstelle entsteht. [ 1 ]
Biotinentfernung, DNA-Scherung, Größenselektion und Endreparatur
Die biotinmarkierten Ligationsprodukte können mittels Phenol-Chloroform-DNA-Extraktion gereinigt werden . [ 4 ] [ 16 ] [ 17 ] Um nicht ligierte Fragmente mit biotinmarkierten Enden zu entfernen, wird T4-DNA-Polymerase mit 3'→5'- Exonukleaseaktivität eingesetzt, um Nukleotide von den Enden dieser Fragmente abzuspalten. [ 4 ] [ 16 ] [ 18 ] Dieser Schritt stellt sicher, dass keine dieser nicht ligierten Fragmente für die Bibliothekspräparation ausgewählt werden. [ 4 ] [ 16 ] Die Reaktion wird mit EDTA gestoppt und die DNA erneut mittels Phenol-Chloroform-DNA-Extraktion gereinigt. [ 4 ] [ 16 ]
Die ideale Größe von DNA-Fragmenten für die Sequenzierungsbibliothek hängt von der verwendeten Sequenzierungsplattform ab. [ 4 ] [ 16 ] DNA kann zunächst mittels Ultraschall in Fragmente von etwa 300–500 bp Länge fragmentiert werden . [ 4 ] [ 16 ] [ 17 ] Fragmente dieser Größe eignen sich für die Hochdurchsatzsequenzierung. [ 4 ] [ 16 ] [ 17 ] Nach der Ultraschallbehandlung können die Fragmente mithilfe von AMPure XP-Beads von Beckman Coulter größenfraktioniert werden, um Ligationsprodukte mit einer Größenverteilung zwischen 150 und 300 bp zu erhalten. [ 4 ] [ 17 ] Dies ist der optimale Fragmentgrößenbereich für die HiSeq-Clusterbildung. [ 4 ] [ 17 ]
DNA-Scherungen verursachen asymmetrische DNA-Brüche und müssen vor der Biotin-Pulldown-Analyse und der Ligation von Sequenzierungsadaptern repariert werden. [ 4 ] [ 16 ] Dies geschieht durch die Kombination von Enzymen, die 5'-Überhänge auffüllen und 5'-Phosphatgruppen sowie Adenylate an die 3'-Enden der Fragmente anfügen, um die Ligation von Sequenzierungsadaptern zu ermöglichen. [ 4 ] [ 16 ]
Biotin-Pull-down
Mithilfe eines Überschusses an Streptavidin-Beads, wie beispielsweise der My-One C1 Streptavidin-Bead-Lösung von Dynabeads , lassen sich biotinylierte Hi-C-Ligationsprodukte isolieren und anreichern. [ 4 ] [ 16 ] Die Ligation der Illumina-Paired-End-Adapter erfolgt, während die DNA-Fragmente an die Streptavidin-Beads gebunden sind. [ 4 ] [ 16 ] [ 17 ] Die Adsorption an die Beads erhöht die Effizienz der Ligation dieser DNA-Fragmente mit stumpfen Enden an die Adapter, da sie deren Mobilität verringert. [ 4 ] [ 16 ] [ 17 ]
Bibliothekspräparation und Sequenzierung
Nach Abschluss der Adapterligierung erfolgt die PCR- Amplifikation der Bibliothek. [ 4 ] [ 16 ] Bei Hi-C-Ligationsprodukten geringer Komplexität kann es durch Überamplifikation zu einer hohen Anzahl von Duplikaten im PCR-Schritt kommen. [ 4 ] [ 16 ] Dies führt dazu, dass nur wenige Interaktionen erfasst werden, was häufig auf eine geringe Zellzahl in der Ausgangsprobe zurückzuführen ist. [ 4 ] [ 16 ] Es ist wichtig, die Anzahl der Zyklen zu optimieren, um mindestens 50 ng Hi-C-Bibliotheks-DNA für die Sequenzierung zu erhalten. [ 4 ] [ 16 ] Je weniger Zyklen, desto besser, um PCR-Artefakte (wie Off-Target-Amplifikate, unspezifische Amplifikate usw.) zu vermeiden. [ 4 ] [ 16 ] Der optimale Bereich für PCR-Zyklen liegt zwischen 9 und 15. Es ist vorteilhafter, mehrere PCR-Reaktionen zu poolen, um ausreichend DNA für die Sequenzierung zu erhalten, als die Anzahl der Zyklen einer einzelnen PCR-Reaktion zu erhöhen. [ 4 ] [ 16 ] Die PCR-Produkte werden erneut mit AMPure-Beads gereinigt, um Primerdimere zu entfernen , und anschließend quantifiziert, bevor sie sequenziert werden. [ 4 ] [ 16 ] Chromatinregionen, die miteinander interagieren, werden dann durch Paired-End-Sequenzierung der biotinylierten, ligierten Produkte identifiziert. [ 4 ] [ 16 ]
Jede Plattform, die die Sequenzierung der ligierten Fragmente über die NheI-Schnittstelle ( Roche 454) oder mittels Paired-End- oder Mate-Paired-Reads ( Illumina GA- und HiSeq- Plattformen) ermöglicht, eignet sich für Hi-C. [ 4 ] Vor der Hochdurchsatzsequenzierung sollte die Qualität der Bibliothek mittels Sanger-Sequenzierung überprüft werden , da die langen Sequenzierungs-Reads dabei die Biotin-Schnittstelle durchdringen. [ 4 ] 36 oder 50 bp lange Reads reichen aus, um die meisten Chromatin-Interaktionspaare mittels Illumina Paired-End-Sequenzierung zu identifizieren. [ 4 ] Da die durchschnittliche Fragmentgröße in der Bibliothek 250 bp beträgt, haben sich 50 bp lange Paired-End-Reads als optimal für die Hi-C-Bibliothekssequenzierung erwiesen. [ 4 ]
Qualitätskontrolle von Hi-C-Bibliotheken
Im Arbeitsablauf der Hi-C-Probenpräparation gibt es mehrere kritische Punkte, die gut dokumentiert und beschrieben sind. [ 4 ] [ 16 ] DNA in verschiedenen Stadien kann auf 0,8%igen Agarosegelen analysiert werden, um die Größenverteilung der Fragmente zu bestimmen. [ 4 ] [ 16 ] Dies ist besonders wichtig nach Fragmentierungsschritten der Größenselektion. [ 4 ] [ 16 ] Der Abbau von DNA kann auch anhand von Schmierspuren unter niedermolekularen Produkten auf Gelen beobachtet werden. [ 4 ] [ 16 ] Der Abbau kann durch unzureichende Zugabe von Proteaseinhibitoren während der Lyse, endogene Nukleaseaktivität oder thermische Degradation durch falsche Kühlung verursacht werden. [ 4 ] [ 16 ] 3C-PCR-Reaktionen können durchgeführt werden, um die Bildung von Proximity-Ligation-Produkten zu überprüfen. [ 4 ] [ 16 ]
Varianten
Standard-Hi-C ist mit einem hohen Bedarf an Ausgangszellen, der Notwendigkeit einer tiefen Sequenzierung und der Erzeugung von Daten mit geringer Auflösung verbunden. Zudem neigt es bei niedrigen Zellzahlen zur Bildung redundanter Moleküle, was zu Bibliotheken mit geringer Komplexität führt. [ 4 ] [ 16 ] [ 17 ] Um diese Probleme zu beheben und die Technik auch in Kontexten anwenden zu können, in denen die Zellzahl ein limitierender Faktor ist, beispielsweise bei der Arbeit mit primären menschlichen Zellen, wurden seit der ersten Konzeption von Hi-C verschiedene Hi-C-Varianten entwickelt. [ 3 ]
Die vier Hauptklassen von Hi-C-Varianten sind: Verdünnungsligation, In-situ-Ligation, Einzelzell- und Rauschunterdrückungssysteme. [ 3 ] Standard-Hi-C ist eine Form der Verdünnungsligation; weitere Verdünnungsligationen sind DNase-Hi-C und Capture-Hi-C. [ 3 ] Im Gegensatz zu Standard- und Capture-Hi-C benötigt DNase-Hi-C nur 2–5 Millionen Zellen als Ausgangsmaterial, verwendet DNase I zur Chromatinfragmentierung und nutzt eine In-Gel-Verdünnungs-Proximity-Ligation. [ 3 ] [ 19 ] [ 20 ] Der Einsatz von DNase I verbessert nachweislich die Effizienz und Auflösung von Hi-C erheblich. [ 3 ] [ 19 ] Capture-Hi-C ist eine genomweite Analysemethode zur Untersuchung von Chromatininteraktionen spezifischer Loci mittels Hybridisierung gezielter genomischer Regionen. [ 20 ] Sie wurde erstmals von Mifsud et al. entwickelt. Ziel dieser Studie war die Kartierung von Promotorkontakten über größere Distanzen in menschlichen Zellen durch die Erstellung einer biotinylierten RNA-Bait-Bibliothek, die auf 21.841 Promotorregionen abzielte. [ 20 ] Diese und weitere (unten beschriebene) Varianten stellen Modifikationen der grundlegenden Hi-C-Technik dar und beheben eine oder mehrere Einschränkungen der ursprünglichen Methode.
In situ Hi-C
In situ Hi-C kombiniert Standard-Hi-C mit einem nukleären Ligationsassay, d. h. einer Proximity-Ligation in intakten Zellkernen. [ 14 ] [ 21 ] Das Protokoll ähnelt dem von Standard-Hi-C hinsichtlich des grundlegenden Arbeitsablaufs, unterscheidet sich jedoch in anderen Punkten. [ 14 ] In situ Hi-C benötigt 2 bis 5 Millionen Zellen im Vergleich zu den idealen 20 bis 25 Millionen für Standard-Hi-C und ist in nur 3 Tagen abgeschlossen, während Standard-Hi-C 7 Tage benötigt. [ 14 ] Darüber hinaus findet die Proximity-Ligation nicht in Lösung wie bei Standard-Hi-C statt, wodurch die Häufigkeit zufälliger, biologisch irrelevanter Kontakte und Ligationen verringert wird, was sich in der geringeren Häufigkeit von mitochondrialen und nukleären DNA-Kontakten in der gebundenen biotinylierten DNA zeigt. [ 14 ] Dies wird dadurch erreicht, dass die Zellkerne für den Ligationsschritt intakt bleiben. [ 14 ] Die Zellen werden vor der Ligation weiterhin mit einem Puffer lysiert, der Tris-HCl (pH 8,0), Natriumchlorid und das Detergens IGEPAL CA630 enthält. Anstatt das Zelllysat zu homogenisieren, werden die Zellkerne jedoch nach der initialen Lyse pelletiert, um die Zellmembran abzubauen. [ 14 ] Nach Abschluss der Proximity-Ligation werden die Zellkerne mindestens 1,5 Stunden bei 68 °C inkubiert, um die Kernmembran zu permeabilisieren und den Kerninhalt freizusetzen. [ 14 ]
Die mit in situ Hi-C erzielbare Auflösung beträgt bis zu 950–1000 bp, verglichen mit der Auflösung von 1–10 Mb bei Standard Hi-C und 100 kb bei DNase Hi-C. [ 3 ] [ 4 ] [ 14 ] [ 19 ] Während Standard Hi-C für den Restriktionsverdau ein 6-bp-Restriktionsenzym wie HindIII verwendet, nutzt in situ Hi-C ein 4-bp-Restriktionsenzym wie MboI oder dessen Isoschizomer DpnII (das nicht empfindlich gegenüber CpG-Methylierung ist ), um Effizienz und Auflösung zu erhöhen (da die Restriktionsstellen von MboI und DpnII häufiger im Genom vorkommen). [ 3 ] [ 4 ] [ 14 ] Die Daten von Replikaten für in situ Hi-C sind konsistent und hochgradig reproduzierbar, weisen ein sehr geringes Hintergrundrauschen auf und zeigen deutliche Chromatin-Interaktionen. [ 3 ] [ 14 ] Es ist jedoch möglich, dass einige der erfassten Interaktionen keine präzisen intermolekularen Wechselwirkungen darstellen, da der Zellkern dicht mit Proteinen und DNA gefüllt ist. Daher können Proximity-Ligationen in intakten Zellkernen auch Wechselwirkungen erfassen, die möglicherweise nur aufgrund der Beschaffenheit der Kernpackung und weniger aufgrund einzigartiger chromosomaler Interaktionen mit zellulärer Funktionsrelevanz entstehen. [ 3 ] [ 14 ] Um die von Rao et al. beschriebene Datenauflösung zu erreichen, ist zudem eine extrem hohe Sequenziertiefe von etwa 5 Milliarden Paired-End-Reads pro Probe erforderlich. [ 3 ] [ 14 ] [ 22 ] Es existieren verschiedene Techniken, die das Konzept von in situ Hi-C adaptiert haben, darunter Sis Hi-C, OCEAN-C und in situ Capture Hi-C. [ 3 ] Im Folgenden werden zwei der wichtigsten in situ Hi-C-basierten Techniken beschrieben. [ 3 ]

1. Niedrig-C
Low-C ist ein In-situ-Hi-C-Protokoll, das für die Verwendung mit geringen Zellzahlen angepasst wurde und sich besonders in Kontexten eignet, in denen die Zellzahl ein limitierender Faktor ist, beispielsweise in primären humanen Zellkulturen. [ 23 ] Diese Methode nutzt geringfügige Änderungen, darunter die verwendeten Volumina und Konzentrationen sowie die zeitliche Abfolge bestimmter experimenteller Schritte, um die Generierung hochwertiger Hi-C-Bibliotheken aus Zellzahlen von nur 1000 Zellen zu ermöglichen. [ 23 ] Trotz des Potenzials, mit nur 1000 Zellen nutzbare und hochauflösende Daten zu generieren, empfehlen Diaz et al. dennoch, wenn möglich, mindestens 1 bis 2 Millionen Zellen zu verwenden, andernfalls mindestens 500.000 Zellen. [ 23 ] Die Bibliotheksqualität wurde zunächst auf der Illumina MiSeq-Plattform (2x84 np Paired-End-Reads) überprüft. Nach Erfüllung der Qualitätskontrollkriterien (einschließlich geringer PCR-Duplikate) wurde die Bibliothek auf Illumina NextSeq (2x80 bp Paired-End) sequenziert. [ 23 ] Insgesamt umgeht diese Technik das Problem der hohen Zellzahl, die für Hi-C erforderlich ist, sowie der hohen Sequenziertiefe, die für hochauflösende Daten notwendig ist. Allerdings erreicht sie nur Auflösungen von bis zu 5 kb und ist aufgrund der variablen Probengrößen und der daraus generierten Daten möglicherweise nicht immer reproduzierbar. [ 23 ]
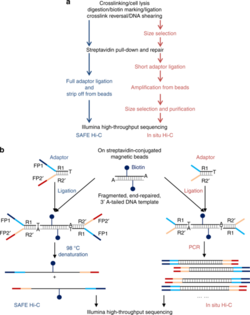
2. SAFE Hi-C
SAFE Hi-C (vereinfachtes, schnelles und wirtschaftliches Hi-C) erzeugt ohne Amplifikation ausreichend ligierte Fragmente für die Hochdurchsatzsequenzierung. [ 17 ] Veröffentlichte In-situ-Hi-C-Daten zeigen, dass die Amplifikation (im PCR-Schritt zur Bibliothekspräparation) eine distanzabhängige Amplifikationsverzerrung verursacht, die zu einem höheren Rausch-Signal-Verhältnis mit zunehmender genomischer Distanz führt. [ 17 ] Mit SAFE Hi-C konnte erfolgreich eine amplifikationsfreie In-situ-Hi-C-Ligationsbibliothek aus nur 250.000 K562-Zellen generiert werden . [ 17 ] Die Ligationsfragmente sind zwischen 200 und 500 bp lang, im Durchschnitt etwa 370 bp. [ 17 ] Alle Ligationsproduktbibliotheken wurden mit der Illumina HiSeq-Plattform (2x150 bp Paired-End-Reads) sequenziert. [ 17 ] Obwohl SAFE Hi-C bereits ab einer Zellmenge von 250.000 Zellen eingesetzt werden kann, empfehlen Niu et al. die Verwendung von 1 bis 2 Millionen Zellen. [ 17 ] Die Proben liefern ausreichend Ligationsmaterial für die Sequenzierung auf einem Viertel einer Spur. [ 17 ] Es wurde gezeigt, dass SAFE Hi-C die Bibliothekskomplexität erhöht, da PCR-Duplikate entfernt werden, welche den Gesamtanteil eindeutiger gepaarter Reads verringern. [ 17 ] Insgesamt erhält SAFE Hi-C die Integrität chromosomaler Interaktionen, reduziert den Bedarf an hoher Sequenziertiefe und spart somit Kosten und Arbeitsaufwand. [ 17 ]
Mikro-C
Micro-C ist eine Variante von Hi-C, die einen Verdauungsschritt mit Mikrokokken-Nuklease (MNase) beinhaltet, um Interaktionen zwischen Nukleosomenpaaren zu untersuchen und so die Auflösung subgenomischer TAD-Strukturen im Bereich von 1 bis 100 Nukleosomen zu ermöglichen. [ 24 ] [ 25 ] Es wurde ursprünglich für die Anwendung in Hefe entwickelt und zeigte, dass es die mit Standard-Hi-C gewonnenen Strukturdaten beibehält, jedoch mit einem höheren Signal-Rausch-Verhältnis. [ 24 ] [ 25 ] Bei der Anwendung mit humanen embryonalen Stammzellen und Fibroblasten wurden 2,6 bis 4,5 Milliarden eindeutig zugeordnete Reads pro Probe erhalten. [ 24 ] [ 25 ] Hsieh et al. analysierten 2,64 Milliarden Reads aus embryonalen Stammzellen der Maus und zeigten eine erhöhte Aussagekraft für den Nachweis von Kurzstreckeninteraktionen. [ 24 ] [ 25 ] [ 26 ]

Einzelzellen-Hi-C
Hi-C wurde auch für die Anwendung mit Einzelzellen adaptiert, jedoch erfordern diese Techniken ein hohes Maß an Fachkenntnis und sind mit Problemen wie geringer Datenqualität, Abdeckung und Auflösung behaftet. [ 3 ]
Anpassungen für alte DNA: PaleoHi-C
PaleoHi-C ist eine spezielle Anpassung der Hi-C-Genomanalysetechnik zur Untersuchung der dreidimensionalen Genomarchitektur in alten DNA-Proben. Sie bewältigt die Herausforderungen, die durch degradierte und fragmentierte DNA entstehen, und ermöglicht es Forschern, Chromatin-Interaktionen in ausgestorbenen Arten zu rekonstruieren.
Methodik
PaleoHi-C modifiziert das traditionelle Hi-C-Protokoll, um den spezifischen Eigenschaften alter DNA Rechnung zu tragen:
- Probenvorbereitung: Die DNA wird aus gut erhaltenem Gewebe, wie Knochen oder Haut, extrahiert, das häufig in kalten oder trockenen Umgebungen gefunden wird, wodurch der Abbau minimiert wird. [ 27 ]
- Fragmentierung und Ligation: Aufgrund der inhärenten Fragmentierung alter DNA nutzt PaleoHi-C optimierte Ligationsprotokolle, um Chromatininteraktionen auch in stark degradierten Proben zu erfassen. [ 28 ]
- Datenanalyse: Mithilfe fortschrittlicher Computerprogramme werden die Interaktionsdaten verarbeitet, Chromatinstrukturen rekonstruiert und Merkmale wie topologisch assoziierende Domänen (TADs) und Chromatinkompartimente identifiziert. [ 27 ]
Anwendungen
PaleoHi-C hat neue Wege in der Paläogenomik eröffnet, darunter:
- Genomrekonstruktion: Sie wurde zur Kartierung der dreidimensionalen Genomarchitektur ausgestorbener Arten, wie beispielsweise des 52.000 Jahre alten Wollhaarmammuts ( Mammuthus primigenius ), eingesetzt und offenbarte Ähnlichkeiten mit modernen Verwandten wie dem Asiatischen Elefanten ( Elephas maximus ). [ 27 ]
- Epigenetische Erkenntnisse: Durch die Identifizierung erhaltener Chromatin-Interaktionen bietet PaleoHi-C einen einzigartigen Einblick in die Genregulation urzeitlicher Organismen. Studien haben gezeigt, dass die Chromatinorganisation, einschließlich der Barr-Körperchen, die inaktive X-Chromosomen repräsentieren, in urzeitlichen Zellkernen intakt bleiben kann. [ 28 ]
- Evolutionsstudien: Die Technik hilft dabei zu verstehen, wie sich die Genomorganisation im Laufe der Zeit und über verschiedene Arten hinweg entwickelt hat. [ 27 ]
Bedeutung
Die Anpassung der Hi-C-Methode an alte DNA hat die Paläogenomik revolutioniert und ermöglicht detaillierte Untersuchungen ausgestorbener Arten auf molekularer Ebene. Durch die Erhaltung und Analyse von Chromatin-Interaktionen liefert PaleoHi-C neue Erkenntnisse über Genomstruktur, Evolution und Anpassung in alten Ökosystemen. [ 27 ]
Einschränkungen
PaleoHi-C ist durch die Verfügbarkeit gut erhaltener Proben und die inhärenten Herausforderungen bei der Arbeit mit stark degradierter DNA eingeschränkt. Fortschritte bei Sequenzierungstechnologien und computergestützten Methoden erweitern jedoch kontinuierlich die potenziellen Anwendungsgebiete. [ 28 ]
Datenanalyse
Die durch Hi-C erzeugten chimären DNA-Ligationsprodukte repräsentieren paarweise Chromatininteraktionen oder physikalische 3D-Kontakte im Zellkern [ 1 ] [ 2 ] [ 3 ] [ 4 ] und können mit verschiedenen nachgelagerten Methoden analysiert werden. Kurz gesagt, werden Deep-Sequencing-Daten verwendet, um unvoreingenommene genomweite Chromatininteraktionskarten zu erstellen [ 3 ] [ 4 ] [ 29 ] [ 30 ] [ 31 ] [ 32 ]. Anschließend können verschiedene Methoden eingesetzt werden, um diese Karten zu analysieren und chromosomale Strukturmuster sowie deren biologische Bedeutung zu identifizieren. Viele dieser Datenanalyseansätze sind auch auf 3C-Sequenzierung oder vergleichbare Daten anwendbar.
Karte lesen
Die durch Hochdurchsatzsequenzierung erzeugten Hi-C-Daten liegen im traditionellen FASTQ-Format vor . Die Reads können mithilfe von Sequenzalignment-Software (z. B. Bowtie [ 33 ] , bwa [ 9 ] , [ 34 ] usw.) [ 29 ] , [ 30 ] auf das gewünschte Genom ausgerichtet werden. Da Hi-C-Ligationsprodukte Hunderte von Megabasen umfassen und Loci auf verschiedenen Chromosomen verbinden können [ 3 ] , [ 4 ] , [ 29 ] , [ 30 ], ist das Hi-C-Read-Alignment häufig chimär. Das bedeutet, dass unterschiedliche Teile eines Reads auf weit voneinander entfernte Loci, möglicherweise in unterschiedlichen Orientierungen, ausgerichtet werden können. Long-Read-Aligner (z. B. minimap2 [ 35 ] ) unterstützen häufig chimäre Alignments und können direkt auf Long-Read-Hi-C-Daten angewendet werden. Das Short-Read-Hi-C-Alignment ist anspruchsvoller.
Hi-C erzeugt Ligationsstellen unterschiedlicher Größe, deren genaue Position jedoch nicht bestimmt wird. [ 3 ] [ 4 ] [ 29 ] Um dieses Problem zu umgehen, wird iteratives Mapping [ 29 ] eingesetzt. Dadurch wird die Suche nach der Ligationsstelle vermieden, bevor die Reads in zwei Teile aufgeteilt und separat gemappt werden können, um die Interaktionspaare zu identifizieren. Die Idee des iterativen Mappings besteht darin, eine möglichst kurze Sequenz zu mappen, um die eindeutige Identifizierung von Interaktionspaaren zu gewährleisten, bevor die Ligationsstelle erreicht wird. [ 29 ] [ 30 ] Daher werden zunächst 25 bp lange Reads, beginnend am 5'-Ende, auf das Genom gemappt. Reads, die nicht eindeutig einem einzelnen Locus zugeordnet werden können, werden um weitere 5 bp verlängert und erneut gemappt. [ 29 ] Dieser Prozess wird wiederholt, bis alle Reads eindeutig gemappt sind oder bis die Reads vollständig verlängert wurden. [ 29 ] [ 30 ] Nur gepaarte Reads, bei denen jede Seite eindeutig einem einzelnen genomischen Locus zugeordnet ist, werden beibehalten. [ 30 ] Alle anderen gepaarten Reads werden verworfen.
In vielen Bioinformatik-Pipelines werden verschiedene Varianten von Read-Mapping-Techniken implementiert, beispielsweise ICE [ 36 ] , HiC-Pro [ 37 ] , HIPPIE [ 38 ] , HiCUP [ 39 ] und TADbit [ 40 ] , um zwei Abschnitte eines Paired-End-Reads separat zu kartieren, falls diese Abschnitte unterschiedlichen genomischen Positionen entsprechen. Dadurch wird die Herausforderung bewältigt, wenn Reads die Ligationsstellen überspannen. [ 30 ]
Mit zunehmender Leselänge werden in neueren Pipelines (z. B. Juicer [ 41 ] und dem 4D-Nucleosome Data Portal [ 42 ] ) kurze Hi-C-Reads häufig mit einem Alignment-Algorithmus ausgerichtet, der chimäre Ausrichtungen ermöglicht, wie etwa bwa-mem [ 43 ] , chromap [ 44 ] und dragmap . Dieses Verfahren führt die Ausrichtung nur einmal durch und ist einfacher als iteratives Mapping.
Fragmentzuweisung und Filterung
Die zugeordneten Reads werden anschließend jeweils einer genomischen Position entsprechend ihrer 5'-Position im Genom zugewiesen. [ 29 ] Jedem Read-Paar wird nur einem der Restriktionsfragmente eine Position zugewiesen ; diese sollte sich daher in unmittelbarer Nähe einer Restriktionsstelle und weniger als die maximale Moleküllänge entfernt befinden. [ 29 ] [ 30 ] Reads, die mehr als die maximale Moleküllänge von den nächstgelegenen Restriktionsstellen entfernt liegen, sind auf physikalische Chromatinbrüche oder nicht-kanonische Nukleaseaktivitäten zurückzuführen. [ 29 ] Da diese Reads auch Informationen über Chromatin-Interaktionen liefern, werden sie nicht verworfen. Nach der Zuordnung der genomischen Positionen muss jedoch eine geeignete Filterung erfolgen, um technisches Rauschen im Datensatz zu entfernen. [ 29 ] [ 30 ] [ 31 ] [ 32 ]
Je nachdem, ob die Lesepaare in dasselbe oder in verschiedene Restriktionsfragmente fallen, werden unterschiedliche Filterkriterien angewendet. Liegen die gepaarten Lesevorgänge im selben Restriktionsfragment, handelt es sich wahrscheinlich um nicht-ligierte, überhängende Enden oder zirkularisierte Fragmente, die keine Information liefern und daher aus dem Datensatz entfernt werden. [ 29 ] [ 30 ] Diese Lesevorgänge könnten auch PCR-Artefakte, unverdautes Chromatinfragment oder einfach Lesevorgänge mit geringer Ausrichtungsqualität darstellen. [ 8 ] [ 30 ] Unabhängig von ihrem Ursprung gelten Lesevorgänge, die im selben Fragment liegen, als „falsche Signale“ [ 30 ] und werden typischerweise vor der weiteren Verarbeitung verworfen.
Die verbleibenden gepaarten Reads, die unterschiedlichen Restriktionsfragmenten zugeordnet sind, werden ebenfalls gefiltert, um identische/redundante PCR-Produkte zu verwerfen. Dies geschieht durch Entfernen von Reads mit exakt derselben Sequenz oder 5'-Alignment-Position. [ 29 ] Je nach experimentellem Zweck können weitere Filterstufen angewendet werden. Beispielsweise können potenzielle unverdaute Restriktionsstellen gezielt herausgefiltert statt passiv identifiziert werden, indem Reads entfernt werden, die demselben Chromosomenstrang zugeordnet sind und einen geringen (benutzerdefinierten, erfahrungsbasierten) Abstand zueinander aufweisen. [ 29 ]

Bin-Einteilung und Filterung auf Bin-Ebene
Basierend auf ihren Mittelpunktkoordinaten werden Hi-C-Restriktionsfragmente in feste genomische Intervalle mit Intervallgrößen von 40 kb bis 1 Mb eingeteilt. [ 29 ] Der Ansatz beruht darauf, dass durch die Reduzierung der Datenkomplexität und der Anzahl potenzieller genomweiter Interaktionen pro Intervall robustere und weniger verrauschte Signale in Form von Kontakthäufigkeiten erzeugt werden können, allerdings auf Kosten der Auflösung (wobei die Restriktionsfragmentlänge weiterhin die physikalische Grenze der Hi-C-Auflösung darstellt). [ 29 ] [ 30 ] Interaktionen zwischen Intervallen werden durch einfache Summation aggregiert. Im Laufe der Jahre wurden jedoch auch fokussiertere und informativere Methoden entwickelt, um das Signal weiter zu verbessern. [ 29 ] Eine dieser Methoden, beschrieben von Rao et al., zielt darauf ab, die Intervallgröße immer weiter zu verkleinern, bis schließlich > 80 % der Intervalle mit jeweils 1000 Reads abgedeckt sind, was die Auflösung der finalen Analyseergebnisse signifikant erhöht. [ 14 ]
Die Filterung auf Bin-Ebene dient, analog zur Filterung auf Fragment-Ebene, dazu, experimentelle Artefakte aus den gewonnenen Daten zu entfernen. Bins mit hohem Rauschen und niedrigen Signalwerten werden entfernt, da sie typischerweise hochrepetitive genomische Bereiche um die Telomere und Zentromere repräsentieren . [ 29 ] Dies geschieht durch Vergleich der Summen der einzelnen Bins mit der Summe aller Bins und Entfernung der untersten 1 % der Bins oder durch Verwendung der Varianz als Rauschmaß. [ 29 ] Bins mit geringer Abdeckung oder Bins, die drei Standardabweichungen unterhalb des Mittelwerts einer logarithmischen Normalverteilung liegen (welche die Gesamtzahl der Kontakte pro genomischem Bin beschreibt), werden mithilfe des MAD-max-Filters (Maximum Allowed Median Absolute Deviation) entfernt. [ 45 ] [ 46 ] Nach der Bin-Einteilung werden die Hi-C-Daten in einem symmetrischen Matrixformat gespeichert. [ 29 ] [ 30 ] [ 31 ] [ 32 ]
In jüngerer Zeit wurden zahlreiche Ansätze vorgeschlagen, um die optimale Bin-Größe für verschiedene Hi-C-Experimente vorab zu bestimmen. Li et al. beschrieben 2018 deDoc, eine Methode, bei der die Bin-Größe so gewählt wird, dass die strukturelle Entropie der Hi-C-Matrix ein stabiles Minimum erreicht. [ 47 ] QuASAR hingegen bietet eine etwas umfassendere Qualitätsbewertung und vergleicht die Ergebnisse von Replikaten der Proben (sofern Replikate für den Versuchszweck verwendet werden), um die maximal nutzbare Auflösung zu ermitteln. [48] Einige Publikationen [8, 49 ] versuchten auch , Interaktionsfrequenzen auf Einzelfragmentebene zu bewerten , wodurch selbst mit einer geringeren Anzahl an Reads eine höhere Abdeckung erzielt werden kann. HiCPlus [ 50 ] , ein 2018 von Zhang et al. entwickeltes Tool, kann Hi-C-Matrizen, die den Originalen sehr ähnlich sind, mit nur 1/16 der ursprünglichen Reads imputieren. [ 50 ]
Ausgleich/Normalisierung
Balancing bezeichnet den Prozess der Bias-Korrektur der gewonnenen Hi-C-Daten und kann explizit oder implizit erfolgen. [ 29 ] [ 30 ] Explizite Balancing-Methoden erfordern die explizite Definition von Bias-Parametern, die bekanntermaßen mit Hi-C-Reads (oder allgemein mit Hochdurchsatzsequenzierungstechniken ) assoziiert sind, darunter die Read-Mappabilität, der GC-Gehalt sowie die Länge einzelner Fragmente. [ 29 ] [ 30 ] Zunächst wird für jeden der betrachteten Bias-Parameter ein Korrekturfaktor berechnet, anschließend für jede Kombination dieser Parameter. Dieser Korrekturfaktor wird dann auf die Read-Anzahl pro genomischem Abschnitt angewendet. [ 29 ] [ 30 ]
Manche Verzerrungen können jedoch unbekannten Ursprungs sein. In diesem Fall wird ein impliziter Ausgleichsansatz verwendet. Dieser basiert auf der Annahme, dass jeder Genort „gleiche Sichtbarkeit“ aufweisen sollte. Dies impliziert, dass sich die Interaktionssignale an jedem Genort in den Hi-C-Daten zu einem Gesamtwert addieren sollten. [ 30 ] Ein Ansatz, die sogenannte iterative Korrektur, verwendet den Sinkhorn-Knopp-Ausgleichsalgorithmus [ 51 ] und versucht, die symmetrische Matrix unter Verwendung der oben genannten Annahme auszugleichen (indem die Summe jeder Zeile und Spalte der Matrix angeglichen wird). [ 29 ] [ 30 ] [ 51 ] Der Algorithmus wechselt iterativ zwischen zwei Schritten: 1) Division jeder Zeile durch ihren Mittelwert und 2) Division jeder Spalte durch ihren Mittelwert. Diese Schritte konvergieren garantiert und führen dazu, dass keine Zeilen oder Spalten mit offensichtlich hohen Werten in der Interaktionsmatrix verbleiben. [ 29 ] [ 51 ] Es existieren weitere Rechenmethoden zur Normalisierung der in Hi-C-Daten inhärenten Verzerrungen, darunter die sequentielle Komponentennormalisierung (SCN) [ 52 ] , der Knight-Ruiz-Matrixausgleichsansatz [ 14 ] [ 53 ] und die Eigenvektorzerlegung (ICE) [ 36 ] . Letztendlich liefern sowohl die expliziten als auch die impliziten Methoden zur Verzerrungskorrektur vergleichbare Ergebnisse. [ 29 ]
Analyse und Dateninterpretation
Mithilfe einer gruppierten, genomweiten Interaktionsmatrix können häufige Interaktionsmuster, die in Säugetiergenomen beobachtet werden, identifiziert und biologisch interpretiert werden, während seltenere, weniger häufig beobachtete Muster wie zirkuläre Chromosomen und Zentromercluster möglicherweise zusätzliche, speziell zugeschnittene Methoden zur Identifizierung erfordern.
1. Cis/Trans-Wechselwirkungsverhältnis
Cis / Trans-Interaktionen gehören zu den beiden stärksten Interaktionsmustern in Hi-C-Karten. [ 29 ] Sie sind nicht lokusspezifisch und gelten daher als genomweites Muster. [ 29 ] Typischerweise ist die Interaktionsfrequenz zwischen Loci-Paaren auf demselben Chromosom (in cis) im Durchschnitt höher als zwischen Loci-Paaren auf verschiedenen Chromosomen (in trans). [ 29 ] In Hi-C-Interaktionsmatrizen erscheinen Cis/Trans-Interaktionen als quadratische Blöcke, die entlang einer Diagonalen zentriert sind und jeweils einem einzelnen Chromosom zugeordnet sind. [ 29 ] Da dieses Muster über verschiedene Spezies und Zelltypen hinweg relativ konsistent ist, kann es zur Beurteilung der Datenqualität herangezogen werden. Ein verrauschteres Experiment, bedingt durch zufällige Hintergrundligation oder andere unbekannte Faktoren, führt zu einem niedrigeren cis/trans-Interaktionsverhältnis (da das Rauschen voraussichtlich sowohl cis- als auch trans-Interaktionen in ähnlichem Maße beeinflusst), und qualitativ hochwertige Experimente weisen typischerweise ein cis/trans-Interaktionsverhältnis zwischen 40 und 60 für das menschliche Genom auf. [ 29 ]
2. Distanzabhängige Interaktionsfrequenz
Dieses Muster beschreibt den distanzabhängigen Abfall der Interaktionshäufigkeiten auf Genomebene und stellt das zweite der beiden stärksten Hi-C-Interaktionsmuster dar. [ 29 ] Mit abnehmenden Interaktionshäufigkeiten zwischen cis-interagierenden Loci (aufgrund des größeren Abstands zwischen ihnen) ist ein allmählicher Rückgang der Interaktionshäufigkeit mit zunehmender Entfernung von der Diagonalen der Interaktionsmatrix zu beobachten. [ 29 ]
Zur statistischen Charakterisierung der Eigenschaften von Locus-Paaren mit einem bestimmten Abstand existieren verschiedene Polymermodelle [ 54 , 55 ]. Diskrete Klassifizierung und die Anpassung kontinuierlicher Funktionen sind zwei gängige Methoden zur Analyse der abstandsabhängigen Interaktionsfrequenzen zwischen Datenpunkten [ 29 ] . Zunächst werden die Interaktionsfrequenzen anhand ihres genomischen Abstands klassifiziert. Anschließend wird eine kontinuierliche Funktion an die Daten angepasst, wobei die Mittelwerte der einzelnen Klassifizierungen berücksichtigt werden [ 29 ] . Die resultierende Abklingfunktion wird in einem doppeltlogarithmischen Diagramm dargestellt, sodass die von den Polymermodellen vorhergesagten Potenzgesetz-Abklingkurven durch eine Gerade repräsentiert werden können [ 54 , 55 ] . Häufig reicht ein einfaches Polymermodell jedoch nicht aus , um die abstandsabhängigen Interaktionsfrequenzen vollständig abzubilden. In diesem Fall können komplexere Abklingfunktionen entstehen, die die Reproduzierbarkeit der Daten beeinträchtigen können. Dies liegt an den locus-spezifischen, nicht genomweiten Mustern in der Hi-C-Matrix (die von den Polymermodellen nicht berücksichtigt werden). [ 29 ] [ 54 ] [ 55 ]
3. Chromatinkompartimente
Das stärkste lokusspezifische Muster in Hi-C-Karten sind Chromatin-Kompartimente [ 1 ] , die in der Interaktionsmatrix ein schachbrettartiges Muster mit alternierenden Blöcken von 1 bis 10 Mb Größe aufweisen (wodurch sie sich auch bei Experimenten mit sehr geringer Stichprobengröße leicht extrahieren lassen) im menschlichen Genom. [ 29 ] [ 30 ] [ 32 ] Dieses Muster tritt sowohl mit hoher als auch mit niedriger Frequenz auf. Da Chromosomen aus zwei Arten von Genomregionen bestehen, die sich entlang der Chromosomenlänge abwechseln, können die Interaktionsfrequenzen zwischen zwei Regionen desselben Typs und zwischen zwei Regionen unterschiedlichen Typs stark variieren. [ 29 ] [ 30 ]
Die Definition der aktiven (A) und inaktiven (B) Chromatin-Kompartimente basiert auf der Hauptkomponentenanalyse , die erstmals 2009 von Lieberman-Aiden et al. etabliert wurde. [ 1 ] [ 29 ] [ 30 ] [ 32 ] Ihr Ansatz berechnete die Korrelation der Hi-C-Matrix des Verhältnisses von beobachtetem zu erwartetem Signal (ermittelt aus einer distanznormalisierten Kontaktmatrix) und verwendete das Vorzeichen des ersten Eigenvektors , um positive und negative Bereiche der resultierenden Darstellung als A- bzw. B-Kompartimente zu kennzeichnen. [ 1 ] [ 29 ] [ 30 ] [ 32 ] Zahlreiche Genomstudien haben gezeigt, dass Chromatin-Kompartimente mit Chromatinzuständen wie Gendichte , DNA-Zugänglichkeit, GC-Gehalt, Replikationszeitpunkt und Histonmodifikationen korrelieren . [ 1 ] [ 29 ] [ 30 ] [ 32 ] Daher werden Kompartimente vom Typ A genauer definiert, um die gendichten Regionen des Euchromatins darzustellen , während Kompartimente vom Typ B heterochromatische Regionen mit geringerer Genaktivität repräsentieren. [ 29 ] [ 30 ] [ 32 ] Insgesamt liefern Chromatinkompartimente Einblicke in die allgemeinen Organisationsprinzipien des jeweiligen Genoms.
In den letzten zehn Jahren wurden immer mehr Bioinformatik-Tools zur Kompartimentbestimmung entwickelt, darunter HOMER [ 56 ] , HiTC R [ 37 ] und CscoreTool [ 57 ] . Obwohl sie sich jeweils durch Unterschiede und Optimierungen gegenüber dem ursprünglichen Ansatz von 2009 auszeichnen, basieren ihre Basisprotokolle weiterhin auf der Hauptkomponentenanalyse.
4. Topologisch assoziierende Domänen (TADs)
TADs sind Sub-Mb-Strukturen, die genregulatorische Merkmale wie lokale Promotor - Enhancer -Interaktionen aufweisen können. [ 29 ] Allgemeiner werden TADs als emergente Eigenschaft zugrundeliegender biologischer Mechanismen betrachtet, was sie als Schleifenausstülpungen, Kompartimentierungen oder beliebige dynamische genomische Muster und nicht als statische Strukturmerkmale des Genoms definiert. [ 58 ] Somit repräsentieren TADs regulatorische Mikroumgebungen und erscheinen in Hi-C-Karten üblicherweise als Blöcke stark selbstinteragierender Regionen, in denen die Interaktionsfrequenzen innerhalb der Region signifikant höher sind als die Interaktionsfrequenzen zwischen zwei benachbarten Regionen. [ 29 ] [ 30 ] [ 32 ] In Hi-C-Interaktionsmatrizen sind TADs quadratische Blöcke erhöhter Interaktionsfrequenzen, die entlang der Diagonalen zentriert sind. [ 29 ] Dies ist jedoch lediglich eine vereinfachte Beschreibung, und die Identifizierung des tatsächlichen Musters erfordert deutlich mehr statistische Verarbeitung und Schätzung.
Ein Ansatz zur Identifizierung von TADs wurde von Dixon et al. [ 9 ] beschrieben . Sie berechneten zunächst (innerhalb eines bestimmten genomischen Bereichs) die Differenz zwischen den durchschnittlichen Upstream- und Downstream-Interaktionen jedes Bins in der Matrix. [ 9 ] Diese Differenz wurde dann mithilfe des Hidden-Markov-Modells in eine Chi-Quadrat-Statistik transformiert . Jede abrupte Änderung dieses Chi-Quadrat-Wertes, der sogenannte Richtungsindex, definiert die Grenzen von TADs. [ 9 ] [ 29 ] Alternativ kann man, wie Naumova et al. [ 59 ] , einfach das Verhältnis zwischen durchschnittlichen Upstream- und Downstream-Interaktionen zur Definition der TAD-Grenzen verwenden.
Ein anderer Ansatz besteht darin, die durchschnittlichen Interaktionshäufigkeiten innerhalb jedes Bins zu berechnen, wiederum innerhalb eines vorab festgelegten genomischen Bereichs. [ 29 ] [ 30 ] [ 60 ] Der resultierende Wert wird als Isolationswert bezeichnet und kann als Mittelwert eines Quadrats interpretiert werden, das entlang der Diagonalen der Matrix verschoben wird (Crane et al.). [ 60 ] Dieser Wert ist an TAD-Grenzen erwartungsgemäß niedriger; daher können Standardverfahren der Statistik verwendet werden, um lokale Minima (Grenzen) zu finden und Bereiche zwischen aufeinanderfolgenden Grenzen als TADs zu definieren. [ 29 ] [ 30 ] [ 60 ]
Wie heute zunehmend erkannt wird, stellen TADs eine hierarchische Abfolge von Strukturen dar, die sich durch die eindimensionalen Scores bisheriger Methoden nicht vollständig charakterisieren lassen. [ 30 ] Die höhere Auflösung neuerer Datensätze ermöglicht nun die explizite Analyse von TADs mithilfe multiskaliger Analyseverfahren. Wie erstmals von Armatus [ 61 ] vorgestellt , lassen sich auflösungsspezifische Domänen identifizieren und ein Konsenssatz von Domänen berechnen, der über verschiedene Auflösungen hinweg erhalten bleibt. [ 30 ] [ 61 ] Dadurch wird das Problem der TAD-Bestimmung in die Optimierung von Scoring-Funktionen basierend auf ihren lokalen Interaktionsdichten transformiert. [ 61 ] Variationen dieses Ansatzes mit unterschiedlichen Zielfunktionen, wie beispielsweise Lavaburst [ 62 ] , MrTADFinder [ 63 ] , 3DNetMod [ 64 ] und Matryoshka [ 65 ], wurden ebenfalls entwickelt, um eine bessere Rechenleistung auf höher auflösenden Datensätzen zu erzielen.

5. Punktinteraktionen
Biologisch gesehen finden regulatorische Interaktionen üblicherweise auf einer viel kleineren Skala als TADs statt, und zwei genomische Elemente können die Expression eines Gens innerhalb eines Abstands von nur 1 kb aktivieren oder hemmen. [ 29 ] Daher sind Punktinteraktionen für die Interpretation von Hi-C-Karten wichtig und erscheinen erwartungsgemäß als lokale Anreicherungen der Kontaktwahrscheinlichkeit. [ 29 ] [ 30 ] Die derzeitigen Methoden zur Identifizierung von Punktinteraktionen sind jedoch implizit, da sie nicht beschreiben, wie eine Punktinteraktion aussehen sollte. [ 29 ] [ 30 ] Stattdessen werden Punktmutationen als Ausreißer mit höheren Interaktionsfrequenzen als erwartet innerhalb der Hi-C-Matrix identifiziert, da das Hintergrundmodell nur aus den stärksten Signalen wie den Distanz-Abklingfunktionen besteht. [ 29 ] [ 30 ] Das Hintergrundmodell kann sowohl mithilfe lokaler Signalverteilungen als auch globaler Ansätze (d. h. chromosomen- oder genomweit) geschätzt und erstellt werden. [ 30 ] Viele der zuvor genannten Bioinformatik-Pakete beinhalten Algorithmen zur Identifizierung von Punktinteraktionen. Kurz gesagt, wird die Signifikanz einzelner paarweiser Interaktionen berechnet, und signifikant hohe Ausreißer werden für multiples Testen korrigiert, bevor sie als tatsächlich informative Punktinteraktionen erkannt werden. [ 29 ] Es ist hilfreich, identifizierte Punktinteraktionen durch zusätzliche Evidenz wie die Analyse von Anreicherungswerten und biologischen Replikaten zu ergänzen, um zu zeigen, dass diese Interaktionen tatsächlich biologisch signifikant sind. [ 29 ]
Verwendung
Hi-C wurde hauptsächlich zur Untersuchung der Chromatinfaltung eingesetzt. Diese Studien haben gezeigt, dass die Prinzipien der Chromosomenorganisation über verschiedene Zelltypen und Spezies hinweg konserviert sind. [ 66 ] [ 67 ] [ 68 ]
Hi-C wird auch bei der Genom-Assemblierung eingesetzt , wobei die Häufigkeit von Langzeitkontakten zwischen Sequenzen in einer vorläufigen Assemblierung genutzt wird, um diese zu gruppieren, zu ordnen und in Chromosomen-Assemblierungen zu orientieren. [ 69 ] [ 70 ] [ 71 ]
Hi-C kann auch zur Erkennung struktureller Variationen im Genom verwendet werden. [ 72 ]
Entwicklung
1. Zellteilung
Hi-C kann Chromatin-Konformationsänderungen während der Zellteilung sichtbar machen. In der Interphase ist das Chromatin im Allgemeinen locker und dynamisch, sodass die Transkriptionsregulation und andere regulatorische Prozesse stattfinden können. [ 73 ] Beim Eintritt in die Mitose und die Zellteilung faltet sich das Chromatin kompakt zu dichten, zylindrischen Chromosomen. [ 73 ] In den letzten fünf Jahren hat die Entwicklung der Einzelzell-Hi-C die Darstellung der gesamten dreidimensionalen Struktur des Chromatins/der Chromosomen während des gesamten Zellzyklus ermöglicht . Zahlreiche Studien haben gezeigt, dass diese identifizierten genomischen Domänen in der Interphase unverändert bleiben und durch Silencing-Mechanismen beim Eintritt der Zelle in die Mitose gelöscht werden. [ 74 ] [ 75 ] Nach Abschluss der mitotischen Teilung und dem erneuten Eintritt der Zelle in die Interphase wird beobachtet, dass die dreidimensionalen Chromatinstrukturen wiederhergestellt sind und die Transkriptionsregulation wiederhergestellt ist. [ 74 ]
2. Transkriptionsregulation und Schicksalsbestimmung
Es wird vermutet, dass die Differenzierung embryonaler Stammzellen (ES-Zellen) und induzierter pluripotenter Stammzellen (iPS-Zellen) in verschiedene reife Zelllinien mit globalen Veränderungen der Chromosomenstrukturen und folglich der Interaktionsdynamik einhergeht, um die Regulation der transkriptionellen Aktivierung/Silenzierung zu ermöglichen. [ 3 ] Standard-Hi-C kann zur Untersuchung dieser Forschungsfrage eingesetzt werden.
Im Jahr 2015 nutzten Dixon et al. [ 11 ] die Standard-Hi-C-Methode, um die globale 3D-Dynamik humaner embryonaler Stammzellen (hESCs) während ihrer Differenzierung zu High-Five-Zellen zu erfassen . Dank der Fähigkeit von Hi-C, dynamische Interaktionen in differenzierungsrelevanten TADs darzustellen, entdeckten die Forscher eine Zunahme der Anzahl von DHS-Bindungsstellen, der CTCF- Bindungsfähigkeit, aktiver Histonmodifikationen und der Expression von Zielgenen innerhalb dieser TADs. Sie fanden zudem eine signifikante Beteiligung wichtiger Pluripotenzfaktoren wie OCT4 , NANOG und SOX2 am Interaktionsnetzwerk während der somatischen Zellreprogrammierung. [ 11 ] Seitdem gilt Hi-C als eine der Standardmethoden zur Untersuchung transkriptioneller regulatorischer Aktivitäten und hat bestätigt, dass die Chromosomenarchitektur eng mit dem Zellschicksal verknüpft ist. [ 11 ] [ 76 ]
3. Wachstum und Entwicklung
Das somatische Wachstum und die Entwicklung von Säugetieren beginnen mit der Befruchtung von Spermium und Eizelle . Darauf folgen das Zygotenstadium , das 2-Zell-, 4-Zell- und 8-Zell-Stadium, das Blastozystenstadium und schließlich das Embryostadium . [ 77 ] Hi-C ermöglichte die umfassende Untersuchung der genomischen Architektur während Wachstum und Entwicklung. Sowohl sis-Hi-C [ 78 ] als auch in situ Hi-C [ 79 ] zeigten, dass TADs sowie die genomischen A- und B-Kompartimente in Eizellen nicht deutlich erkennbar und weniger gut strukturiert sind. [ 78 ] [ 79 ] Diese Strukturmerkmale des Chromatins entwickeln sich nach der Befruchtung mit fortschreitender Entwicklung erst allmählich von schwächeren zu klareren und häufigeren Datenpunkten. [ 78 ] [ 79 ]
Genom-Evolution
Da Daten zu 3D-Genomstrukturen in den letzten Jahren immer häufiger verfügbar sind, wird Hi-C zunehmend zur Verfolgung evolutionärer Strukturmerkmale und -veränderungen eingesetzt. Genomische Einzelnukleotid-Polymorphismen (SNPs) und TADs sind typischerweise über verschiedene Spezies hinweg konserviert [ 80 ] , ebenso wie der CTCF-Faktor in der Chromatindomänen-Evolution [ 81 ] . Hi-C-Techniken haben jedoch gezeigt, dass auch andere Faktoren strukturellen Evolutionen in der 3D-Architektur unterliegen. Dazu gehören die Ähnlichkeit der Codon-Nutzungshäufigkeit (CUFS) [ 82 ] , die Koregulation paraloger Gene [ 83 ] und räumlich koevolvierende orthologe Module (SCOMs) [ 84 ] . Bei der Evolution großräumiger Domänen erwiesen sich chromosomale Translokationen , syntäne Regionen sowie genomische Rearrangement-Regionen als relativ konserviert. [ 2 ] [ 76 ] [ 81 ] [ 85 ] [ 86 ] Diese Ergebnisse deuten darauf hin, dass Hi-C-Technologien eine alternative Sichtweise im eukaryotischen Stammbaum des Lebens ermöglichen . [ 3 ]
Krebs
Mehrere Studien nutzten Hi-C, um die Chromatinarchitektur verschiedener Krebsarten und deren Einfluss auf die Pathogenese zu beschreiben und zu untersuchen. Kloetgen et al. verwendeten in situ Hi-C zur Untersuchung der akuten lymphoblastischen T-Zell-Leukämie (T-ALL) und fanden ein TAD-Fusionsereignis, das eine CTCF-Isolationsstelle entfernte und so die direkte Interaktion des MYC -Promotors mit einem distalen Super-Enhancer ermöglichte . [ 87 ] Fang et al. zeigten ebenfalls mittels in situ Hi-C, dass es bei T-ALL zu spezifischen Zugewinnen oder Verlusten der Chromatinisolation kommt, welche die Stärke der TAD-Architektur des Genoms verändern. [ 88 ] Low-C wurde zur Kartierung der Chromatinstruktur primärer B-Zellen eines Patienten mit diffusem großzelligem B-Zell-Lymphom eingesetzt und zeigte eine hohe chromosomale Strukturvariation zwischen den B-Zellen des Patienten und gesunden Zellen. [ 23 ] Insgesamt liefert die Anwendung von Hi-C und seinen Varianten in der Krebsforschung einzigartige Einblicke in die molekularen Grundlagen der treibenden Faktoren zellulärer Anomalien. [ 23 ] [ 87 ] [ 88 ] Sie kann dazu beitragen, biologische Phänomene (z. B. die hohe MYC-Expression bei T-ALL) zu erklären und die Entwicklung von Medikamenten zu unterstützen, die auf Mechanismen abzielen, die für Krebszellen spezifisch sind. [ 23 ] [ 87 ] [ 88 ]
Referenzen
- ^ a b c d e f g h i j k l m n o Lieberman-Aiden, E ; van Berkum, NL; Williams, L; Imakaev, M; Ragoczy, T; Erzählen, A; Amit, ich; Lajoie, BR; Sabo, PJ; Dorschner, MO; Sandström, R; Bernstein, B ; Bender, MA; Groudine, M ; Gnirke, A; Stamatoyannopoulos, J ; Mirny, LA; Lander, ES ; Dekker, J (9. Oktober 2009). „Umfassende Kartierung weitreichender Wechselwirkungen enthüllt Faltungsprinzipien des menschlichen Genoms“ . Wissenschaft . 326 (5950): 289– 93. Bibcode : 2009Sci...326..289L . doi : 10.1126/science.1181369 . PMC 2858594 . PMID 19815776 .
- Lin , Da; Hong, Ping; Zhang, Siheng; Xu, Weize; Jamal, Muhammad; Yan, Keji; Lei, Yingying; Li, Liang; Ruan, Yijun; Fu, Zhen F.; Li, Guoliang; Cao, Gang (Mai 2018). „ Digestion - Ligation -only Hi-C is an efficient and cost-effective method for chromosome conformation capture“ . Nature Genetics . 50 (5): 754–763 . doi : 10.1038/s41588-018-0111-2 . ISSN 1546-1718 . PMID 29700467. S2CID 13740808 .
- Kong , Siyuan ; Zhang, Yubo (1. Februar 2019 ) . „ Hi - C entschlüsseln : vom 3D - Genom zur Funktion “ . Cell Biology and Toxicology . 35 ( 1 ) : 15–32 . doi : 10.1007 / s10565-018-09456-2 . ISSN 1573-6822 . PMID 30610495. S2CID 57427743 .
- ^ a b c d e f g h i j k l m n o p q r s t u v w x y z aa ab ac ad ae af ag ah ai aj ak al am an ao ap aq ar as at au av aw ax ay az ba bb bc bd be bf bg bh bi bj bk bl bm bn bo bp bq br bs bt bu bv bw bx von Belton, Jon-Matthew; McCord, Rachel Patton; Gibcus, Johan; Naumova, Natalia; Zhan, Ye; Dekker, Job (November 2012). „Hi-C: Eine umfassende Technik zur Erfassung der Konformation von Genomen“ . Methoden . 58 (3 ) : 268–276 . doi : 10.1016/j.ymeth.2012.05.001 . ISSN 1046-2023 . PMC 3874846. PMID 22652625 .
- ^ a b Eagen, Kyle P. (Juni 2018). „Prinzipien der Chromosomenarchitektur, enthüllt durch Hi-C“ . Trends in Biochemical Sciences . 43 (6): 469–478 . doi : 10.1016/j.tibs.2018.03.006 . ISSN 0968-0004 . PMC 6028237. PMID 29685368 .
- ^ a b Kim, Kyukwang; Kim, Mooyoung; Kim, Yubin; Lee, Dongsung; Jung, Inkyung (1. Januar 2022). „Hi-C als molekularer Entfernungsmesser zur Untersuchung genomischer Umlagerungen“ . Seminars in Cell & Developmental Biology . 121 : 161–170 . doi : 10.1016/j.semcdb.2021.04.024 . ISSN 1084-9521 . PMID 33992531. S2CID 234746398 .
- ^ a b Burren, Oliver S.; Rubio García, Arcadio; Javierre, Biola-Maria; Rainbow, Daniel B.; Cairns, Jonathan; Cooper, Nicholas J.; Lambourne, John J.; Schofield, Ellen; Castro Dopico, Xaquin; Ferreira, Ricardo C.; Coulson, Richard; Burden, Frances; Rowlston, Sophia P.; Downes, Kate; Wingett, Steven W. (04.09.2017). „ Chromosomenkontakte in aktivierten T-Zellen identifizieren Kandidatengene für Autoimmunerkrankungen“ . Genome Biology . 18 (1): 165. doi : 10.1186/s13059-017-1285-0 . ISSN 1474-760X . PMC 5584004. PMID 28870212 .
- ^ a b c d Jin, Fulai; Li, Yan; Dixon, Jesse R.; Selvaraj, Siddarth; Ja, Zhen; Lee, Ah Young; Yen, Chia-An; Schmitt, Anthony D.; Espinoza, Celso; Ren, Bing (14. November 2013). „Eine hochauflösende Karte des dreidimensionalen Chromatin-Interaktoms in menschlichen Zellen“ . Natur . 503 (7475): 290–294 . Bibcode : 2013Natur.503..290J . doi : 10.1038/nature12644 . ISSN 0028-0836 . PMC 3838900 . PMID 24141950 .
- Dixon , JR; Selvaraj, S; Yue, F; Kim, A; Li, Y; Shen, Y; Hu, M; Liu, JS; Ren, B (11. April 2012). „ Topologische Domänen in Säugetiergenomen , identifiziert durch die Analyse von Chromatininteraktionen“ . Nature . 485 ( 7398): 376–80 . Bibcode : 2012Natur.485..376D . doi : 10.1038/nature11082 . PMC 3356448. PMID 22495300 .
- ^ Küster, Tom; Yaffe, Eitan; Königsberg, Ephraim; Bantignies, Frédéric; Leblanc, Benjamin; Hoichman, Michael; Parrinello, Hugues; Tanay, Amos; Cavalli, Giacomo (3. Februar 2012). „Dreidimensionale Faltungs- und funktionelle Organisationsprinzipien des Drosophila-Genoms“ . Zelle . 148 (3): 458– 472. Bibcode : 2012Cell..148..458S . doi : 10.1016/j.cell.2012.01.010 . ISSN 0092-8674 . PMID 22265598 . S2CID 17364610 .
- Dixon , Jesse R.; Jung, Inkyung; Selvaraj, Siddarth; Shen, Yin; Antosiewicz-Bourget, Jessica E.; Lee, Ah Young; Ye , Zhen; Kim , Audrey ; Rajagopal, Nisha; Xie, Wei; Diao, Yarui; Liang, Jing; Zhao, Huimin; Lobanenkov, Victor V.; Ecker, Joseph R.; Thomson, James A.; Ren, Bing (Februar 2015). „ Reorganisation der Chromatinarchitektur während der Stammzelldifferenzierung“ . Nature . 518 (7539): 331–336 . Bibcode : 2015Natur.518..331D . doi : 10.1038/nature14222 . ISSN 1476-4687 . PMC 4515363 . PMID 25693564 .
- Belaghzal , Houda; Dekker , Job; Gibcus, Johan H. (1. Juli 2017). „ Hi - C 2.0: Ein optimiertes Hi-C - Verfahren für die hochauflösende genomweite Kartierung der Chromosomenkonformation“ . Methods . 123 : 56–65 . doi : 10.1016/j.ymeth.2017.04.004 . ISSN 1046-2023 . PMC 5522765. PMID 28435001 .
- Lafontaine , Denis L.; Yang, Liyan; Dekker, Job; Gibcus, Johan H. (Juli 2021). „ Hi - C 3.0: Verbessertes Protokoll zur genomweiten Chromosomenkonformationserfassung“ . Current Protocols . 1 ( 7) e198. doi : 10.1002/cpz1.198 . ISSN 2691-1299 . PMC 8362010. PMID 34286910 .
- Rao , Suhas SP; Huntley, Miriam H.; Durand, Neva C.; Stamenova, Elena K.; Bochkov, Ivan D.; Robinson, James T.; Sanborn, Adrian L.; Machol, Ido; Omer, Arina D.; Lander, Eric S.; Aiden , Erez Lieberman ( 18. Dezember 2014 ) . „ Eine 3D - Karte des menschlichen Genoms mit Kilobasenauflösung enthüllt Prinzipien der Chromatin-Schleifenbildung“ . Cell . 159 ( 7): 1665–1680 . doi : 10.1016/j.cell.2014.11.021 . ISSN 0092-8674 . PMC 5635824. PMID 25497547 .
- Hoffman, Elizabeth A.; Frey, Brian L.; Smith, Lloyd M .; Auble, David T. (30. Oktober 2015). „ Formaldehyd- Vernetzung : Ein Werkzeug zur Untersuchung von Chromatin-Komplexen“ . The Journal of Biological Chemistry . 290 ( 44): 26404–26411 . Bibcode : 2015JBiCh.29026404H . doi : 10.1074 / jbc.R115.651679 . ISSN 0021-9258 . PMC 4646298. PMID 26354429 .
- ^ a b c d e f g h i j k l m n o p q r s t u v w x y z aa ab ac ad ae af ag ah ai aj ak al am van Berkum, Nynke L.; Lieberman-Aiden, Erez ; Williams, Louise; Imakaev, Maxim; Gnirke, Andreas; Mirny, Leonid A.; Dekker, Job; Lander, Eric S. (6. Mai 2010). „Hi-C: Eine Methode zur Untersuchung der dreidimensionalen Architektur von Genomen“ . Journal of Visualized Experiments . 39 (39): 1869. Bibcode : 2010JVExp..39.1869V . doi : 10.3791/1869 . ISSN 1940-087X . PMC 3149993 . PMID 20461051 .
- ^ a b c d e f g h i j k l m n o p q r Niu, Longjian; Shen, Wei; Huang, Yingzhang; He, Na; Zhang, Yuedong; Sun, Jialei; Wan, Jing; Jiang, Daxin; Yang, Manyun; Tse, Yu Chung; Li, Li; Hou, Chunhui (19. Juli 2019). „ Amplifikationsfreie Bibliothekspräparation mit SAFE Hi-C nutzt Ligationsprodukte für die Hochdurchsatzsequenzierung zur Verbesserung der traditionellen Hi-C-Analyse“ . Communications Biology . 2 (1): 267. doi : 10.1038/s42003-019-0519-y . ISSN 2399-3642 . PMC 6642088. PMID 31341966 .
- ^ Doetsch, PW; Chan, GL; Haseltine, WA (10. Mai 1985). „T4 DNA-Polymerase (3'–5')-Exonuklease, ein Enzym zum Nachweis und zur Quantifizierung stabiler DNA-Läsionen: das Beispiel mit ultraviolettem Licht“ . Nucleic Acids Research . 13 (9): 3285–3304 . doi : 10.1093/nar/ 13.9.3285 . ISSN 0305-1048 . PMC 341235. PMID 2987881 .
- ^ a b c Ma, Wenxiu; Ja, Ferhat; Lee, Choli; Gulsoy, Gunhan; Deng, Xinxian; Koch, Savannah; Hesson, Jennifer; Cavanaugh, Christopher; Ware, Carol B.; Krumm, Anton; Shendure, Jay; Blau, Carl Anthony; Disteche, Christine M.; Noble, William S.; Duan, Zhijun (Januar 2015). „Feine Chromatin-Interaktionskarten enthüllen die cis-regulatorische Landschaft menschlicher lincRNA-Gene“ . Naturmethoden . 12 (1): 71–78 . doi : 10.1038/nmeth.3205 . ISSN 1548-7105 . PMC 4281301 . PMID 25437436 .
- ^ a b c Mifsud, Borbala; Tavares-Cadete, Filipe; Young, Alice N.; Sugar, Robert; Schoenfelder, Stefan; Ferreira, Lauren; Wingett, Steven W.; Andrews, Simon; Grey, William; Ewels, Philip A.; Herman, Bram; Happe, Scott; Higgs, Andy; LeProust, Emily ; Follows, George A.; Fraser, Peter; Luscombe, Nicholas M.; Osborne, Cameron S. (Juni 2015). „Mapping long-range promoter contacts in human cells with high-resolution capture Hi-C“ . Nature Genetics . 47 (6): 598–606 . doi : 10.1038 / ng.3286 . ISSN 1546-1718 . PMID 25938943. S2CID 6036717 .
- ^ Cullen, Katherine E.; Kladde, Michael P.; Seyfred, Mark A. (9. Juli 1993). „Interaktion zwischen transkriptionsregulatorischen Regionen des Prolaktin-Chromatins“ . Science . 261 (5118): 203–206 . Bibcode : 1993Sci...261..203C . doi : 10.1126/science.8327891 . PMID 8327891 .
- Zhou , Yufan; Cheng, Xiaolong; Yang, Yini; Li, Tian; Li, Jingwei; Huang, Tim H.-M.; Wang, Junbai; Lin, Shili; Jin, Victor X. (12. August 2020). „Modellierung und Analyse von Hi-C - Daten mittels HiSIF identifiziert charakteristische Promoter-ferne Schleifen“ . Genome Medicine . 12 (1): 69. doi : 10.1186/s13073-020-00769-8 . ISSN 1756-994X . PMC 7425017. PMID 32787954 .
- Díaz , Noelia; Kruse, Kai; Erdmann, Tabea; Staiger, Annette M.; Ott, German; Lenz, Georg; Vaquerizas, Juan M. (29. November 2018). „ Chromatin - Konformationsanalyse von primärem Patientengewebe mittels einer Hi-C-Methode mit geringem Probeninput“ . Nature Communications . 9 (1): 4938. Bibcode : 2018NatCo...9.4938D . doi : 10.1038/ s41467-018-06961-0 . ISSN 2041-1723 . PMC 6265268. PMID 30498195 .
- ^ a b c d de Souza, Natalie (September 2015). „Micro-C maps of genome structure“ . Nature Methods . 12 (9): 812. doi : 10.1038 / nmeth.3575 . ISSN 1548-7105 . PMID 26554092. S2CID 5765554 .
- Burgess , Darren J. ( Juni 2020). „ Chromosomenstruktur im Mikromaßstab“ . Nature Reviews Genetics . 21 ( 6): 337. doi : 10.1038/s41576-020-0243-y . ISSN 1471-0064 . PMID 32346116. S2CID 216560645 .
- ^ a b Hsieh, Tsung-Han S.; Cattoglio, Claudia; Slobodyanyuk, Elena; Hansen, Anders S.; Rando, Oliver J.; Tjian, Robert; Darzacq, Xavier (7. Mai 2020). „Auflösung der 3D-Landschaft der transkriptionsvermittelten Chromatinfaltung bei Säugetieren“ . Molecular Cell . 78 (3): 539–553.e8. doi : 10.1016/j.molcel.2020.03.002 . ISSN 1097-2765 . PMC 7703524. PMID 32213323 .
- ^ a b c d e Sandoval-Velasco, Marcela; Dudchenko, Olga; Rodríguez, Juan Antonio; Estrada, Cynthia Pérez; Dehasque, Marianne; Fontsere, Claudia; Mak, Sarah ST; Khan, Ruqayya; Contessoto, Vinícius G.; Junior, Antonio B. Oliveira; Kalluchi, Achyuth; Herrera, Bernardo J. Zubillaga; Jeong, Jiyun; Roy, Renata P.; Christopher, Ishawnia (11.07.2024). „Die dreidimensionale Genomarchitektur bleibt in einer 52.000 Jahre alten Hautprobe eines Wollmammuts bestehen . “ Zelle . 187 (14): 3541–3562.e51. doi : 10.1016/j.cell.2024.06.002 . HDL : 10230/61194 . ISSN 0092-8674 . PMC 12128189. PMID 38996487 .
- ^ a b c Yamagata, Kazuo; Nagai, Kouhei; Miyamoto, Hiroshi; Anzai, Masayuki; Kato, Hiromi; Miyamoto, Kei; Kurosaka, Satoshi; Azuma, Rika; Kolodeznikov, Igor I.; Protopopov, Albert V.; Plotnikov, Valerii V.; Kobayashi, Hisato; Kawahara-Miki, Ryouka; Kono, Tomohiro; Uchida, Masao (11.03.2019). „Anzeichen biologischer Aktivitäten von 28.000 Jahre alten Mammutkernen in Eizellen von Mäusen, sichtbar gemacht durch Bildgebung lebender Zellen“ . Wissenschaftliche Berichte . 9 (1): 4050. Bibcode : 2019NatSR...9.4050Y . doi : 10.1038/ s41598-019-40546-1 . ISSN 2045-2322 . PMC 6411884. PMID 30858410 .
- Lajoie , Bryan R .; Dekker , Job ; Kaplan , Noam ( Januar 2015 ) . „ The Hitchhiker 's Guide to Hi - C Analysis : Practical guidelines “ . Methods . 72 : 65–75 . doi : 10.1016 / j.ymeth.2014.10.031 . ISSN 1046-2023 . PMC 4347522. PMID 25448293 .
- ^ a b c d e f g h i j k l m n o p q r s t u v w x y z aa ab ac ad ae af ag ah ai Pal , Koustav; Forcato, Mattia; Ferrari, Francesco (20. Dezember 2018). „Hi-C - Analyse: von der Datengenerierung zur Integration“ . Biophysical Reviews . 11 (1): 67–78 . doi : 10.1007/s12551-018-0489-1 . ISSN 1867-2450 . PMC 6381366. PMID 30570701 .
- Forcato , Mattia; Bicciato, Silvio (2021). „Computergestützte Analyse von Hi-C-Daten“ . Erfassung der Chromosomenkonformation . Methoden der Molekularbiologie. Band 2157. Springer US. S. 103–125 . doi : 10.1007/978-1-0716-0664-3_7 . hdl : 11380/1210404 . ISBN 978-1-0716-0663-6PMID 32820401 . S2CID 221219811 .
{{cite book}}:|journal=ignoriert ( Hilfe ) - Gong , Haiyan ; Yang, Yi; Zhang, Sichen ; Li , Minghong ; Zhang, Xiaotong (1. Januar 2021). „ Anwendung von Hi-C und anderen Omics-Datenanalysen in der Forschung zu menschlichem Krebs und Zelldifferenzierung“ . Computational and Structural Biotechnology Journal . 19 : 2070–2083 . doi : 10.1016/j.csbj.2021.04.016 . ISSN 2001-0370 . PMC 8086027. PMID 33995903 .
- ^ Langmead, Ben (Dezember 2010). „ Aligning Short Sequencing Reads with Bowtie“ . Current Protocols in Bioinformatics . 32 (1): Unit 11.7. doi : 10.1002/0471250953.bi1107s32 . hdl : 2027.42/137758 . ISSN 1934-3396 . PMC 3010897. PMID 21154709 .
- ^ Li, Heng; Durbin, Richard (15. Juli 2009). „Schnelle und genaue Ausrichtung kurzer Lesesequenzen mit der Burrows-Wheeler-Transformation“ . Bioinformatics . 25 ( 14): 1754–1760 . doi : 10.1093/bioinformatics/btp324 . PMC 2705234. PMID 19451168 .
- ^ Li, Heng (2018). „ Minimap2: Paarweiser Alignment für Nukleotidsequenzen“ . Bioinformatics . 34 (18): 3094–3100 . doi : 10.1093/bioinformatics/bty191 . PMC 6137996. PMID 29750242 .
- ^ a b Imakaev, Maxim; Fudenberg, Geoffrey; McCord, Rachel Patton; Naumova, Natalia; Goloborodko, Anton; Lajoie, Bryan R.; Dekker, Job; Mirny, Leonid A. (Oktober 2012). „Iterative Korrektur von Hi-C-Daten enthüllt Merkmale der Chromosomenorganisation“ . Nature Methods . 9 (10): 999–1003 . doi : 10.1038/nmeth.2148 . ISSN 1548-7105 . PMC 3816492. PMID 22941365 .
- Servant , Nicolas; Varoquaux, Nelle; Lajoie, Bryan R.; Viara, Eric; Chen, Chong-Jian; Vert, Jean-Philippe; Heard, Edith; Dekker, Job; Barillot, Emmanuel (1. Dezember 2015). „ HiC -Pro: eine optimierte und flexible Pipeline für die Hi-C-Datenverarbeitung“ . Genome Biology . 16 (1): 259. doi : 10.1186/s13059-015-0831-x . ISSN 1474-760X . PMC 4665391. PMID 26619908 .
- ^ Hwang, Yih-Chii; Lin, Chiao-Feng; Valladares, Otto; Malamon, John; Kuksa, Pavel P.; Zheng, Qi; Gregory, Brian D.; Wang, Li-San (15. April 2015). „HIPPIE: eine Hochdurchsatz-Identifizierungspipeline für Promotor-interagierende Enhancer-Elemente“ . Bioinformatics . 31 ( 8): 1290–1292 . doi : 10.1093/bioinformatics/btu801 . ISSN 1367-4803 . PMC 4393516. PMID 25480377 .
- ^ Wingett, Steven; Ewels, Philip; Furlan-Magaril, Mayra; Nagano, Takashi; Schoenfelder, Stefan; Fraser, Peter; Andrews, Simon (20. November 2015). „HiCUP: Pipeline für die Kartierung und Verarbeitung von Hi-C-Daten“ . F1000Research . 4 : 1310. doi : 10.12688/f1000research.7334.1 . ISSN 2046-1402 . PMC 4706059. PMID 26835000 .
- Serra , François; Baù, Davide; Goodstadt, Mike; Castillo, David; Filion, Guillaume J.; Marti-Renom, Marc A. (19. Juli 2017). „Automatische Analyse und 3D-Modellierung von Hi-C-Daten mit TADbit enthüllt Strukturmerkmale der Chromatinfarben der Fruchtfliege“ . PLOS Computational Biology . 13 (7) e1005665. Bibcode : 2017PLSCB..13E5665S . doi : 10.1371/journal.pcbi.1005665 . ISSN 1553-7358 . PMC 5540598. PMID 28723903 .
- ^ Durand, Neva C.; Shamim, Muhammad S.; Machol, Ido; Rao, Suhas SP; Huntley, Miriam H.; Lander, Eric S.; Aiden, Erez Lieberman (27. Juli 2016). „Juicer bietet ein Ein-Klick-System zur Analyse von Hi-C-Experimenten mit Schleifenauflösung“ . Cell Systems . 3 (1): 95–98 . doi : 10.1016/j.cels.2016.07.002 . ISSN 2405-4712 . PMC 5846465. PMID 27467249 .
- ^ Reiff, Sarah B.; Schroeder, Andrew J.; Kırlı, Koray; Cosolo, Andrea; Bakker, Clara; Lee, Soohyun; Veit, Alexander D.; Balashov, Alexander K.; Vitzthum, Carl; Ronchetti, William; Pitman, Kent M.; Johnson, Jeremy; Ehmsen, Shannon R.; Kerpedjiev, Peter; Abdennur, Nezar; Imakaev, Maxim; Öztürk, Serkan Utku; Çamoğlu, Uğur; Mirny, Leonid A.; Gehlenborg, Nils; Alver, Burak H.; Park, Peter J. (2022). „Das 4D-Nukleomdatenportal als Ressource für die Suche und Visualisierung kuratierter Nukleomikdaten“ . Nature Communications . 13 (1): 2365. Bibcode : 2022NatCo..13.2365R . doi : 10.1038/ s41467-022-29697-4 . PMC 9061818. PMID 35501320 .
- ^ Li, Heng (2013). „Aligning sequence reads, clone sequences and assembly contigs with BWA-MEM“. arXiv : 1303.3997 [ q-bio.GN ].
- Zhang , H.; Song, L.; Wang, X.; Cheng, H.; Wang, C.; Meyer, C. A.; Liu, T.; Tang, M.; Aluru, S.; Yue, F.; Liu, X. S.; Li, H. (2021). „Schnelle Ausrichtung und Vorverarbeitung von Chromatinprofilen mit Chromap“ . Nature Communications . 12 (1): 6566. Bibcode : 2021NatCo..12.6566Z . doi : 10.1038/s41467-021-26865- w . PMC 8589834. PMID 34772935 .
- ^ Forcato, Mattia; Nicoletti, Chiara; Pal, Koustav; Livi, Carmen Maria; Ferrari, Francesco; Bicciato, Silvio (Juli 2017). „Vergleich von Rechenmethoden für die Hi-C-Datenanalyse“ . Naturmethoden . 14 (7): 679–685 . doi : 10.1038/nmeth.4325 . ISSN 1548-7105 . PMC 5493985 . PMID 28604721 .
- ^ Nora, Elphège P.; Goloborodko, Anton; Valton, Anne-Laure; Gibcus, Johan H.; Uebersohn, Alec; Abdennur, Nezar; Dekker, Job; Mirny, Leonid A.; Bruneau, Benoit G. (18. Mai 2017). „Gezielter Abbau von CTCF entkoppelt die lokale Isolation von Chromosomendomänen von der genomischen Kompartimentierung“ . Cell . 169 (5): 930–944.e22. Bibcode : 2017Cell..169..930N . doi : 10.1016/j.cell.2017.05.004 . ISSN 0092-8674 . PMC 5538188. PMID 28525758 .
- ^ Li, Angsheng; Yin, Xianchen; Xu, Bingxiang; Wang, Danyang; Han, Jimin; Wei, Yi; Deng, Yun; Xiong, Ying; Zhang, Zhihua (15. August 2018). „Decoding topologically associating domains with ultra-low resolution Hi-C data by graph structural entropy“ . Nature Communications . 9 (1): 3265. Bibcode : 2018NatCo...9.3265L . doi : 10.1038/ s41467-018-05691-7 . ISSN 2041-1723 . PMC 6093941. PMID 30111883 .
- ^ Sauria, Michael EG; Taylor, James (14. November 2017). „QuASAR: Qualitätsbewertung der Reproduzierbarkeit räumlicher Anordnungen in Hi-C-Daten“. bioRxiv 10.1101/204438 .
- ^ Ramirez, Fidel; Lingg, Thomas; Toscano, Sarah; Lam, Kin Chung; Georgiev, Plamen; Chung, Ho-Ryun; Lajoie, Bryan; de Wit, Elzo; Zhan, Ye; de Laat, Wouter; Dekker, Job; Manke, Thomas; Akhtar, Asifa (1. Oktober 2015). „Hochaffine Bindungsstellen bilden ein Interaktionsnetzwerk, das die Ausbreitung des MSL-Komplexes über das X-Chromosom in Drosophila erleichtert“ . Molecular Cell . 60 (1): 146–162 . doi : 10.1016/j.molcel.2015.08.024 . ISSN 1097-2765 . PMC 4806858. PMID 26431028 .
- ^ a b Zhang, Yan; An, Lin; Xu, Jie; Zhang, Bo; Zheng, W. Jim; Hu, Ming; Tang, Jijun; Yue, Feng (21. Februar 2018). „Verbesserung der Hi-C-Datenauflösung mit dem tiefen Faltungsneuronalen Netzwerk HiCPlus“ . Nature Communications . 9 (1): 750. Bibcode : 2018NatCo...9..750Z . doi : 10.1038/s41467-018-03113-2 . ISSN 2041-1723 . PMC 5821732. PMID 29467363 .
- ^ a b c Knopp, Paul; Sinkhorn, Richard (Januar 1967). „Über nichtnegative Matrizen und doppelt stochastische Matrizen“ . Pacific Journal of Mathematics . 21 (2): 343–348 . doi : 10.2140/pjm.1967.21.343 . ISSN 0030-8730 .
- ^ Cournac, Axel; Marie-Nelly, Hervé; Marbouty, Martial; Koszul, Romain; Mozziconacci, Julien (30. August 2012). „Normalisierung einer chromosomalen Kontaktkarte“ . BMC Genomics . 13, 436. doi : 10.1186 /1471-2164-13-436 . ISSN 1471-2164 . PMC 3534615. PMID 22935139 .
- ^ Knight, Philip; Ruiz, Daniel (26. Oktober 2012). „Ein schneller Algorithmus zum Matrixausgleich“ . IMA Journal of Numerical Analysis . 33 (3): 1029–1047 . doi : 10.1093/imanum/drs019 .
- ^ a b c Raccosta, Samuele; Librizzi, Fabio; Jagger, Alistair M.; Noto, Rosina; Martorana, Vincenzo; Lomas, David A.; Irving, James A.; Manno, Mauro (Januar 2021). „Skalierungskonzepte in der Serpin-Polymerphysik“ . Materialien . 14 (10): 2577. Bibcode : 2021Mate...14.2577R . doi : 10.3390/ma14102577 . ISSN 1996–1944 . PMC 8156723 . PMID 34063488 .
- Fudenberg , Geoffrey ; Mirny, Leonid A. (1. April 2012). „ Höhere Chromatin-Struktur: Eine Brücke zwischen Physik und Biologie“ . Current Opinion in Genetics & Development . 22 (2): 115–124 . doi : 10.1016/j.gde.2012.01.006 . hdl : 1721.1 /103044 . ISSN 0959-437X . PMC 3697851. PMID 22360992 .
- Heinz , Sven; Benner, Christopher; Spann, Nathanael; Bertolino, Eric; Lin, Yin C.; Laslo, Peter; Cheng, Jason X.; Murre, Cornelis; Singh, Harinder; Glass, Christopher K. (28. Mai 2010). „Einfache Kombinationen von linienbestimmenden Transkriptionsfaktoren bereiten cis-regulatorische Elemente vor, die für die Identität von Makrophagen und B-Zellen erforderlich sind.“ Molecular Cell . 38 ( 4): 576–589 . doi : 10.1016/j.molcel.2010.05.004 . ISSN 1097-2765 . PMC 2898526. PMID 20513432 .
- ^ Zheng, Xiaobin; Zheng, Yixian (1. Mai 2018). „CscoreTool: Schnelle Hi-C-Kompartimentanalyse mit hoher Auflösung“ . Bioinformatics . 34 ( 9): 1568–1570 . doi : 10.1093/bioinformatics/btx802 . ISSN 1367-4803 . PMC 5925784. PMID 29244056 .
- ^ de Wit, Elzo (7. Februar 2020). „TADs as the Caller Calls Them“ . Journal of Molecular Biology . 432 (3): 638–642 . doi : 10.1016/j.jmb.2019.09.026 . ISSN 0022-2836 . PMID 31654669. S2CID 204918507 .
- ^ Naumova, Natalia; Imakaev, Maxim; Fudenberg, Geoffrey; Zhan, Ye; Lajoie, Bryan R.; Mirny, Leonid A.; Dekker, Job (22. November 2013). „Organisation des mitotischen Chromosoms“ . Science . 342 (6161): 948–953 . Bibcode : 2013Sci...342..948N . doi : 10.1126 /science.1236083 . ISSN 0036-8075 . PMC 4040465. PMID 24200812 .
- Crane , Emily; Bian, Qian; McCord, Rachel Patton; Lajoie, Bryan R.; Wheeler, Bayly S.; Ralston, Edward J.; Uzawa, Satoru; Dekker, Job; Meyer , Barbara J. (Juli 2015). „ Condensin-getriebene Umstrukturierung der X -Chromosomen-Topologie während der Dosiskompensation“ . Nature . 523 (7559): 240–244 . Bibcode : 2015Natur.523..240C . doi : 10.1038/nature14450 . ISSN 1476-4687 . PMC 4498965. PMID 26030525 .
- ^ a b c Filippova, Darya; Patro, Rob; Duggal, Geet; Kingsford, Carl (3. Mai 2014). „ Identifizierung alternativer topologischer Domänen im Chromatin“ . Algorithms for Molecular Biology . 9 (1): 14. doi : 10.1186/1748-7188-9-14 . ISSN 1748-7188 . PMC 4019371. PMID 24868242 .
- ^ Schwarzer, Wibke; Abdennur, Nezar; Goloborodko, Anton; Pekowska, Aleksandra; Fudenberg, Geoffrey; Loe-Mie, Yann; Fonseca, Nuno A; Huber, Wolfgang; Häring, Christian; Mirny, Leonid; Spitz, Francois (2. November 2017). „Zwei unabhängige Arten der Chromatinorganisation, die durch die Entfernung von Kohäsin aufgedeckt werden“ . Natur . 551 (7678): 51– 56. Bibcode : 2017Natur.551...51S . doi : 10.1038/nature24281 . ISSN 0028-0836 . PMC 5687303 . PMID 29094699 .
- ^ Yan, Koon-Kiu; Lou, Shaoke; Gerstein, Mark (24. Juli 2017). „MrTADFinder: Ein auf Netzwerkmodularität basierender Ansatz zur Identifizierung topologisch assoziierter Domänen in mehreren Auflösungen“ . PLOS Computational Biology . 13 (7) e1005647. Bibcode : 2017PLSCB..13E5647Y . doi : 10.1371/journal.pcbi.1005647 . ISSN 1553-734X . PMC 5546724. PMID 28742097 .
- ^ Norton, Heidi K.; Emerson, Daniel J.; Huang, Harvey; Kim, Jesi; Titus, Katelyn R.; Gu, Shi; Bassett, Danielle S.; Phillips-Cremins, Jennifer E. (Februar 2018). „Detecting hierarchical genome folding with network modularity“ . Nature Methods . 15 (2): 119–122 . doi : 10.1038/nmeth.4560 . ISSN 1548-7105 . PMC 6029251. PMID 29334377 .
- ^ Malik, Laraib; Patro, Rob (September 2019). „Rich Chromatin Structure Prediction from Hi-C Data“. IEEE /ACM Transactions on Computational Biology and Bioinformatics . 16 (5): 1448–1458 . Bibcode : 2019ITCBB..16.1448M . doi : 10.1109/TCBB.2018.2851200 . ISSN 1557-9964 . PMID 29994683. S2CID 54563346 .
- ^ Lieberman-Aiden E, van Berkum NL, Williams L, Imakaev M, Ragoczy T, Telling A, Amit I, Lajoie BR, Sabo PJ, Dorschner MO, Sandstrom R, Bernstein B, Bender MA, Groudine M, Gnirke A, Stamatoyannopoulos J, Mirny LA, Lander ES, Dekker J (Oktober 2009). „Umfassende Kartierung weitreichender Wechselwirkungen enthüllt Faltungsprinzipien des menschlichen Genoms“ . Wissenschaft . 326 (5950): 289– 93. Bibcode : 2009Sci...326..289L . doi : 10.1126/science.1181369 . PMC 2858594 . PMID 19815776 .
- ^ Dixon JR, Selvaraj S, Yue F, Kim A, Li Y, Shen Y, Hu M, Liu JS, Ren B (April 2012). „Topologische Domänen in Säugetiergenomen , identifiziert durch die Analyse von Chromatininteraktionen“ . Nature . 485 (7398): 376–80 . Bibcode : 2012Natur.485..376D . doi : 10.1038/nature11082 . PMC 3356448. PMID 22495300 .
- ^ Nora EP, Lajoie BR, Schulz EG, Giorgetti L, Okamoto I, Servant N, Piolot T, van Berkum NL, Meisig J, Sedat J, Gribnau J, Barillot E, Blüthgen N, Dekker J, Heard E (April 2012). „ Räumliche Aufteilung der regulatorischen Landschaft des X-Inaktivierungszentrums“ . Nature . 485 (7398): 381–5 . Bibcode : 2012Natur.485..381N . doi : 10.1038/nature11049 . PMC 3356449. PMID 22495304 .
- ^ Burton JN, Adey A, Patwardhan RP, Qiu R, Kitzman JO, Shendure J (Dezember 2013). „Chromosomenweites Scaffolding von De-novo-Genomassemblierungen basierend auf Chromatininteraktionen“ . Nature Biotechnology . 31 (12): 1119–25 . doi : 10.1038/nbt.2727 . PMC 4199034. PMID 24185095 .
- ^ Dudchenko O, Batra SS, Omer AD, Nyquist SK, Hoeger M, Durand NC, Shamim MS, Machol I, Lander ES, Aiden AP, Aiden EL (April 2017). „De novo-Assemblierung des Aedes aegypti-Genoms mittels Hi-C liefert chromosomenlange Scaffolds“ . Science . 356 (6333): 92–95 . Bibcode : 2017Sci...356...92D . doi : 10.1126 /science.aal3327 . PMC 5612822. PMID 28386020 .
- ^ Yamaguchi et al. (2021). „Technische Überlegungen zum Hi-C-Scaffolding und zur Evaluierung von Genom-Assemblierungen auf Chromosomenebene“ . Molecular Ecology . Molecular Ecology / Wiley via PubMed Central.
- ^ Lajoie BR, Dekker J, Kaplan N (Januar 2015). „Der Leitfaden für die Hi-C-Analyse: Praktische Richtlinien“ . Methods . 72 : 65–75 . doi : 10.1016 /j.ymeth.2014.11.021 . PMC 4308829. PMID 25482193 .
- Ou , Horng D.; Phan, Sébastien; Deerinck, Thomas J.; Thor, Andrea; Ellisman, Mark H.; O'Shea, Clodagh C. (28. Juli 2017). „ ChromEMT : Visualisierung der 3D-Chromatinstruktur und -Kompaktierung in Interphase- und Mitosezellen“ . Science . 357 (6349) eaag0025. Bibcode : 2017Sci...357g0025O . doi : 10.1126 /science.aag0025 . ISSN 0036-8075 . PMC 5646685. PMID 28751582 .
- ^ Nagano , Takashi ; Lubling, Yaniv; Várnai, Csilla; Dudley, Carmel; Leung, Flügel; Baran, Yael; Mendelson Cohen, Netta; Wingett, Steven; Fraser, Peter; Tanay, Amos (Juli 2017). „Zellzyklusdynamik der chromosomalen Organisation bei Einzelzellauflösung“ . Natur . 547 (7661): 61– 67. Bibcode : 2017Natur.547...61N . doi : 10.1038/nature23001 . ISSN 1476-4687 . PMC 5567812 . PMID 28682332 .
- ^ Bintu, Bogdan; Mateo, Leslie J.; Su, Jun-Han; Sinnott-Armstrong, Nicholas A.; Parker, Mirae; Kinrot, Seon; Yamaya, Kei; Boettiger, Alistair N.; Zhuang, Xiaowei (26. Oktober 2018). „ Superauflösende Chromatin-Analyse enthüllt Domänen und kooperative Interaktionen in einzelnen Zellen“ . Science . 362 (6413) eaau1783. Bibcode : 2018Sci...362.1783B . doi : 10.1126/science.aau1783 . ISSN 0036-8075 . PMC 6535145. PMID 30361340 .
- ^ a b Yu, Miao; Ren, Bing (6. Oktober 2017). „Die dreidimensionale Organisation von Säugetiergenomen“ . Annual Review of Cell and Developmental Biology . 33 (1): 265–289 . doi : 10.1146/annurev - cellbio-100616-060531 . ISSN 1081-0706 . PMC 5837811. PMID 28783961 .
- ^ Niakan, Kathy K.; Han, Jinnuo; Pedersen, Roger A.; Simon, Carlos; Pera, Renee A. Reijo (1. März 2012). „Entwicklung des menschlichen Präimplantations-Embryos“ . Development . 139 (5): 829–841 . doi : 10.1242/dev.060426 . ISSN 0950-1991 . PMC 3274351. PMID 22318624 .
- ^ a b c Du, Zhenhai; Zheng, Hui; Huang, Bo; Ma, Rui; Wu, Jingyi; Zhang, Xianglin; Er, Jing; Xiang, Yunlong; Wang, Qiujun; Li, Yuanyuan; Ma, Jing; Zhang, Xu; Zhang, Ke; Wang, Yang; Zhang, Michael Q.; Gao, Juntao; Dixon, Jesse R.; Wang, Xiaowo; Zeng, Jianyang; Xie, Wei (Juli 2017). „Allelische Neuprogrammierung der 3D-Chromatinarchitektur während der frühen Säugetierentwicklung“ . Natur . 547 (7662): 232–235 . Bibcode : 2017Natur.547..232D . doi : 10.1038/nature23263 . ISSN 1476-4687 . PMID 28703188 . S2CID 4410486 .
- ^ a b c Ke, Yuwen; Xu, Yanan; Chen, Xuepeng; Feng, Songjie; Liu, Zhenbo; Sonne, Yaoyu; Yao, Xuelong; Li, Fangzhen; Zhu, Wei; Gao, Lei; Chen, Haojie; Du, Zhenhai; Xie, Wei; Xu, Xiaocui; Huang, Xingxu; Liu, Jiang (13. Juli 2017). „3D-Chromatinstrukturen reifer Gameten und strukturelle Neuprogrammierung während der Embryogenese von Säugetieren“ . Zelle . 170 (2): 367–381.e20. doi : 10.1016/j.cell.2017.06.029 . ISSN 0092-8674 . PMID 28709003 . S2CID 23974814 .
- ^ Diament, Alon; Tuller, Tamir (1. Juni 2019). „Modellierung der dreidimensionalen genomischen Organisation in Evolution und Pathogenese“ . Seminars in Cell & Developmental Biology . 90 : 78–93 . doi : 10.1016/j.semcdb.2018.07.008 . ISSN 1084-9521 . PMID 30030143. S2CID 51704135 .
- ^ a b Vietri, Matteo; Barrington, Christopher; Henderson, Stephen; Ernst, Christina; Odom, Duncan; Tanay, Amos; Hadjur, Suzana (26. Februar 2015). „Comparative Hi-C Reveals that CTCF Underlies Evolution of Chromosomal Domain Architecture“ . Cell Reports . 10 (8): 1297–1309 . doi : 10.1016/j.celrep.2015.02.004 . ISSN 2211-1247 . PMC 4542312. PMID 25732821 .
- ^ Diament, Alon; Pinter, Ron Y.; Tuller, Tamir (16. Dezember 2014). „Die dreidimensionale genomische Organisation von Eukaryoten korreliert stark mit der Expression und Funktion von Codons . “ Nature Communications . 5 (1): 5876. Bibcode : 2014NatCo...5.5876D . doi : 10.1038/ncomms6876 . ISSN 2041-1723 . PMID 25510862 .
- ^ Ibn-Salem, Jonas; Muro, Enrique M.; Andrade-Navarro, Miguel A. (9. Januar 2017). „Ko-Regulation von Paraloggenen in der dreidimensionalen Chromatinarchitektur“ . Nucleic Acids Research . 45 (1): 81–91 . doi : 10.1093/nar/gkw813 . ISSN 0305-1048 . PMC 5224500. PMID 27634932 .
- ^ Diament, Alon; Tuller, Tamir (5. Mai 2017). „Die Untersuchung der Evolution der dreidimensionalen Genorganisation belegt deren Zusammenhang mit der phänotypischen Divergenz“ . Nucleic Acids Research . 45 (8): 4330–4343 . doi : 10.1093/nar/gkx205 . ISSN 0305-1048 . PMC 5416853. PMID 28369658 .
- ^ Bonev, Boyan; Cavalli, Giacomo (November 2016). „Organisation und Funktion des 3D-Genoms“ . Nature Reviews Genetics . 17 (11): 661–678 . doi : 10.1038/nrg.2016.112 . ISSN 1471-0064 . PMID 27739532. S2CID 31259189 .
- Chambers , Emily V.; Bickmore, Wendy A.; Semple, Colin A. (4. April 2013). „Divergenz der Chromatin-Struktur höherer Ordnung bei Säugetieren ist mit Entwicklungsloci assoziiert“ . PLOS Computational Biology . 9 (4) e1003017. Bibcode : 2013PLSCB...9E3017C . doi : 10.1371/journal.pcbi.1003017 . ISSN 1553-7358 . PMC 3617018. PMID 23592965 .
- ^ a b c Klötgen, Andreas; Thandapani, Palaniraja; Ntziachristos, Panagiotis; Ghebrechristos, Yohana; Nomikou, Sofia; Lazaris, Charalampos; Chen, Xufeng; Hu, Hai; Bakogianni, Sofia; Wang, Jingjing; Fu, Yi; Boccalatte, Francesco; Zhong, Hua; Paietta, Elisabeth; Trimarchi, Thomas; Zhu, Yixing; Van Vlierberghe, Pieter; Inghirami, Giorgio G.; Lionnet, Timothee; Aifantis, Iannis; Tsirigos, Aristotelis (April 2020). „Dreidimensionale Chromatinlandschaften bei akuter lymphoblastischer T-Zell-Leukämie“ . Naturgenetik . 52 (4): 388–400 . doi : 10.1038/ s41588-020-0602-9 . ISSN 1546-1718 . PMC 7138649. PMID 32203470 .
- Fang, Celestia; Wang, Zhenjia; Han, Cuijuan; Safgren, Stephanie L.; Helmin, Kathryn A.; Adelman, Emmalee R.; Serafin, Valentina ; Basso, Giuseppe; Eagen, Kyle P.; Gaspar-Maia, Alexandre; Figueroa, Maria E.; Singer, Benjamin D.; Ratan, Aakrosh; Ntziachristos, Panagiotis; Zang, Chongzhi (15. September 2020). „ Krebsspezifische CTCF-Bindung erleichtert onkogene transkriptionelle Dysregulation“ . Genome Biology . 21 (1): 247. doi : 10.1186/s13059-020-02152-7 . ISSN 1474-760X . PMC 7493976. PMID 32933554 .